강의
통계학 입문
4시간
163.6K
실습 문제하고 트랙하세요.
Google로 계속하기t-검정을 실행했는데 p-값이 이상하게 나와서, 나중에 보니 데이터가 정규분포와는 거리가 멀었다는 경험이 있으신가요?
이런 일은 누구에게나 한 번쯤 일어납니다. t-검정의 문제는 데이터가 정규분포를 따른다는 가정을 한다는 점입니다. 이 가정이 깨지면 결과가 오해를 불러일으킬 수 있습니다. 왜도가 큰 데이터와 작은 표본 크기는 모두 정규성 가정을 위반합니다. 그리고 실제 데이터는 교과서가 말하는 대로 잘 움직이지 않습니다.
Mann-Whitney U 검정은 이 문제를 해결합니다. 평균이 아니라 순위를 기반으로 두 집단을 비교하는 비모수적 대안이기 때문에, 분포의 모양에 구애받지 않습니다.
이 글에서는 Mann-Whitney U 검정이 무엇인지, 언제 사용하는지, 수학적 원리는 무엇인지, 그리고 Python과 R에서 실행하고 해석하는 방법을 다룹니다.
그런데 t-검정이 정확히 무엇인가요? 그런 질문이 든다면, 저희의 Introduction to Python T-Tests 블로그 글을 읽어보세요. 모든 궁금증이 해결됩니다.
Mann-Whitney U 검정은 두 개의 독립 집단을 비교하는 데 사용되는 비모수 통계 검정입니다.
t-검정과 달리 데이터가 정규분포를 따른다고 가정하지 않습니다. 원시 값을 순위로 변환해 두 집단의 분포를 비교합니다. 따라서 데이터에 왜도가 있거나, 이상치가 있거나, 그 밖의 이유로 정규성 요건을 충족하지 못할 때 좋은 선택입니다.
또한 Wilcoxon 순위합 검정이라고도 부르며, 실질적으로 동의어라고 보면 됩니다.
Mann-Whitney U 검정에는 특정 조건이 필요합니다. 아래 모든 조건을 충족할 때만 사용하세요:
예시를 통해 살펴보겠습니다.
서로 다른 방법으로 가르친 두 반이 있고, 어느 쪽이 시험 성적이 더 좋았는지 알고 싶다고 합시다. 점수를 그려보니 정규분포가 아니고, 한 반은 소수의 이상치 때문에 분포가 오른쪽으로 치우쳐 있습니다. t-검정은 집단의 평균을 비교하므로, 그 이상치가 평균을 끌어올려 한 반이 실제보다 더 좋아 보이게 만듭니다.
왜곡된 평균이 t-검정 계산에 반영되어 반환된 p-값이 집단 간 차이를 제대로 반영하지 못합니다. Mann-Whitney U 검정은 원시 점수 대신 순위를 사용하므로 이런 문제가 없습니다. 단일 이상치는 최대한 높은 순위를 차지할 뿐이어서, 평균처럼 결과를 왜곡시킬 수 없습니다.
또한 1~5 척도의 설문 응답 같은 서열형 데이터를 다룰 때도 적합합니다. 그런 값은 진정한 의미의 연속형이 아니므로 평균을 계산하는 것이 그다지 의미가 없습니다.
이 검정은 각 집단에 대해 두 개의 U 통계량을 산출합니다. 공식은 다음과 같습니다:
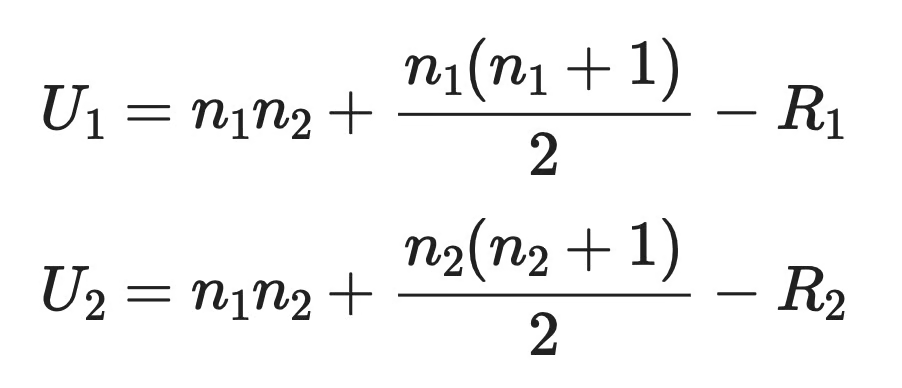
Mann-Whitney U 검정 공식
여기서:
n1 및 n2 는 1집단과 2집단의 표본 크기입니다
R1 및 R2 는 각 집단의 순위합입니다. 즉, 각 집단 관측치에 부여된 모든 순위의 합입니다
순위합은 두 집단의 모든 값을 합쳐 낮은 값부터 높은 값까지 정렬하고 각 값에 순위를 부여해 계산합니다. 가장 작은 값은 순위 1, 그다음은 2, 이런 식입니다. 그런 다음 각 집단에 속한 순위를 따로 합산합니다.
검정 통계량은 U1 과 U2 중 더 작은 값입니다. 이를 임계값과 비교하거나 p-값 계산에 사용합니다.
좋은 소식은 이를 손으로 계산할 필요가 없다는 점입니다. Python과 R이 모두 계산해 주며, 곧 보여드리겠습니다.
Mann-Whitney U 검정은 t-검정보다 유연하지만, 지켜야 할 가정이 세 가지 있습니다:
세 번째 가정이 가장 혼란스럽게 느껴질 수 있습니다.
Mann-Whitney U 검정은 흔히 중앙값을 비교하는 검정으로 설명되지만, 이는 두 분포의 형태가 유사할 때만 사실입니다. 형태가 다르면 결과는 더 일반적인 내용을 알려줍니다. 즉, 한 집단의 값이 다른 집단의 값보다 대체로 더 높은 경향이 있는지입니다.
Python의 scipy.stats 모듈에는 Mann-Whitney U 검정 함수가 있습니다. 두 반의 시험 점수를 사용한 간단한 예시는 다음과 같습니다.
from scipy.stats import mannwhitneyu

class_a = [72, 85, 90, 65, 78, 88, 95, 70, 83, 76]
class_b = [60, 55, 74, 68, 80, 58, 63, 71, 66, 59]

stat, p_value = mannwhitneyu(class_a, class_b, alternative="two-sided")

print(f"U statistic: {stat}")
print(f"P-value: {p_value:.4f}")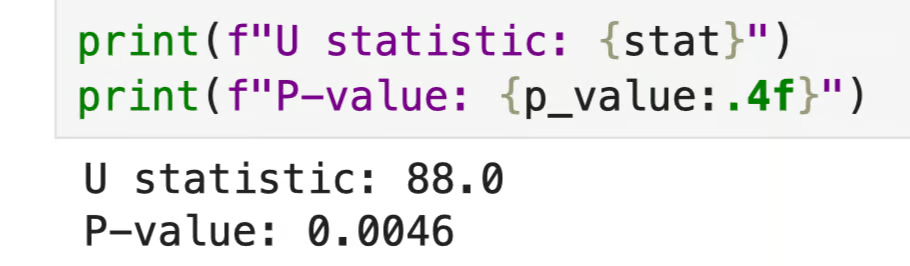
Python에서의 Mann-Whitney U 검정
alternative="two-sided" 인자는 두 집단이 어느 방향으로든 차이가 있는지 검정하겠다는 의미입니다. 사전에 어느 집단이 더 높을 것이라고 가정하지 않습니다. 방향성 가설이 있다면 "less" 또는 "greater" 를 사용합니다.
여기서 p-값은 0.0046으로, 일반적인 임계값 0.05보다 작습니다. 즉, 두 반의 점수 분포 사이에 통계적으로 유의한 차이가 있으므로 귀무가설을 기각할 수 있습니다.
U 통계량 자체만으로는 맥락 없이 큰 의미가 없습니다. 차이가 통계적으로 유의한지 판단하려면 p-값에 집중하고, 차이의 방향을 이해하려면 원시 데이터나 중앙값을 확인하세요.
R에서는 wilcox.test() 함수로 Mann-Whitney U 검정을 실행합니다. 앞서 사용한 동일한 시험 점수 예시를 사용하겠습니다.
class_a <- c(72, 85, 90, 65, 78, 88, 95, 70, 83, 76)
class_b <- c(60, 55, 74, 68, 80, 58, 63, 71, 66, 59)

wilcox.test(class_a, class_b, alternative = "two.sided")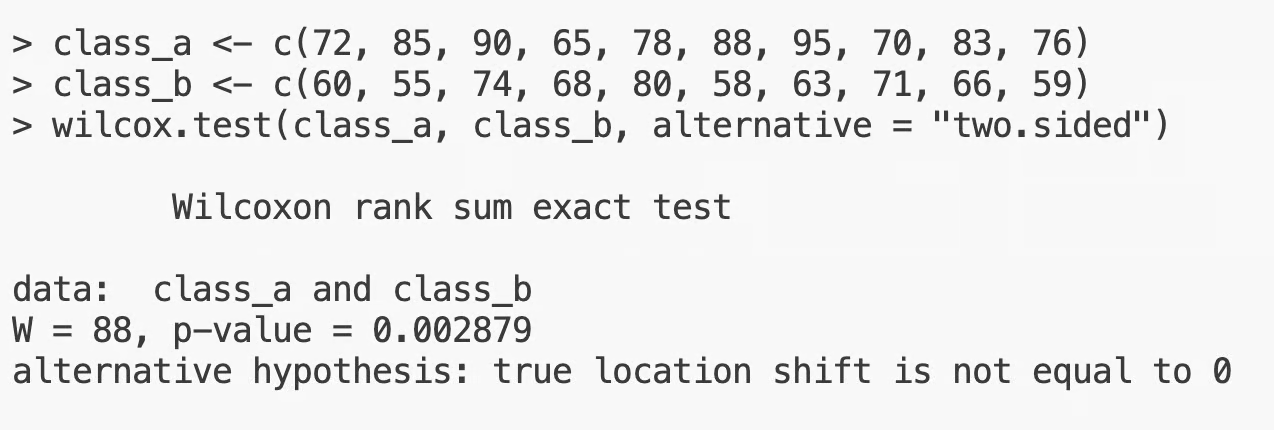
R에서의 Mann-Whitney U 검정
W 통계량은 U 통계량과 동일하며, R이 라벨만 다르게 붙입니다. 해석도 Python과 같습니다. p-값 0.0029는 0.05보다 작으므로 두 집단 사이에 통계적으로 유의한 차이가 있습니다.
데이터에 동점(tie)이 있다는 경고가 표시될 수도 있습니다.
이는 두 집단에 동일한 값이 둘 이상 존재할 때 발생하며, 순위 부여 방식에 영향을 줍니다. R이 이를 처리해 주지만, 동점이 많다면 데이터가 검정의 가정을 충족하는지 점검해 볼 가치가 있습니다.
Mann-Whitney U 검정의 귀무가설은 두 집단이 동일한 분포에서 왔다, 즉 차이가 없다는 것입니다. 여러분의 과제는 그에 반하는 증거를 찾는 것입니다.
p-값으로 이를 판단합니다:
Mann-Whitney U 검정은 분포를 비교한다는 점을 기억하세요. 유의한 결과는 한 집단의 값이 다른 집단보다 더 높은 순위를 차지하는 경향이 있음을 알려줄 뿐, 평균이 더 높다는 뜻은 아닙니다. 차이의 방향을 설명하려면 평균이 아니라 각 집단의 중앙값을 보세요.
두 검정은 동일한 문제(두 집단 비교)를 해결하지만 방식이 다르며, 잘못 선택하면 결과에 영향을 줍니다.
t-검정은 두 집단의 평균을 비교합니다. 데이터가 정규분포를 따른다는 가정에 기반하며, 이 가정이 성립할 때는 좋은 검정입니다.
문제는 그 가정입니다. 데이터에 왜도가 있거나 표본이 작아 정규성을 확인하기 어렵다면, t-검정의 결과는 신뢰도가 떨어질 수 있습니다. 평균은 극단값의 영향을 크게 받고, p-값이 그 영향을 반영합니다.
다음과 같은 경우 t-검정을 사용하세요:
Mann-Whitney U 검정은 평균이 아니라 분포를 비교합니다. 두 집단의 모든 값을 함께 순위화해 한 집단이 다른 집단보다 일관되게 더 높은 순위를 차지하는지 확인합니다. 순위 기반으로 작동하므로 이상치와 왜도가 결과를 같은 방식으로 왜곡하지 않습니다.
데이터가 실제로 정규분포를 따른다면 t-검정이 차이를 더 신뢰성 있게 탐지합니다. Mann-Whitney U 검정은 더 유연하지만, 그만큼 민감도는 다소 낮습니다.
다음과 같은 경우 Mann-Whitney U 검정을 사용하세요:
두 검정을 빠르게 비교하면 다음과 같습니다:
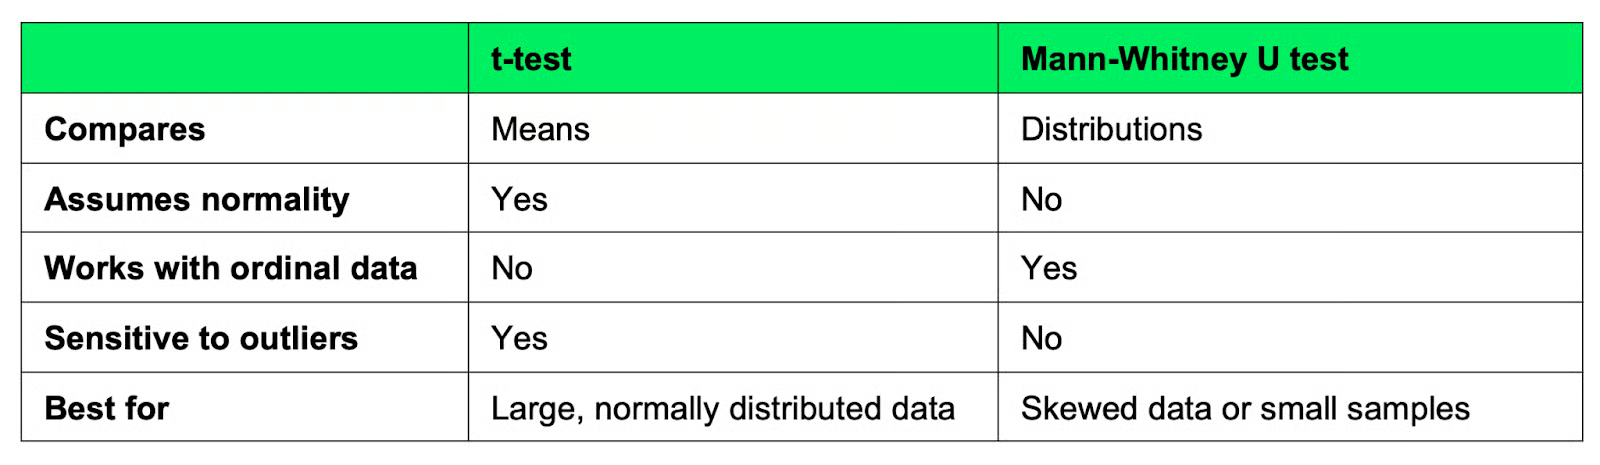
t-검정과 Mann-Whitney U 검정 비교
의심스러울 때는 먼저 분포를 확인하세요. 어느 정도 정규적이면 t-검정을, 그렇지 않다면 Mann-Whitney U 검정을 사용하는 것이 더 안전합니다.
이 검정에서의 대부분의 실수는 실제로 무엇을 하는지 이해하지 못한 데서 비롯됩니다. 자주 보이는 실수는 다음과 같습니다.
가장 흔한 실수입니다. Mann-Whitney U 검정은 평균이 아니라 분포를 비교합니다. 유의한 결과는 한 집단의 값이 다른 집단보다 더 높은 순위를 차지하는 경향이 있음을 뜻할 뿐, 평균이 더 높다는 의미는 아닙니다. 차이를 설명해야 한다면 평균이 아니라 중앙값을 보고하세요.
두 집단의 분포 형태가 다르면(예: 한쪽은 오른쪽으로 치우치고 다른 쪽은 대칭) 결과를 중앙값 비교로 해석할 수 없습니다. 검정은 여전히 실행되지만, 출력은 중심의 이동이 아니라 전체 분포의 차이를 보여줍니다. 중앙값에 대한 결론을 내리기 전에 분포를 확인하세요.
p-값이 0.05 미만이면 차이는 통계적으로 유의합니다. 그러나 차이의 크기나 실무적 의미를 알려주지는 않습니다. 매우 큰 표본에서는 실제 차이가 아주 작아도 유의한 p-값이 나올 수 있습니다. 효과 크기가 중요하다면 별도로 계산하세요.
Mann-Whitney U 검정은 두 개의 독립 집단을 위한 것입니다. 동일 피험자를 두 번 측정했거나 매칭된 쌍과 같은 대응표본 데이터에는 Wilcoxon 부호순위 검정을 사용해야 합니다.
Mann-Whitney U 검정이 모든 상황에 적합한 도구는 아닙니다. 다음과 같은 경우에는 다른 방법을 사용하세요.
동일한 피험자가 두 집단 모두에 등장한다면(사전-사후 측정, 매칭된 쌍 등) 두 표본은 독립이 아닙니다. Mann-Whitney U 검정은 독립을 가정하므로, 이를 사용하면 관측치 간의 관계를 무시하게 되어 신뢰할 수 없는 결과가 나옵니다. 대신 Wilcoxon 부호순위 검정을 사용하세요.
Mann-Whitney U 검정은 한 번에 두 집단만 비교합니다. 세 집단 이상을 비교하려면 일원 분산분석의 비모수적 대안인 Kruskal-Wallis 검정을 사용하세요. 여러 집단을 처리할 수 있습니다.
Mann-Whitney U 검정의 주요 장점은 정규성을 가정하지 않는다는 점입니다. 데이터가 정규분포를 따르고 표본이 충분히 커서 이를 확인할 수 있다면 t-검정이 더 나은 선택입니다. 그 상황에서는 통계적 검정력이 더 커 실제 차이가 있을 때 이를 더 잘 탐지합니다.
Mann-Whitney U 검정은 데이터가 정규분포를 따르지 않아 t-검정이 적합하지 않을 때 훌륭한 해결책입니다.
원시 값 대신 순위를 사용하므로, 왜도가 크거나 표본이 작은 데이터에서 모수 검정을 불안하게 만드는 가정을 피할 수 있습니다. 현실 세계의 분석에서 데이터는 기대처럼 움직이지 않는 경우가 많기 때문에 유용한 검정입니다.
여기서 더 큰 교훈은 검정 선택입니다. 모든 데이터셋에 맞는 단 하나의 검정은 없습니다. 항상 먼저 데이터의 분포, 구조, 표본 크기를 확인하고, 그 특성에 맞춰 방법을 선택해야 합니다. 정답은 데이터에 맞는 검정입니다.
통계를 처음 접하시거나 더 깊이 공부하고 싶다면, Statistician in R 트랙을 통해 52시간 분량의 자료로 실무 준비를 갖출 수 있습니다.
DataCamp와 함께 학습하세요
강의
트랙
실습 문제하고 트랙하세요.
Google로 계속하기