Courses
Claude Code 101
3小时
26.3K
Claude Code Review 是一套多代理的代码评审系统,会在仓库上下文中检查 PR,并报告潜在的 Bug、安全问题与回归。GitHub Code Review 会在 GitHub PR 上运行这些代理,而本地 /code-review 则直接从 Claude Code 为您当前的 diff 提供评审。
这里的关键词是“上下文”。传统的 diff 评审让人只看变更的行。Claude 的评审代理会在仓库上下文中审视这些变更。GitHub 工作流包含多个并行的专业化代理,随后进行验证、去重与严重性分级。
例如,对 pandas 转换的 10 行更改,可能依赖上游 dbt 模型创建的 schema、Snowflake 表的粒度,以及下游仪表板中的假设。
Claude 既不会批准也不会阻止 PR。GitHub Code Review 报告的是中立检查结论,因此现有的分支保护规则不会改变,除非您基于检查输出自建 CI 逻辑。
当前有 3 种主要方式使用 Claude Code 进行代码评审。
|
评审载体 |
运行位置 |
最佳用途 |
当前可用性 |
|
|
您的 Claude Code 会话 |
开发过程中的快速反馈 |
任意付费方案可用 |
|
GitHub Code Review |
Anthropic 基础设施 |
自动化 PR 评审与行内评论 |
Team 与 Enterprise 研究预览(Zero Data Retention 不可用) |
|
|
远程云沙箱 |
更深入的合并前评审 |
研究预览,需要 claude.ai 认证 |
本地 /code-review 命令会检查您分支的提交。您也可以指定具体文件、分支、PR 编号或 Git 引用范围。
GitHub Code Review 围绕 PR 本身设计。根据仓库配置,它可以在 PR 创建后评审一次、每次推送后评审,或仅在有人用 @claude review 请求评审时才运行。
/code-review ultra 是更重的选项。Anthropic 将该功能称为 ultrareview,当您的账户可用时,/ultrareview 作为别名同样可用。它会在远程沙箱中运行一组评审代理,每条报告的 Bug 在进入发现列表前都已被复现与验证。目前这是研究预览,典型评审耗时约 5 至 10 分钟。
Claude Code Review 首先关注正确性。Anthropic 的文档明确区分对生产有影响的 Bug 与格式偏好、缺失测试覆盖等问题。
发现分为 3 个严重级别:
|
严重性 |
含义 |
数据管道示例 |
|
🔴 重要 |
合并前应修复的 Bug |
以错误粒度关联订单、导致收入重复 |
|
🟡 细节 |
值得修复的次要问题,但不阻塞 PR |
令人困惑的变量名,例如 df2 |
|
🟣 既有 |
当前 PR 之前就已存在的 Bug |
一个已存在的辅助函数暴露了客户标识符 |
这种区分很有用,因为数据科学家对哪些问题值得评审时间往往看法迥异。比如关于 revenue_df 与 weekly_revenue 的命名建议,和因为一次多对多关联溜进了转换而把收入翻倍,这两类问题完全不是一个量级。
根据您需要本地评审还是 GitHub PR 评审,设置步骤不同。本地 /code-review 无需 GitHub 应用,甚至可以在您尚未打开 PR 前就完成。
GitHub Code Review 则需要组织的 Owner 或 Primary Owner 配置 Claude GitHub 应用并选择仓库。进行 PR 评审时,您还应创建名为 REVIEW.md 的专用文件,存放评审专属规则。
CLAUDE.md 与 REVIEW.md 用途不同,将其混在一起很容易造成噪声评审。
CLAUDE.md 包含 Claude 在各类任务中使用的通用项目说明。代码评审同样会读取这些说明,并将新引入的违规报告为细节(nit)。而 REVIEW.md 专门用于评审行为,告诉评审代理您团队希望标注、跳过或按“重要”处理的事项。
对于一个 Python 数据仓库,我会让 CLAUDE.md 聚焦于仓库结构、如何运行 pytest、转换使用 pandas 还是 polars、以及 SQL 模型的位置等。
我会把评审规则放在 REVIEW.md。一些可能的规则示例:
一个小型的 REVIEW.md 可能如下:
# Review instructions

## Important findings

Report as Important:
- Incorrect joins or filters that can change dataset grain
- Missing tenant or customer scoping
- Secrets or credentials written to logs
- Silent changes to revenue or customer metrics

## Do not report
- Formatting already enforced by Ruff
- Generated files
- *.lock files

## Always check
- New transformations have tests
- Joins use the intended keys
- Datetime operations specify timezone assumptions
- Missing values are handled explicitly
我建议让 REVIEW.md 保持聚焦,因为指令太长会稀释重要规则。当前实现也将该文件作为纯指令读取,因此请直接写入规则,而不要使用 @ 快捷方式。
另外,在本地开发时,/code-review 不会读取 REVIEW.md。它遵循 CLAUDE.md,而 GitHub Code Review 流水线会使用 REVIEW.md 作为评审专属指令。
如果您希望本地与 GitHub 遵循相同的评审规则,请将通用规则写入 CLAUDE.md,并在需要时在 REVIEW.md 中重复评审专属规则。
想更深入了解,推荐阅读我们的CLAUDE.md 最佳写作指南。
GitHub Code Review 由组织的 Owner 或 Primary Owner 通过 Claude 的管理设置进行配置。管理员需要安装 Claude GitHub 应用,授予仓库访问权限,选择要评审的仓库,然后为每个仓库指定评审行为。
有 3 种触发模式:
|
触发方式 |
行为 |
成本影响 |
|
PR 创建后一次 |
在 PR 打开或就绪时评审 |
每个 PR 一次评审 |
|
每次推送后 |
每次新推送都评审 |
评审频率与成本最高 |
|
手动 |
仅在请求时运行 |
您可控制何时消耗用量 |
三种模式有一个共同例外:Claude 从不自动评审来自 fork 的 PR。必须有人在其下评论 @claude review。
截至 2026 年 7 月的更新,手动命令也发生了变化:
@claude review 启动一次评审,不会订阅该 PR 的后续推送。
@claude review always 启动评审并订阅该 PR,后续推送会触发评审。
@claude review once 与裸命令行为一致。
如果您在 2026 年更早的时候学习过 Claude Code Review,旧教程可能会说 @claude review 会订阅后续评审,但该行为已在 2026 年 7 月更改,并在 2026 年 9 月仍为现状。
未接入组织层面的 GitHub Code Review 的 Pro 与 Max 用户,可以完全跳过该应用,改用本地 /code-review,并在需要更深入评审时使用 /code-review ultra。
/code-review 本地评审一个 diff?本地 /code-review 命令会在您打开 PR 之前对当前分支进行评审。我总是从这里开始,因为它能在我仍在开发时捕捉问题,避免 CI 失败。
假设我们有一个电商仓库,订单表包含 order_id、customer_id、order_date、status 和 revenue,我们创建 weekly_revenue.py 来计算每周收入:
orders = load_orders()
customers = load_customers()

# Derive the reporting week from the order date
orders["week"] = orders["order_date"].dt.to_period("W").dt.start_time

weekly_revenue = (
    orders
    .merge(customers, on="customer_id", how="inner")
    .groupby("week", as_index=False)["revenue"]
    .sum()
)乍看之下没有任何异常。merge() 写得清楚、分组逻辑可读,并且在关联后对收入进行聚合。
问题在于客户表对部分客户包含多条历史记录。对于拥有 2 条记录的客户,关联后会产生 2 行,从而使该客户对应的收入翻倍。这正是那种如果不检查表的粒度、只在本地阅读转换代码就很容易忽略的 Bug。
在您的 Claude Code 会话中运行 /code-review。
该命令会评审当前分支相对其上游分支的提交,以及未提交的更改。您也可以针对某个文件、分支、PR 或范围(如 main...feature/weekly-revenue)。
例如:
/code-review weekly_revenue.py或:
/code-review main...feature/weekly-revenue您也可以传入努力级别,例如 /code-review high。在 low 与 medium 下,评审只报告最有把握的发现;而 high 到 max 会扩大覆盖范围,但可能带来更多误报。
熟悉工作流后,有两个标志很实用:
--fix 会在评审后将发现应用到您的工作树。
--comment 会将发现作为行内评论发布。
Claude 将评审作为后台子代理运行,因此在处理期间您可以继续工作。评审完成后,发现会返回到您的会话中。
评审可能会报告如下内容:
🔴 Important
weekly_revenue.py:9

The merge on customer_id can duplicate order rows because
customers contains multiple records per customer. This can
inflate revenue when a customer has more than one matching
customer record.

Verify that customer_id is unique in customers or join against
the intended current-record subset before aggregating revenue.
评审指出了一个具体的失败模式,并给出可根据实际 schema 验证的建议,而不是让我盲目相信 Claude 的判断。
在运行 /code-review --fix 之前,我仍会手动过一遍。首先搜索构建 customers 的代码,检查其唯一性约束,并查看 weekly_revenue.py 周边的测试。
如果 customers.customer_id 的确唯一,那么 Claude 的发现就是误报。如果该表是每个客户按生效日期一行,那么发现为真,转换需要更改。
这里的关键是 Claude 的评审者关注代码行为,而我仍需了解数据所代表的含义。
您可以在评审后让 Claude 继续调查:
Investigate the customer_id join finding.
Check how the customers table is built and determine whether
customer_id is unique at the point of this merge. Do not modify
the code yet.
这一步往往比让 Claude 盲目修复评论更有用。它让评审变成一次简短的调查,而不是代码生成练习。
GitHub Code Review 会将 Claude 的发现直接贴在 PR 上,评审者可以在变更代码旁看到问题。
顺序很重要,因为评审附着于已存在的 PR:
通过 git push 将 weekly-revenue 分支推送到 GitHub。
打开拉取请求。Claude 只能评审已打开的 PR,因此在此之前不会发生任何事。
如果仓库设置为自动触发,评审会自动启动。如果设置为手动,请在 PR 的顶层评论中发布 @claude review 以启动。
这里有三个常见的坑。命令必须是顶层 PR 评论,而非对行内评审评论的回复;您需要具备仓库的写、维护或管理员权限;命令还必须放在评论的开头,如果加上 once 或 always,应与命令在同一行。
真正影响花费的选择在两条手动命令之间,而非在手动与自动之间。
@claude review 会运行一次评审并保持未订阅。@claude review always 会运行评审并订阅该 PR,后续每次推送都会启动新的评审。
这是一项 2026 年 7 月之后、截至 2026 年 9 月仍然有效的行为变更。在此之前,裸 @claude review 命令会订阅后续评审,因此如果您在看旧教程,请先核对这一点。
评审通常耗时约 20 分钟,尽管 Anthropic 表示成本与时长取决于 PR 的大小与复杂度。每次评审也会单独通过用量积分计费,而不是消耗 Team 或 Enterprise 方案所含用量。若您想了解更多成本结构,推荐阅读我们的Claude Code 用量限制指南。
评审完成后,Claude 会在相关代码行贴上行内评论。GitHub 的检查运行也会包含严重性摘要,这在一个 PR 涉及 weekly_revenue.py、SQL 模型与测试文件多项发现时很有用。
例如:
|
严重性 |
文件 |
发现 |
|
🔴 重要 |
weekly_revenue.py:9 |
连接可能会复制订单行 |
|
🟡 细节 |
weekly_revenue.py:12 |
变量名未体现聚合层级 |
|
🟣 既有 |
utils/dates.py:42 |
已有的时区假设 |
我会在行内评论处调查具体问题,而在检查运行结果中把握评审全貌。
需要注意的是,点选 👍 或 👎 不会触发新一轮评审,回复行内评论也不会让 Claude 回应。若要再次评审,请修复代码并推送,或发布新的顶层 PR 评论 @claude review。
评审本身也不会阻止合并。检查给出的是中立结论,不过检查输出包含机器可读的严重性信息,如果团队希望构建自己的合并闸门,可以通过 gh 与 jq 消费这些信息。
整个要点是在评审周期中保持人类在环。这意味着每次 Claude 评审都需要判断每条发现是实际 Bug、非阻塞改进,还是误报。这是因为代码评审者可以检查实现行为,但未必了解数据集或指标背后的所有业务假设。
我使用一个简单的三向决策:
|
决策 |
时机 |
示例 |
|
修复 |
发现为真且会改变输出 |
客户关联复制了订单行 |
|
跳过 |
真实但不值得为其阻塞 |
关于重命名 |
|
驳回 |
真实但不值得为其阻塞 |
|
最后一类很重要。报告 30 条发现的评审者不一定比只报告 5 条的更好。关于 pandas 合并的误报评论,可能比原始代码改动更费时。
如果客户行重复的 Bug 为真,我可能会请 Claude 检查上游模型,然后做如下修复:
The customer_id finding is valid. Inspect the existing customer
model and update weekly_revenue.py to join only the current
customer record. Add a regression test for a customer with
multiple historical records, then run the relevant tests.
随后 Claude 可以检查仓库、修改 Python 代码、添加测试并运行测试套件。
如果您希望基于 GitHub 评审评论开展工作,Claude Code 也可以通过GitHub CLI(gh)与仓库交互。重要的是,我会挑选那些您认为有效的具体修复,而不是把整份评审都交给它“全部修复”。
这能让开发者始终处于评审环中:
这个闭环比把第一次评审输出当作自动重构队列安全得多。
Claude 无法覆盖的失效模式是:代码运行正确,但做错了事。这种情况反复出现的三种版本:
存在于 diff 之外的假设。Claude 读的是您的仓库,而不是数据仓库、配置服务,或其他团队维护的契约。一次关联可以使用正确键,但仍改变结果的粒度,因为每个键对应的行数是上游表的属性,而非眼前代码的属性。
只有您团队掌握的定义。收入应按订单、客户还是周来计,是业务决策。Claude 能告诉您 groupby() 会愉快地对给定的行求和,但它不知道贵司财务认可哪个数字。
时间与类型假设。2026-08-27 是 UTC 自然日、本地工作日,还是由上游模型设定的报表日?静默类型转换同样棘手:在对象、可空整数、带时区的日期时间与字符串列之间进行操作,可能返回看似合理的结果,却悄悄改变了比较行为。
数据泄漏是第一类中最尖锐的例子。一次特征转换可能把训练集与仅在预测日期之后才出现信息的表关联起来。关联有效、行数符合预期,但模型已被污染。
因此我把 Claude 当作实现行为的评审者,而非定义的所有者。
使用 /code-review 获得快速本地反馈,而 /code-review ultra 用于更深入的合并前检查。两者都评审代码,但 /code-review 面向迭代,而 ultra 评审会运行多个远程代理,并对所报告的 Bug 进行独立验证。
|
|
|
|
|
位置 |
本地 Claude Code 会话 |
远程云沙箱 |
|
评审风格 |
单一本地评审流程 |
多代理评审并独立验证 |
|
典型时长 |
数秒到数分钟 |
约 5 至 10 分钟 |
|
成本 |
常规 Claude Code 用量 |
Pro/Max 免费 3 次,其后 $5 至 $25 用量积分 |
|
最佳阶段 |
开发过程中 |
合并重大变更前 |
|
GitHub PR |
可针对某个 PR |
可按 PR 编号评审 |
|
认证 |
Claude Code 认证 |
需要 claude.ai 账户 |
Anthropic 目前将 ultra 评审描述为研究预览。Pro 与 Max 订阅者一次性获得 3 次免费运行,且不刷新;其后一次评审通常花费 $5 至 $25,取决于变更规模。Team 与 Enterprise 用户不享有这些免费运行,且该功能在 Amazon Bedrock、Google Cloud 的 Agent Platform、Microsoft Foundry,以及启用 Zero Data Retention 的组织中不可用。
重要差异在于“验证”。/code-review ultra 会将仓库状态发送到远程沙箱,运行一组评审代理,并在报告返回为发现前独立复现 Bug。
我不会在每次提交上都运行它。如果我只是调整 Python 笔记本中的变量名,或微调 dbt 模型格式,本地 /code-review 已足够。如果我在更改生产模型的特征生成逻辑、重写收入转换,或修改客户级别聚合,那么更深一层的评审更合理。
还有一个值得注意的命名细节。文档中的命令是 /code-review ultra,/ultrareview 是当 ultrareview 对您的账户可用时的别名。旧教程常将 /ultrareview 作为主命令,但 Anthropic 的文档现在将深度云评审视为 /code-review 命令族的一部分,并且当云功能不可用时,/code-review ultra 会回退为本地评审。
在仓库中运行:
/code-review ultra直接评审某个 GitHub PR:
/code-review ultra <pr#>不带参数时,/code-review ultra 会比较您当前分支与默认分支,并包含未提交与暂存的更改。按默认设置,分支评审约上限为 500 个变更文件与 8,000 行变更,尽管 Anthropic 指出这些数字可能变化。如果 diff 过大,请推送分支并改为作为 PR 进行评审。
传入 PR 编号时,远程环境会从 GitHub 克隆该 PR,不会从您的机器上传任何内容。
开始之前,Claude 会展示评审范围、剩余免费次数与预估费用。确认后,评审在后台运行,因此您可以在远程代理工作时继续使用 Claude Code。
针对我们的 weekly_revenue.py 示例,我会比较两次评审的发现,而不是假设更深入的评审必然正确。
如果 /code-review 标注了客户关联问题,而 ultra 评审也独立复现了相同的收入重复,我对该发现的信心会更强。如果 ultra 评审忽略了它,原因是上游表保证唯一性,那么在改代码前,我会核查两次评审给出的证据与实际模型定义。
这正是多位评审者的价值:分歧会给您带来值得调查的线索。
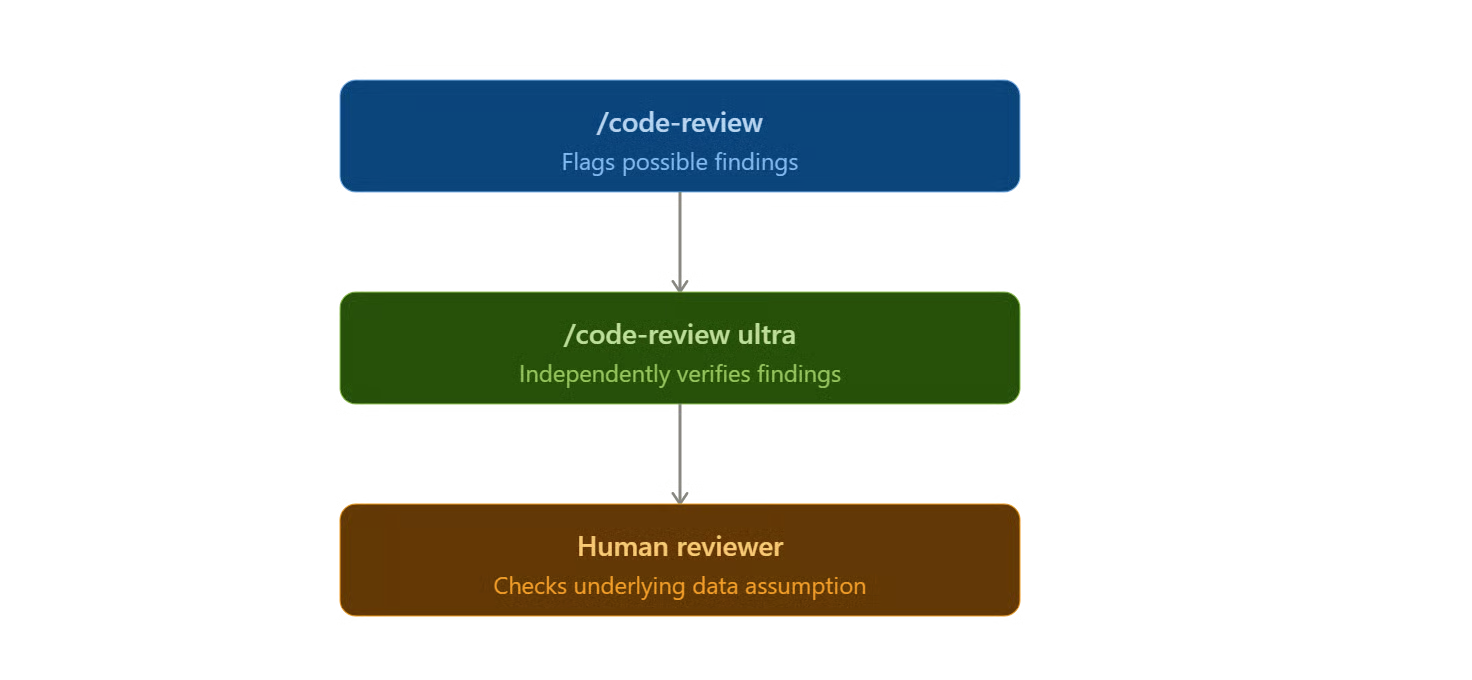
另一个考虑是成本。GitHub Code Review 目前平均每次 $15 至 $25,而 ultra 评审在用完 Pro 与 Max 的免费次数后通常为 $5 至 $25。GitHub Code Review 的费用独立于套餐内用量,Anthropic 为组织提供支出控制。
如果您独立工作,本地 /code-review 加上偶尔的 /code-review ultra 是一个合理的入门工作流。如果您处于 Team 或 Enterprise 方案,并希望每个 PR 都附带自动评审,那么 GitHub Code Review 更合适。
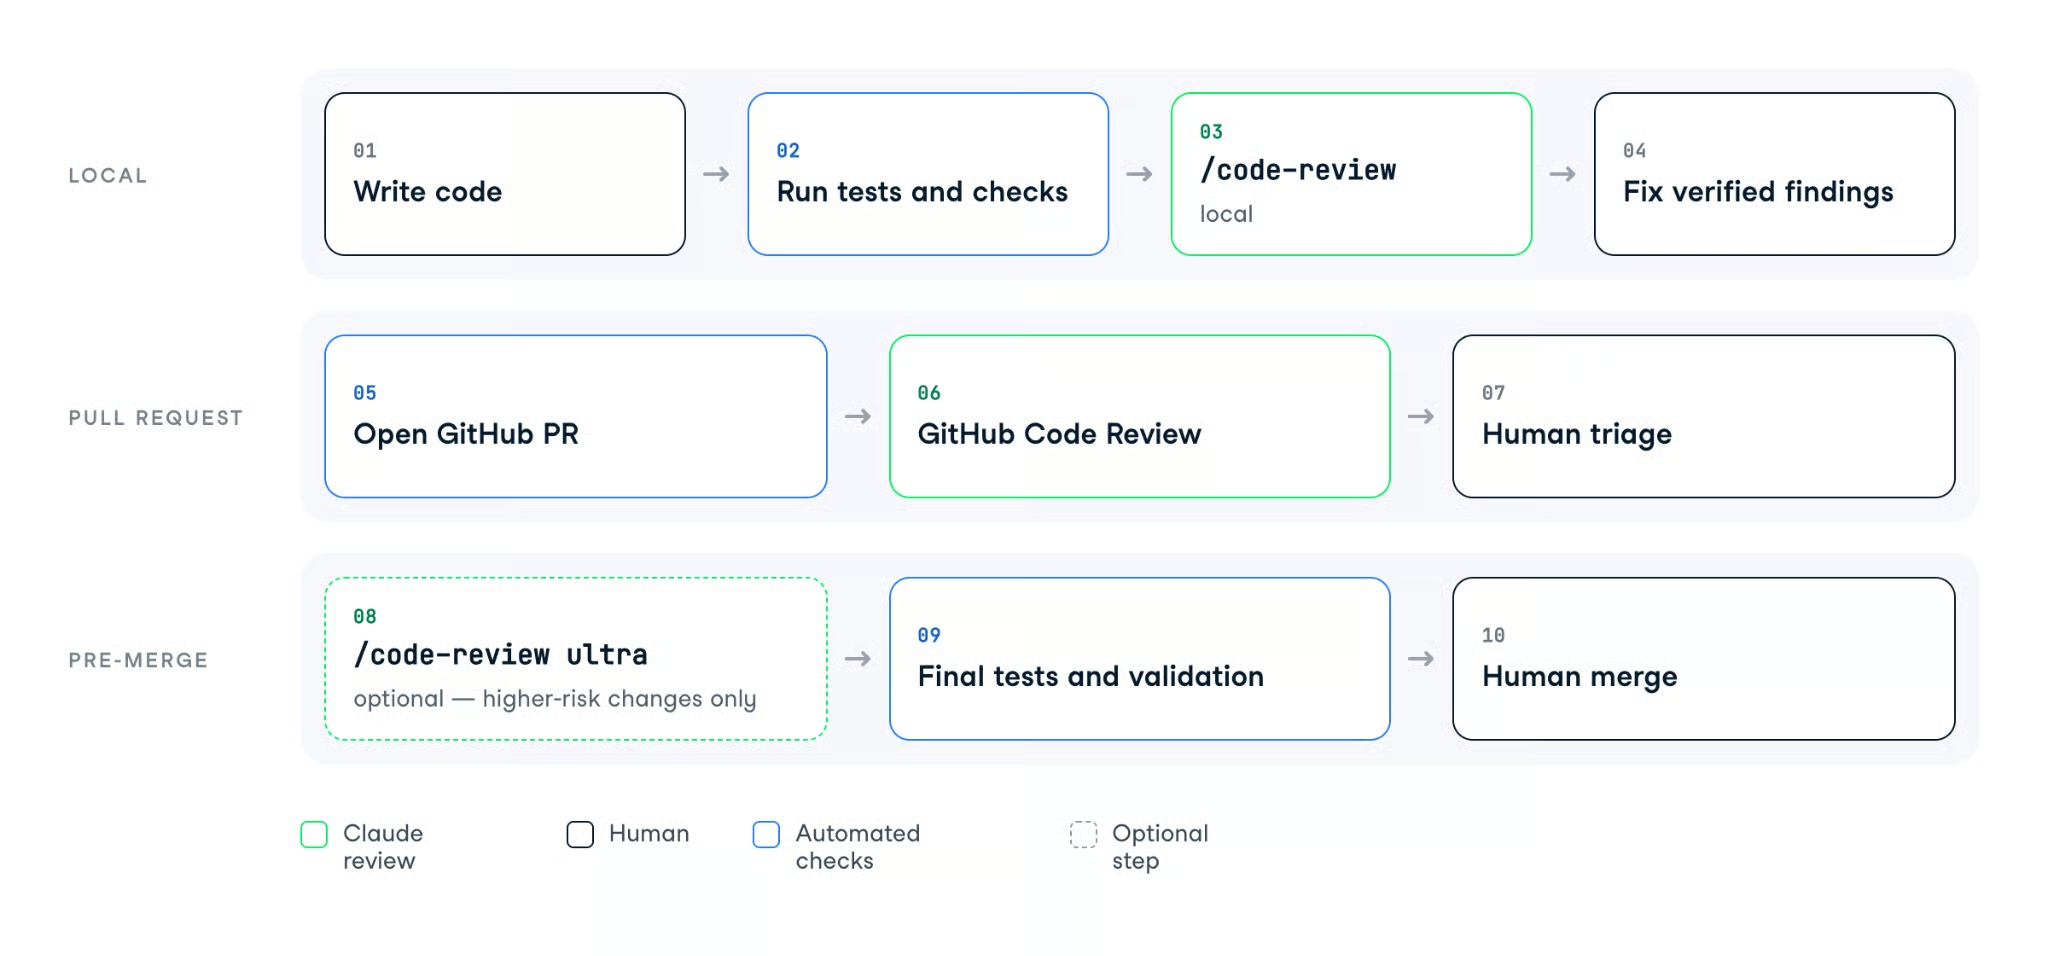
有用的工作流并不是“每次合并前都跑 Claude”。而是在开发的不同阶段进行不同类型的评审,因为每一步的成本不同、能捕获的问题类型也不同。
对于一个生产变更,我会这样做:
Write code
	   ↓
Run tests and data checks
	   ↓
/code-review
	   ↓
Fix verified findings
	   ↓
Open GitHub PR
	   ↓
GitHub Code Review
	   ↓
Human triage
	   ↓
/code-review ultra for higher-risk changes
	   ↓
Final tests
	   ↓
Human merge
本地评审能在问题修复成本最低时及时发现。GitHub 评审为更广的团队提供一份共享的发现记录,而 ultra 评审则在关键合并前给出更高投入的第二意见。
对于数据工作,我会在 Claude 之外再加 4 项检查,而不是指望模型完成整个评审:
Claude 可以参与以上 4 项,但期望的结果应来自代码、测试或数据,而非 Claude 的解释。
当我把 Claude Code Review 当作评审线程中的另一位工程师,而不是自动批准戳时,它的效果最佳。
本地 /code-review 命令可在 PR 尚未存在时快速评审。GitHub Code Review 将多代理的发现带入 Team 与 Enterprise 组织的 PR 中,而 /code-review ultra 则在值得二次把关的变更上提供更深入的远程评审。
我建议从小处开始。把 /code-review 纳入您的常规分支工作流,为 GitHub 评审写一份简短的 REVIEW.md,并在那些错误合并会带来实质代价的变更上试试 /code-review ultra。
关于底层模型概念,我们的Claude 模型导论课程提供更广泛的背景;GitHub 基础与GitHub 进阶概念涵盖 Code Review 所依托的 Git 与 GitHub 工作流。若想进一步了解如何用 Claude 分诊 GitHub 仓库,也推荐阅读我们的Claude Code 连接器教程。
与 Claude Code 一起玩转 Vibecoding
Courses
Courses
Courses