Cours
Claude Code 101
3 h
26.3K
Claude Code Review est un système de relecture multi-agents qui étudie une PR dans le contexte du dépôt et signale des bugs potentiels, des failles de sécurité et des régressions. GitHub Code Review exécute ces agents sur une PR GitHub, tandis que le /code-review local vous fournit une relecture de votre diff en cours directement depuis Claude Code.
Le mot clé ici est contexte. Une relecture classique de diff demande d'inspecter les lignes modifiées. Les agents de Claude examinent ces changements dans le contexte du dépôt. Le workflow GitHub s'appuie sur plusieurs agents spécialisés en parallèle, puis une vérification, une déduplication et un classement par sévérité.
Par exemple, une modification de 10 lignes sur une transformation pandas peut dépendre du schéma produit par un modèle dbt en amont, du grain d'une table Snowflake, et d'hypothèses intégrées dans un tableau de bord en aval.
Claude n'approuve ni ne bloque une PR. GitHub Code Review publie un check neutre : vos règles de protection de branche existantes restent inchangées, sauf si vous construisez votre propre logique CI autour de la sortie du check.
Il existe aujourd'hui 3 façons principales de relire du code avec Claude Code.
|
Surface de revue |
Où elle s'exécute |
Meilleur usage |
Disponibilité actuelle |
|
|
Votre session Claude Code |
Retour rapide pendant le développement |
Disponible avec tout forfait payant |
|
GitHub Code Review |
Infrastructure Anthropic |
Revue automatisée de PR avec commentaires inline |
Aperçu Team et Enterprise (indisponible avec Zero Data Retention) |
|
|
Bac à sable cloud distant |
Relecture pré-merge approfondie |
Aperçu de recherche, authentification claude.ai requise |
La commande /code-review locale analyse les commits de votre branche. Vous pouvez aussi lui passer un fichier, une branche, un numéro de PR, ou un intervalle de références Git.
GitHub Code Review est conçu autour de la PR elle-même. Selon la configuration du dépôt, il peut lancer une revue à la création, à chaque push, ou uniquement sur demande via @claude review.
/code-review ultra est l'option la plus lourde. Anthropic appelle cette fonctionnalité ultrareview, et /ultrareview fonctionne comme alias si votre compte y a accès. Elle exécute une flotte d'agents de revue dans un bac à sable distant, chaque bug signalé étant reproduit et vérifié avant d'apparaître dans les constats. C'est pour l'instant un aperçu de recherche, une revue typique durant de 5 à 10 minutes.
Claude Code Review privilégie d'abord la justesse. La documentation d'Anthropic distingue clairement les bugs qui impactent la production des préférences de formatage et du manque de couverture de tests.
Les constats utilisent 3 niveaux de sévérité :
|
Sévérité |
Signification |
Exemple pour une data pipeline |
|
🔴 Important |
Un bug à corriger avant le merge |
Jointure au mauvais grain dupliquant le revenu |
|
🟡 Nit |
Détail mineur à corriger, non bloquant pour la PR |
Nom de variable ambigu, par exemple df2 |
|
🟣 Préexistant |
Bug déjà présent avant la PR |
Un helper existant qui expose un identifiant client |
Cette distinction est utile, car les data scientists ont souvent des avis divergents sur ce qui mérite du temps de revue. Une suggestion de nommage entre revenue_df et weekly_revenue n'est pas de la même nature que doubler un chiffre d'affaires à cause d'une jointure many-to-many glissée dans une transformation.
La configuration de Claude Code Review varie selon que vous souhaitez une revue locale ou sur PR GitHub. Le /code-review local ne nécessite pas l'application GitHub et peut s'utiliser avant même d'ouvrir une PR.
GitHub Code Review requiert qu'un Owner ou Primary Owner de l'organisation configure l'application GitHub de Claude et sélectionne les dépôts. Pour les revues de PR, il est préférable de créer un fichier spécifique, REVIEW.md, contenant des règles dédiées à la revue.
CLAUDE.md et REVIEW.md ont des finalités différentes, et les mélanger est un bon moyen de créer du bruit inutile.
CLAUDE.md contient des consignes générales de projet utilisées par Claude pour divers usages. La relecture lit aussi ces consignes, et les violations nouvellement introduites sont signalées comme nits. REVIEW.md, lui, est spécifique au comportement de revue et indique aux agents ce que votre équipe souhaite signaler, ignorer ou étiqueter comme Important.
Pour un dépôt data en Python, je garderais CLAUDE.md centré sur la structure du repo, comment exécuter pytest, si les transformations utilisent pandas ou polars, et où vivent les modèles SQL.
Je mettrais les règles de relecture dans REVIEW.md. Quelques exemples :
Un petit REVIEW.md pourrait ressembler à ceci :
# Review instructions

## Important findings

Report as Important:
- Incorrect joins or filters that can change dataset grain
- Missing tenant or customer scoping
- Secrets or credentials written to logs
- Silent changes to revenue or customer metrics

## Do not report
- Formatting already enforced by Ruff
- Generated files
- *.lock files

## Always check
- New transformations have tests
- Joins use the intended keys
- Datetime operations specify timezone assumptions
- Missing values are handled explicitly
Je recommande de garder REVIEW.md concis, car des consignes trop longues diluent les règles importantes. L'implémentation actuelle lit également le fichier comme un texte d'instructions, donc mettez les règles directement dedans plutôt que d'utiliser le raccourci @.
Au passage, en développement local, /code-review ne lit pas REVIEW.md. Il suit CLAUDE.md, tandis que le pipeline GitHub Code Review s'appuie sur REVIEW.md pour les instructions spécifiques à la revue.
Si vous souhaitez les mêmes règles de revue en local et sur GitHub, mettez les règles générales dans CLAUDE.md et répétez au besoin les règles spécifiques dans REVIEW.md.
Pour aller plus loin, consultez notre guide pour rédiger un excellent fichier CLAUDE.md.
GitHub Code Review est configuré par un Owner ou Primary Owner via les paramètres d'administration de Claude. L'admin doit installer l'application GitHub Claude, lui accorder l'accès aux dépôts, sélectionner les dépôts à relire, puis attribuer un comportement de revue à chaque dépôt.
Il existe 3 modes de déclenchement :
|
Déclencheur |
Comportement |
Impact coût |
|
Une fois à la création de la PR |
Lance une revue à l'ouverture ou quand elle devient prête |
Une revue par PR |
|
Après chaque push |
Relit à chaque nouveau push |
Fréquence et coût de revue les plus élevés |
|
Manuel |
N'exécute qu'à la demande |
Vous contrôlez quand la revue consomme de l'usage |
Une exception commune aux 3 : Claude ne relit jamais automatiquement une PR provenant d'un fork. Quelqu'un doit commenter @claude review dessus.
Depuis la mise à jour de juillet 2026, les commandes manuelles ont également changé :
@claude review lance une seule revue et n'abonne pas la PR aux futurs pushes.
@claude review always lance une revue et abonne la PR aux futures revues déclenchées par push.
@claude review once se comporte comme la commande seule.
Si vous avez appris Claude Code Review plus tôt en 2026, d'anciens tutoriels peuvent indiquer que @claude review abonne la PR aux revues futures, mais ce comportement a changé en juillet 2026 et reste valable en septembre 2026.
Les utilisateurs Pro et Max qui n'ont pas accès au GitHub Code Review de l'organisation peuvent ignorer l'application et utiliser /code-review en local, avec /code-review ultra pour une revue plus poussée.
/code-review ?La commande locale /code-review relit votre branche actuelle avant d'ouvrir une PR. Je commence toujours par là, car elle détecte des problèmes pendant que je travaille encore et peut éviter des échecs CI.
Supposons un dépôt e-commerce avec une table des commandes contenant order_id, customer_id, order_date, status et revenue, et que nous créions weekly_revenue.py pour calculer le revenu hebdomadaire :
orders = load_orders()
customers = load_customers()

# Derive the reporting week from the order date
orders["week"] = orders["order_date"].dt.to_period("W").dt.start_time

weekly_revenue = (
    orders
    .merge(customers, on="customer_id", how="inner")
    .groupby("week", as_index=False)["revenue"]
    .sum()
)
A priori, rien d'anormal. Le merge() est explicite, le groupby lisible, et le revenu est agrégé après la jointure.
Le problème : la table clients contient plusieurs enregistrements historiques pour certains clients. Un client avec 2 lignes génère désormais 2 lignes après la jointure, doublant le revenu associé à ce client. C'est typiquement le genre de bug facile à manquer quand on lit la transformation localement sans vérifier le grain de la table.
Depuis votre session Claude Code, lancez /code-review.
La commande relit les commits de votre branche en avance sur sa branche amont, ainsi que les changements non commités. Vous pouvez aussi cibler un fichier, une branche, une PR ou un intervalle, par exemple main...feature/weekly-revenue.
Par exemple :
/code-review weekly_revenue.pyou :
/code-review main...feature/weekly-revenueVous pouvez également passer un niveau d'effort, comme /code-review high. En low et medium, la revue ne remonte que les constats les plus probables, tandis que high à max élargit la couverture au prix de quelques faux positifs supplémentaires.
Une fois à l'aise avec le flux, deux options deviennent très utiles :
--fix applique les correctifs dans votre working tree après la revue.
--comment publie les constats en commentaires inline.
Claude exécute la revue en arrière-plan comme un sous-agent, vous pouvez donc continuer à travailler pendant le traitement. Les constats reviennent dans votre session une fois la revue terminée.
La revue pourrait signaler quelque chose de ce genre :
🔴 Important
weekly_revenue.py:9

The merge on customer_id can duplicate order rows because
customers contains multiple records per customer. This can
inflate revenue when a customer has more than one matching
customer record.

Verify that customer_id is unique in customers or join against
the intended current-record subset before aggregating revenue.
La revue a trouvé un mode d'échec concret et me donne de quoi vérifier face au schéma réel, plutôt que de me demander de faire confiance à son jugement.
Je passerais tout de même en revue manuellement avant d'exécuter /code-review --fix. Commencez par chercher le code qui construit customers, inspectez ses contraintes d'unicité, et regardez les tests autour de weekly_revenue.py.
Si customers.customer_id est vraiment unique, le constat de Claude est un faux positif. Si la table contient une ligne par client et par date d'effet, le constat est réel et la transformation doit changer.
L'essentiel : le relecteur de Claude examine le comportement du code, tandis que je reste responsable de la signification des données.
Vous pouvez demander à Claude d'investiguer après la revue :
Investigate the customer_id join finding.
Check how the customers table is built and determine whether
customer_id is unique at the point of this merge. Do not modify
the code yet.
Cette seconde étape est souvent plus utile que de demander à Claude de corriger à l'aveugle. Elle transforme la revue en brève investigation plutôt qu'en génération de code.
GitHub Code Review place les constats de Claude directement sur la PR, pour que les relecteurs voient le problème au pied du code modifié.
L'ordre compte, car la revue s'attache à une PR déjà existante :
Poussez la branche weekly-revenue sur GitHub via git push.
Ouvrez la pull request. Claude ne peut relire qu'une PR ouverte : rien ne se passe avant.
Si le dépôt est en mode automatique, la revue démarre seule. En mode Manuel, postez @claude review en commentaire de PR (niveau supérieur) pour la lancer.
Trois prérequis piègent souvent : la commande doit être un commentaire de premier niveau (pas une réponse à un commentaire inline), vous devez avoir les droits write, maintain ou admin sur le dépôt, et la commande doit démarrer le commentaire, avec once ou always sur la même ligne s'ils sont ajoutés.
Le choix qui a un impact financier se fait entre les deux commandes manuelles, pas entre manuel et automatique.
@claude review lance une revue et laisse la PR non abonnée. @claude review always lance une revue et s'abonne à la PR : chaque push ultérieur en déclenchera une nouvelle.
C'est le comportement depuis juillet 2026 et en septembre 2026. Avant, la commande @claude review abonnait la PR aux revues futures ; si vous suivez un ancien tutoriel, vérifiez ce point.
La revue prend souvent environ 20 minutes, même si Anthropic précise que le coût et la durée dépendent de la taille et de la complexité de la PR. Chaque revue est facturée séparément via des crédits d'usage plutôt que de consommer l'usage inclus du plan Team ou Enterprise. Pour en savoir plus sur les coûts, consultez notre guide sur les limites d'usage de Claude Code.
Une fois la revue terminée, Claude publie des commentaires inline sur les lignes concernées. Le check GitHub inclut aussi un récapitulatif de sévérité, utile quand une PR comporte plusieurs constats dans weekly_revenue.py, des modèles SQL et des fichiers de tests.
Par exemple :
|
Sévérité |
Fichier |
Constat |
|
🔴 Important |
weekly_revenue.py:9 |
La jointure peut dupliquer des lignes de commandes |
|
🟡 Nit |
weekly_revenue.py:12 |
Le nom de variable ne décrit pas le niveau d'agrégation |
|
🟣 Préexistant |
utils/dates.py:42 |
Hypothèse de fuseau horaire existante |
Le côté inline est l'endroit où j'investigue le problème concret. Le check me donne la vision d'ensemble de la revue.
Notez que cliquer sur 👍 ou 👎 ne déclenche pas une autre revue, et répondre à un commentaire inline ne fait pas répondre Claude. Pour une nouvelle revue, corrigez le code et poussez, ou postez @claude review en nouveau commentaire de PR de premier niveau.
La revue ne bloque pas non plus le merge par elle-même. Le check a une conclusion neutre, même s'il contient des informations de sévérité lisibles par machine qu'une équipe peut exploiter via gh et jq pour construire son propre verrou de merge.
L'idée est de garder l'humain dans la boucle pendant la revue. Chaque revue de Claude implique donc de décider si chaque constat est un vrai bug, une amélioration non bloquante ou un faux positif. Un relecteur de code peut analyser le comportement d'implémentation sans connaître toutes les hypothèses métier d'un jeu de données ou d'un indicateur.
J'utilise une décision en 3 volets :
|
Décision |
Quand |
Exemple |
|
Corriger |
Le constat est réel et change le résultat |
La jointure client duplique des lignes de commandes |
|
Ignorer |
Réel mais non bloquant |
Un nit proposé pour renommer |
|
Réfuter |
Le constat n'est pas valide |
|
Cette dernière catégorie est importante. Un relecteur qui remonte 30 constats n'est pas nécessairement meilleur qu'un autre qui en remonte 5. Un faux positif sur un merge pandas peut coûter plus de temps que le changement initial.
Si le bug de duplication des lignes client est réel, je peux demander à Claude d'inspecter le modèle amont, puis d'appliquer la correction suivante :
The customer_id finding is valid. Inspect the existing customer
model and update weekly_revenue.py to join only the current
customer record. Add a regression test for a customer with
multiple historical records, then run the relevant tests.
Claude peut alors explorer le dépôt, modifier le code Python, ajouter le test et exécuter la suite de tests.
Si vous souhaitez travailler à partir des commentaires GitHub, Claude Code peut aussi interagir avec le dépôt via le GitHub CLI (gh). L'essentiel est de choisir les correctifs pertinents plutôt que de lui donner « tout corriger » d'un bloc.
Cela garde les développeurs dans la boucle :
Ce cycle est bien plus sûr que de traiter la première sortie de revue comme une file d'attente de refactoring automatisé.
Le risque que Claude ne couvre pas, c'est un code qui tourne correctement mais fait mal le travail. Trois scénarios reviennent souvent :
Des hypothèses en dehors du diff. Claude lit votre dépôt, pas votre data warehouse, votre service de config ni le contrat d'une autre équipe. Une jointure peut utiliser les bonnes clés et quand même changer le grain du résultat : le nombre de lignes par clé est une propriété de la table amont, pas du code sous vos yeux.
Des définitions que seule votre équipe détient. Compter le revenu au niveau de la commande, du client ou de la semaine est une décision métier. Claude peut vous dire que groupby() additionnera tout ce qu'on lui donne, pas quel chiffre votre finance valide.
Des hypothèses de temps et de type. 2026-08-27 signifie-t-il un jour en UTC, un jour ouvré local, ou une date de reporting définie par un modèle amont ? Les coercitions silencieuses ont le même effet : des opérations entre colonnes object, entiers nullable, datetimes avec fuseau et chaînes peuvent renvoyer quelque chose de plausible tout en modifiant discrètement les comparaisons.
La fuite de données est l'exemple le plus saillant du premier cas. Une transformation de features peut joindre un jeu d'entraînement à une table contenant des informations postérieures à la date de prédiction. La jointure est valide, le nombre de lignes correspond, et le modèle est corrompu.
Je considère donc Claude comme un relecteur du comportement d'implémentation, pas comme garant de la définition.
Utilisez /code-review pour un retour rapide en local et /code-review ultra pour une passe pré-merge plus profonde. Les deux relisent le code, mais /code-review est pensé pour l'itération, tandis que l'ultra exécute plusieurs agents distants et vérifie indépendamment les bugs signalés.
|
|
|
|
|
Emplacement |
Session Claude Code locale |
Bac à sable cloud distant |
|
Style de revue |
Flux de revue local unique |
Revue multi-agents avec vérification indépendante |
|
Durée typique |
De quelques secondes à quelques minutes |
Environ 5 à 10 minutes |
|
Coût |
Usage normal de Claude Code |
3 exécutions Pro/Max gratuites, puis 5 $ à 25 $ en crédits d'usage |
|
Étape idéale |
Pendant le développement |
Avant de fusionner des changements importants |
|
PR GitHub |
Peut cibler une PR |
Peut relire une PR par numéro |
|
Authentification |
Authentification Claude Code |
Compte claude.ai requis |
Anthropic décrit actuellement l'ultra review comme un aperçu de recherche. Les abonnés Pro et Max reçoivent 3 exécutions gratuites uniques, puis une revue coûte généralement entre 5 $ et 25 $, selon la taille du changement. Les utilisateurs Team et Enterprise ne bénéficient pas de ces exécutions gratuites, et la fonctionnalité est indisponible sur Amazon Bedrock, Google Cloud Agent Platform, Microsoft Foundry, et pour les organisations avec Zero Data Retention activé.
La différence majeure est la vérification. /code-review ultra envoie l'état du dépôt dans un bac à sable distant, exécute une flotte d'agents, et ne remonte que des bugs reproduits indépendamment.
Je ne l'exécuterais pas à chaque commit. Si je renomme une variable dans un notebook Python ou ajuste le formatage d'un modèle dbt, un /code-review local suffit. Si je modifie la génération de features d'un modèle de production, réécris une transformation de revenu ou modifie une agrégation au niveau client, une passe supplémentaire s'impose.
Un détail de nommage à bien noter : la commande documentée est /code-review ultra, et /ultrareview en est un alias lorsque la fonctionnalité est activée pour votre compte. D'anciens tutoriels présentent souvent /ultrareview comme commande principale, mais la documentation d'Anthropic intègre désormais la revue cloud poussée à la famille /code-review, et /code-review ultra revient à une revue locale si la fonctionnalité cloud est indisponible.
Depuis le dépôt, exécutez :
/code-review ultraPour relire directement une PR GitHub :
/code-review ultra <pr#>Sans argument, /code-review ultra compare votre branche actuelle à la branche par défaut et inclut les changements non commités et indexés. Une revue de branche plafonne à environ 500 fichiers modifiés et 8 000 lignes changées par défaut, même si Anthropic indique que ces limites peuvent évoluer. Si votre diff est trop volumineux, poussez la branche et lancez la revue en tant que PR.
Avec un numéro de PR, l'environnement distant clone la PR depuis GitHub et rien n'est téléversé depuis votre machine.
Avant de commencer, Claude affiche le périmètre de la revue, le solde d'exécutions gratuites et le coût estimé. Après confirmation, la revue tourne en arrière-plan, vous pouvez donc continuer à utiliser Claude Code pendant le travail des agents distants.
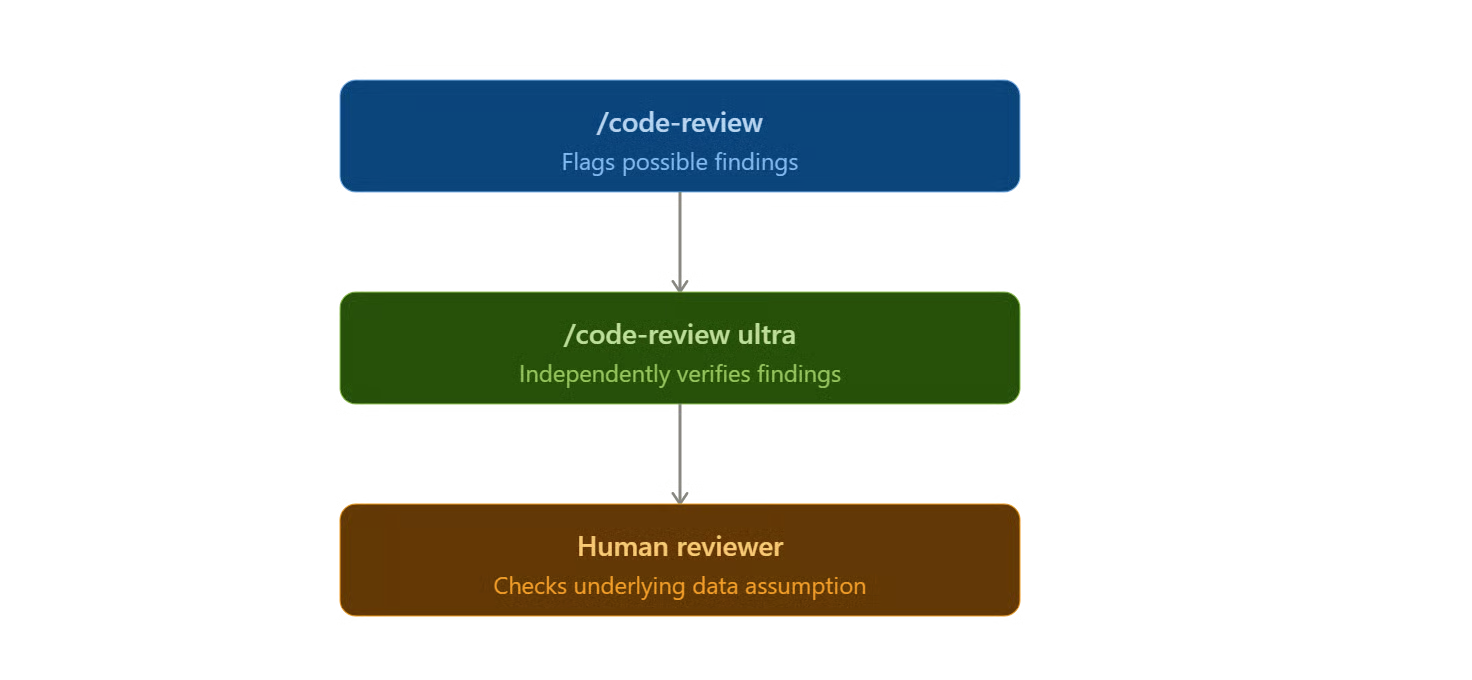
Pour notre exemple weekly_revenue.py, je comparerais les constats plutôt que de supposer que la revue plus profonde a forcément raison.
Si /code-review signale la jointure client et que l'ultra review reproduit indépendamment la même duplication de revenu, ma confiance augmente. Si l'ultra l'ignore car la table amont garantit l'unicité, j'inspecterais les éléments des deux revues et la définition réelle du modèle avant de changer le code.
C'est l'avantage de relecteurs multiples : un désaccord donne matière à investiguer.
Un mot sur les coûts : GitHub Code Review coûte aujourd'hui en moyenne 15 $ à 25 $ par revue, tandis que l'ultra review revient généralement à 5 $ à 25 $ après les exécutions gratuites Pro et Max. Les coûts GitHub Code Review sont distincts de l'usage inclus aux abonnements, et Anthropic propose des contrôles de dépenses pour les organisations.
Si vous travaillez seul, /code-review en local plus un /code-review ultra occasionnel est un bon point de départ. En équipe Team ou Enterprise et si vous souhaitez une revue automatisée sur chaque PR, GitHub Code Review est plus indiqué.
Le bon workflow n'est pas « lancer Claude avant chaque merge ». C'est une séquence où chaque revue intervient à un moment différent, car chacune coûte différemment et détecte une autre classe de problèmes.
Voici le processus que j'utiliserais pour un changement en production :
Write code
	   ↓
Run tests and data checks
	   ↓
/code-review
	   ↓
Fix verified findings
	   ↓
Open GitHub PR
	   ↓
GitHub Code Review
	   ↓
Human triage
	   ↓
/code-review ultra for higher-risk changes
	   ↓
Final tests
	   ↓
Human merge
La revue locale intercepte des problèmes quand ils sont peu coûteux à corriger. La revue GitHub laisse une trace partagée pour l'équipe, tandis que l'ultra review offre un second avis plus approfondi avant un merge conséquent.
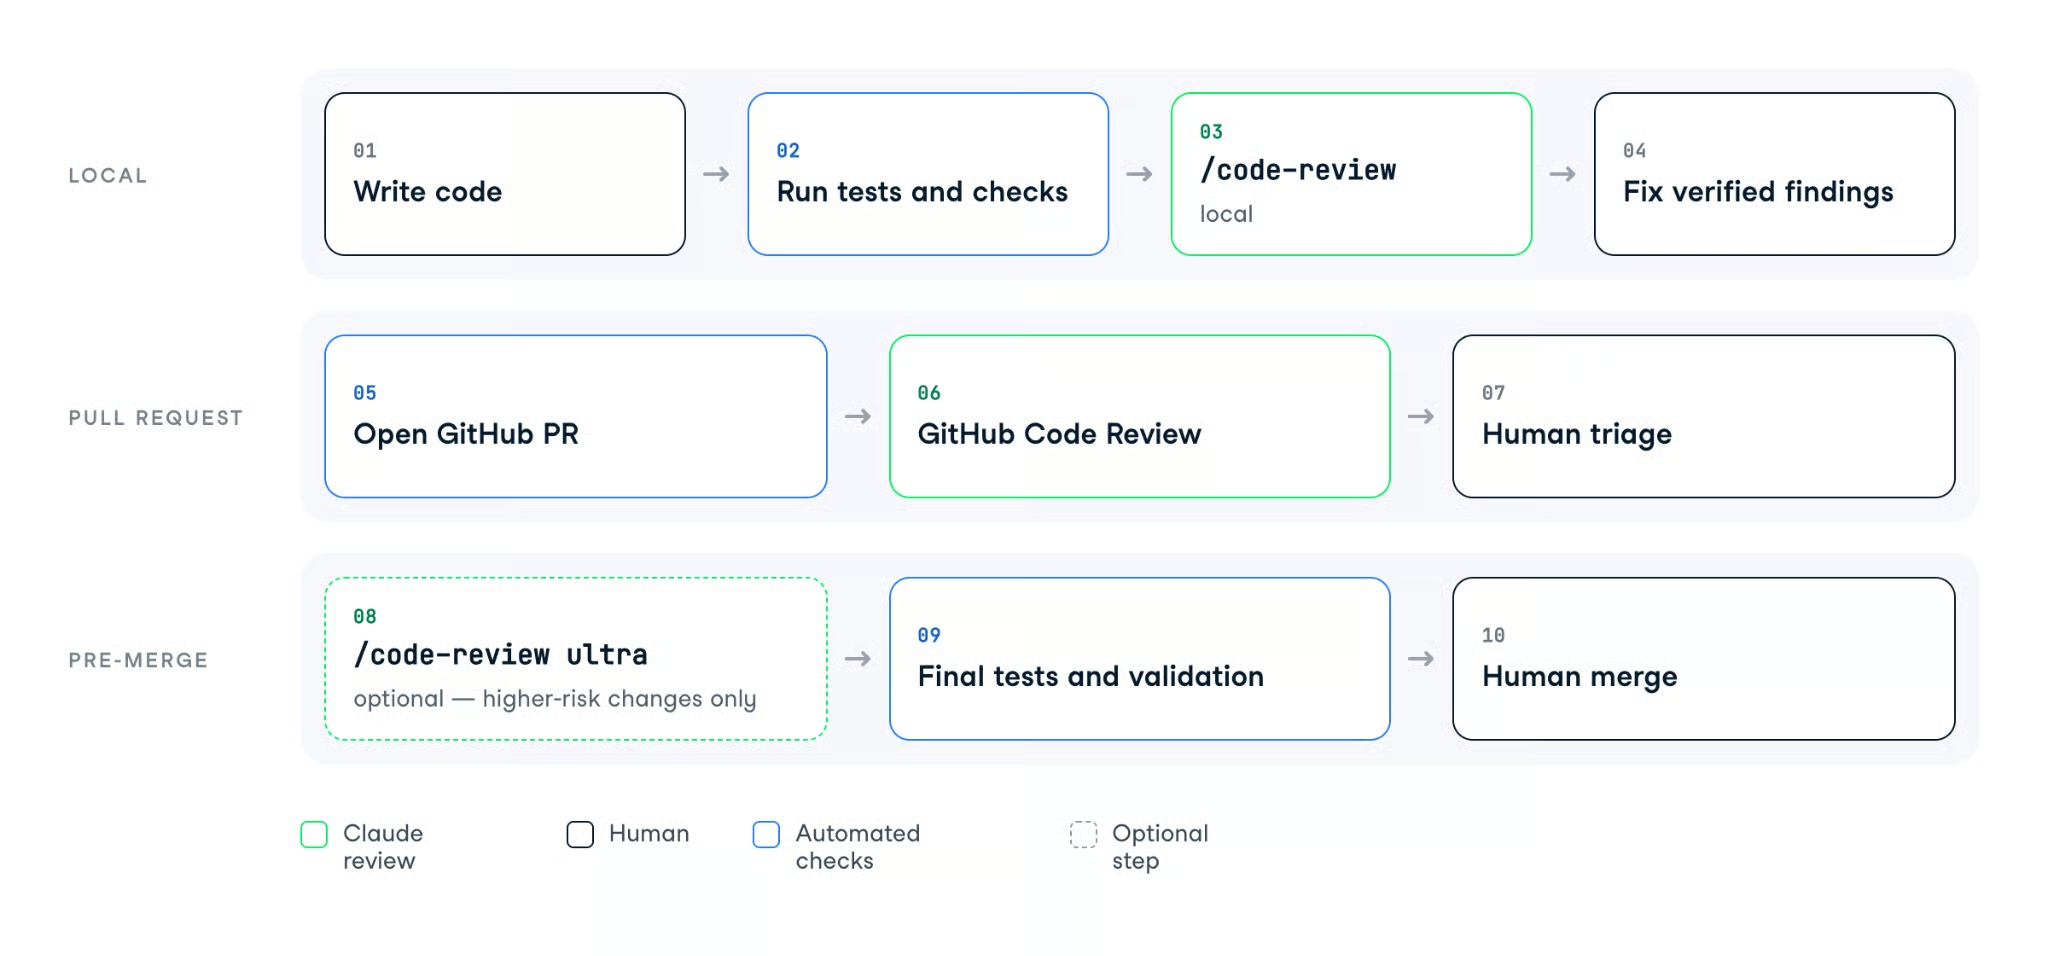
Pour les travaux data, j'ajouterais 4 vérifications autour de Claude plutôt que d'attendre du modèle qu'il fasse toute la revue :
Claude peut participer aux 4 activités, mais le résultat attendu doit venir du code, des tests ou des données, pas de l'explication de Claude.
Claude Code Review fonctionne le mieux quand je le traite comme un autre ingénieur dans le fil de revue, pas comme un tampon d'approbation automatique.
La commande locale /code-review vous donne une relecture rapide avant l'existence de la PR. GitHub Code Review apporte des constats multi-agents dans la PR pour les organisations Team et Enterprise, tandis que /code-review ultra offre une revue distante plus approfondie lorsque le changement le justifie.
Je commencerais modestement. Intégrez /code-review à votre routine de branches, écrivez un REVIEW.md court pour vos revues GitHub, et testez /code-review ultra sur les changements où un mauvais merge aurait un vrai coût.
Pour les concepts de modèle sous-jacents, notre Introduction to Claude Models offre le contexte général, tandis que GitHub Foundations et Intermediate GitHub Concepts couvrent les flux Git et GitHub sur lesquels s'appuie Code Review. Pour plus d'idées sur le triage de dépôts GitHub avec Claude, lisez aussi notre tutoriel sur le connecteur Claude Code.
Apprenez le Vibecoding avec Claude Code
Cours
Cours
Cours
Tutoriel
Kurtis Pykes
15 min
Tutoriel
Tutoriel
Satyabrata Pal
15 min
Tutoriel
Matt Crabtree
5 min
Tutoriel
Stephen Gruppetta
12 min
Tutoriel
Aditya Sharma
5 min