Courses
OpenAI APIを使いこなす
3時間
172.6K
2022 年末の ChatGPT の登場(現在進行中の AI 革命の幕開けとなった出来事)以降、生成系 AI モデルはより強力かつ多様になってきました。サイズや機能、モダリティ、用途の異なる新しいモデルが日々市場に登場しており、どこまでが可能なのか見極めるのが難しくなっています。
全体として、より大規模で複雑なモデルを開発する傾向が明確です。生成系 AI モデルの基盤技術である大規模言語モデル(LLM)の性能を高めるには、パラメータ数や学習データ量を増やすのが最善策と考えられています。詳しく知るには、別記事「LLM とは何か」をご覧ください。
しかし、大規模モデルの学習・運用に必要なリソース(およびそれに伴う環境負荷)への懸念が高まる中、AI の開発・展開における効率性が急速に重視されるようになっています。
本記事では、Stability AI がリリースした最新モデル Stable Code 3B を紹介します。正確で応答性の高いコーディングのために特化設計されたこの LLM は、モデルサイズを大幅に抑えながら、最先端の LLM に匹敵する性能を発揮します。
Stable Code 3B は、Stability AI により 2024 年 1 月にリリースされた、コーディング用途向けの 30 億パラメータ LLM です。前身の Stable Code Alpha 3B の改良版にあたります。
Stable Code 3B はコード補完タスクで優れており、初心者プログラマーにとって優れた学習ツールにもなります。モデルは研究目的または個人利用に限り無料で公開されています。商用利用には、Stability AI Memberships のいずれかに加入する必要があります。
Stable Code 3B は同等サイズの LLM 群の中でもトップクラスの製品で(次節で性能指標の詳細を確認できます)、大幅に小さなサイズで優れた結果を達成しています。コンパクトな設計と効率性により、専用 GPU を搭載していない一般的なノート PC(例:MacBook Air)でもオフラインで動作可能です。
Stable Code 3B は 27 億パラメータのコンパクトなモデルです。Meta のオープンソース LLaMA に類似したデコーダ専用トランスフォーマーです。LLaMA の詳細は別記事をご覧ください。
Stable Code 3B の学習プロセスは、Meta の CodeLLaMA に明確に触発されています。モデルは Stability AI の事前学習済み LLM である StableLM-3b-4e1t を出発点(基盤モデル)としています。
本モデルは 2 段階のファインチューニングを実施しました。第 1 段階では、CommitPack、GitHub Issues、StarCoder およびその他の数学系データセットなど、複数のコードおよびコード関連データセットで学習しました。学習データには Python、R、Java、C を含む 18 の広く使用されるプログラミング言語のコードが含まれます。
その後、CodeLLaMA の研究論文で提案された fill-in-the-middle 手法を用い、16,384 トークンのより長いシーケンスで追加の微調整を行いました。第 2 段階により、最大 100k トークンの長いコンテキストウィンドウをサポートします。これはコーディングタスクに特に適しています。入力シーケンスを長くできるため、開発者はコードベースからより多くのコンテキストや長いコード片をモデルに与え、より関連性が高く正確な出力を得られます。
Stability AI の開発者は、複数のプログラミング言語でテストされる MultiPL-E 指標において、同等サイズのモデルと比較して最先端の性能を達成するモデルを作成しました。以下の画像に比較が示されています。
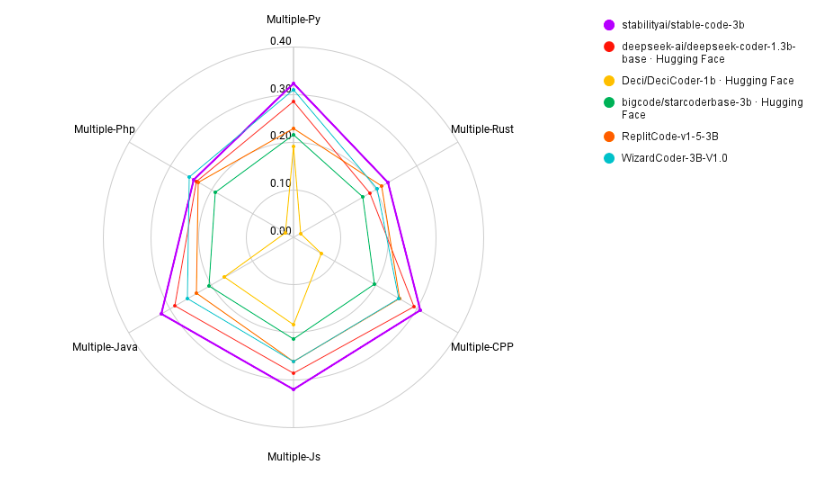
3B 未満のモデルにおける Multi-PL パフォーマンス比較。出典:Stability AI
Stable Code 3B は、はるかに大きいモデルと比べても優れています。たとえば、主なインスピレーション元である CodeLLaMA 7b と同等の性能を、モデルサイズを 60% 削減した上で達成しています。
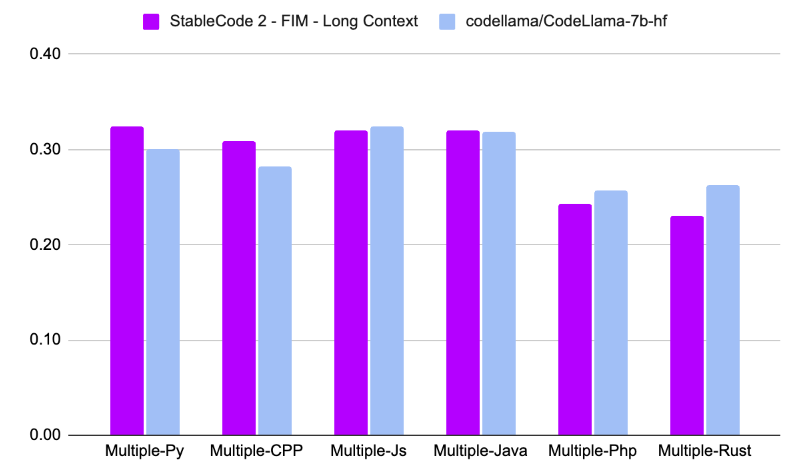
Stable Code Completion 3B と CodeLLama 7B の比較。出典:Stability AI
Stable Code 3B のような AI 搭載のコーディングアシスタントは、ソフトウェア開発やデータ分析に多くの機会をもたらします。以下は、プログラマーがすでに AI を活用している方法の一部です。
Stable Code 3B は、基本的な SQL クエリの実行、探索的データ分析の実施、データサイエンスプロジェクトの効率化など、繰り返しで単調なタスクをシームレスに自動化できます。これにより、時間のかかる作業を省き、より複雑で難易度の高い業務に集中できます。実際の動作を知るには、解説的なデータサイエンスにおける ChatGPT 活用ガイドをご覧ください。
デバッグは多くの時間を要し、特に何百行ものコードを抱える複雑なプロジェクトでは困難になりがちです。Stable Code 3B は、数秒でコードを走査し、修正のためのコードや構造の提案を行うことで、このプロセスを加速する理想的なアシスタントです。長いコンテキストウィンドウのおかげで、大きなスクリプトを与えても、コード内の潜在的なエラーや落とし穴を見つけ出します。
大量の計算資源を要する複雑なプロジェクトでは、効率性が不可欠です。コードの書き方は効率に大きく影響します。Stable Code 3B は、効率向上のためにコードを書き換える支援を行い、時間・リソース・コストの節約につなげます。
他者のコードを理解するのは難しい場合があり、特にジュニアのコーダーにとってはなおさらです。Stable Code 3B はコード改善を提案できるだけでなく、特定のコード片について詳細な説明も提供し、学習を加速します。
学習目的で生成系 AI を活用する方法を知るには、DataCamp Workspace を強くおすすめします。データサイエンス向け IDE を支えるために GPT 3.5 と GPT-4 を採用し、複雑なシンタックスの理解を助けます。別ガイド「DataCamp Workspace を始める」もご覧ください。
Stable Code 3B を始める最良の方法は、HuggingFace API を利用することです。次のコードで、Python 環境に簡単にモデルを読み込み、テキスト生成を開始できます。
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer
tokenizer = AutoTokenizer.from_pretrained("stabilityai/stable-code-3b", trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained(
  "stabilityai/stable-code-3b",
  trust_remote_code=True,
  torch_dtype="auto",
)
model.cuda()
inputs = tokenizer("import torch\nimport torch.nn as nn", return_tensors="pt").to(model.device)
tokens = model.generate(
  **inputs,
  max_new_tokens=48,
  temperature=0.2,
  do_sample=True,
)
print(tokenizer.decode(tokens[0], skip_special_tokens=True))前述のとおり、Stable Code 3B は研究目的または個人利用に限り無料で公開されています。商用利用には、Stability AI Memberships のいずれかへの加入が必須です。
現在、Stability AI は非商用向けに加えて 2 種類のメンバーシップを提供しており、以下の画像のとおりです。
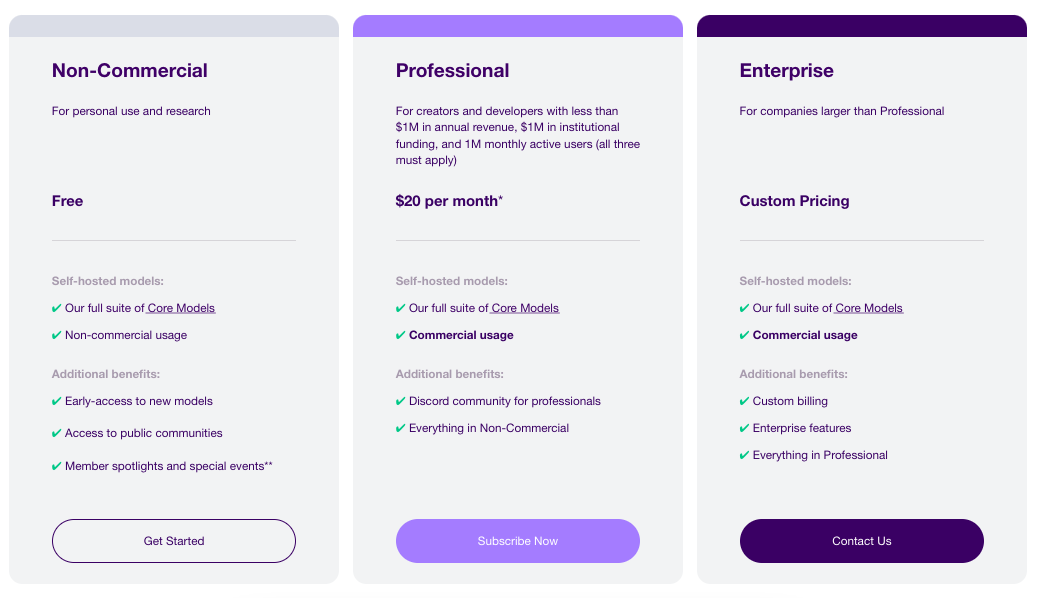
Professional メンバーシップは月額 20 ドルで、画像・動画・3D・テキスト・コード生成の各モデルを含む Stability AI のコアモデルへのアクセスと商用利用権を提供します。Enterprise メンバーシップは大企業向けで、カスタム価格およびエンタープライズ機能が含まれます。
データ分野のプロフェッショナルにとって、今はわくわくする時代です。Stable Code 3B のような生成系 AI ツールの大規模な普及により、業界は変革の瀬戸際にあります。
進行中の AI 革命を乗り切る最善の方法は、常に情報をキャッチアップし、最新動向を追うことです。DataCamp にお任せください。他の強力な生成系 AI ツールを扱った特集記事もぜひご覧ください。
今すぐ AI の学習を始めましょう!
Courses
Courses
Courses