강의
대형 언어 모델(LLM)의 개념
2시간
111.4K
회로도는 전자 부품이 어떻게 연결되는지 보여주는 도면입니다. 이를 검토한다는 것은 부품과 그 값이 설계 요구사항을 충족하는지 확인하는 일입니다. 전원 공급 장치는 충분한 전류를 제공할 수 있나요? 프로세서는 센서의 전체 출력을 읽을 수 있나요? 답은 회로도, 부품 데이터시트, 그리고 몇 가지 계산에서 나옵니다.
Grok 4.7이 그 전체 리뷰를 완료할 수 있는지 확인해 보고 싶었습니다. Grok 4.7 가이드는 이 모델이 더 긴 작업과 자체 검증에 더 신중하도록 훈련되었다고 밝힙니다. 회로는 또한 일반적인 Python 코드로 확인할 수 있는 수치를 제공하므로, 결과를 판단하기 위해 다른 AI 모델이 필요하지 않습니다.
실험을 위해 USB 전원으로 구동되는 소형 센서 보드 EnviroNode Rev A를 제작하고, 설계에 세 가지 결함을 심어 두었습니다. Grok에게 결함의 개수는 알려주지 않습니다. Grok은 이를 찾아내고, 각 발견을 부품 문서로 뒷받침하며, 수정안을 제시하고, 수정된 값을 Python 검사에 제출해야 합니다.
따라가 보시려면 전기공학 배경이 없어도 됩니다. 각 회로 규칙은 처음 등장할 때 설명합니다. 다음을 배우게 됩니다:
Responses API를 통해 Grok 4.7에 회로도 이미지를 보내는 방법
Files API로 데이터시트를 첨부하고 Grok이 이를 검색하도록 하는 방법
합격/불합격을 결정하는 로컬 verify_design() 함수를 Grok에 제공하는 방법
긴 문서 중심의 대화를 모델 컨텍스트 한도 내에 유지하는 방법
일관된 리뷰 형식을 반환하고, 추론 수준을 비교하는 방법
같은 보드를 첫 이미지 리뷰부터 최종 Python 검사까지 계속 사용합니다.
Grok 4.7은 데이터시트를 받은 후 심어 둔 모든 결함을 식별했으며, 수정된 설계는 Python 검사를 통과했습니다. 이는 회로 리뷰 전반이 아니라 이 세 가지 결함에 대한 이야기입니다.
이는 작은 보드 하나일 뿐, 벤치마크가 아닙니다. 데이터시트가 수십 개인 보드는 더 큰 컨텍스트를 만들고 다른 결과를 낼 수 있습니다.
Grok 4.7 API는 모델 ID grok-4.7를 통해 Python 앱에 텍스트 및 이미지 입력, 텍스트 출력, 500,000토큰 컨텍스트 윈도우를 제공합니다. 공식 가이드는 low, medium, high(기본값), xhigh 추론 수준을 나열하며, 추론은 끌 수 없습니다. API는 함수 호출, 구조화 출력, 웹 검색, X 검색, 코드 실행도 지원합니다.
저희 Grok 4.7 개요는 출시와 벤치마크를 다룹니다. SpaceXAI는 Chat Completions를 레거시로 분류하므로, 여기의 모든 예시는 Responses API를 사용합니다.
프롬프트 토큰이 200,000 미만일 때, Grok 4.7의 비용은 입력 100만 토큰당 $2, 캐시된 입력 100만 토큰당 $0.50, 출력 100만 토큰당 $6입니다. 프롬프트가 200,000 토큰에 도달하면 해당 요청의 모든 토큰이 $4, $1, $12 요율로 청구됩니다.
서버 측 도구는 별도 요금이 있습니다: 요금 페이지는 웹 검색 또는 코드 실행 호출 1,000회당 $5를 부과합니다. 첨부 문서 검색은 회당 1센트이며, 저장된 문서에는 GiB당 일일 요금이 적용됩니다. 관련 요청에는 안정적인 prompt_cache_key를 사용하되, 캐시되지 않은 입력에 대한 예산도 고려하세요.
청구된 비용은 usage.cost_in_usd_ticks에서 읽을 수 있습니다. 비용 추적 문서에 따르면 캐싱 및 도구 요금이 포함됩니다. 값을 달러로 환산하려면 10^10으로 나누세요.
회로 설계는 문서 읽기, 계산, 도구 사용, 검증을 한 번에 시험합니다. SpaceXAI는 Grok 4.7의 EEBench 점수를 64.0%로 보고합니다. EEBench 방법론은 대형 언어 모델(LLM) 판정 대신 시뮬레이션과 자재 명세서(BOM) 검사를 사용하며, EnviroNode도 같은 원칙을 따릅니다.
EnviroNode Rev A는 USB 전원으로 구동되는 센서 노드입니다. 전체 프로젝트는 GitHub에서 다운로드할 수 있습니다.
회로도에는 Grok이 리뷰에 필요한 모든 부품 값이 기재되어 있습니다. 각 요구사항에는 PWR-002 또는 BW-001 같은 ID가 있어, 모든 발견을 한 가지 규칙과 연결할 수 있습니다.
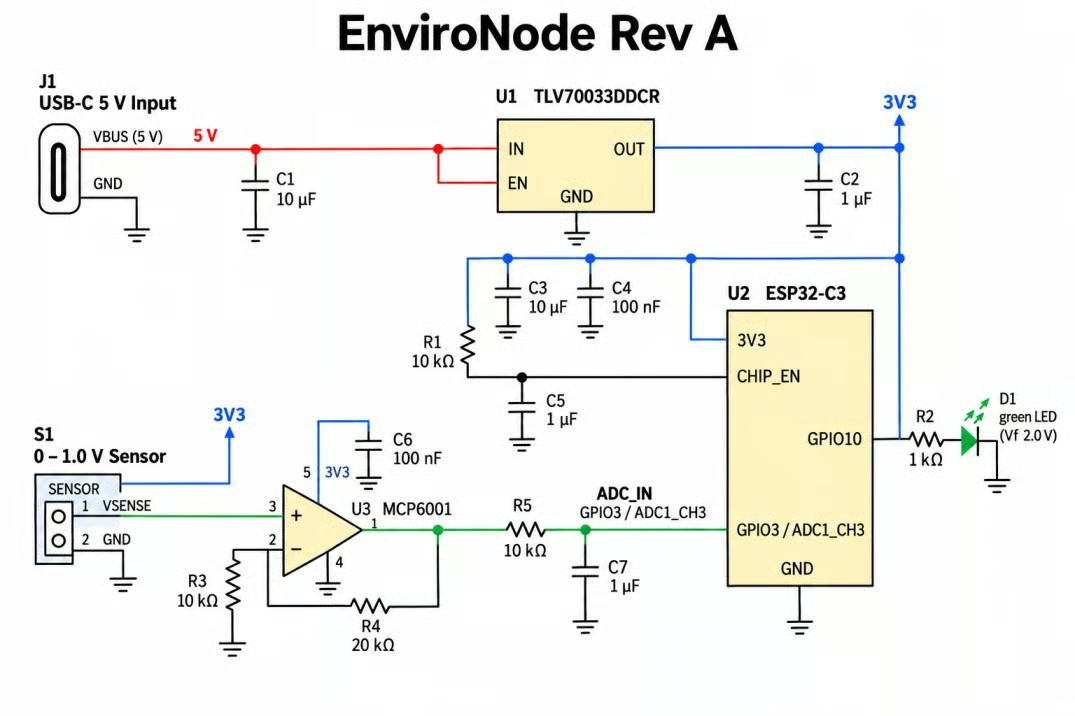
값이 포함된 EnviroNode Rev A 회로도. 이미지: 작성자.
Grok이 보드를 검토하기 전에, 검증기가 사용할 모든 규칙을 공개하세요. 이 함수는 다음 여덟 가지 요구사항으로부터 만들어진 다섯 가지 합격/불합격 체크를 반환합니다:
모델도 같은 요구사항 세트를 받습니다. 어떤 검증기 한계도 Grok이 수정안을 제안한 후에야 나타나지 않습니다.
세 가지 결함은 수치로 확인할 수 있습니다. 결함의 개수는 프롬프트에 포함하지 않습니다.
레귤레이터 용량 부족(PWR-002): TI TLV700는 200 mA 정격인 반면, ESP32-C3 데이터시트는 Wi-Fi 송신 피크 335 mA를 명시하고, Espressif의 회로도 체크리스트는 최소 500 mA를 요구합니다.
ADC 범위 초과(ADC-001): 이득 3은 ADC에 3.0 V를 인가하지만, 데이터시트의 실효 범위 상한은 2,500 mV이고, 요구사항은 그 90%를 허용합니다.
필터가 너무 느림(BW-001): 10 kΩ과 1 μF는 15.9 Hz 차단 주파수를 만들며, 100 Hz까지의 신호는 최대 1 dB만 손실되어야 합니다.
ADC 결함은 핀 손상이 아닌 측정 범위에 관한 것입니다. LED 저항과 CHIP_EN 지연 같은 올바른 선택은 거짓 양성을 정량화할 수 있게 해줍니다.
리뷰에는 명확한 경계가 필요합니다: Grok은 변경을 제안하고, Python은 합격 또는 불합격을 판정합니다. 다이어그램은 문서와 도구가 그 루프에 어디서 들어오는지를 보여줍니다.
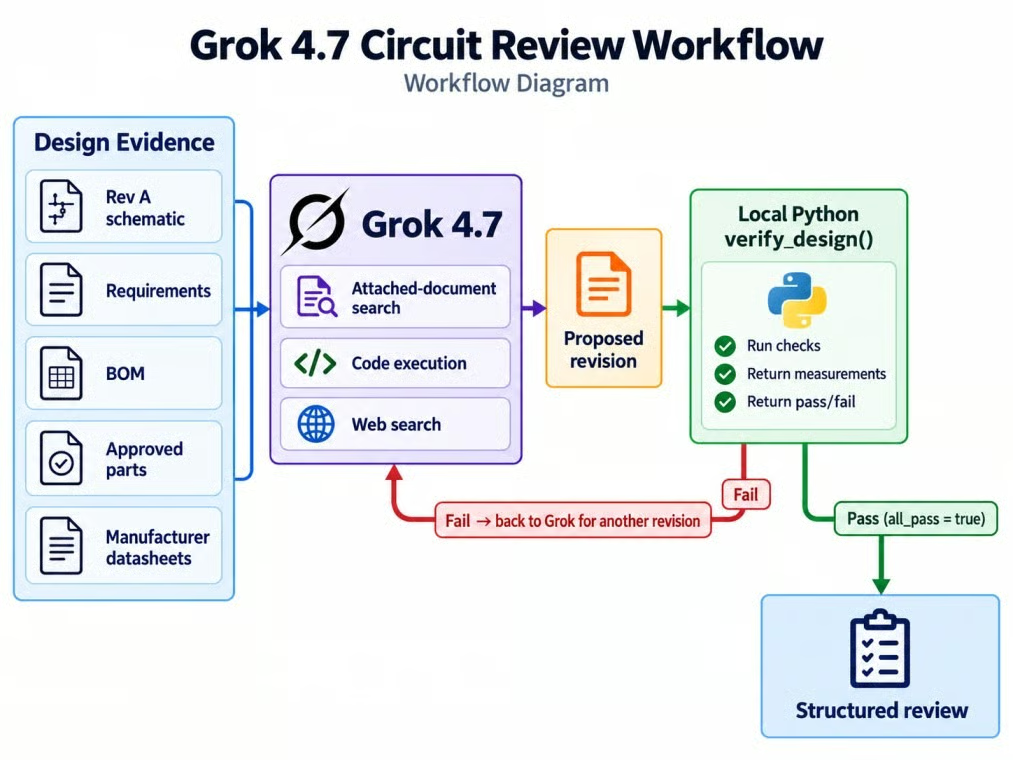
리뷰 루프는 제안과 검증을 분리합니다. 이미지: 작성자.
첫 API 호출 전에 성공 기준을 정의하세요. Grok이 결함을 요구사항과 증거에 연결했을 때만 결함으로 집계합니다. verify_design()가 all_pass = true를 반환할 때만 수정을 집계합니다.
선충전 크레딧이 있는 xAI API 키, Python 3.10 이상, xAI의 기본 URL을 가리키는 OpenAI Python SDK가 필요합니다. xAI 콘솔에서 키를 만든 다음, 아래에 사용된 패키지를 설치하세요.
python -m venv .venv
source .venv/bin/activate        # Windows: .venv\Scripts\activate
pip install openai python-dotenv pydantic httpx streamlit
pip install matplotlib schemdraw pytest  # Optional diagrams and verifier tests
API 예시는 첫 번째 패키지 그룹을 사용하고, 두 번째는 리포지토리 다이어그램과 테스트를 지원합니다. Python 3.11.9, openai 3.19.2, pydantic 2.13.5, streamlit 1.64.0, httpx 0.28.1에서 테스트했습니다. 키는 XAI_API_KEY 환경 변수로 저장하고, 소스 코드에 넣는 대신 python-dotenv로 로드하세요. 가상 환경 가이드가 처음이라면 설정 방법을 참고하세요.
키가 이미 Responses API에서 작동한다면 1단계로 건너뛰세요. 아니라면, 이 요청은 키, 기본 URL, 모델 ID를 한 번에 점검합니다.
import os
import httpx
from dotenv import load_dotenv
from openai import OpenAI

load_dotenv()
client = OpenAI(api_key=os.environ["XAI_API_KEY"], base_url="https://api.x.ai/v1",
                timeout=httpx.Timeout(3600.0))

response = client.responses.create(
    model="grok-4.7",
    reasoning={"effort": "low"},
    input="In one sentence, what does a low-dropout regulator do?",
)
print(response.output_text)
한 문장으로 된 답변이 나오면 설정이 정상 작동하는 것입니다. 긴 타임아웃은 나중에 중요해지는데, 추론과 도구를 사용하는 요청은 몇 분이 걸릴 수 있기 때문입니다.
예. Grok 4.7은 프롬프트에서 도구가 오지 않는다고 분명히 말하면, 이미지만으로 회로도를 리뷰할 수 있습니다. 기준선은 PNG를 base64 데이터 URL로 보내고, 요구사항 텍스트를 함께 전송합니다.
image = {
    "type": "input_image",
    "image_url": f"data:image/png;base64,{SCHEMATIC_B64}",
    "detail": "high",
}
response = client.responses.create(
    model="grok-4.7",
    input=[{"role": "user", "content": [
        image,
        {"type": "input_text", "text": REVIEW_PROMPT},
    ]}],
)
프롬프트는 확정, 추가 증거 필요, 점검 완료 및 적합의 세 섹션을 요청합니다. 결함 개수나 의심 부품은 언급하지 않습니다.
도구나 데이터시트가 없을 때는 모델에 명시적으로 알려주세요. 그렇지 않으면 접근할 수 없는 규격을 찾아보겠다며 응답을 끝낼 수 있습니다.
요약에서 언급했듯이, Grok은 15.9 Hz 차단 주파수와 100 Hz에서 16.1 dB 손실로 필터 결함을 확정했습니다. 레귤레이터와 ADC는 한계를 추측하지 않고 "증거 필요"에 배치했습니다.
첨부 문서는 모호한 우려를 수치로 뒷받침된 주장으로 바꿉니다. 각 문서를 한 번 업로드하고 file_id로 참조하세요.
with open(DATASHEET_PATH, "rb") as datasheet:
    uploaded = client.files.create(
        file=datasheet,
        purpose="assistants",
        expires_after={"anchor": "created_at", "seconds": 7 * 24 * 3600},
    )
content = [image, *[{"type": "input_file", "file_id": fid} for fid in file_ids],
           {"type": "input_text", "text": EVIDENCE_PROMPT}]
이 튜토리얼은 expires_after를 7일로 설정했기 때문에, 캐시된 ID는 그 기간 내에서만 유효합니다. expires_after가 없으면 xAI는 파일을 삭제할 때까지 보관합니다.
여기서 캡처한 OpenAI SDK 응답에서는 첨부 검색이 pdf_search 및 pdf_browse라는 이름의 custom_tool_call 항목으로 나타났고, 사용량은 document_search_calls에 집계되었습니다. 이는 관찰된 동작일 뿐 도구 유형의 일반 계약은 아니므로, 루프는 문서화된 사용량 카운터도 확인합니다.
문서는 1단계의 두 가지 열린 질문을 해결하고 전력, ADC, 필터 발견을 뒷받침했습니다. 레귤레이터 발견은 TLV700의 200 mA 정격, ESP32-C3의 335 mA 송신 피크, 500 mA 전원 권장 사항을 인용했습니다.
필터의 경우 Grok은 R5를 변경하지 않고도 두 대역폭 규칙을 만족하는 커패시터 값을 도출했습니다: 대략 32~81 nF. 모든 디코이는 이유와 함께 "점검 완료 및 적합"으로 분류되었습니다.
코드 실행은 xAI의 서버 측 Python 샌드박스이며, OpenAI 클라이언트를 사용할 때 tools에 {"type": "code_interpreter"}로 추가됩니다. 프롬프트에는 한 가지 규칙을 더합니다: 숫자가 있는 모든 주장은 확정으로 간주되기 전에 계산되어야 합니다.
앞서 링크한 코드 실행 가이드는 샌드박스가 네트워크에 접근할 수 없고, 요청 간 상태를 유지하지 않는다고 설명합니다. 몇 가지 데이터시트 수치를 다루기에는 충분합니다.
전력 예산, ADC 범위, 필터 대역폭을 하나의 스크립트로 확인하도록 요청하세요. 회로가 낯설다면 아래 출력은 건너뛰셔도 됩니다. 핵심 요지는 그 다음에 나옵니다.
f=  100.0 Hz  |H|=0.157177  attenuation=16.0722 dB
fc required for <= 1 dB at 100 Hz: fc >= 196.5227 Hz
V_adc_fs = 3.0000 V
90% limit = 2.2500 V
required rating = max(headroom, mcu min) = 500.00 mA
196.5 Hz의 최소 차단 주파수는 필터 수정이 의존하는 값이며, 코드는 이를 모델 산술에 맡기지 않고 계산합니다. 최소 감쇠 허용 오차 구석에서도 100 Hz에서 15 dB 이상 손실되므로, 판정은 유지됩니다.
예. 웹 검색은 모델의 학습 컷오프 이후 제조사가 데이터시트를 개정했는지, 첨부 문서가 최신인지 확인합니다. 증거가 1차 출처로 유지되도록 공식 도메인으로 제한하세요.
tools = [
    {"type": "code_interpreter"},
    {"type": "web_search", "filters": {"allowed_domains": ["ti.com", "espressif.com"]}},
]
앞서 링크한 웹 검색 가이드는 최대 다섯 개의 allowed_domains를 허용하며, docs.espressif.com 같은 서브도메인도 포함됩니다. 첨부 데이터시트가 최신이라도 이 단계를 유지하길 권합니다. 업로드 이후에 게시된 개정판을 잡아낼 수 있기 때문입니다.
Grok은 현재 TI 제품 페이지, ESP32-C3 문서, 하드웨어 체크리스트, 관련 정오표를 인용해야 합니다. 이 인용은 공학적 결론의 옳고 그름이 아니라 출처의 증거로 취급하세요.
도메인 필터를 걸어도 무관한 페이지가 반환될 수 있습니다. 모든 인용이 계산에 사용된 정확한 부품과 한계를 뒷받침하는지 확인하세요.
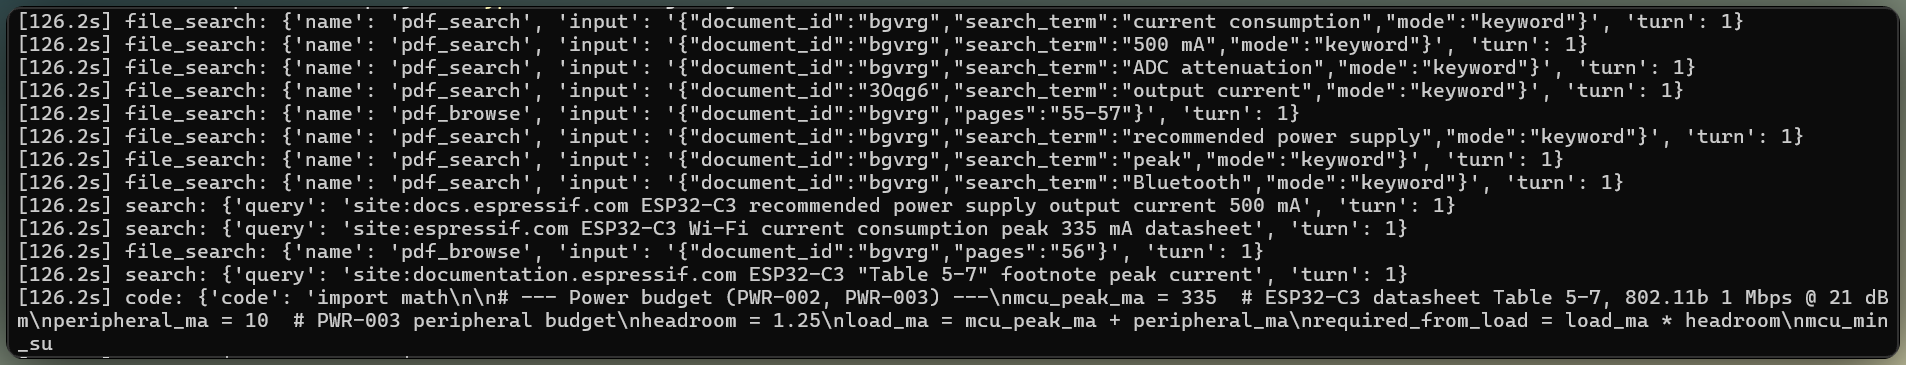
Grok은 파일을 검색하고, 계산하고, 출처를 확인합니다. 이미지: 작성자.
verify_design()는 로컬 머신에서 실행되는 일반적인 Python 함수이며, 수정안의 통과 여부를 판정하는 유일한 심판입니다. Grok은 함수 호출을 통해 설계 값을 제안하고, 함수는 고정된 한계에 대해 이를 점검합니다.
VERIFY_DESIGN_TOOL = {
    "type": "function",
    "name": "verify_design",
    "description": "Deterministically check an EnviroNode revision against EN-REQ-001...",
    "parameters": {
        "type": "object",
        "properties": {
            "revision": {"type": "string"},
            "regulator_part": {"type": "string"},
            "gain_rf_ohm": {"type": "number"},
            "gain_rg_ohm": {"type": "number"},
            "filter_r_ohm": {"type": "number"},
            "filter_c_nf": {"type": "number"},
        },
        "required": ["revision", "regulator_part", "gain_rf_ohm",
                     "gain_rg_ohm", "filter_r_ohm", "filter_c_nf"],
    },
}
전력 용량은 max((335 + 10) mA × 1.25, 500 mA)를 만족해야 합니다. ADC의 경우 1.0 V × (1 + Rf/Rg)가 1,500~2,250 mV 사이에 있어야 합니다. 필터 검사는 100 Hz에서의 손실과 500 Hz의 차단 주파수 상한을 측정하며, 각 검사는 값, 한계, 합격/불합격을 반환합니다.
도구 스키마는 Grok에 어떤 값을 보낼지에 대해서만 알려줍니다. 합격/불합격의 핵심 로직은 평범한 Python입니다:
import math

part = PARTS.get(regulator_part.strip().upper())
required_ma = max((335 + 10) * 1.25, 500)
power_ok = (
    part is not None
    and float(part["rated_iout_ma"]) >= required_ma
    and float(part["vin_max_v"]) >= 5.25
    and float(part["vout_v"]) == 3.3
)

gain = 1 + gain_rf_ohm / gain_rg_ohm
adc_mv = gain * 1000

fc = 1 / (2 * math.pi * filter_r_ohm * filter_c_nf * 1e-9)
loss_db = 10 * math.log10(1 + (100 / fc) ** 2)

checks = {
    "PWR-002": power_ok,
    "ADC-001": adc_mv <= 2250,
    "ADC-002": adc_mv >= 1500,
    "BW-001": loss_db <= 1.0,
    "BW-002": fc <= 500,
}
return {"all_pass": all(checks.values()), "checks": checks}
전체 함수는 유효하지 않은 값을 거부하고 각 결과와 함께 측정값을 반환합니다. 정상 설계, 비정상 설계, 미지 부품, 근접 실패로 테스트하세요.
부품 정격은 모델의 통제 바깥에 두세요. 모델이 전류 정격을 직접 제시하도록 두진 않겠습니다. Grok은 부품 번호를 보내고, 애플리케이션의 카탈로그에서 함수가 정격을 조회합니다.
정답을 코드로 검사할 수 있는 상황에서, 에이전트가 해결책을 제안하고 그것이 옳은지 스스로 판정해서는 안 됩니다. 작업이 바뀌면 verify_design()을 테스트 스위트나 스키마 검사로 대체하세요. 검증기를 작성하는 데는 추가 작업이 들지만, 합격/불합격 결과는 모델의 의견에 좌우되지 않습니다.
Grok에 한 가지 목표를 주세요: 확정된 모든 위반을 가장 합리적인 최소 변경으로 고치고, 앞서 정의한 검사를 통과하기 전까지 설계가 완료됐다고 하지 마세요. 3~5단계의 증거와 도구를 제공한 다음, 요청 한도를 설정하세요.
여기서 요약의 컨텍스트 경고가 중요합니다. 더 많은 턴을 추가하기 전에 해결하세요.
이어진 요청은 이전 도구 결과를 포함하고, 문서 검색은 많은 텍스트를 반환할 수 있습니다. 실패한 프로토타입에서는 다음 연속 요청이 1,116,321 토큰에 도달해 Grok 4.7의 500,000토큰 윈도우를 초과했습니다.
컨텍스트 압축은 이미 한도를 초과한 요청을 구할 수 없습니다. 수정된 루프는 다음 요청을 보내기 전에 각 문서 검색 성공 턴을 압축합니다.
details = (response.usage.model_extra or {}).get(
    "server_side_tool_usage_details", {}
)
observed_attachment_call = any(
    item.type == "custom_tool_call"
    and item.name in {"pdf_search", "pdf_browse"}
    for item in response.output
)
used_documents = (
    details.get("document_search_calls", 0) > 0
    or observed_attachment_call
)

if used_documents:
    compacted = client.responses.compact(
        model="grok-4.7", input=history + list(response.output) + follow_up)
    history = list(compacted.output)  # pass the compaction item back unchanged
    # Compaction drops tool output, so restate the verifier's verdict ourselves.
    history.append({"role": "user", "content":
                    "verify_design results, exactly as returned: " + json.dumps(results)})
else:
    history = history + list(response.output) + follow_up
response = client.responses.create(model="grok-4.7", input=history, tools=TOOLS,
                                   store=False, prompt_cache_key=cache_key)
마지막 append를 유지하세요. 압축은 장황한 도구 출력을 버리므로, 검증기 결과를 다시 서술하면 다음 응답이 만들어내거나 혼동하는 검사를 피하는 데 도움이 됩니다. 각 문서 중심 턴 뒤의 압축은 보수적인 주기이며, 더 큰 시스템은 입력 토큰 임계값을 사용할 수 있습니다.
예. Grok은 실패한 각 서브시스템(전력, ADC 이득, 필터 대역폭)에서 한 개의 부품을 변경했습니다. 다이어그램은 Rev A와 Rev B의 정확한 값을 보여줍니다.
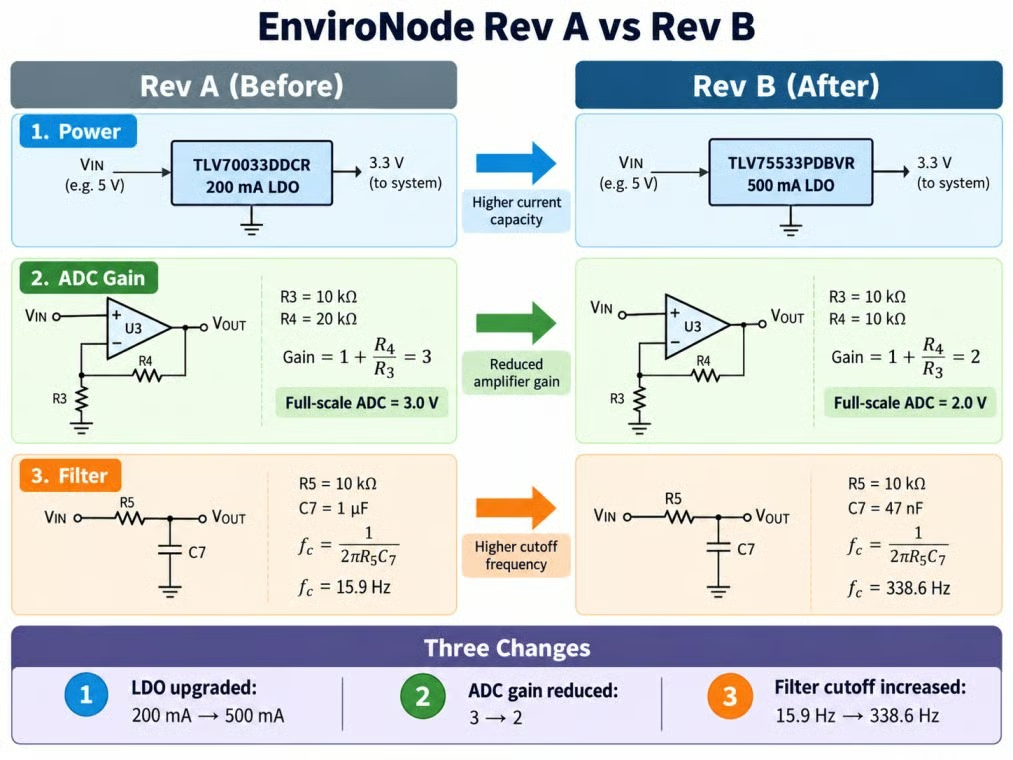
세 가지 부품 변경으로 Rev A를 수정. 이미지: 작성자.
수정된 값은 verify_design()로 전달됩니다. 각 요구사항에 대해 하나의 결과를 반환합니다.
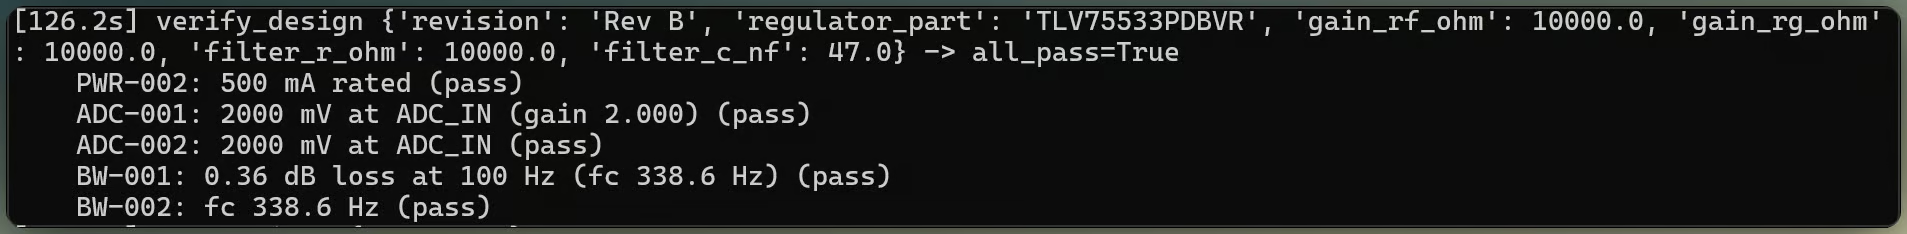
수정된 설계는 모든 검증 검사를 통과합니다. 이미지: 작성자.
실패 결과는 function_call_output으로 다시 전달되어, Grok이 검사가 통과될 때까지 또는 요청 한도에 도달할 때까지 설계를 수정할 수 있습니다.
구조화 출력은 파싱해야 하는 산문 대신 스키마에 맞는 객체를 반환합니다. 동일한 대화에서 Pydantic 모델과 함께 client.responses.parse()를 호출하되, 도구 호출은 꺼 두세요.
class Finding(BaseModel):
    violated_requirement: str
    severity: Literal["blocker", "major", "minor"]
    evidence: list[str]
    recommended_change: str
    verifier_result: Literal["pass", "fail", "not_verified"]

parsed = client.responses.parse(
    model="grok-4.7", input=history + [REPORT_REQUEST],
    text_format=DesignReview, tools=TOOLS, tool_choice="none", store=False,
)
유효한 스키마가 내용의 정확성을 보장하지는 않으므로, 검증기 결과를 포함하고 verifier_result가 그에 기반하도록 지시하세요. JSON은 이후 이슈 트래커나 사람 승인 큐로 전달할 수 있습니다.
구조화 보고서는 각 원래 결함을 해결됨으로 표시하고, 검증기가 반환한 측정값을 인용하며, 미검증 우려는 open_risks에 유지해야 합니다. 이 설계에서 그러한 우려에는 500 mA 최저치에 정확히 맞춘 레귤레이터와 Espressif 권고와 다른 ADC 커패시터가 포함됩니다.
더 높은 노력은 검증기 점수를 높이지는 않았지만, 필터 수정의 질은 달라졌습니다. 각 수준은 같은 회로도, 프롬프트, 도구, 요청 한도를 받았습니다.
|
Effort |
Defects / false positives |
Verifier calls |
Input / cached |
Output / reasoning |
Tools |
Time |
Cost |
|
|
3/3, 0; PASS |
1 |
256,006 / 197,120 |
7,950 / 2,323 |
7 |
111.2 s |
$0.2990 |
|
|
3/3, 0; PASS |
1 |
364,611 / 131,456 |
21,904 / 14,268 |
15 |
292.8 s |
$0.7385 |
|
|
3/3, 0; PASS |
2 |
413,071 / 336,896 |
19,685 / 14,800 |
17 |
277.8 s |
$0.5239 |
low reduced는 저항을 줄이고 1 μF 커패시터를 유지하여, 검증기 바깥의 용량성 부하 및 정착 동작을 남겨두었습니다. Microchip의 용량성 부하 가이드는 직렬 저항이 안정성을 개선할 수 있다고 설명하므로, 이 결과가 수정이 불안정하다는 것을 증명하지는 않습니다. 주파수 응답, 계단 응답 또는 벤치 테스트가 필요합니다. high는 대신 커패시터를 변경했으며, xhigh는 추가 검증기 호출 후 high와 같은 최종 값을 선택했습니다.
이번 단일 비교에서는 high가 더 나은 균형을 보였습니다. xhigh가 수행한 추가 검증기 호출 없이, 모델링되지 않은 부하 우려를 피했습니다. 수준별 한 번의 실행만으로 일반 순위를 확립할 수는 없습니다.
처음 질문에 대한 답은, 검증기의 다섯 가지 검사 범위 내에서는 그렇다는 것입니다. 표는 앞선 발견을 한 화면에 응축합니다.
Grok은 인코딩된 요구사항을 수정했습니다. 수정된 보드가 전기적으로 완전하거나 양산 준비가 되었음을 입증한 것은 아닙니다.
문서는 우려에 증거가 있는지 결정합니다. Python은 수정안의 통과 여부를 결정합니다. 유려한 문장으로 어느 쪽도 대체할 수 없습니다.
저희 Streamlit 가이드는 여기에서 사용한 인터페이스를 설명합니다. 스트리밍을 사용해 도구 호출을 도착 즉시 표시하고, 이후 검증기 검사와 최종 보고서를 보여줍니다.
DataCamp로 AI 배우기
강의
강의
강의