Cursus
Concepten van Large Language Models (LLMs)
2 uur
111.4K
Een schakelschema is een diagram dat laat zien hoe elektronische onderdelen zijn verbonden. Zo'n schema beoordelen betekent nagaan of de onderdelen en hun waarden aan de ontwerpeisen voldoen. Kan de voeding genoeg stroom leveren? Kan de processor de volledige sensoruitgang uitlezen? De antwoorden komen uit het schema, de componentdatasheets en een paar berekeningen.
Ik wilde zien of Grok 4.7 die hele review kon uitvoeren. De Grok 4.7-gids zegt dat het model is getraind voor langere taken en om zijn eigen werk zorgvuldiger te controleren. Een schakeling levert ons ook getallen die gewone Python-code kan controleren, dus we hebben geen ander AI-model nodig om het resultaat te beoordelen.
Voor het experiment bouwde ik EnviroNode Rev A, een kleine sensorprint op USB-voeding, en stopte drie fouten in het ontwerp. Grok wordt niet verteld hoeveel fouten er zijn. Het moet ze vinden, elke bevinding onderbouwen met componentdocumentatie, correcties voorstellen en de gecorrigeerde waarden indienen voor Python-controles.
Je hebt geen elektrotechnische achtergrond nodig om te kunnen volgen. Ik leg elke schakeregel uit zodra die voor het eerst verschijnt. Je leert hoe je:
Een schema-afbeelding naar Grok 4.7 stuurt via de Responses API
Datasheets toevoegt met de Files API en Grok erin laat zoeken
Berekeningen controleert met code-executie en grenzen met websearch
Grok een lokale verify_design()-functie geeft die beslist over slagen of falen
Een lange, documentzware conversatie binnen de contextlimiet van het model houdt
Een consistent reviewformat teruggeeft en vervolgens redeneerniveaus vergelijkt
Dezelfde print blijft in beeld van de eerste imagereview tot de laatste Python-check.
Grok 4.7 vond elke geplande fout zodra het de datasheets had, en het gecorrigeerde ontwerp slaagde voor de Python-controles. Dat zegt iets over deze drie fouten, niet over circuitreviews in het algemeen.
Dit is één kleine print, geen benchmark. Een print met een dozijn datasheets creëert een grotere context en kan andere resultaten opleveren.
De Grok 4.7 API geeft Python-apps tekst- en afbeeldingsinput, tekstoutput en een contextwindow van 500.000 tokens via het model-ID grok-4.7. De officiële gids noemt redeneerniveaus low, medium, high (de standaard) en xhigh; redeneren kan niet worden uitgezet. De API ondersteunt ook function calling, gestructureerde outputs, websearch, X-zoekopdrachten en code-executie.
Onze Grok 4.7-overzicht behandelt de lancering en benchmarks. SpaceXAI bestempelt Chat Completions als legacy, dus elk voorbeeld hier gebruikt de Responses API.
Onder 200.000 prompttokens kost Grok 4.7 $2 per miljoen inputtokens, $0,50 per miljoen gecachete inputtokens en $6 per miljoen outputtokens. Zodra een prompt 200.000 tokens bereikt, worden alle tokens in dat request gefactureerd aan $4, $1 en $12.
Server-side tools hebben aparte kosten: de prijspagina rekent $5 per 1.000 websearch- of code-executie-calls. Zoeken in bijgevoegde documenten kost één cent per stuk, en opgeslagen documenten dragen ook een dagelijkse per-GiB-kost. Gebruik een stabiele prompt_cache_key voor gerelateerde requests, maar budgetteer voor niet-gecachete input.
Lees de gefactureerde kost uit usage.cost_in_usd_ticks. De kosten-trackingdocs zeggen dat deze caching en toolkosten omvat. Deel de waarde door 10^10 voor dollars.
Schakelingontwerp test documentlezen, berekeningen, toolgebruik en verificatie in één taak. SpaceXAI rapporteert 64,0% voor Grok 4.7 op EEBench. De EEBench-methodologie gebruikt simulaties en BOM-controles (bill of materials) in plaats van een LLM-jury, en EnviroNode volgt dezelfde regel.
EnviroNode Rev A is een sensor-node op USB-voeding. Je kunt het complete project downloaden van GitHub.
Het schema bevat elke componentwaarde die Grok nodig heeft voor de review. Elke eis heeft een ID zoals PWR-002 of BW-001, zodat elke bevinding kan verwijzen naar één regel.
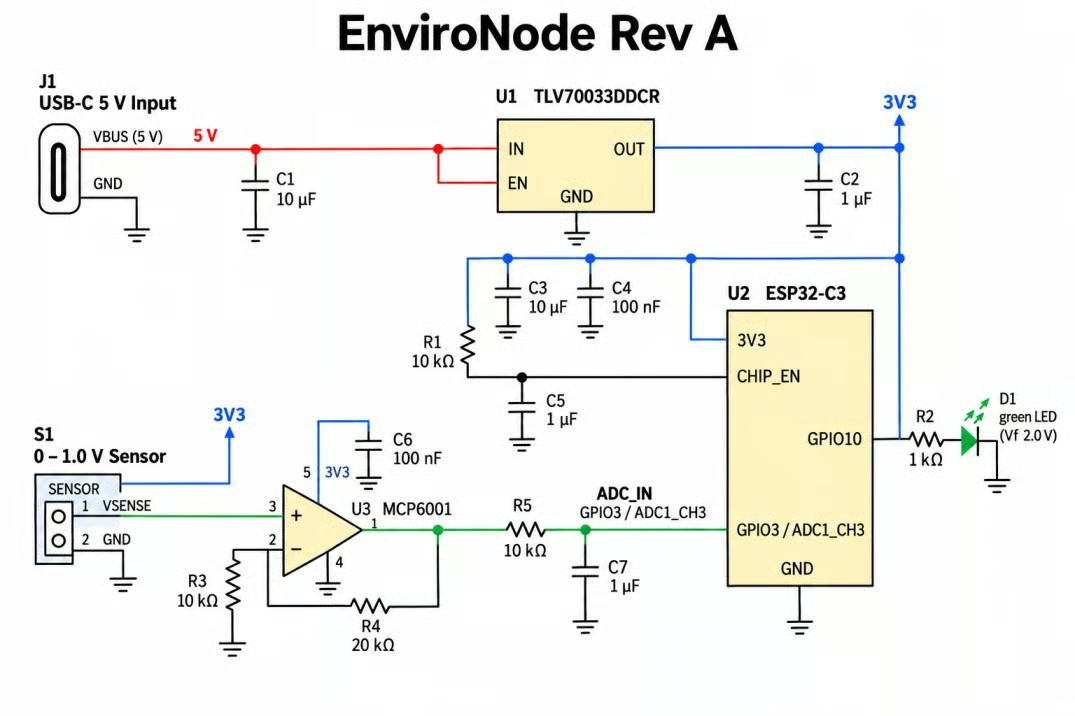
EnviroNode Rev A-schema met waarden. Afbeelding door de auteur.
Voordat Grok de print beoordeelt, leg je elke regel bloot die de verifier zal gebruiken. De functie retourneert vijf pass-or-fail-controles opgebouwd uit deze acht eisen:
Het model ontvangt dezelfde set eisen. Geen enkele verifierlimiet verschijnt pas nadat Grok een fix voorstelt.
Drie fouten zijn met getallen te controleren. Het aantal blijft buiten de prompt.
Regelaar te klein (PWR-002): de TI TLV700 is gespecificeerd voor 200 mA, terwijl de ESP32-C3-datasheet een Wi-Fi-zendpiek van 335 mA noemt en Espressifs schema-checklist minstens 500 mA vraagt.
ADC buiten bereik (ADC-001): een gain van 3 zet 3,0 V op de ADC, maar het effectieve bereik in de datasheet gaat tot 2.500 mV, en de eis staat 90% daarvan toe.
Filter te traag (BW-001): 10 kΩ en 1 µF geven een afsnijfrequentie van 15,9 Hz, terwijl signalen tot 100 Hz hoogstens 1 dB mogen verliezen.
De ADC-fout betreft meetbereik, niet pinschade. Correcte keuzes, zoals de LED-weerstand en CHIP_EN-vertraging, maken valse positieven meetbaar.
De review heeft een duidelijke scheidslijn nodig: Grok stelt wijzigingen voor, terwijl Python beslist over slagen of falen. Het diagram toont waar documenten en tools die lus binnenkomen.
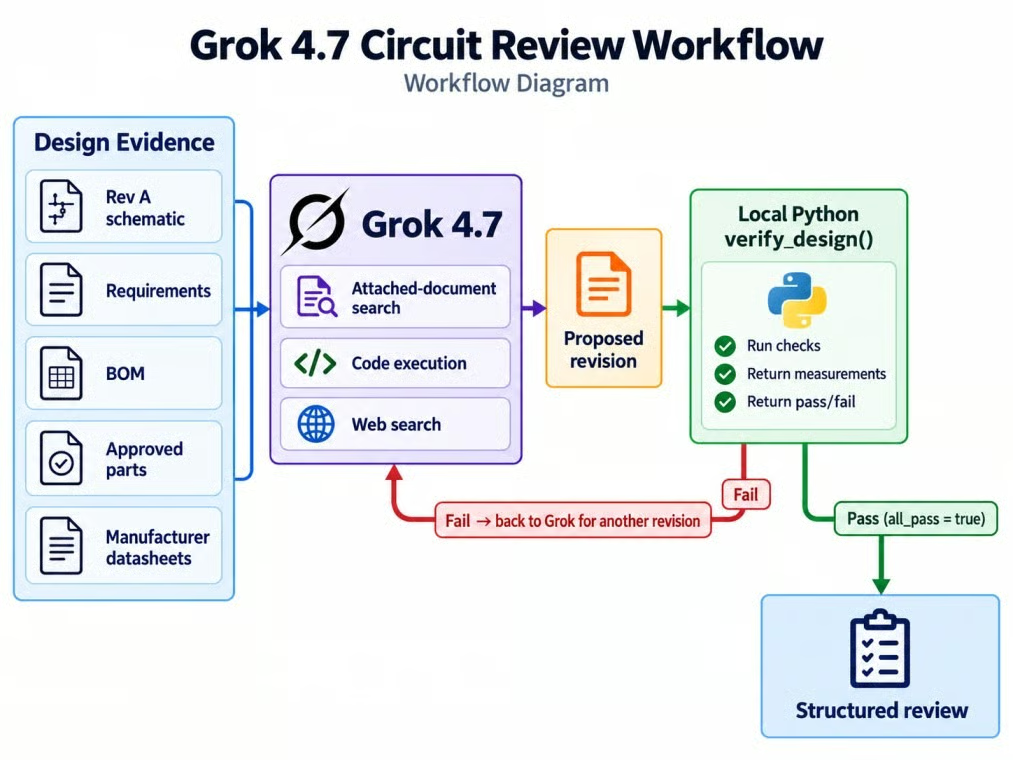
Reviewlus scheidt voorstel van verificatie. Afbeelding door de auteur.
Definieer succes vóór de eerste API-call. Tel een fout pas mee wanneer Grok die koppelt aan een eis en ondersteunend bewijs. Tel een fix pas mee wanneer verify_design() all_pass = true retourneert.
Je hebt een xAI API-sleutel met prepaid tegoed nodig, Python 3.10 of nieuwer, en de OpenAI Python SDK die naar xAI's base URL wijst. Maak de sleutel aan in de xAI Console en installeer vervolgens de pakketten hieronder.
python -m venv .venv
source .venv/bin/activate        # Windows: .venv\Scripts\activate
pip install openai python-dotenv pydantic httpx streamlit
pip install matplotlib schemdraw pytest  # Optionele diagrammen en verifier-tests
De API-voorbeelden gebruiken de eerste pakketgroep; de tweede ondersteunt repository-diagrammen en tests. Ik testte ze met Python 3.11.9, openai 3.19.2, pydantic 2.13.5, streamlit 1.64.0 en httpx 0.28.1. Sla de sleutel op als de XAI_API_KEY-omgevingsvariabele en laad die met python-dotenv in plaats van hem in je broncode te plaatsen; onze gids voor virtuele omgevingen legt de setup uit als dit nieuw voor je is.
Als je sleutel al werkt met de Responses API, ga dan naar Stap 1. Anders controleert dit request in één keer de sleutel, de base URL en het model-ID.
import os
import httpx
from dotenv import load_dotenv
from openai import OpenAI

load_dotenv()
client = OpenAI(api_key=os.environ["XAI_API_KEY"], base_url="https://api.x.ai/v1",
                timeout=httpx.Timeout(3600.0))

response = client.responses.create(
    model="grok-4.7",
    reasoning={"effort": "low"},
    input="In one sentence, what does a low-dropout regulator do?",
)
print(response.output_text)
Een antwoord van één zin betekent dat de setup werkt. De lange timeout is later belangrijk, omdat requests met redeneren en tools enkele minuten kunnen duren.
Ja, Grok 4.7 kan een schema beoordelen op basis van alleen een afbeelding, zolang de prompt duidelijk zegt dat er geen tools komen. De baseline stuurt de PNG als een base64 data-URL samen met de tekst van de eisen.
image = {
    "type": "input_image",
    "image_url": f"data:image/png;base64,{SCHEMATIC_B64}",
    "detail": "high",
}
response = client.responses.create(
    model="grok-4.7",
    input=[{"role": "user", "content": [
        image,
        {"type": "input_text", "text": REVIEW_PROMPT},
    ]}],
)
De prompt vraagt om drie secties: bevestigd, meer bewijs nodig en gecontroleerd en acceptabel. Er wordt niet gesproken over een aantal fouten of een verdacht onderdeel.
Zeg expliciet tegen het model wanneer er geen tools of datasheets beschikbaar zijn. Anders kan het het antwoord beëindigen nadat het heeft gezegd een specificatie op te zoeken waar het geen toegang toe heeft.
Zoals in de TL;DR vermeld, bevestigde Grok de filterfout met een afsnijfrequentie van 15,9 Hz en 16,1 dB verlies bij 100 Hz. Het plaatste de regelaar en de ADC onder "meer bewijs nodig" in plaats van te gokken naar hun grenzen.
Bijgevoegde documenten veranderen een vaag vermoeden in een claim gesteund door getallen. Upload elk document één keer en verwijs ernaar via file_id.
with open(DATASHEET_PATH, "rb") as datasheet:
    uploaded = client.files.create(
        file=datasheet,
        purpose="assistants",
        expires_after={"anchor": "created_at", "seconds": 7 * 24 * 3600},
    )
content = [image, *[{"type": "input_file", "file_id": fid} for fid in file_ids],
           {"type": "input_text", "text": EVIDENCE_PROMPT}]
Omdat deze tutorial expires_after op zeven dagen zet, zijn gecachete ID's alleen binnen dat venster geldig. Zonder expires_after bewaart xAI geüploade bestanden totdat je ze verwijdert.
In de met de OpenAI SDK vastgelegde responses verschenen bijlagenzoekopdrachten als custom_tool_call-items met de namen pdf_search en pdf_browse, terwijl het gebruik ze telde onder document_search_calls. Dat is waargenomen gedrag, niet het algemene contract voor tooltypes, dus de lus controleert ook de gedocumenteerde gebruiksteller.
De documenten losten de twee open vragen uit Stap 1 op en ondersteunden de power-, ADC- en filterbevindingen. De regelaarbevinding citeerde de 200 mA-rating van de TLV700, de 335 mA zendpiek van de ESP32-C3 en de aanbeveling van 500 mA voor de voeding.
Voor het filter werkte Grok uit welke condensatorwaarden beide bandbreedteregels zouden halen met R5 ongewijzigd: grofweg 32 tot 81 nF. Elke afleidingsoptie kwam onder "gecontroleerd en acceptabel" met een reden.
Code-executie is xAI's server-side Python-sandbox, toegevoegd aan tools als {"type": "code_interpreter"} wanneer je de OpenAI-client gebruikt. De prompt voegt één regel toe: elke claim met een getal moet worden berekend voordat die als bevestigd telt.
De eerder gelinkte gids voor code-executie zegt dat de sandbox geen netwerktoegang heeft en geen state behoudt tussen requests. Voor een paar datasheetgetallen is dat prima.
Vraag Grok om het powerbudget, het ADC-bereik en de filterbandbreedte in één script te controleren. Als schakelingen niet jouw ding zijn, sla de output hieronder over; de kern volgt erna.
f=  100.0 Hz  |H|=0.157177  attenuation=16.0722 dB
fc required for <= 1 dB at 100 Hz: fc >= 196.5227 Hz
V_adc_fs = 3.0000 V
90% limit = 2.2500 V
required rating = max(headroom, mcu min) = 500.00 mA
De minimale afsnijfrequentie van 196,5 Hz is het getal waar de filterfix van afhangt, en code berekent die in plaats van dat aan het rekenwerk van het model over te laten. Zelfs de minst-geattenueerde tolerantiesituatie verliest meer dan 15 dB bij 100 Hz, dus het oordeel blijft staan.
Ja. Websearch controleert of de bijgevoegde documenten nog actueel zijn, aangezien fabrikanten datasheets herzien na de training cutoff van een model. Beperk het tot officiële domeinen zodat het bewijs first-party blijft.
tools = [
    {"type": "code_interpreter"},
    {"type": "web_search", "filters": {"allowed_domains": ["ti.com", "espressif.com"]}},
]
De eerder gelinkte websearch-gids staat tot vijf allowed_domains toe, inclusief subdomeinen zoals docs.espressif.com. Ik zou deze stap aanhouden zelfs wanneer de bijgevoegde datasheets actueel zijn, omdat het een revisie kan opvangen die na je upload is gepubliceerd.
Grok zou de huidige TI-productpagina, de ESP32-C3-documentatie, de hardwarechecklist en relevante errata moeten citeren. Zie die citaties als bewijs van de bron, niet als bewijs dat de technische conclusie klopt.
Domeinfilters kunnen nog steeds een irrelevante pagina teruggeven. Controleer of elke citatie de exacte component en grens ondersteunt die in de berekening zijn gebruikt.
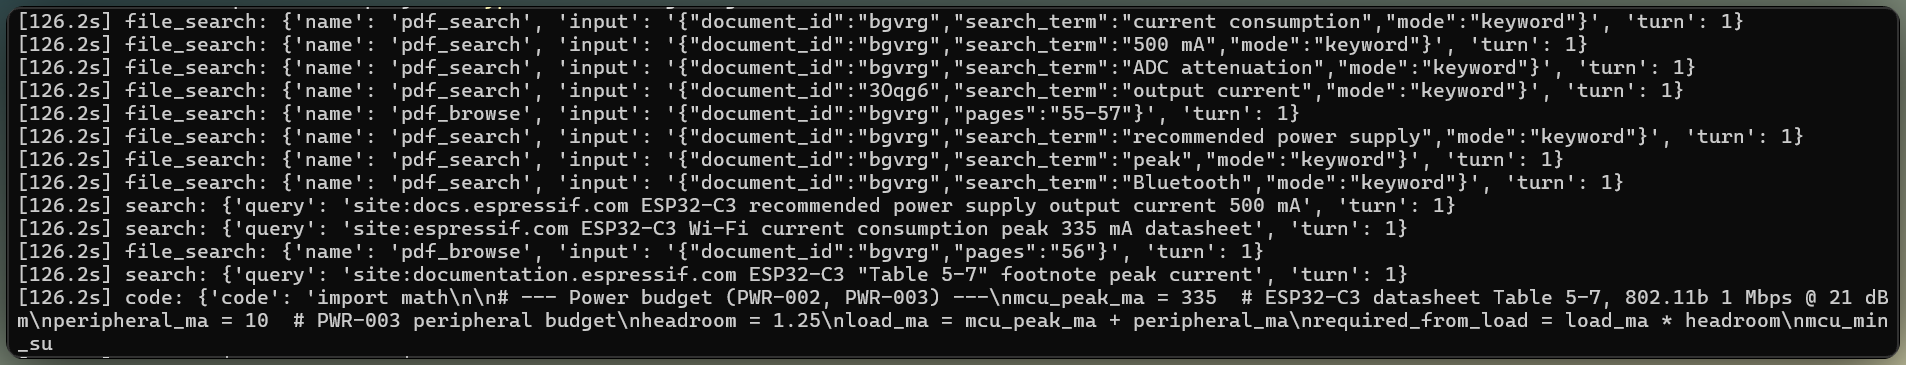
Grok zoekt in files, rekent, controleert bronnen. Afbeelding door de auteur.
verify_design() is een gewone Python-functie die op je machine draait en de enige beoordelaar is of een revisie slaagt. Grok stelt ontwerpwaarden voor via function calling, en de functie controleert ze tegen vaste grenzen.
VERIFY_DESIGN_TOOL = {
    "type": "function",
    "name": "verify_design",
    "description": "Deterministically check an EnviroNode revision against EN-REQ-001...",
    "parameters": {
        "type": "object",
        "properties": {
            "revision": {"type": "string"},
            "regulator_part": {"type": "string"},
            "gain_rf_ohm": {"type": "number"},
            "gain_rg_ohm": {"type": "number"},
            "filter_r_ohm": {"type": "number"},
            "filter_c_nf": {"type": "number"},
        },
        "required": ["revision", "regulator_part", "gain_rf_ohm",
                     "gain_rg_ohm", "filter_r_ohm", "filter_c_nf"],
    },
}
Vermogenscapaciteit moet voldoen aan max((335 + 10) mA × 1.25, 500 mA). Voor de ADC moet 1.0 V × (1 + Rf/Rg) tussen 1.500 en 2.250 mV blijven. Filtercontroles meten verlies bij 100 Hz en begrenzen de afsnijding op 500 Hz; elke check retourneert een waarde, een grens en slagen of falen.
Het toolschema vertelt Grok alleen welke waarden te sturen. De kernlogica voor slagen of falen is gewone Python:
import math

part = PARTS.get(regulator_part.strip().upper())
required_ma = max((335 + 10) * 1.25, 500)
power_ok = (
    part is not None
    and float(part["rated_iout_ma"]) >= required_ma
    and float(part["vin_max_v"]) >= 5.25
    and float(part["vout_v"]) == 3.3
)

gain = 1 + gain_rf_ohm / gain_rg_ohm
adc_mv = gain * 1000

fc = 1 / (2 * math.pi * filter_r_ohm * filter_c_nf * 1e-9)
loss_db = 10 * math.log10(1 + (100 / fc) ** 2)

checks = {
    "PWR-002": power_ok,
    "ADC-001": adc_mv <= 2250,
    "ADC-002": adc_mv >= 1500,
    "BW-001": loss_db <= 1.0,
    "BW-002": fc <= 500,
}
return {"all_pass": all(checks.values()), "checks": checks}
De volledige functie wijst ook ongeldige waarden af en retourneert metingen bij elk resultaat. Test hem met een bekend goed ontwerp, een bekend slecht ontwerp, een onbekend component en een near miss.
Houd componentratings buiten de controle van het model. Ik zou het model niet zijn eigen stroomrating laten aanleveren. Grok stuurt een onderdeelnr., en de functie zoekt de rating op in de catalogus van de applicatie.
Een agent moet niet zowel een oplossing voorstellen als beslissen of die correct is wanneer code het antwoord kan controleren. Vervang verify_design() door een test-suite of schemacontrole wanneer de taak verandert. De verifier schrijven kost extra werk, maar zijn resultaat slagen of falen hangt niet af van de mening van het model.
Geef Grok één doel: los elke bevestigde overtreding op met de kleinst mogelijke redelijke set wijzigingen, en verklaar het ontwerp niet compleet totdat de eerder gedefinieerde check slaagt. Geef het bewijs en de tools uit Stappen 3 t/m 5, en stel dan een requestlimiet in.
Hier is de contextwaarschuwing uit de TL;DR belangrijk. Los dat op vóór je meer beurten toevoegt.
Een vervolgrequest omvat eerdere toolresultaten, en documentzoekopdrachten kunnen veel tekst teruggeven. In het mislukte prototype bereikte de volgende voortzetting 1.116.321 tokens en overschreed het 500.000-tokenwindow van Grok 4.7.
Contextcompactie kan geen request redden dat al over de limiet is. De gecorrigeerde lus compresseert elke geslaagde documentzoekbeurt vóór het volgende request.
details = (response.usage.model_extra or {}).get(
    "server_side_tool_usage_details", {}
)
observed_attachment_call = any(
    item.type == "custom_tool_call"
    and item.name in {"pdf_search", "pdf_browse"}
    for item in response.output
)
used_documents = (
    details.get("document_search_calls", 0) > 0
    or observed_attachment_call
)

if used_documents:
    compacted = client.responses.compact(
        model="grok-4.7", input=history + list(response.output) + follow_up)
    history = list(compacted.output)  # pass the compaction item back unchanged
    # Compaction drops tool output, so restate the verifier's verdict ourselves.
    history.append({"role": "user", "content":
                    "verify_design results, exactly as returned: " + json.dumps(results)})
else:
    history = history + list(response.output) + follow_up
response = client.responses.create(model="grok-4.7", input=history, tools=TOOLS,
                                   store=False, prompt_cache_key=cache_key)
Behoud die laatste append. Compactie gooit uitgebreide tooloutput weg, dus het herhalen van het verifierresultaat helpt de volgende response om verzonnen of verwarde checks te vermijden. Comprimeren na elke documentzware beurt is een conservatief tempo; een groter systeem kan een inputtokendrempel gebruiken.
Ja. Grok veranderde één onderdeel in elk falend subsysteem: power, ADC-gain en filterbandbreedte. Het diagram toont de exacte waarden van Rev A en Rev B.
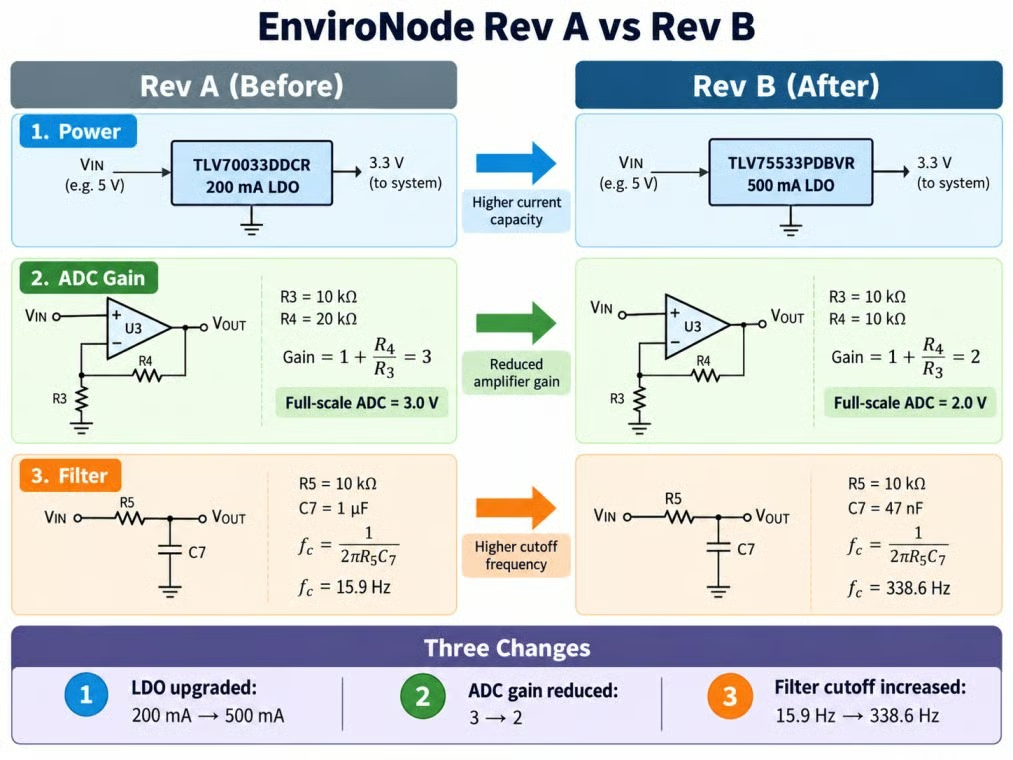
Drie componentwijzigingen corrigeren Rev A. Afbeelding door de auteur.
De herziene waarden gaan vervolgens naar verify_design(). Die retourneert één resultaat voor elke eis.
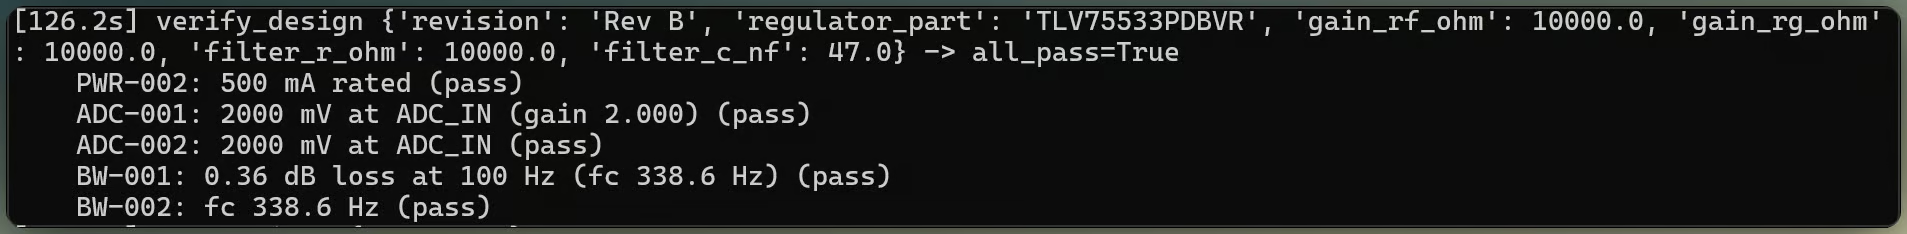
Herzien ontwerp slaagt voor alle verificatiechecks. Afbeelding door de auteur.
Een falend resultaat gaat terug als een function_call_output, zodat Grok het ontwerp kan herzien totdat de checks slagen of de requestlimiet is bereikt.
Gestructureerde outputs retourneren een object dat overeenkomt met een schema in plaats van proza dat je zou moeten parsen. Roep client.responses.parse() aan met een Pydantic-model in dezelfde conversatie, met toolcalls uitgezet.
class Finding(BaseModel):
    violated_requirement: str
    severity: Literal["blocker", "major", "minor"]
    evidence: list[str]
    recommended_change: str
    verifier_result: Literal["pass", "fail", "not_verified"]

parsed = client.responses.parse(
    model="grok-4.7", input=history + [REPORT_REQUEST],
    text_format=DesignReview, tools=TOOLS, tool_choice="none", store=False,
)
Een geldig schema is geen bewijs dat de inhoud klopt, dus neem de verifierresultaten op en zeg tegen Grok dat verifier_result daarop moet zijn gebaseerd. De JSON kan vervolgens een issuetracker of een menselijke goedkeuringsqueue voeden.
Het gestructureerde rapport moet elk oorspronkelijk defect als opgelost markeren, de gemeten waarde citeren die de verifier teruggaf, en ongeteste zorgen onder open_risks houden. Voor dit ontwerp omvatten die zorgen een regelaar die precies op de bodem van 500 mA zit en een ADC-condensator die afwijkt van Espressifs aanbeveling.
Hogere inspanning verbeterde de verifier-score niet, maar veranderde de kwaliteit van de filterfix. Elk niveau kreeg hetzelfde schema, dezelfde prompt, tools en requestlimiet.
|
Inspanning |
Defecten / valse positieven |
Verifier-calls |
Input / cached |
Output / redeneren |
Tools |
Tijd |
Kost |
|
|
3/3, 0; PASS |
1 |
256.006 / 197.120 |
7.950 / 2.323 |
7 |
111,2 s |
$0,2990 |
|
|
3/3, 0; PASS |
1 |
364.611 / 131.456 |
21.904 / 14.268 |
15 |
292,8 s |
$0,7385 |
|
|
3/3, 0; PASS |
2 |
413.071 / 336.896 |
19.685 / 14.800 |
17 |
277,8 s |
$0,5239 |
low verminderde de weerstand en behield de 1 µF-condensator, waardoor capacitatieve-belasting en settlinggedrag buiten de verifier bleven. Microchips richtlijnen voor capacitatieve belasting zeggen dat een serieweerstand de stabiliteit kan verbeteren, dus dit resultaat bewijst niet dat de fix instabiel is; het vraagt om frequentierespons-, staprespons- of benchtests. high veranderde in plaats daarvan de condensator, terwijl xhigh na een extra verifier-call dezelfde eindwaarden koos als high.
Voor deze enkele vergelijking gaf high de betere balans. Het vermeed de niet-gemodelleerde belastingszorg zonder de extra verifier-call die xhigh deed. Eén uitvoering per niveau kan geen algemene rangorde vaststellen.
Het antwoord op de openingsvraag is ja, binnen de verifier's vijf checks. De tabel vat de eerdere bevindingen samen in één overzicht.
Grok fixte de gecodeerde requirements. Het bewees niet dat de herziene print elektrisch compleet was of klaar voor productie.
Documenten bepalen of een zorg een bewijsbasis heeft. Python beslist of een revisie slaagt. Vloeiend proza kan geen van beide vervangen.
Onze Streamlit-gids legt de hier gebruikte interface uit. Die gebruikt streaming om toolcalls te tonen zodra ze binnenkomen en laat daarna de verifierchecks en het eindrapport zien.
Leer AI met DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min