คอร์ส
แนวคิดของ Large Language Models (LLMs)
2 ชม.
111.4K
สเกแมติกของวงจรคือไดอะแกรมที่แสดงการเชื่อมต่อของชิ้นส่วนอิเล็กทรอนิกส์ การตรวจทานหมายถึงการตรวจว่าองค์ประกอบและค่าที่ใช้ตรงตามข้อกำหนดการออกแบบหรือไม่ แหล่งจ่ายไฟจ่ายกระแสได้พอหรือไม่? โปรเซสเซอร์อ่านค่าสูงสุดของเซ็นเซอร์ได้เต็มช่วงหรือเปล่า? คำตอบมาจากสเกแมติก แผ่นข้อมูลของชิ้นส่วน และการคำนวณไม่กี่ขั้น
อยากทราบว่า Grok 4.7 จะทำบทรีวิวทั้งหมดนั้นได้ไหม คู่มือ Grok 4.7 ระบุว่ารุ่นนี้ถูกฝึกสำหรับงานยาวขึ้นและตรวจงานของตัวเองอย่างรอบคอบยิ่งขึ้น วงจรยังให้ตัวเลขที่ Python ธรรมดาตรวจสอบได้ จึงไม่ต้องใช้โมเดล AI ตัวอื่นมาตัดสินผล
สำหรับการทดลอง ได้สร้าง EnviroNode Rev A ซึ่งเป็นบอร์ดเซ็นเซอร์ขนาดเล็กจ่ายไฟด้วย USB และฝังข้อผิดพลาดไว้ 3 จุดในงานออกแบบ Grok ไม่ได้รับแจ้งว่ามีกี่จุด ต้องค้นหาเอง อ้างอิงแต่ละข้อด้วยเอกสารของชิ้นส่วน เสนอการแก้ไข และส่งค่าที่แก้ไขแล้วไปตรวจด้วย Python
ไม่จำเป็นต้องมีพื้นฐานวิศวกรรมไฟฟ้าก็อ่านตามได้ จะอธิบายกฎวงจรแต่ละข้อเมื่อปรากฏครั้งแรก สิ่งที่จะได้เรียนรู้ ได้แก่:
ส่งรูปสเกแมติกให้ Grok 4.7 ผ่าน Responses API
แนบแผ่นข้อมูลด้วย Files API แล้วให้ Grok ค้นหาในเอกสารเหล่านั้น
ตรวจการคำนวณด้วย code execution และตรวจขีดจำกัดด้วย web search
ให้ Grok ใช้ฟังก์ชันโลคัล verify_design() เพื่อตัดสินผ่านหรือไม่ผ่าน
คงบทสนทนายาวที่มีเอกสารจำนวนมากให้อยู่ในขีดจำกัดคอนเท็กซ์ของโมเดล
ส่งคืนรูปแบบรีวิวที่สม่ำเสมอ แล้วเปรียบเทียบระดับการให้เหตุผล
ใช้บอร์ดเดียวกันตั้งแต่รีวิวภาพครั้งแรกจนถึงการตรวจด้วย Python สุดท้าย
Grok 4.7 ระบุข้อผิดพลาดที่ฝังไว้ครบถ้วนเมื่อมีแผ่นข้อมูล และงานออกแบบที่แก้ไขแล้วผ่านการตรวจของ Python สิ่งนี้สะท้อนถึงข้อผิดพลาดทั้งสาม ไม่ใช่การรีวิววงจรโดยทั่วไป
นี่เป็นบอร์ดขนาดเล็กหนึ่งตัว ไม่ใช่เกณฑ์ทดสอบ บอร์ดที่มีแผ่นข้อมูลเป็นโหลจะสร้างคอนเท็กซ์ที่ใหญ่ขึ้นและอาจได้ผลลัพธ์ต่างออกไป
Grok 4.7 API ให้แอป Python ส่งข้อความและรูปภาพเข้า รับข้อความออก และมีหน้าต่างคอนเท็กซ์ 500,000 โทเค็น ผ่านรหัสโมเดล grok-4.7 คู่มืออย่างเป็นทางการระบุระดับการให้เหตุผล low, medium, high (ค่าเริ่มต้น) และ xhigh; การให้เหตุผลปิดไม่ได้ API ยังรองรับการเรียกฟังก์ชัน เอาต์พุตแบบมีโครงสร้าง การค้นเว็บ การค้น X และการรันโค้ด
บทความ ภาพรวม Grok 4.7 ของเราครอบคลุมการเปิดตัวและเกณฑ์วัด SpaceXAI จัดให้ Chat Completions เป็นแบบเดิม จึงใช้ Responses APIในทุกตัวอย่างที่นี่
ต่ำกว่า 200,000 โทเค็นพรอมต์ Grok 4.7 คิด $2 ต่อหนึ่งล้านโทเค็นอินพุต $0.50 ต่อหนึ่งล้านโทเค็นอินพุตแบบแคช และ $6 ต่อหนึ่งล้านโทเค็นเอาต์พุต เมื่อพรอมต์ถึง 200,000 โทเค็น ทุกโทเค็นในคำขอนั้นจะถูกคิดที่ $4, $1 และ $12
เครื่องมือฝั่งเซิร์ฟเวอร์มีค่าใช้จ่ายแยกต่างหาก: หน้าราคาคิด $5 ต่อ 1,000 ครั้งของการค้นเว็บหรือรันโค้ด การค้นเอกสารแนบคิดครั้งละหนึ่งเซ็นต์ และเอกสารที่เก็บไว้มีค่าบริการรายวันต่อ GiB ใช้ prompt_cache_key ที่คงที่สำหรับคำขอที่เกี่ยวข้อง แต่กันงบสำหรับอินพุตที่ไม่ถูกแคชไว้
อ่านค่าใช้จ่ายที่เรียกเก็บจาก usage.cost_in_usd_ticks เอกสาร การติดตามค่าใช้จ่ายระบุว่ารวมค่าแคชและค่าเครื่องมือแล้ว นำค่าที่ได้หารด้วย 10^10 เพื่อเป็นดอลลาร์
การออกแบบวงจรทดสอบการอ่านเอกสาร การคำนวณ การใช้เครื่องมือ และการยืนยันผลในงานเดียว SpaceXAI รายงาน 64.0% สำหรับ Grok 4.7 บน EEBench ระเบียบวิธีของ EEBench ใช้การจำลองและตรวจ BOM แทนการให้ LLM ตัดสิน และ EnviroNode ก็ทำตามหลักเดียวกัน
EnviroNode Rev A เป็นโหนดเซ็นเซอร์ที่จ่ายไฟด้วย USB ดาวน์โหลดโปรเจ็กต์ฉบับสมบูรณ์ได้จาก GitHub.
สเกแมติกมีค่าชิ้นส่วนทุกอย่างที่ Grok ต้องใช้ในการรีวิว แต่ละข้อกำหนดมีรหัส เช่น PWR-002 หรือ BW-001 เพื่อให้ทุกข้อค้นพบอ้างกลับไปยังกฎข้อหนึ่งได้
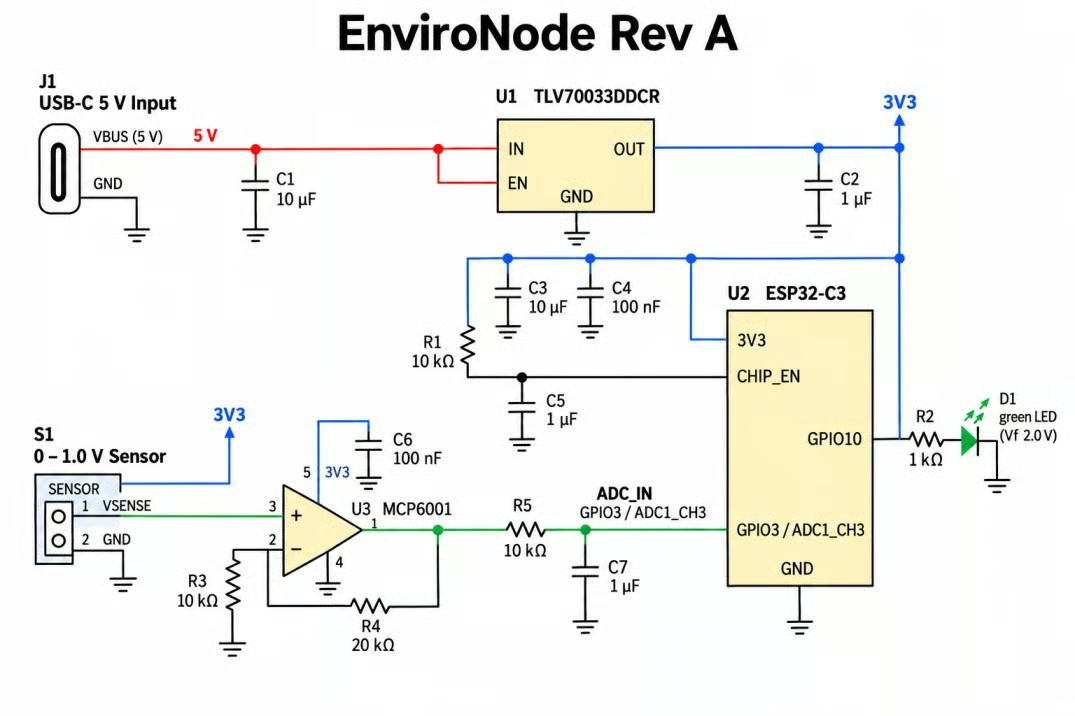
สเกแมติก EnviroNode Rev A พร้อมค่า อิมเมจโดยผู้เขียน
ก่อนที่ Grok จะรีวิวบอร์ด เปิดเผยกฎทุกข้อที่จะใช้โดยตัวตรวจยืนยัน ฟังก์ชันจะส่งคืนการตรวจแบบผ่าน-ไม่ผ่าน 5 รายการที่สร้างจากข้อกำหนด 8 ข้อต่อไปนี้:
โมเดลได้รับชุดข้อกำหนดเดียวกัน ไม่มีขีดจำกัดของตัวตรวจยืนยันที่โผล่มาหลังจาก Grok เสนอวิธีแก้ไข
ข้อผิดพลาดทั้งสามตรวจด้วยตัวเลขได้ จำนวนข้อผิดพลาดไม่ถูกใส่ไว้ในพรอมต์
เรกูเลเตอร์เล็กเกินไป (PWR-002): TI TLV700 รับกระแสได้ 200 mA ขณะที่ แผ่นข้อมูล ESP32-C3 ระบุพีกการส่ง Wi‑Fi 335 mA และ เช็กลิสต์สเกแมติก ของ Espressif ขออย่างน้อย 500 mA
ADC เกินช่วง (ADC-001): กำลังขยาย 3 ทำให้ได้ 3.0 V ที่ ADC แต่ช่วงใช้งานตามแผ่นข้อมูลสูงสุด 2,500 mV และข้อกำหนดอนุญาต 90% ของค่านั้น
ฟิลเตอร์ช้าเกินไป (BW-001): 10 kΩ และ 1 µF ให้ความถี่ตัด 15.9 Hz ขณะที่สัญญาณถึง 100 Hz ต้องสูญเสียไม่เกิน 1 dB
ข้อบกพร่องของ ADC เกี่ยวกับช่วงการวัด ไม่ใช่ความเสียหายที่ขา ตัวเลือกที่ถูกต้อง เช่น ตัวต้านทาน LED และดีเลย์ CHIP_EN ทำให้ตรวจวัดผลบวกลวงได้
รีวิวต้องมีขอบเขตที่ชัด: Grok เสนอการเปลี่ยนแปลง ขณะที่ Python เป็นเจ้าของผลผ่านหรือไม่ผ่าน ไดอะแกรมแสดงว่าจุดไหนที่เอกสารและเครื่องมือเข้าสู่ลูปนั้น
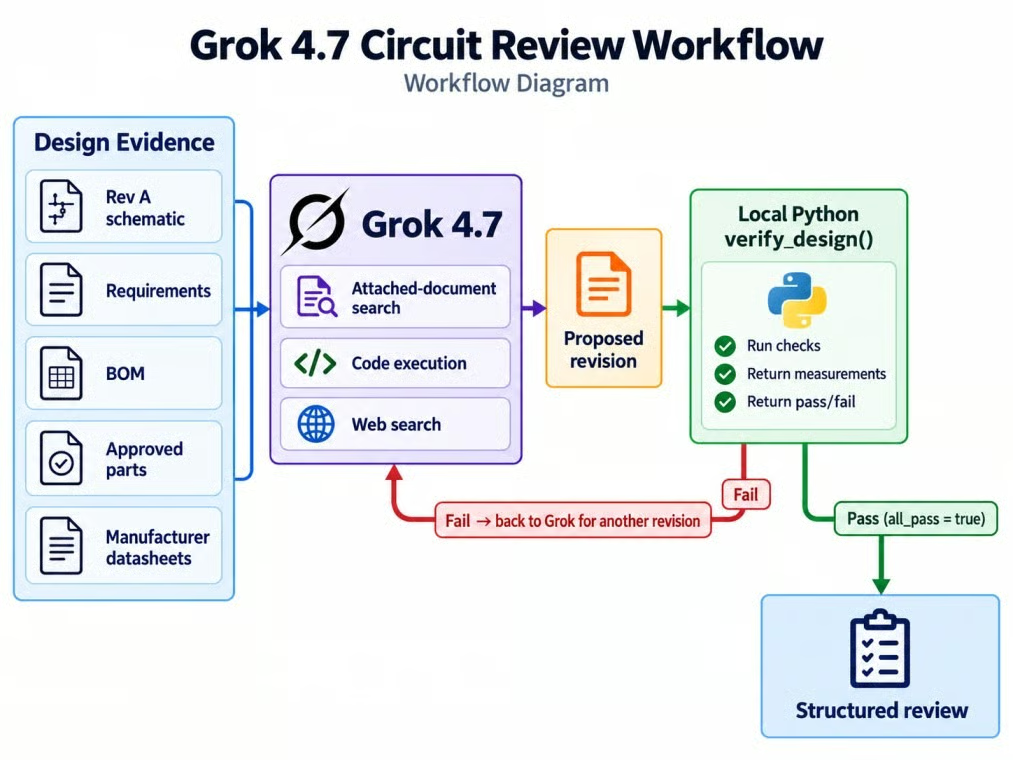
ลูปรีวิวแยกการเสนอจากการยืนยันผล อิมเมจโดยผู้เขียน
กำหนดความสำเร็จก่อนเรียก API ครั้งแรก นับข้อบกพร่องก็ต่อเมื่อ Grok เชื่อมโยงกับข้อกำหนดและหลักฐานสนับสนุน นับวิธีแก้ไขก็ต่อเมื่อ verify_design() ส่งคืน all_pass = true
ต้องมีคีย์ xAI API ที่เติมเครดิตไว้ Python 3.10 ขึ้นไป และชุดพัฒนา Python ของ OpenAI (SDK) ที่ชี้ไปยัง URL ฐานของ xAI สร้างคีย์ใน xAI Console แล้วติดตั้งแพ็กเกจด้านล่าง
python -m venv .venv
source .venv/bin/activate        # Windows: .venv\Scripts\activate
pip install openai python-dotenv pydantic httpx streamlit
pip install matplotlib schemdraw pytest  # Optional diagrams and verifier tests
ตัวอย่าง API ใช้แพ็กเกจกลุ่มแรก; กลุ่มที่สองรองรับไดอะแกรมและการทดสอบในรีโพ ผทดสอบด้วย Python 3.11.9, openai 3.19.2, pydantic 2.13.5, streamlit 1.64.0 และ httpx 0.28.1 บันทึกคีย์ไว้ในตัวแปรสภาพแวดล้อม XAI_API_KEY แล้วโหลดด้วย python-dotenv แทนการฝังไว้ในซอร์สโค้ด คู่มือ virtual environmentของเราจะอธิบายการตั้งค่าหากยังใหม่
หากคีย์ใช้งานกับ Responses API ได้แล้ว ให้ข้ามไปขั้นตอนที่ 1 มิฉะนั้น คำขอด้านล่างจะตรวจคีย์ URL ฐาน และรหัสโมเดลในคราวเดียว
import os
import httpx
from dotenv import load_dotenv
from openai import OpenAI

load_dotenv()
client = OpenAI(api_key=os.environ["XAI_API_KEY"], base_url="https://api.x.ai/v1",
                timeout=httpx.Timeout(3600.0))

response = client.responses.create(
    model="grok-4.7",
    reasoning={"effort": "low"},
    input="In one sentence, what does a low-dropout regulator do?",
)
print(response.output_text)
ได้คำตอบหนึ่งประโยคแปลว่าการตั้งค่าทำงานแล้ว การตั้งเวลาให้ยาวสำคัญในตอนหลัง เพราะคำขอที่ใช้การให้เหตุผลและเครื่องมืออาจใช้เวลาหลายนาที
ได้ Grok 4.7 รีวิวสเกแมติกจากรูปเพียงอย่างเดียวได้ ตราบใดที่พรอมต์บอกชัดว่าไม่มีเครื่องมือให้ใช้ ค่าเริ่มต้นจะส่ง PNG เป็น data URL แบบ base64 พร้อมกับข้อความข้อกำหนด
image = {
    "type": "input_image",
    "image_url": f"data:image/png;base64,{SCHEMATIC_B64}",
    "detail": "high",
}
response = client.responses.create(
    model="grok-4.7",
    input=[{"role": "user", "content": [
        image,
        {"type": "input_text", "text": REVIEW_PROMPT},
    ]}],
)
พรอมต์ขอ 3 ส่วน: ยืนยันแล้ว ต้องการหลักฐานเพิ่ม และตรวจแล้วว่าใช้ได้ โดยไม่เอ่ยถึงจำนวนข้อบกพร่องหรือชิ้นส่วนที่น่าสงสัย
บอกโมเดลให้ชัดเจนเมื่อไม่มีเครื่องมือหรือแผ่นข้อมูลให้ มิฉะนั้นอาจจบการตอบหลังจากบอกว่าจะค้นสเปกที่เข้าถึงไม่ได้
ตามที่สรุปไว้ Grok ยืนยันข้อบกพร่องของฟิลเตอร์ด้วยความถี่ตัด 15.9 Hz และการสูญเสีย 16.1 dB ที่ 100 Hz ส่วนเรกูเลเตอร์และ ADC ถูกจัดไว้ภายใต้ "ต้องการหลักฐานเพิ่ม" แทนที่จะเดาขีดจำกัดของมัน
เอกสารแนบเปลี่ยนความกังวลที่คลุมเครือให้เป็นข้ออ้างอิงตัวเลข อัปโหลดเอกสารแต่ละฉบับครั้งเดียวแล้วอ้างด้วย file_id
with open(DATASHEET_PATH, "rb") as datasheet:
    uploaded = client.files.create(
        file=datasheet,
        purpose="assistants",
        expires_after={"anchor": "created_at", "seconds": 7 * 24 * 3600},
    )
content = [image, *[{"type": "input_file", "file_id": fid} for fid in file_ids],
           {"type": "input_text", "text": EVIDENCE_PROMPT}]
ในบทเรียนนี้ตั้งค่า expires_after เป็น 7 วัน ดังนั้น ID ที่แคชไว้ใช้ได้เฉพาะในช่วงนั้น หากไม่ใช้ expires_after xAI จะเก็บไฟล์ที่อัปโหลดไว้จนกว่าจะลบ
ในคำตอบจาก SDK ของ OpenAI ที่บันทึกไว้ การค้นหาไฟล์แนบปรากฏเป็น custom_tool_call ชื่อ pdf_search และ pdf_browse ขณะที่การใช้งานนับไว้ใน document_search_calls นั่นเป็นพฤติกรรมที่สังเกตได้ ไม่ใช่สัญญาเรื่องชนิดเครื่องมือโดยรวม จึงมีการตรวจตัวนับการใช้งานที่มีเอกสารกำกับไว้ด้วย
เอกสารช่วยคลี่คลายสองคำถามค้างในขั้นตอนที่ 1 และสนับสนุนข้อค้นพบด้านพลังงาน ADC และฟิลเตอร์ ข้อค้นพบเรกูเลเตอร์อ้างถึงค่ารับกระแส 200 mA ของ TLV700 พีกส่ง 335 mA ของ ESP32-C3 และคำแนะนำแหล่งจ่าย 500 mA
สำหรับฟิลเตอร์ Grok คำนวณค่าคอนเดนเซอร์ที่ทำให้ผ่านกฎแบนด์วิดท์ทั้งสองโดยไม่เปลี่ยน R5: ราว 32 ถึง 81 nF เหยื่อล่อทุกตัวถูกจัดไว้ภายใต้ "ตรวจแล้วว่าใช้ได้" พร้อมเหตุผล
Code execution คือ sandbox Python ฝั่งเซิร์ฟเวอร์ของ xAI เพิ่มเข้าไปใน tools เป็น {"type": "code_interpreter"} เมื่อใช้ไคลเอนต์ OpenAI พรอมต์เพิ่มกฎหนึ่งข้อ: ทุกข้ออ้างที่มีตัวเลขต้องถูกคำนวณก่อนจึงจะนับว่ายืนยันแล้ว
คู่มือ code execution ที่ลิงก์ไว้บอกว่า sandbox ไม่มีการเข้าถึงเครือข่ายและไม่คงสถานะระหว่างคำขอ สำหรับตัวเลขไม่กี่ค่าจากแผ่นข้อมูลก็เพียงพอ
ขอให้ Grok ตรวจงบพลังงาน ช่วง ADC และแบนด์วิดท์ฟิลเตอร์ในสคริปต์เดียว หากวงจรไม่ใช่สายที่ถนัด ให้ข้ามเอาต์พุตด้านล่าง; สาระสำคัญอยู่ถัดจากนั้น
f=  100.0 Hz  |H|=0.157177  attenuation=16.0722 dB
fc required for <= 1 dB at 100 Hz: fc >= 196.5227 Hz
V_adc_fs = 3.0000 V
90% limit = 2.2500 V
required rating = max(headroom, mcu min) = 500.00 mA
ค่าความถี่ตัดขั้นต่ำ 196.5 Hz คือเลขที่วิธีแก้ฟิลเตอร์ขึ้นอยู่กับมัน และคำนวณด้วยโค้ดแทนที่จะปล่อยให้โมเดลคำนวณเอง แม้แต่มุมเผื่อที่ลดการสูญเสียน้อยที่สุดก็ยังสูญเสียมากกว่า 15 dB ที่ 100 Hz ดังนั้นคำตัดสินยังคงเดิม
ได้ การค้นเว็บตรวจว่าเอกสารแนบยังเป็นปัจจุบันหรือไม่ เพราะผู้ผลิตอาจแก้ไขแผ่นข้อมูลหลังเส้นตัดการฝึกของโมเดล จำกัดโดเมนให้เป็นของทางการเพื่อให้หลักฐานยังเป็นแหล่งข้อมูลปฐมภูมิ
tools = [
    {"type": "code_interpreter"},
    {"type": "web_search", "filters": {"allowed_domains": ["ti.com", "espressif.com"]}},
]
คู่มือการค้นเว็บที่ลิงก์ไว้ยอมให้ใส่ allowed_domains ได้สูงสุด 5 รายการ รวมถึงซับโดเมนอย่าง docs.espressif.com จะคงขั้นตอนนี้ไว้แม้แผ่นข้อมูลแนบจะเป็นฉบับล่าสุด เพราะอาจจับฉบับแก้ไขที่ออกหลังการอัปโหลดได้
Grok ควรอ้างหน้าผลิตภัณฑ์ TI ปัจจุบัน เอกสาร ESP32-C3 เช็กลิสต์ฮาร์ดแวร์ และ errata ที่เกี่ยวข้อง จงมองการอ้างอิงเหล่านี้เป็นหลักฐานของแหล่งที่มา ไม่ใช่หลักฐานว่าข้อสรุปทางวิศวกรรมถูกต้อง
ตัวกรองโดเมนยังอาจคืนหน้าที่ไม่เกี่ยวข้อง ตรวจว่าทุกการอ้างอิงสนับสนุนชิ้นส่วนและขีดจำกัดที่ใช้ในคำนวณตรงกันจริง
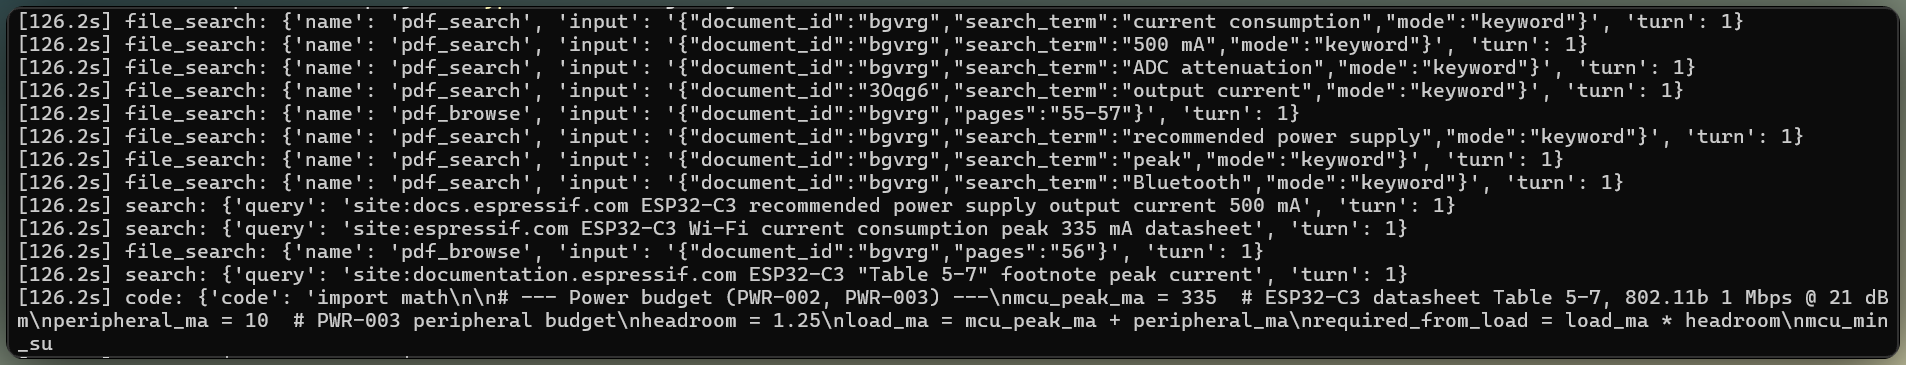
Grok ค้นหาไฟล์ คำนวณ ตรวจแหล่งข้อมูล อิมเมจโดยผู้เขียน
verify_design() เป็นฟังก์ชัน Python ธรรมดาที่รันบนเครื่อง และเป็นผู้ตัดสินเพียงคนเดียวว่างานปรับแก้ผ่านหรือไม่ Grok เสนอค่าการออกแบบผ่าน function calling และฟังก์ชันตรวจค่ากับขีดจำกัดตายตัว
VERIFY_DESIGN_TOOL = {
    "type": "function",
    "name": "verify_design",
    "description": "Deterministically check an EnviroNode revision against EN-REQ-001...",
    "parameters": {
        "type": "object",
        "properties": {
            "revision": {"type": "string"},
            "regulator_part": {"type": "string"},
            "gain_rf_ohm": {"type": "number"},
            "gain_rg_ohm": {"type": "number"},
            "filter_r_ohm": {"type": "number"},
            "filter_c_nf": {"type": "number"},
        },
        "required": ["revision", "regulator_part", "gain_rf_ohm",
                     "gain_rg_ohm", "filter_r_ohm", "filter_c_nf"],
    },
}
ความสามารถด้านพลังงานต้องเป็นไปตาม max((335 + 10) mA × 1.25, 500 mA) สำหรับ ADC ค่า 1.0 V × (1 + Rf/Rg) ต้องอยู่ระหว่าง 1,500 ถึง 2,250 mV การตรวจฟิลเตอร์วัดการสูญเสียที่ 100 Hz และจำกัดความถี่ตัดที่ 500 Hz; แต่ละเช็คส่งคืนค่า ขีดจำกัด และผลผ่านหรือไม่ผ่าน
สคีมาของเครื่องมือบอกเพียงว่าต้องการให้ Grok ส่งค่าอะไร แก่นของตรรกะผ่าน-ไม่ผ่านเป็น Python ปกติ:
import math

part = PARTS.get(regulator_part.strip().upper())
required_ma = max((335 + 10) * 1.25, 500)
power_ok = (
    part is not None
    and float(part["rated_iout_ma"]) >= required_ma
    and float(part["vin_max_v"]) >= 5.25
    and float(part["vout_v"]) == 3.3
)

gain = 1 + gain_rf_ohm / gain_rg_ohm
adc_mv = gain * 1000

fc = 1 / (2 * math.pi * filter_r_ohm * filter_c_nf * 1e-9)
loss_db = 10 * math.log10(1 + (100 / fc) ** 2)

checks = {
    "PWR-002": power_ok,
    "ADC-001": adc_mv <= 2250,
    "ADC-002": adc_mv >= 1500,
    "BW-001": loss_db <= 1.0,
    "BW-002": fc <= 500,
}
return {"all_pass": all(checks.values()), "checks": checks}
ฟังก์ชันเต็มยังปฏิเสธค่าที่ไม่ถูกต้องและส่งคืนค่าที่วัดได้พร้อมผลลัพธ์ ทดสอบด้วยงานออกแบบที่รู้ว่าใช้ได้ งานที่รู้ว่าใช้ไม่ได้ ชิ้นส่วนที่ไม่รู้จัก และกรณีเฉียดฉิว
เก็บค่าพิกัดของชิ้นส่วนนอกเหนือการควบคุมของโมเดล ไม่ควรให้โมเดลระบุค่ากระแสของตนเอง Grok ส่งหมายเลขชิ้นส่วน แล้วฟังก์ชันจะค้นหาค่าพิกัดจากแคตตาล็อกของแอปพลิเคชัน
เอเจนต์ไม่ควรทั้งเสนอวิธีแก้และตัดสินว่าถูกหรือไม่เมื่อโค้ดตรวจคำตอบได้ แทนที่ verify_design() ด้วยชุดทดสอบหรือการตรวจสคีมาเมื่อภารกิจเปลี่ยน การเขียนตัวตรวจยืนยันต้องใช้แรงเพิ่ม แต่ผลผ่านหรือไม่ผ่านไม่ขึ้นกับความเห็นของโมเดล
ให้ Grok มีเป้าหมายเดียว: แก้การละเมิดที่ยืนยันแล้วทุกข้อด้วยชุดการเปลี่ยนแปลงที่น้อยที่สุดอย่างสมเหตุสมผล และอย่าประกาศว่างานออกแบบเสร็จจนกว่าการตรวจที่กำหนดไว้ก่อนหน้าจะผ่าน จัดให้มีหลักฐานและเครื่องมือจากขั้นตอนที่ 3 ถึง 5 แล้วตั้งขีดจำกัดจำนวนคำขอ
ตรงนี้เองที่คำเตือนเรื่องคอนเท็กซ์ในสรุปสั้น ๆ สำคัญ แก้ปัญหานี้ก่อนเพิ่มรอบสนทนา
คำขอที่ต่อเนื่องจะรวมผลเครื่องมือก่อนหน้า และการค้นหาเอกสารอาจคืนข้อความจำนวนมาก ในต้นแบบที่ล้มเหลว การต่อครั้งถัดไปถึง 1,116,321 โทเค็นและเกินหน้าต่าง 500,000 โทเค็นของ Grok 4.7
การบีบอัดคอนเท็กซ์ ไม่สามารถช่วยคำขอที่เกินขีดแล้วได้ ลูปที่แก้ไขแล้วจะบีบอัดทุกเทิร์นที่ค้นหาเอกสารสำเร็จก่อนส่งคำขอครั้งถัดไป
details = (response.usage.model_extra or {}).get(
    "server_side_tool_usage_details", {}
)
observed_attachment_call = any(
    item.type == "custom_tool_call"
    and item.name in {"pdf_search", "pdf_browse"}
    for item in response.output
)
used_documents = (
    details.get("document_search_calls", 0) > 0
    or observed_attachment_call
)

if used_documents:
    compacted = client.responses.compact(
        model="grok-4.7", input=history + list(response.output) + follow_up)
    history = list(compacted.output)  # pass the compaction item back unchanged
    # Compaction drops tool output, so restate the verifier's verdict ourselves.
    history.append({"role": "user", "content":
                    "verify_design results, exactly as returned: " + json.dumps(results)})
else:
    history = history + list(response.output) + follow_up
response = client.responses.create(model="grok-4.7", input=history, tools=TOOLS,
                                   store=False, prompt_cache_key=cache_key)
คงการ append ท้ายสุดนั้นไว้ การบีบอัดจะตัดเอาต์พุตของเครื่องมือที่ยืดยาวออก ดังนั้นการย้ำผลตัวตรวจยืนยันช่วยให้คำตอบถัดไปเลี่ยงการตรวจที่แต่งขึ้นหรือสับสน การบีบอัดหลังทุกเทิร์นที่หนักเอกสารเป็นจังหวะที่รอบคอบ; ระบบใหญ่กว่าอาจใช้เกณฑ์จำนวนโทเค็นอินพุตแทน
ผ่าน Grok เปลี่ยนชิ้นส่วนหนึ่งตัวในแต่ละซับซิสเต็มที่ล้มเหลว: พลังงาน กำลังขยาย ADC และแบนด์วิดท์ของฟิลเตอร์ ไดอะแกรมแสดงค่า Rev A และ Rev B ที่แน่นอน
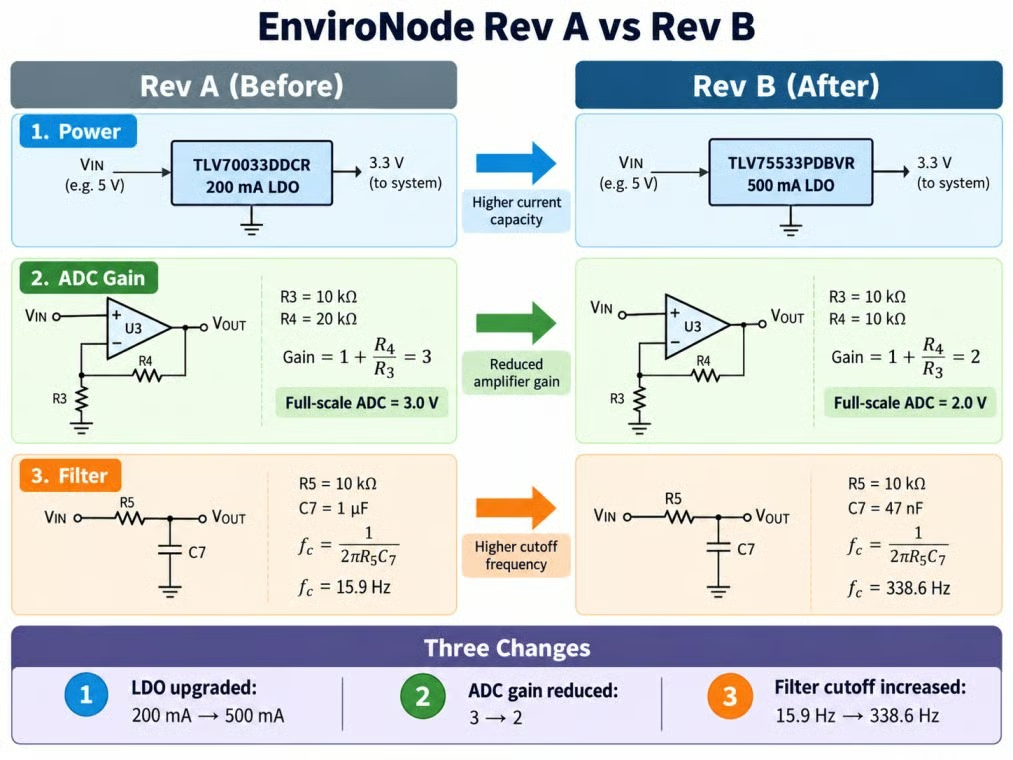
การเปลี่ยน 3 ชิ้นส่วนแก้ Rev A ได้ อิมเมจโดยผู้เขียน
จากนั้นส่งค่าที่แก้ไขไปยัง verify_design() ซึ่งจะส่งผลหนึ่งรายการต่อข้อกำหนด
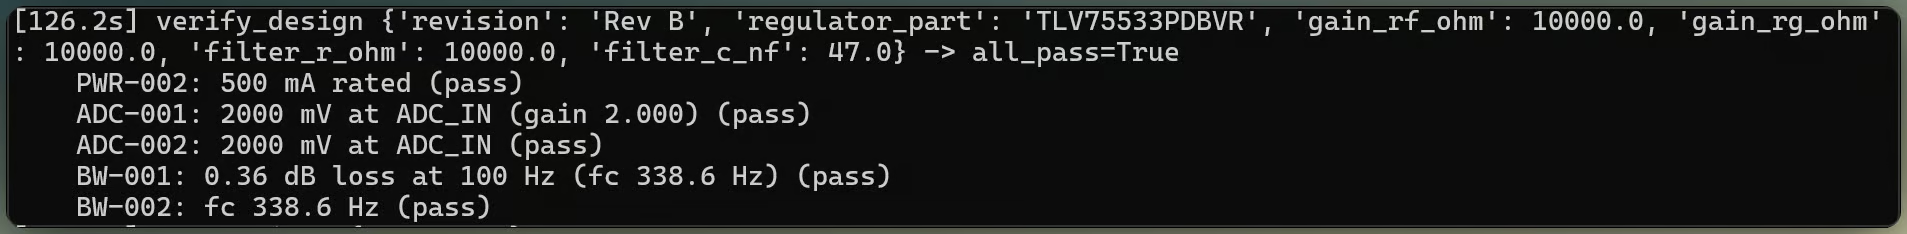
งานออกแบบที่แก้ไขผ่านการตรวจทุกข้อ อิมเมจโดยผู้เขียน
ผลที่ไม่ผ่านจะส่งกลับเป็น function_call_output เพื่อให้ Grok ปรับงานออกแบบต่อไปจนกว่าจะผ่านเช็คหรือลิมิตคำขอหมด
เอาต์พุตแบบมีโครงสร้าง ส่งคืนอ็อบเจ็กต์ที่ตรงตามสคีมาแทนโพรสที่ต้องพาร์สเอง เรียก client.responses.parse() ด้วยโมเดล Pydantic ในบทสนทนาเดียวกัน โดยปิดการเรียกเครื่องมือ
class Finding(BaseModel):
    violated_requirement: str
    severity: Literal["blocker", "major", "minor"]
    evidence: list[str]
    recommended_change: str
    verifier_result: Literal["pass", "fail", "not_verified"]

parsed = client.responses.parse(
    model="grok-4.7", input=history + [REPORT_REQUEST],
    text_format=DesignReview, tools=TOOLS, tool_choice="none", store=False,
)
สคีมาที่ถูกต้องไม่ใช่หลักฐานว่าเนื้อหาถูกต้อง ดังนั้นให้รวมผลตัวตรวจยืนยันและบอก Grok ให้ยึด verifier_result ตามนั้น JSON ที่ได้สามารถส่งต่อเข้า issue tracker หรือคิวอนุมัติโดยมนุษย์ได้
รายงานแบบมีโครงสร้างควรทำเครื่องหมายว่าข้อบกพร่องเดิมแต่ละข้อได้รับการแก้ไข อ้างค่าที่วัดได้จากตัวตรวจยืนยัน และเก็บประเด็นที่ยังไม่ทดสอบไว้ภายใต้ open_risks สำหรับงานออกแบบนี้ ประเด็นดังกล่าวรวมถึงเรกูเลเตอร์ที่อยู่ตรงพื้น 500 mA พอดี และคอนเดนเซอร์ของ ADC ที่ต่างจากคำแนะนำของ Espressif
ระดับที่สูงขึ้นไม่ได้ปรับคะแนนของตัวตรวจยืนยันให้ดีขึ้น แต่เปลี่ยน คุณภาพของวิธีแก้ฟิลเตอร์ แต่ละระดับได้รับสเกแมติก พรอมต์ เครื่องมือ และลิมิตคำขอเหมือนกัน
|
Effort |
Defects / false positives |
Verifier calls |
Input / cached |
Output / reasoning |
Tools |
Time |
Cost |
|
|
3/3, 0; PASS |
1 |
256,006 / 197,120 |
7,950 / 2,323 |
7 |
111.2 s |
$0.2990 |
|
|
3/3, 0; PASS |
1 |
364,611 / 131,456 |
21,904 / 14,268 |
15 |
292.8 s |
$0.7385 |
|
|
3/3, 0; PASS |
2 |
413,071 / 336,896 |
19,685 / 14,800 |
17 |
277.8 s |
$0.5239 |
low ลดค่าตัวต้านทานและคงคอนเดนเซอร์ 1 µF ไว้ ทำให้ประเด็นโหลดเชิงความจุและการเซตตัวอยู่นอกตัวตรวจยืนยัน คำแนะนำโหลดเชิงความจุของ Microchip ระบุว่าตัวต้านทานอนุกรมช่วยปรับเสถียรภาพได้ ดังนั้นผลนี้ไม่ได้พิสูจน์ว่าวิธีแก้ไม่เสถียร; ควรทดสอบการตอบสนองความถี่ การตอบสนองต่อสเต็ป หรือทดสอบบนเบนช์ high เปลี่ยนคอนเดนเซอร์แทน ขณะที่ xhigh เลือกค่าท้ายสุดเหมือน high หลังมีการเรียกตัวตรวจยืนยันเพิ่มหนึ่งครั้ง
สำหรับการเปรียบเทียบครั้งเดียวนี้ high ให้สมดุลที่ดีกว่า เลี่ยงประเด็นโหลดที่ไม่ได้ทำแบบจำลองโดยไม่ต้องเรียกตัวตรวจยืนยันเพิ่มแบบ xhigh การรันต่อระดับเพียงครั้งเดียวยังสรุปอันดับโดยรวมไม่ได้
คำตอบของคำถามเปิดคือ ได้ ภายในขอบเขตการตรวจของตัวตรวจยืนยันทั้งห้าข้อ ตารางสรุปผลก่อนหน้าไว้ในมุมมองเดียว
Grok แก้ไขข้อกำหนดที่เข้ารหัสไว้เรียบร้อย แต่ไม่ได้พิสูจน์ว่าบอร์ดที่แก้ไขสมบูรณ์ทางไฟฟ้าหรือพร้อมผลิต
เอกสารตัดสินว่าความกังวลมีหลักฐานหรือไม่ Python ตัดสินว่าฉบับแก้ผ่านหรือไม่ โพรสสละสลวยทดแทนทั้งสองอย่างไม่ได้
บทความ Streamlit ของเราอธิบายอินเทอร์เฟซที่ใช้ที่นี่ ใช้ สตรีมมิง เพื่อแสดงการเรียกเครื่องมือแบบเรียลไทม์ แล้วแสดงเช็คของตัวตรวจยืนยันและรายงานสุดท้าย
เรียนรู้ AI กับ DataCamp
คอร์ส
คอร์ส
คอร์ส