
Kurs
Konzepte großer Sprachmodelle (LLMs)
2 Std.
111.4K
Ein Schaltplan zeigt, wie elektronische Bauteile verbunden sind. Ein Review prüft, ob Bauteile und Werte die Designanforderungen erfüllen. Liefert die Stromversorgung genug Strom? Kann der Prozessor den vollen Sensorausgang einlesen? Die Antworten stecken im Schaltplan, in den Datenblättern und in ein paar Berechnungen.
Ich wollte sehen, ob Grok 4.7 den kompletten Review durchführen kann. Der Grok 4.7 Guide sagt, das Modell wurde auf längere Aufgaben trainiert und prüft seine Arbeit sorgfältiger. Eine Schaltung liefert Zahlen, die sich mit normalem Python-Code prüfen lassen – ein weiteres KI-Modell ist dafür nicht nötig.
Für das Experiment habe ich EnviroNode Rev A gebaut, ein kleines USB-betriebenes Sensor-Board, und drei Fehler absichtlich eingebaut. Grok erfährt nicht, wie viele Fehler es gibt. Das Modell muss sie finden, mit Bauteildokumentation belegen, Korrekturen vorschlagen und die korrigierten Werte durch Python-Checks schicken.
Du brauchst keinen Hintergrund in Elektrotechnik, um mitzukommen. Ich erkläre jede Regel, sobald sie vorkommt. Du lernst, wie du:
Ein Schaltbild als Bild über die Responses API an Grok 4.7 sendest
Datenblätter mit der Files API anhängst und Grok darin suchen lässt
Berechnungen mit Codeausführung und Grenzwerte mit Websuche prüfst
Grok eine lokale verify_design()-Funktion gibst, die über bestanden/nicht bestanden entscheidet
Eine lange, dokumentenlastige Unterhaltung innerhalb des Kontextlimits des Modells hältst
Ein konsistentes Reviewformat zurückgibst und anschließend die Reasoning-Levels vergleichst
Dasselbe Board bleibt vom ersten Bildreview bis zum abschließenden Python-Check im Fokus.
Grok 4.7 hat alle eingebauten Fehler identifiziert, sobald die Datenblätter vorlagen, und das korrigierte Design hat die Python-Checks bestanden. Das sagt etwas über diese drei Fehler, nicht über Schaltungsreviews im Allgemeinen.
Das ist ein kleines Board, kein Benchmark. Ein Board mit einem Dutzend Datenblättern erzeugt einen größeren Kontext und kann andere Ergebnisse liefern.
Die Grok 4.7 API bietet Python-Apps Text- und Bildeingaben, Textausgaben und ein Kontextfenster mit 500.000 Tokens über die Modell-ID grok-4.7. Der offizielle Guide listet die Reasoning-Levels low, medium, high (Standard) und xhigh auf; Reasoning lässt sich nicht abschalten. Die API unterstützt außerdem Funktionsaufrufe, strukturierte Ausgaben, Websuche, X-Suche und Codeausführung.
Unsere Grok 4.7 Übersicht deckt Launch und Benchmarks ab. SpaceXAI stuft Chat Completions als Legacy ein, daher nutzen alle Beispiele hier die Responses API.
Unter 200.000 Prompt-Tokens kostet Grok 4.7 $2 pro Million Eingabetokens, $0,50 pro Million gecachter Eingabetokens und $6 pro Million Ausgabetokens. Ab 200.000 Tokens im Prompt werden alle Tokens dieser Anfrage mit $4, $1 und $12 berechnet.
Serverseitige Tools haben separate Gebühren: Die Preisseite berechnet $5 pro 1.000 Websuche- oder Codeausführungsaufrufe. Suchen in angehängten Dokumenten kosten je einen Cent, und gespeicherte Dokumente verursachen zusätzlich eine tägliche Gebühr pro GiB. Verwende für verwandte Anfragen einen stabilen prompt_cache_key, aber plane Budget für ungecachte Eingaben ein.
Lies die berechneten Kosten aus usage.cost_in_usd_ticks. Die Kosten-Tracking-Dokumentation sagt, sie umfasst Caching- und Tool-Gebühren. Teile den Wert durch 10^10 für US-Dollar.
Schaltungsdesign testet Dokumentenverständnis, Berechnungen, Toolnutzung und Verifikation in einer Aufgabe. SpaceXAI meldet 64,0% für Grok 4.7 auf EEBench. Die EEBench-Methodik nutzt Simulationen und Stücklisten-Checks (BOM) statt eines LLM-Judges, und EnviroNode folgt demselben Prinzip.
EnviroNode Rev A ist ein USB-betriebener Sensorknoten. Du kannst das komplette Projekt von GitHub herunterladen.
Der Schaltplan enthält alle Bauteilwerte, die Grok für das Review braucht. Jede Anforderung hat eine ID wie PWR-002 oder BW-001, sodass jeder Fund auf eine Regel verweisen kann.
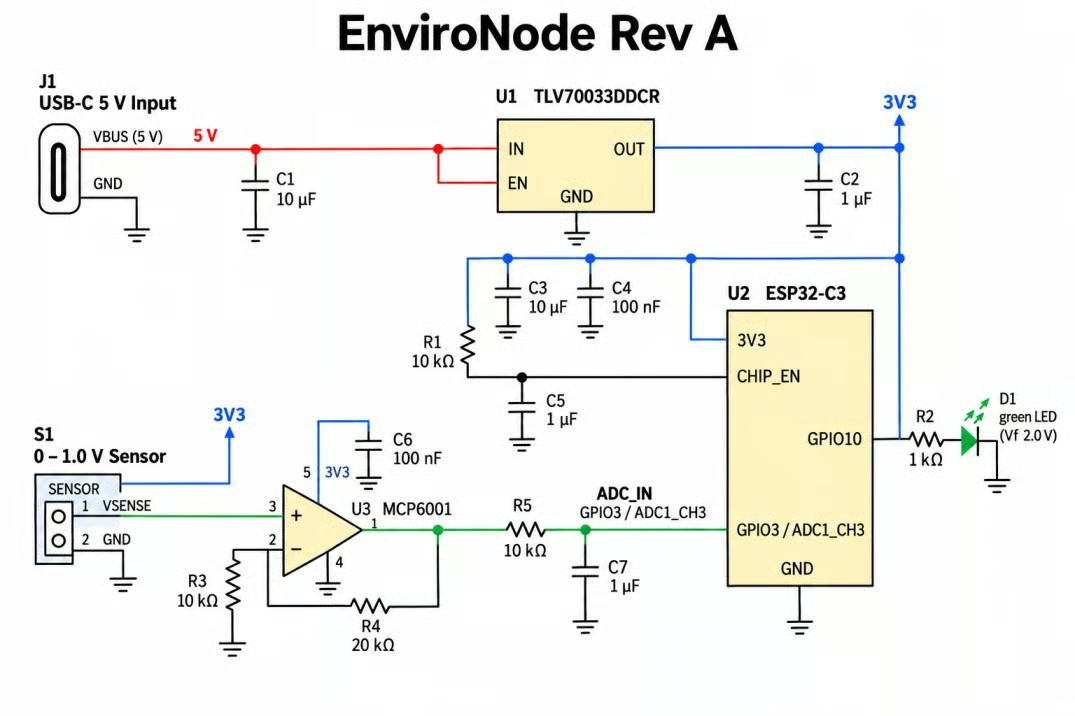
EnviroNode Rev A Schaltplan mit Werten. Bild: Autor.
Bevor Grok das Board prüft, lege alle Regeln offen, die der Verifier nutzt. Die Funktion liefert fünf Bestanden-/Nicht-bestanden-Checks basierend auf diesen acht Anforderungen:
Das Modell erhält denselben Anforderungssatz. Keine Verifier-Grenze taucht erst nach Grok’s Fixvorschlägen auf.
Drei Fehler lassen sich mit Zahlen überprüfen. Ihre Anzahl bleibt aus dem Prompt heraus.
Regler zu klein (PWR-002): Der TI TLV700 ist für 200 mA ausgelegt, während das ESP32-C3-Datenblatt einen 335-mA-Wi-Fi-Transmit-Peak ausweist und Espressifs Schematic-Checkliste mindestens 500 mA fordert.
ADC über Bereich (ADC-001): Eine Verstärkung von 3 bringt 3,0 V an den ADC, aber der effektive Bereich im Datenblatt endet bei 2.500 mV, und die Anforderung lässt 90% davon zu.
Filter zu langsam (BW-001): 10 kΩ und 1 µF ergeben eine Grenzfrequenz von 15,9 Hz, während Signale bis 100 Hz höchstens 1 dB verlieren dürfen.
Der ADC-Defekt betrifft den Messbereich, nicht die Pinschädigung. Richtige Entscheidungen wie der LED-Widerstand und die CHIP_EN-Verzögerung machen Fehlalarme messbar.
Das Review braucht eine klare Trennung: Grok schlägt Änderungen vor, Python entscheidet über bestehen oder nicht. Das Diagramm zeigt, wo Dokumente und Tools in die Schleife kommen.
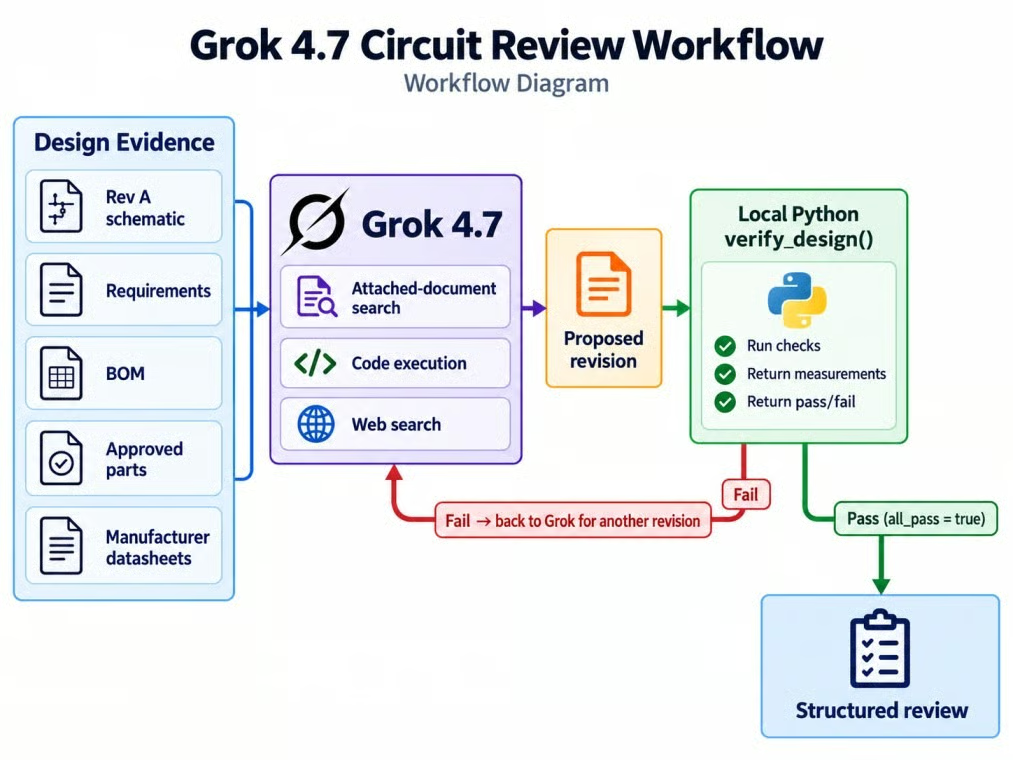
Die Review-Schleife trennt Vorschlag und Verifikation. Bild: Autor.
Definiere Erfolg vor dem ersten API-Call. Zähle einen Defekt nur, wenn Grok ihn mit einer Anforderung und stützenden Belegen verknüpft. Zähle einen Fix nur, wenn verify_design() all_pass = true zurückgibt.
Du brauchst einen xAI API-Schlüssel mit Prepaid-Guthaben, Python 3.10 oder neuer und das OpenAI-Python-SDK, das auf xAI’s Base-URL zeigt. Erstelle den Schlüssel in der xAI Console und installiere dann die unten verwendeten Pakete.
python -m venv .venv
source .venv/bin/activate        # Windows: .venv\Scripts\activate
pip install openai python-dotenv pydantic httpx streamlit
pip install matplotlib schemdraw pytest  # Optionale Diagramme und Verifier-Tests
Die API-Beispiele nutzen die erste Paketgruppe; die zweite unterstützt Diagramme und Tests im Repository. Getestet mit Python 3.11.9, openai 3.19.2, pydantic 2.13.5, streamlit 1.64.0 und httpx 0.28.1. Speichere den Schlüssel als Umgebungsvariable XAI_API_KEY und lade ihn mit python-dotenv statt ihn im Quellcode abzulegen; unser Virtual-Environment-Guide erklärt das Setup, falls es neu für dich ist.
Wenn dein Schlüssel bereits mit der Responses API funktioniert, springe zu Schritt 1. Andernfalls prüft diese Anfrage Schlüssel, Base-URL und Modell-ID in einem Rutsch.
import os
import httpx
from dotenv import load_dotenv
from openai import OpenAI

load_dotenv()
client = OpenAI(api_key=os.environ["XAI_API_KEY"], base_url="https://api.x.ai/v1",
                timeout=httpx.Timeout(3600.0))

response = client.responses.create(
    model="grok-4.7",
    reasoning={"effort": "low"},
    input="In one sentence, what does a low-dropout regulator do?",
)
print(response.output_text)
Eine Ein-Satz-Antwort bedeutet, dass das Setup funktioniert. Das lange Timeout ist später wichtig, weil Anfragen mit Reasoning und Tools mehrere Minuten dauern können.
Ja, Grok 4.7 kann einen Schaltplan allein anhand eines Bildes prüfen, solange der Prompt klar sagt, dass keine Tools folgen. Die Basisvariante sendet das PNG als Base64-Data-URL zusammen mit dem Anforderungstext.
image = {
    "type": "input_image",
    "image_url": f"data:image/png;base64,{SCHEMATIC_B64}",
    "detail": "high",
}
response = client.responses.create(
    model="grok-4.7",
    input=[{"role": "user", "content": [
        image,
        {"type": "input_text", "text": REVIEW_PROMPT},
    ]}],
)
Der Prompt fordert drei Abschnitte: bestätigt, braucht weitere Belege, sowie geprüft und akzeptabel. Er erwähnt keine Fehleranzahl und kein verdächtiges Teil.
Sag dem Modell explizit, wenn keine Tools oder Datenblätter verfügbar sind. Andernfalls beendet es die Antwort womöglich mit dem Hinweis, eine Spezifikation nachzuschlagen, auf die es nicht zugreifen kann.
Wie im TL;DR erwähnt, hat Grok den Filterdefekt mit 15,9 Hz Grenzfrequenz und 16,1 dB Verlust bei 100 Hz bestätigt. Regler und ADC landeten unter „weitere Belege nötig“, statt Grenzwerte zu raten.
Angehängte Dokumente machen aus einer vagen Vermutung eine Zahl-belegte Aussage. Lade jedes Dokument einmal hoch und referenziere es über die file_id.
with open(DATASHEET_PATH, "rb") as datasheet:
    uploaded = client.files.create(
        file=datasheet,
        purpose="assistants",
        expires_after={"anchor": "created_at", "seconds": 7 * 24 * 3600},
    )
content = [image, *[{"type": "input_file", "file_id": fid} for fid in file_ids],
           {"type": "input_text", "text": EVIDENCE_PROMPT}]
Weil dieses Tutorial expires_after auf sieben Tage setzt, sind gecachte IDs nur in diesem Zeitraum gültig. Ohne expires_after behält xAI hochgeladene Dateien, bis du sie löschst.
In den hier aufgezeichneten OpenAI-SDK-Antworten erschienen Anhangsuchen als custom_tool_call-Items namens pdf_search und pdf_browse, während die Nutzung sie unter document_search_calls zählte. Das ist beobachtetes Verhalten, kein allgemeiner Tool-Typ-Vertrag, daher prüft die Schleife zusätzlich den dokumentierten Nutzungszähler.
Die Dokumente lösten die zwei offenen Fragen aus Schritt 1 und stützten die Funde zu Leistung, ADC und Filter. Beim Regler zitierte der Fund das 200-mA-Rating des TLV700, den 335-mA-Transmit-Peak des ESP32-C3 und die 500-mA-Empfehlung.
Für den Filter ermittelte Grok, welche Kondensatorwerte beide Bandbreiten-Regeln mit unverändertem R5 erfüllen: grob 32 bis 81 nF. Jeder Köder landete unter „geprüft und akzeptabel“ mit Begründung.
Codeausführung ist xAI’s serverseitige Python-Sandbox, die du im OpenAI-Client über tools als {"type": "code_interpreter"} aktivierst. Der Prompt ergänzt eine Regel: Jede Aussage mit einer Zahl muss berechnet werden, bevor sie als bestätigt zählt.
Der oben verlinkte Guide zur Codeausführung sagt, die Sandbox hat keinen Netzwerkzugang und behält keinen Zustand zwischen Anfragen. Für ein paar Datenblattzahlen ist das völlig okay.
Bitte Grok, Leistungsbudget, ADC-Bereich und Filterbandbreite in einem Skript zu prüfen. Wenn Schaltungen nicht deins sind, überspringe die Ausgabe unten; die Quintessenz folgt unmittelbar danach.
f=  100.0 Hz  |H|=0.157177  attenuation=16.0722 dB
fc required for <= 1 dB at 100 Hz: fc >= 196.5227 Hz
V_adc_fs = 3.0000 V
90% limit = 2.2500 V
required rating = max(headroom, mcu min) = 500.00 mA
Die minimale Grenzfrequenz von 196,5 Hz ist die Zahl, von der die Filterkorrektur abhängt – und der Code berechnet sie statt sie dem Kopfrechnen des Modells zu überlassen. Selbst die toleranteste Ecke verliert bei 100 Hz über 15 dB, das Urteil steht also fest.
Ja. Die Websuche prüft, ob die angehängten Dokumente noch aktuell sind, denn Hersteller überarbeiten Datenblätter nach dem Trainingsstichtag eines Modells. Beschränke sie auf offizielle Domains, damit die Belege aus erster Hand stammen.
tools = [
    {"type": "code_interpreter"},
    {"type": "web_search", "filters": {"allowed_domains": ["ti.com", "espressif.com"]}},
]
Der oben verlinkte Websuche-Guide erlaubt bis zu fünf allowed_domains, inklusive Subdomains wie docs.espressif.com. Ich würde diesen Schritt selbst bei aktuellen Datenblättern beibehalten, da er eine Revision nach deinem Upload erkennen kann.
Grok sollte die aktuelle TI-Produktseite, die ESP32-C3-Dokumentation, die Hardware-Checkliste und relevante Errata zitieren. Behandle diese Zitate als Beleg für die Quelle, nicht als Beweis, dass die ingenieurtechnische Schlussfolgerung korrekt ist.
Domain-Filter können dennoch eine irrelevante Seite liefern. Prüfe, dass jedes Zitat genau das verwendete Bauteil und den genutzten Grenzwert stützt.
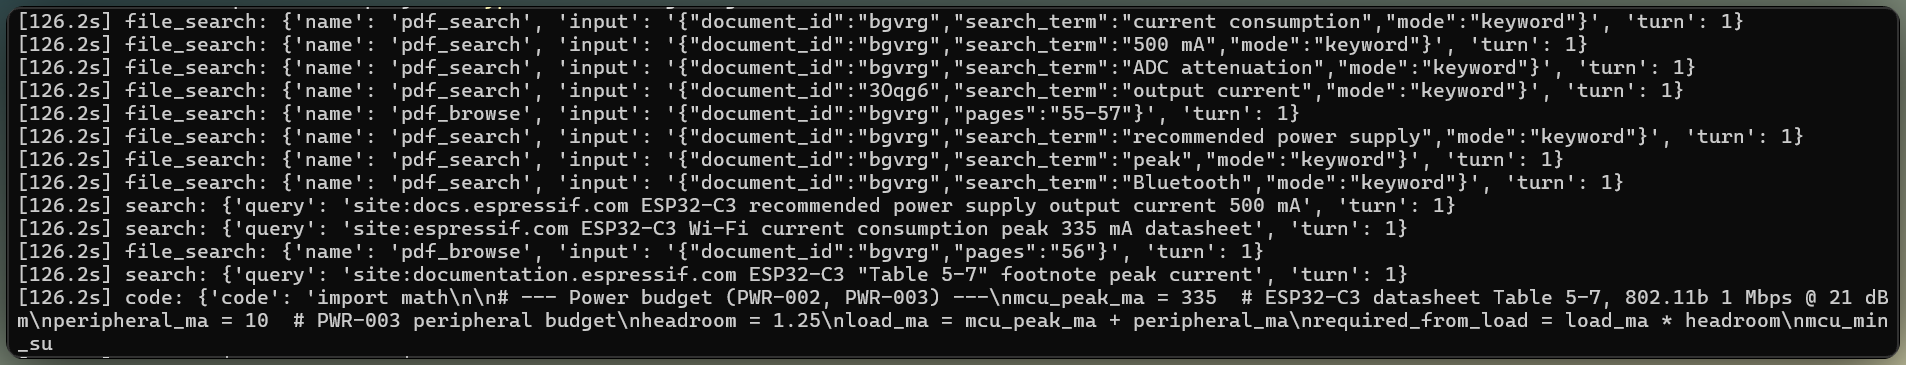
Grok durchsucht Dateien, rechnet und prüft Quellen. Bild: Autor.
verify_design() ist eine einfache Python-Funktion auf deinem Rechner und die einzige Instanz, die über bestehen oder nicht entscheidet. Grok schlägt Designwerte via Funktionsaufrufe vor, und die Funktion prüft sie gegen feste Grenzen.
VERIFY_DESIGN_TOOL = {
    "type": "function",
    "name": "verify_design",
    "description": "Deterministically check an EnviroNode revision against EN-REQ-001...",
    "parameters": {
        "type": "object",
        "properties": {
            "revision": {"type": "string"},
            "regulator_part": {"type": "string"},
            "gain_rf_ohm": {"type": "number"},
            "gain_rg_ohm": {"type": "number"},
            "filter_r_ohm": {"type": "number"},
            "filter_c_nf": {"type": "number"},
        },
        "required": ["revision", "regulator_part", "gain_rf_ohm",
                     "gain_rg_ohm", "filter_r_ohm", "filter_c_nf"],
    },
}
Die Leistungskapazität muss max((335 + 10) mA × 1.25, 500 mA) erfüllen. Für den ADC muss 1.0 V × (1 + Rf/Rg) zwischen 1.500 und 2.250 mV bleiben. Filter-Checks messen den Verlust bei 100 Hz und begrenzen die Grenzfrequenz auf 500 Hz; jeder Check liefert Messwert, Grenzwert und Bestanden/Nicht bestanden.
Das Tool-Schema sagt Grok nur, welche Werte zu senden sind. Die Kernlogik für Bestanden/Nicht bestanden ist normales Python:
import math

part = PARTS.get(regulator_part.strip().upper())
required_ma = max((335 + 10) * 1.25, 500)
power_ok = (
    part is not None
    and float(part["rated_iout_ma"]) >= required_ma
    and float(part["vin_max_v"]) >= 5.25
    and float(part["vout_v"]) == 3.3
)

gain = 1 + gain_rf_ohm / gain_rg_ohm
adc_mv = gain * 1000

fc = 1 / (2 * math.pi * filter_r_ohm * filter_c_nf * 1e-9)
loss_db = 10 * math.log10(1 + (100 / fc) ** 2)

checks = {
    "PWR-002": power_ok,
    "ADC-001": adc_mv <= 2250,
    "ADC-002": adc_mv >= 1500,
    "BW-001": loss_db <= 1.0,
    "BW-002": fc <= 500,
}
return {"all_pass": all(checks.values()), "checks": checks}
Die vollständige Funktion lehnt auch ungültige Werte ab und gibt mit jedem Ergebnis Messungen zurück. Teste sie mit einem bekannten guten Design, einem bekannten schlechten Design, einem unbekannten Bauteil und einem Beinahetreffer.
Halte Bauteilratings außerhalb der Kontrolle des Modells. Ich würde das Modell nicht seine eigene Stromangabe liefern lassen. Grok sendet eine Teilenummer, und die Funktion liest das Rating aus dem Katalog der Anwendung.
Ein Agent sollte nicht zugleich eine Lösung vorschlagen und darüber entscheiden, ob sie korrekt ist, wenn Code die Antwort prüfen kann. Ersetze verify_design() durch eine Testsuite oder Schemachecks, wenn sich die Aufgabe ändert. Der Verifier kostet Aufwand, aber sein Ergebnis hängt nicht von der Meinung des Modells ab.
Gib Grok ein Ziel: Behebe jeden bestätigten Verstoß mit dem kleinstmöglichen sinnvollen Set an Änderungen und erkläre das Design erst dann für fertig, wenn der zuvor definierte Check besteht. Stelle die Belege und Tools aus den Schritten 3 bis 5 bereit und setze dann ein Anfrage-Limit.
Hier zählt die Kontextwarnung aus dem TL;DR. Löse sie, bevor du weitere Turns hinzufügst.
Eine Fortsetzung enthält frühere Tool-Ergebnisse, und Dokumentsuchen können viel Text zurückgeben. Im fehlgeschlagenen Prototyp erreichte die nächste Fortsetzung 1.116.321 Tokens und überschritt Grok 4.7’s 500.000er Fenster.
Kontextkomprimierung kann eine bereits übergroße Anfrage nicht retten. Die korrigierte Schleife komprimiert jeden erfolgreichen Dokument-Suchturn, bevor die nächste Anfrage gesendet wird.
details = (response.usage.model_extra or {}).get(
    "server_side_tool_usage_details", {}
)
observed_attachment_call = any(
    item.type == "custom_tool_call"
    and item.name in {"pdf_search", "pdf_browse"}
    for item in response.output
)
used_documents = (
    details.get("document_search_calls", 0) > 0
    or observed_attachment_call
)

if used_documents:
    compacted = client.responses.compact(
        model="grok-4.7", input=history + list(response.output) + follow_up)
    history = list(compacted.output)  # pass the compaction item back unchanged
    # Compaction drops tool output, so restate the verifier's verdict ourselves.
    history.append({"role": "user", "content":
                    "verify_design results, exactly as returned: " + json.dumps(results)})
else:
    history = history + list(response.output) + follow_up
response = client.responses.create(model="grok-4.7", input=history, tools=TOOLS,
                                   store=False, prompt_cache_key=cache_key)
Lass dieses letzte append stehen. Die Komprimierung entfernt ausführliche Tool-Ausgaben, daher hilft das erneute Festhalten des Verifier-Ergebnisses der nächsten Antwort, erfundene oder verwechselte Checks zu vermeiden. Nach jedem dokumentenlastigen Turn zu komprimieren ist konservativ; ein größeres System kann stattdessen eine Eingabe-Token-Schwelle nutzen.
Ja. Grok änderte je ein Bauteil in jedem fehlerhaften Teilsystem: Leistung, ADC-Verstärkung und Filterbandbreite. Das Diagramm zeigt die genauen Werte von Rev A und Rev B.
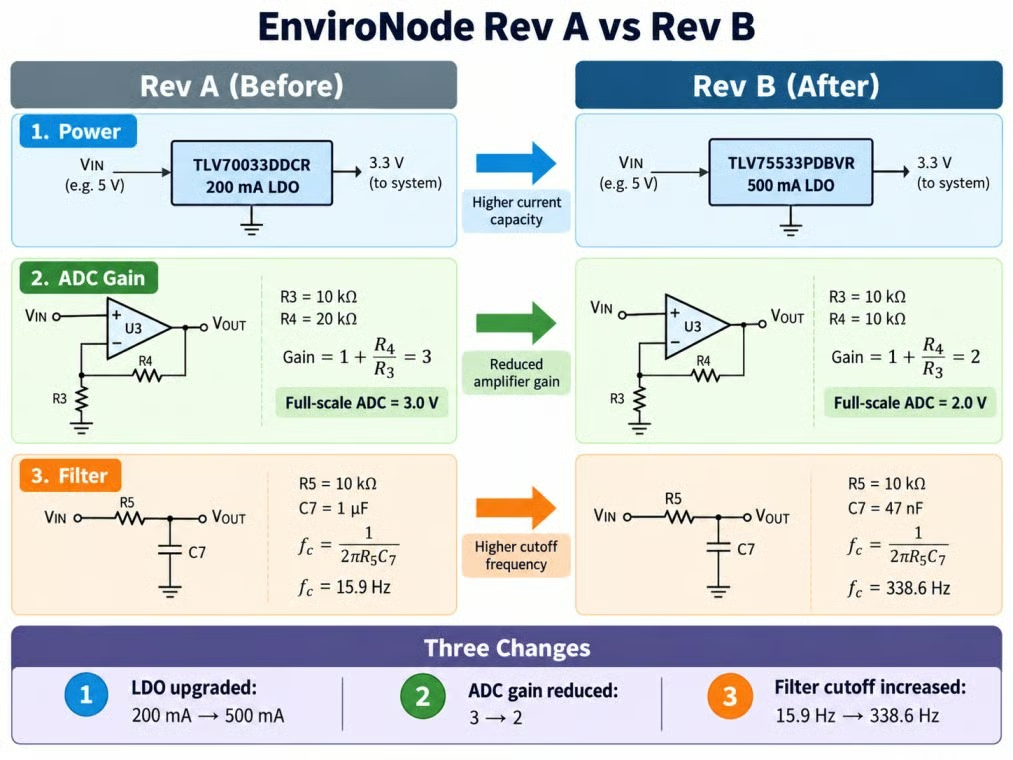
Drei Bauteiländerungen korrigieren Rev A. Bild: Autor.
Die revidierten Werte gehen dann an verify_design(). Es liefert ein Ergebnis pro Anforderung.
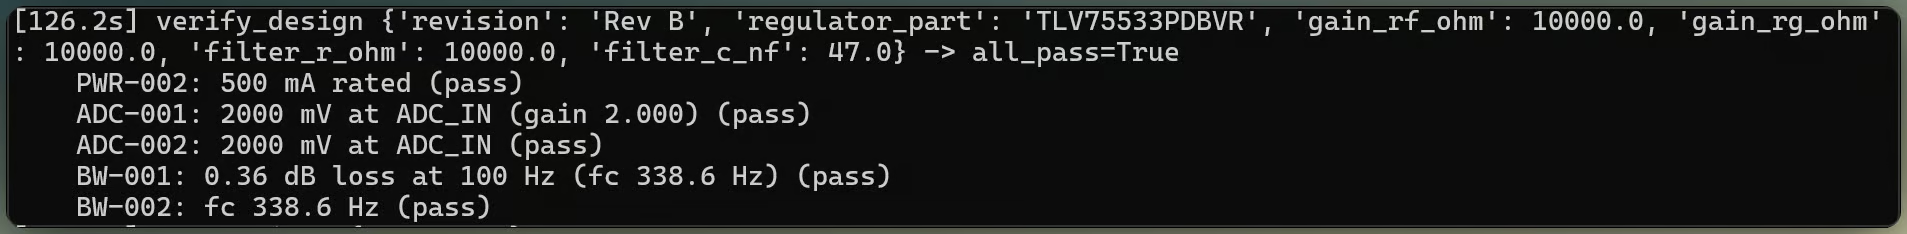
Das revidierte Design besteht alle Verifikations-Checks. Bild: Autor.
Ein nicht bestandenes Ergebnis kommt als function_call_output zurück, sodass Grok das Design überarbeiten kann, bis die Checks bestehen oder das Anfrage-Limit erreicht ist.
Strukturierte Ausgaben liefern ein Objekt, das einem Schema entspricht – statt Fließtext, den du parsen müsstest. Rufe client.responses.parse() mit einem Pydantic-Modell in derselben Unterhaltung auf, bei deaktivierten Tool-Aufrufen.
class Finding(BaseModel):
    violated_requirement: str
    severity: Literal["blocker", "major", "minor"]
    evidence: list[str]
    recommended_change: str
    verifier_result: Literal["pass", "fail", "not_verified"]

parsed = client.responses.parse(
    model="grok-4.7", input=history + [REPORT_REQUEST],
    text_format=DesignReview, tools=TOOLS, tool_choice="none", store=False,
)
Ein gültiges Schema beweist nicht, dass der Inhalt stimmt, daher binde die Verifier-Ergebnisse ein und sag Grok, verifier_result darauf zu stützen. Das JSON kann dann ein Issue-Tracking oder eine menschliche Freigabe speisen.
Der strukturierte Bericht sollte jeden ursprünglichen Defekt als behoben markieren, den gemessenen Wert des Verifiers zitieren und ungeprüfte Punkte unter open_risks führen. Für dieses Design gehören dazu ein Regler genau am 500-mA-Minimum und ein ADC-Kondensator, der von Espressifs Empfehlung abweicht.
Höherer Effort verbesserte nicht den Verifier-Score, veränderte aber die Qualität des Filter-Fixes. Jede Stufe erhielt denselben Schaltplan, Prompt, dieselben Tools und dasselbe Anfrage-Limit.
|
Effort |
Defekte / False Positives |
Verifier-Aufrufe |
Input / gecached |
Output / Reasoning |
Tools |
Zeit |
Kosten |
|
|
3/3, 0; PASS |
1 |
256.006 / 197.120 |
7.950 / 2.323 |
7 |
111,2 s |
$0,2990 |
|
|
3/3, 0; PASS |
1 |
364.611 / 131.456 |
21.904 / 14.268 |
15 |
292,8 s |
$0,7385 |
|
|
3/3, 0; PASS |
2 |
413.071 / 336.896 |
19.685 / 14.800 |
17 |
277,8 s |
$0,5239 |
low reduzierte den Widerstand und ließ den 1 µF-Kondensator unverändert – kapazitive Last und Einschwingverhalten blieben außerhalb des Verifiers. Microchips Hinweise zu kapazitiver Last sagen, ein Serienwiderstand kann die Stabilität verbessern; dieses Ergebnis beweist also nicht, dass der Fix instabil ist – es ruft nach Frequenzgang-, Step-Response- oder Labortests. high änderte stattdessen den Kondensator, während xhigh nach einem zusätzlichen Verifier-Call dieselben Endwerte wie high wählte.
In diesem Einzelvergleich lieferte high die bessere Balance. Es vermied das nicht modellierte Last-Thema ohne den zusätzlichen Verifier-Call von xhigh. Ein Lauf pro Level reicht nicht für ein generelles Ranking.
Die Antwort auf die Eingangsfrage ist Ja – innerhalb der fünf Checks des Verifiers. Die Tabelle fasst die Ergebnisse kompakt zusammen.
Grok hat die kodierten Anforderungen erfüllt. Es hat nicht bewiesen, dass das revidierte Board elektrisch vollständig oder produktionsreif ist.
Dokumente entscheiden, ob ein Verdacht Belege hat. Python entscheidet, ob eine Revision besteht. Fließtext ersetzt keines von beidem.
Unser Streamlit-Guide erklärt die hier verwendete Oberfläche. Sie nutzt Streaming, um Tool-Aufrufe live zu zeigen, und anschließend die Verifier-Checks und den Abschlussbericht.
Lerne KI mit DataCamp
Kurs
Kurs
Kurs
Tutorial
Matt Crabtree
5 Min.
Tutorial
Satyabrata Pal
15 Min.
Tutorial
Aditya Sharma
5 Min.
Tutorial
DataCamp Team
5 Min.
Tutorial
DataCamp Team
4 Min.
Tutorial
Sejal Jaiswal
24 Min.


