

Quantization คืออะไร?
Quantization คือเทคนิคการบีบอัดโมเดลที่ลดความแม่นยำของเวทของโมเดล
ปกติแล้วโมเดลภาษาขนาดใหญ่จะถูกจัดเก็บในฟอร์แมตความแม่นยำสูงอย่าง BF16 หรือ FP16 ซึ่งรักษาคุณภาพไว้ได้ดีแต่ใช้หน่วยความจำมาก การควอนไทซ์จะแปลงเวทเหล่านั้นให้เป็นฟอร์แมตที่มีจำนวนบิตต่ำลง เช่น 8 บิตหรือ 4 บิต ทำให้โมเดลใช้ VRAM น้อยลงและรันแบบโลคัลได้ง่ายขึ้น Hugging Face ระบุว่าการควอนไทซ์ 8 บิตสามารถลดการใช้หน่วยความจำได้ราวครึ่งหนึ่ง ขณะที่ 4 บิตจะลดได้มากยิ่งขึ้น
ข้อแลกเปลี่ยนคือความแม่นยำที่ต่ำลงอาจทำให้คุณภาพผลลัพธ์ลดลงได้ โดยเฉพาะหากโมเดลไม่ได้ถูกปรับให้เหมาะกับการควอนไทซ์ พูดง่าย ๆ คือ BF16 และ FP16 โดยมากให้คุณภาพดีที่สุดแต่ใช้หน่วยความจำมาก โมเดล 8 บิตมีขนาดเล็กลงพร้อมรักษาคุณภาพได้ดี ส่วนโมเดล 4 บิตมีขนาดเล็กกว่ามากแต่อาจสูญเสียความแม่นยำหรือความเสถียรบางส่วน
สำหรับการอนุมานแบบโลคัล ข้อแลกเปลี่ยนนี้มักคุ้มค่าเพราะช่วยให้รันโมเดลที่ใหญ่ขึ้นบน GPU สำหรับผู้ใช้ทั่วไปได้ แทนที่จะต้องใช้ฮาร์ดแวร์ดาต้าเซ็นเตอร์ที่มีราคาแพง
Quantization Aware Training คืออะไร?
Quantization-Aware Training (QAT) คือเทคนิคการฝึกที่ทำให้โมเดลถูกฝึกหรือปรับจูนโดยจำลองพฤติกรรมความแม่นยำต่ำระหว่างการฝึก ช่วยให้โมเดลคงความเสถียรหลังการควอนไทซ์ และสามารถปรับปรุงประสิทธิภาพการอนุมานแบบโลคัลที่ระดับบิตต่ำได้
QAT แตกต่างอย่างไร?
แนวทางทั่วไปอย่างการควอนไทซ์หลังการฝึก (post-training quantization) จะบีบอัดโมเดลหลังจากฝึกเสร็จแล้ว วิธีนี้เรียบง่ายและใช้งานจริงได้ แต่โมเดลอาจสูญเสียคุณภาพบางส่วนเพราะไม่ได้ถูกฝึกให้รับมือกับเวทความแม่นยำต่ำ
ตามเอกสารของ Google AI Edge การควอนไทซ์หลังการฝึกเป็นขั้นตอนการแปลงที่ช่วยลดขนาดโมเดลและปรับปรุงเวลาแฝง โดยปกติสูญเสียความแม่นยำเพียงเล็กน้อย อย่างไรก็ตาม คุณภาพสุดท้ายยังขึ้นอยู่กับตัวโมเดลและระดับการควอนไทซ์
Quantization-Aware Training หรือ QAT ใช้แนวทางที่ต่างออกไป แทนที่จะควอนไทซ์หลังการฝึกเพียงอย่างเดียว QAT จะจำลองพฤติกรรมความแม่นยำต่ำระหว่างการฝึกหรือการปรับจูน ช่วยให้โมเดลเรียนรู้การรักษาความเสถียรเมื่อถูกแปลงเป็นฟอร์แมตที่เล็กลงในภายหลัง และลดการสูญเสียคุณภาพเมื่อบีบอัดโมเดล
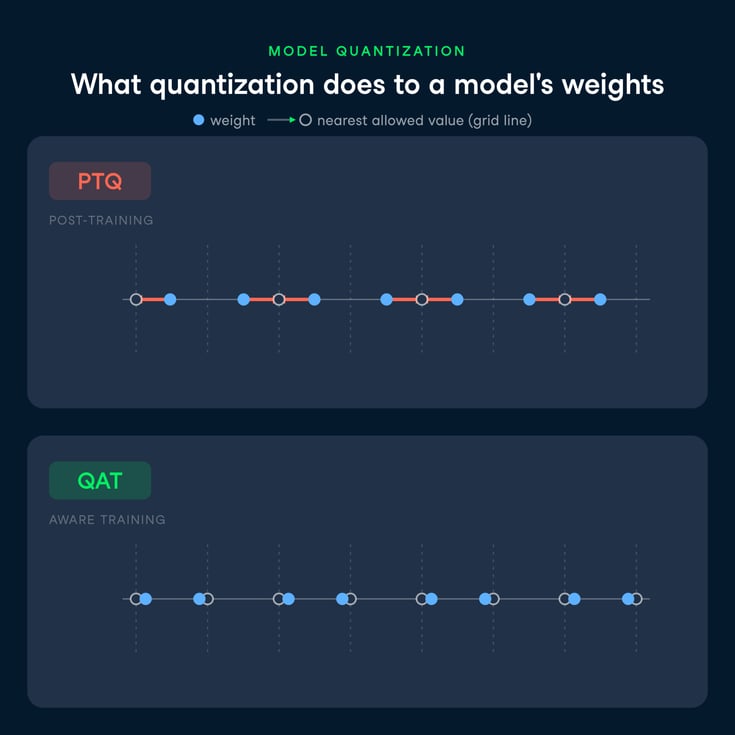
นี่จึงเป็นเหตุผลที่ Gemma 4 QAT มีประโยชน์สำหรับ AI แบบโลคัล มันถูกสร้างโดยคำนึงถึงการควอนไทซ์ จึงรักษาคุณภาพของโมเดลต้นฉบับได้มากขึ้นขณะใช้หน่วยความจำน้อยลง สำหรับผู้ใช้ที่รันโมเดลบน GPU สำหรับผู้ใช้ทั่วไป นั่นอาจหมายถึงความเสถียรที่ระดับบิตต่ำดีขึ้น ใช้ VRAM น้อยลง และการอนุมานแบบโลคัลที่ใช้งานได้จริงมากขึ้น
ขั้นตอนที่ 1: ติดตั้งไลบรารีที่ต้องใช้และบิลด์ llama.cpp
ก่อนจะดาวน์โหลดโมเดล เราต้องเตรียมสภาพแวดล้อมโลคัลก่อน บทช่วยสอนนี้ทดสอบบนเครื่องที่มี GPU NVIDIA RTX 4090 และ VRAM 24 GB เราจะใช้ llama.cpp เป็นรันไทม์สำหรับอนุมาน ใช้ GGUF เป็นฟอร์แมตของโมเดล และไฟล์โมเดลควอนไทซ์ UD-Q4_K_XL
สภาพแวดล้อมที่ทดสอบ:
- GPU: NVIDIA RTX 4090
- VRAM: 24 GB
- รันไทม์: llama.cpp
- ฟอร์แมตโมเดล: GGUF
- การควอนไทซ์: UD-Q4_K_XL
เราจะเปรียบเทียบโมเดล Unsloth GGUF ต่อไปนี้สองตัว:
- unsloth/gemma-4-12B-it-GGUF
- unsloth/gemma-4-12B-it-qat-GGUF
ก่อนอื่น ตรวจสอบว่า GPU พร้อมใช้งาน
nvidia-smi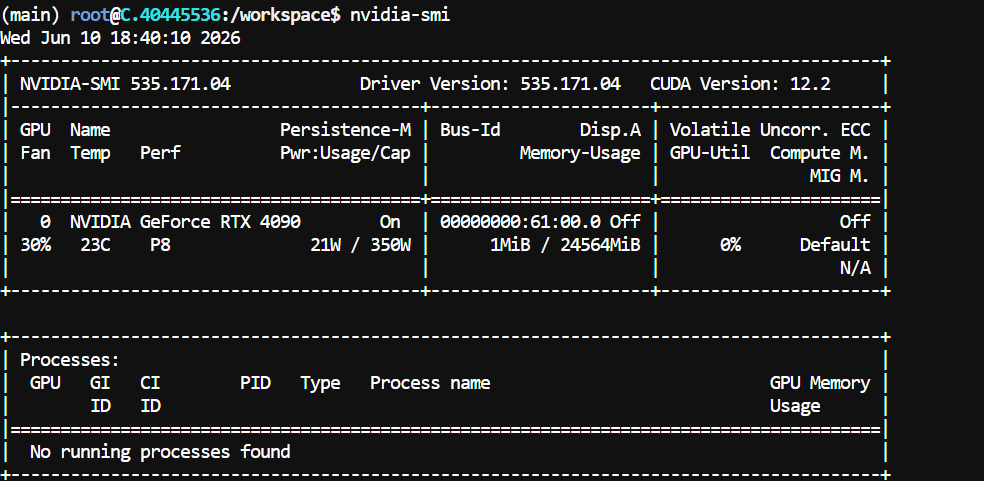
ถัดไป ติดตั้งแพ็กเกจระบบที่จำเป็นสำหรับการบิลด์ llama.cpp
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -yโคลนรีโพสิทอรี llama.cpp อย่างเป็นทางการ
git clone https://github.com/ggml-org/llama.cppตอนนี้บิลด์ llama.cpp โดยเปิดใช้งานการรองรับ CUDA วิธีนี้ช่วยให้เลเยอร์ของโมเดลรันบน GPU แทนที่จะเป็นแค่ CPU
cmake llama.cpp -B llama.cpp/build \
-DBUILD_SHARED_LIBS=OFF \
-DGGML_CUDA=ONคอมไพล์ไบนารีที่ต้องใช้
cmake --build llama.cpp/build \
--config Release \
-j \
--clean-first \
--target llama-cli llama-mtmd-cli llama-server llama-gguf-split
หลังบิลด์เสร็จ ไบนารีหลักที่เราจะใช้คือ llama-server ซึ่งช่วยให้เรารันโมเดล GGUF แบบโลคัลและเปิดเผยปลายทาง API ที่เข้ากันได้กับ OpenAI ให้เรียกด้วย curl ได้
ขั้นตอนที่ 2: ดาวน์โหลดโมเดล Gemma 4 12B แบบ Non-QAT และ QAT
เมื่อ llama.cpp พร้อมแล้ว เราสามารถดาวน์โหลดโมเดล Gemma 4 12B ทั้งสองเวอร์ชันจาก Hugging Face จะดาวน์โหลดทั้งโมเดลที่ปรับสำหรับงานคำสั่งทั่วไป (instruction-tuned) และเวอร์ชัน QAT ในฟอร์แมต GGUF
ก่อนอื่น ติดตั้ง Hugging Face Hub CLI พร้อมรองรับการดาวน์โหลดที่เร็วขึ้น
pip install -U "huggingface_hub[hf_xet]" hf-xet hf_transferเปิดใช้งานการดาวน์โหลด Xet ประสิทธิภาพสูง
export HF_XET_HIGH_PERFORMANCE=1ดาวน์โหลดโมเดล Gemma 4 12B แบบ instruction ในฟอร์แมต GGUF
hf download unsloth/gemma-4-12B-it-GGUF \
--local-dir models/gemma-4-12B-it-GGUF \
--include "*mmproj-BF16*" \
--include "*UD-Q4_K_XL*"จากนั้นดาวน์โหลดเวอร์ชัน QAT โดยใช้ฟอร์แมตการควอนไทซ์เดียวกัน
hf download unsloth/gemma-4-12B-it-qat-GGUF \
--local-dir models/gemma-4-12B-it-qat-GGUF \
--include "*mmproj-BF16*" \
--include "*UD-Q4_K_XL*"แฟล็ก --include ทำให้เราดาวน์โหลดเฉพาะไฟล์ที่ต้องใช้ในบทช่วยสอนนี้ แทนที่จะดึงทั้งรีโพสิทอรี ที่นี่เราดาวน์โหลดไฟล์โมเดล GGUF แบบ UD-Q4_K_XL และไฟล์ mmproj-BF16 ที่แพ็กเกจโมเดลใช้
หลังดาวน์โหลดเสร็จ ยืนยันว่ามีทั้งสองโฟลเดอร์ของโมเดล
ls modelsผลลัพธ์ที่คาดหวัง:
gemma-4-12B-it-GGUF
gemma-4-12B-it-qat-GGUFถึงตอนนี้ โมเดลทั้งแบบ non-QAT และ QAT พร้อมใช้งานแบบโลคัลแล้ว และเราสามารถเริ่มให้บริการด้วย llama-server ได้
ขั้นตอนที่ 3: รันโมเดล Non-QAT ด้วย llama-server
เริ่มจากรันโมเดล Gemma 4 12B แบบ instruction ปกติก่อน เพื่อเป็นค่าพื้นฐานไว้เปรียบเทียบกับเวอร์ชัน QAT โดยใช้การตั้งค่าเดียวกันภายหลัง
สตาร์ทโมเดล non-QAT ด้วย llama-server
./llama.cpp/llama-server \
-m models/gemma-4-12B-it-GGUF/*UD-Q4_K_XL*.gguf \
--host 0.0.0.0 \
--port 8001 \
--ctx-size 8192 \
--n-gpu-layers 99 \
--temp 1.0 \
--top-p 0.95 \
--top-k 64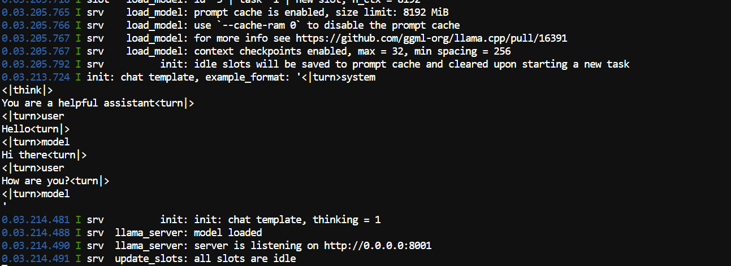
คำสั่งนี้จะเริ่มเซิร์ฟเวอร์แบบโลคัลที่เข้ากันได้กับ OpenAI ที่ http://localhost:8001
เปิดเทอร์มินัลอีกหน้าต่างและส่งคำขอไปยังเซิร์ฟเวอร์โลคัล
time curl http://localhost:8001/v1/chat/completions \
-H "Content-Type: application/json" \
-d '{
"model": "gemma-4-12B-it",
"messages": [
{
"role": "system",
"content": "You are a helpful local AI assistant."
},
{
"role": "user",
"content": "Explain why quantization-aware training is useful for running LLMs on consumer GPUs."
}
],
"temperature": 1.0,
"top_p": 0.95,
"max_tokens": 512
}'ในคำสั่งนี้ เราใช้ปลายทางโลคัล /v1/chat/completions ซึ่งเป็นรูปแบบ API ที่เข้ากันได้กับ OpenAI พรอมต์ขอให้โมเดลอธิบาย quantization-aware training และตั้งค่า max_tokens เป็น 512 เพื่อให้ทดสอบทั้งสองเวอร์ชันของโมเดลด้วยความยาวผลลัพธ์เท่ากัน
ในการทดสอบด้วย RTX 4090 ของเรา โมเดล non-QAT ให้ผลเวลาต่อไปนี้:
- โทเคนของพรอมต์: 40
- โทเคนของคำตอบ: 512
- ความเร็วในการป้อนพรอมต์: 510.22 โทเคน/วินาที
- ความเร็วในการสร้างคำตอบ: 94.65 โทเคน/วินาที
- เวลารวม: 5.516 วินาที
การใช้หน่วยความจำของ GPU:
9247 MiB / 24564 MiB
ค่านี้เป็นค่าพื้นฐานสำหรับประสิทธิภาพของโมเดล Gemma 4 12B ปกติ ขั้นตอนถัดไป เราจะรันเวอร์ชัน QAT ด้วยคอนฟิกเดียวกันและเปรียบเทียบผลลัพธ์
ขั้นตอนที่ 4: รันและทดสอบโมเดล QAT
ตอนนี้เราจะรัน Gemma 4 12B เวอร์ชัน QAT ด้วยการตั้งค่า llama-server เดียวกัน อย่าลืมหยุดเซิร์ฟเวอร์ non-QAT ก่อน เพราะทั้งสองคำสั่งใช้พอร์ตเดียวกัน
สตาร์ทโมเดล QAT
./llama.cpp/llama-server \
-m models/gemma-4-12B-it-qat-GGUF/*UD-Q4_K_XL*.gguf \
--host 0.0.0.0 \
--port 8001 \
--ctx-size 8192 \
--n-gpu-layers 99 \
--temp 1.0 \
--top-p 0.95 \
--top-k 64คำสั่งนี้จะเริ่มโมเดล QAT บนปลายทางที่เข้ากันได้กับ OpenAI แบบโลคัลเดียวกันที่ http://localhost:8001
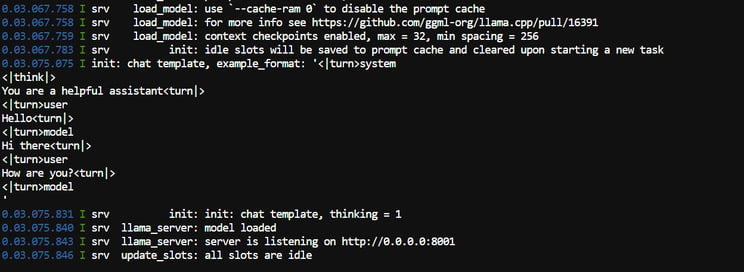
ตอนนี้ส่งพรอมต์ทดสอบเดียวกันไปยังโมเดล QAT
time curl http://localhost:8001/v1/chat/completions \
-H "Content-Type: application/json" \
-d '{
"model": "gemma-4-12B-it-qat",
"messages": [
{
"role": "system",
"content": "You are a helpful local AI assistant."
},
{
"role": "user",
"content": "Explain why quantization-aware training is useful for running LLMs on consumer GPUs."
}
],
"temperature": 1.0,
"top_p": 0.95,
"max_tokens": 512
}'ในการทดสอบด้วย RTX 4090 ของเรา โมเดล QAT ให้ผลเวลาต่อไปนี้:
- โทเคนของพรอมต์: 40
- โทเคนของคำตอบ: 512
- ความเร็วในการป้อนพรอมต์: 593.93 โทเคน/วินาที
- ความเร็วในการสร้างคำตอบ: 101.65 โทเคน/วินาที
- เวลารวม: 5.114 วินาที
การใช้หน่วยความจำของ GPU:
8627 MiB / 24564 MiB
ยังสามารถคัดลอก URL เซิร์ฟเวอร์โลคัล (http://localhost:8001) ไปวางในเบราว์เซอร์ได้ด้วย
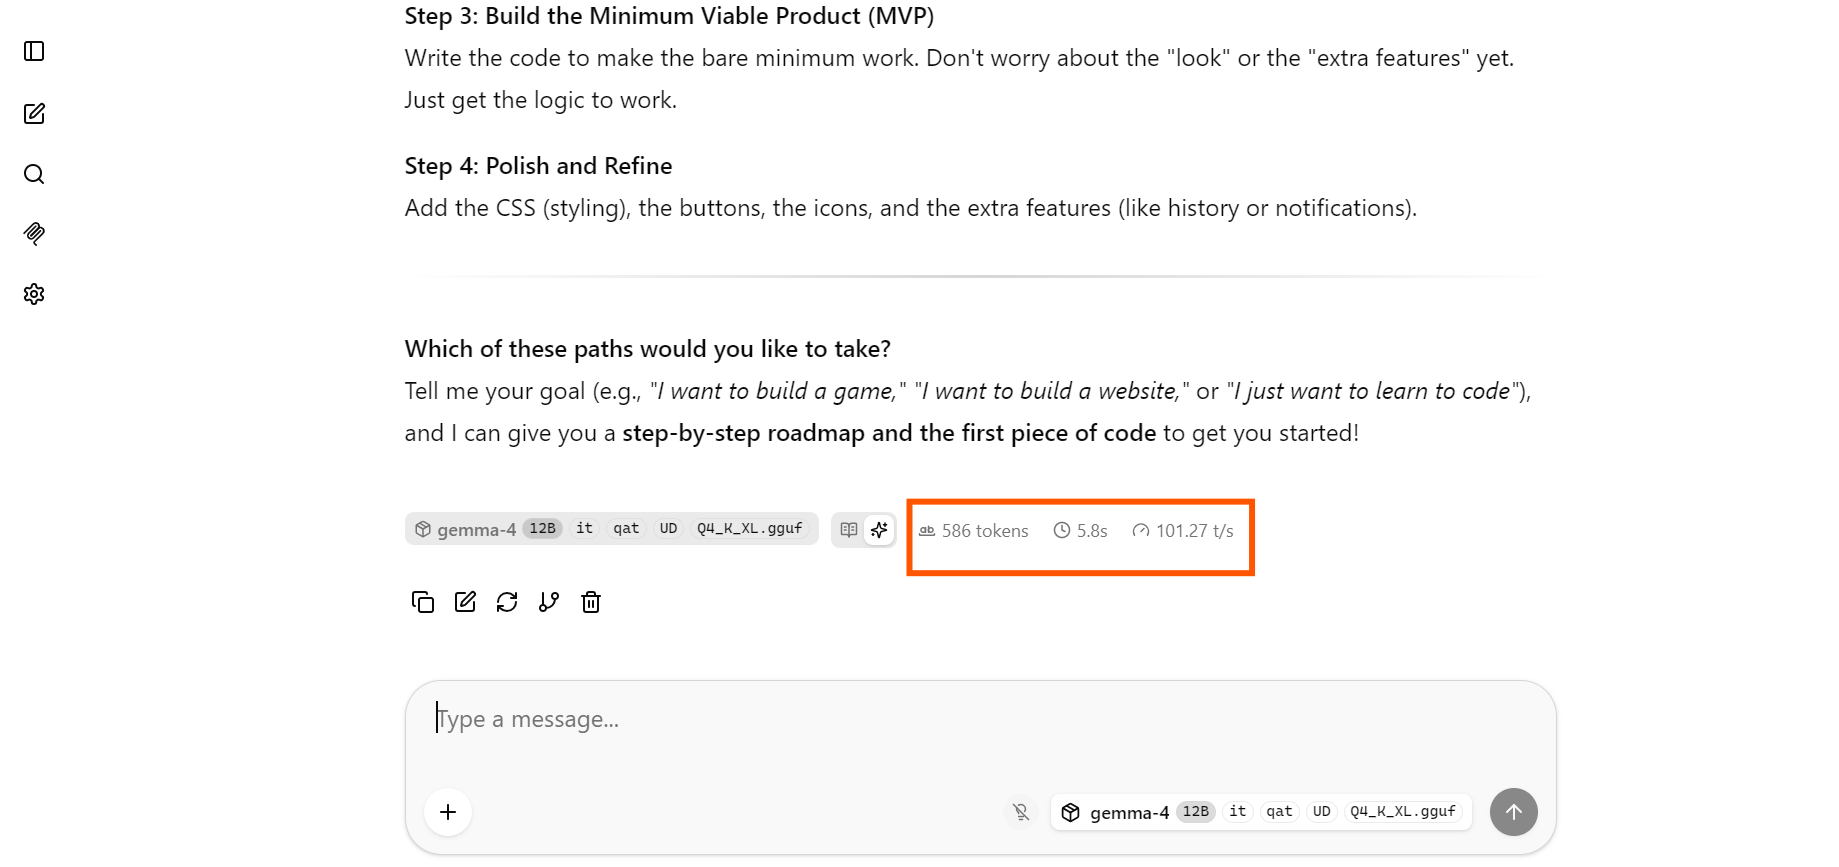
จะเปิดเว็บ UI ของ llama.cpp ที่ฝังมาให้ ให้ส่วนต่อประสานคล้าย ChatGPT สำหรับทดสอบโมเดลโลคัล สามารถใช้แชทกับโมเดล QAT ได้โดยตรงในเบราว์เซอร์ ทดลองพรอมต์ต่าง ๆ และใช้โมเดลเป็นผู้ช่วย AI แบบโลคัลในชีวิตประจำวันได้
เปรียบเทียบผล QAT กับ Non-QAT
หลังทดสอบทั้งสองโมเดลด้วยพรอมต์และการตั้งค่าเซิร์ฟเวอร์เดียวกัน เราสามารถเปรียบเทียบประสิทธิภาพบน RTX 4090 ได้โดยตรง
|
ตัวชี้วัด |
Gemma 4 12B Non-QAT |
Gemma 4 12B QAT |
|
การควอนไทซ์ |
UD-Q4_K_XL |
UD-Q4_K_XL |
|
ขนาดบริบท |
8192 |
8192 |
|
โทเคนของพรอมต์ |
40 |
40 |
|
โทเคนของคำตอบ |
512 |
512 |
|
ความเร็วในการป้อนพรอมต์ |
510.22 โทเคน/วินาที |
593.93 โทเคน/วินาที |
|
ความเร็วในการสร้างคำตอบ |
94.65 โทเคน/วินาที |
101.65 โทเคน/วินาที |
|
เวลารวม |
5.516 วินาที |
5.114 วินาที |
|
การใช้ VRAM |
9247 MiB |
8627 MiB |
ในการรันครั้งนี้ โมเดล QAT ทั้งเร็วกว่าและเบากว่าโมเดล non-QAT ปกติ โดยใช้ VRAM น้อยลง 620 MiB ลดการใช้หน่วยความจำลงประมาณ 6.7% ซึ่งเป็นประโยชน์ต่อการอนุมานแบบโลคัล เพราะการประหยัด VRAM ทุกส่วนช่วยได้มากเมื่อรันโมเดลขนาดใหญ่บน GPU สำหรับผู้ใช้ทั่วไป
โมเดล QAT ยังสร้างโทเคนได้เร็วขึ้น จาก 94.65 โทเคน/วินาที เป็น 101.65 โทเคน/วินาที เพิ่มขึ้นราว 7.4% ทำให้เวลาจริงลดจาก 5.516 วินาที เหลือ 5.114 วินาที
สำหรับการใช้งานทุกวัน โมเดล QAT ให้ความลื่นไหลและตอบสนองได้ดีกว่า คุณภาพคำตอบก็ดูเสถียรกว่าในการทดสอบนี้ ซึ่งเป็นเหตุผลหลักที่ QAT มีประโยชน์: มันช่วยให้โมเดลรับมือกับการควอนไทซ์ระดับบิตต่ำได้ โดยสูญเสียคุณภาพน้อยลง ขณะยังคงได้ประโยชน์ด้านหน่วยความจำและความเร็วของโมเดลที่ถูกบีบอัด
บทส่งท้าย
Google กำลังทำงานอันยอดเยี่ยมเพื่อชุมชน AI แบบโลคัล ด้วยโมเดลอย่าง Gemma 4 และเทคนิคอย่าง QAT ความฝันในการรันโมเดล AI ทรงพลังแบบโลคัล ออฟไลน์ทั้งหมด และแม้แต่บนฮาร์ดแวร์สำหรับผู้ใช้ทั่วไป กำลังกลายเป็นจริง
ที่น่าตื่นเต้นที่สุดคือมันไม่ได้เป็นเพียงการลดขนาดโมเดล ด้วย QAT เราไม่ได้ยอมทิ้งคุณภาพแค่เพื่อให้โมเดลพอดี แต่เราได้โมเดลที่ออกแบบมาให้รันได้ดีกว่าในฟอร์แมตบิตต่ำ ช่วยยกระดับประสบการณ์ AI แบบโลคัล โดยในการทดสอบนี้ โมเดล QAT เร็วกว่า เบากว่า และใช้งานลื่นไหลกว่าเวอร์ชัน non-QAT
ตอนนี้ฉันตั้งตารอที่จะทดสอบเวอร์ชัน MTP ของโมเดล ซึ่งอาจเพิ่มความเร็วได้อีก อาจถึง 2 เท่า นั่นจะทำให้ง่ายขึ้นมากในการย้ายเวิร์กโฟลว์ส่วนใหญ่ไปยัง AI แบบโลคัล ฉันสามารถรันโมเดลแบบโลคัล เชื่อมต่อกับเครื่องมืออย่าง OpenCode และเริ่มแก้ไขไฟล์โปรเจกต์โดยตรงด้วยผู้ช่วยส่วนตัวแบบโลคัลส่วนตัว
คลื่นลูกใหม่ของ AI แบบโลคัลกำลังเปลี่ยนวิธีคิดเกี่ยวกับการใช้งานระบบ AI งานที่ครั้งหนึ่งเคยต้องพึ่งพาการตั้งค่าบนคลาวด์ขนาดใหญ่ โดยเฉพาะเวิร์กโฟลว์แบบมัลติโหมดที่รับทั้งข้อความ รูปภาพ และวิดีโอ กำลังค่อย ๆ เป็นไปได้บนเครื่องโลคัล สำหรับนักพัฒนา นักวิจัย และผู้สร้างที่ให้ความสำคัญกับความเป็นส่วนตัว ความเร็ว และการควบคุม นี่คือทิศทางที่น่าตื่นเต้นมาก
การควอนไทซ์เป็นหนึ่งในวิธีที่ใช้งานได้จริงที่สุดในการรันโมเดลภาษาขนาดใหญ่บน GPU สำหรับผู้ใช้ทั่วไป แทนที่จะใช้เวทที่มีความแม่นยำสูงซึ่งกิน VRAM มาก เราสามารถใช้โมเดลแบบบีบอัด 4 บิตที่พอดีกับ GPU อย่าง NVIDIA RTX 4090 โมเดล Gemma ของ Google ก็เป็นส่วนหนึ่งของกระแสที่กำลังเติบโตนี้ เพื่อทำให้ AI แบบเปิดทรงพลังรันแบบโลคัลได้ง่ายขึ้น
ในบทช่วยสอนนี้ เราจะรัน Gemma 4 12B loคัลด้วย llama.cpp และเปรียบเทียบเวอร์ชันฐานของโมเดลกับอีกเวอร์ชันที่ปรับจูนด้วย Quantization-Aware Training (QAT)
อย่าลืมอ่านบทช่วยสอนอื่น ๆ เกี่ยวกับโมเดลของ Google ด้วย ได้แก่ สร้างเอเจนต์ AI ด้วย Gemma 4 และ Ollama และ วิธี Fine-Tune Gemma 4