机器学习是数据科学中最实用的技能之一。借助机器学习,数据从业者能够对关键数据集进行预测、自动化工作流,并提取洞察。机器学习的工作流是什么样的?下方信息图展示了机器学习工作流的简化视图。
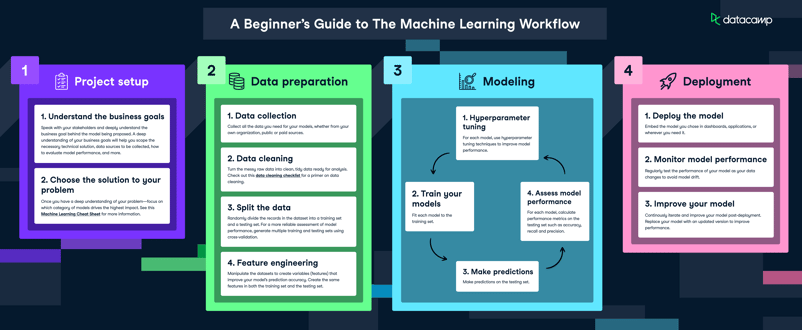
点击图片下载此信息图
项目设置
理解业务目标
与相关方沟通,深入理解所提议模型背后的业务目标。对业务目标的深刻理解将有助于您界定所需的技术解决方案、需要收集的数据来源、如何评估模型表现等。
选择问题的解决方案
在深入理解您的问题之后——聚焦于能产生最大影响的模型类别。更多信息请参阅这份机器学习速查表。
数据准备
数据收集
收集模型所需的全部数据,来源可以是您所在组织、公共渠道或付费渠道。
数据清洗
将凌乱的原始数据整理为可用于分析的干净、整洁数据。可参考这份数据清洗核对清单,快速入门数据清洗。
特征工程
对数据集进行处理,创建能提升模型预测准确性的变量(特征)。在训练集和测试集中创建相同的特征。
拆分数据
将数据集中的记录随机划分为训练集和测试集。为更可靠地评估模型表现,可使用交叉验证生成多组训练集与测试集。
建模
超参数调优
针对每个模型,使用超参数调优技术来提升模型表现。
训练模型
将每个模型拟合到训练集。
进行预测
在测试集上进行预测。
评估模型表现
对每个模型,在测试集上计算准确率、召回率与精确率等性能指标。
部署
部署模型
将选定的模型嵌入到仪表板、应用程序或其他需要的地方。
监控模型表现
随着数据变化,定期测试模型表现,避免模型漂移。
改进模型
在部署后持续迭代并改进模型。用更新版本替换现有模型以提升表现。

机器学习是数据科学中最实用的技能之一。借助机器学习,数据从业者能够对关键数据集进行预测、自动化工作流,并提取洞察。机器学习的工作流是什么样的?下方信息图展示了机器学习工作流的简化视图。
点击图片下载此信息图
项目设置
理解业务目标
与相关方沟通,深入理解所提议模型背后的业务目标。对业务目标的深刻理解将有助于您界定所需的技术解决方案、需要收集的数据来源、如何评估模型表现等。
选择问题的解决方案
在深入理解您的问题之后——聚焦于能产生最大影响的模型类别。更多信息请参阅这份机器学习速查表。
数据准备
数据收集
收集模型所需的全部数据,来源可以是您所在组织、公共渠道或付费渠道。
数据清洗
将凌乱的原始数据整理为可用于分析的干净、整洁数据。可参考这份数据清洗核对清单,快速入门数据清洗。
特征工程
对数据集进行处理,创建能提升模型预测准确性的变量(特征)。在训练集和测试集中创建相同的特征。
拆分数据
将数据集中的记录随机划分为训练集和测试集。为更可靠地评估模型表现,可使用交叉验证生成多组训练集与测试集。
建模
超参数调优
针对每个模型,使用超参数调优技术来提升模型表现。
训练模型
将每个模型拟合到训练集。
进行预测
在测试集上进行预测。
评估模型表现
对每个模型,在测试集上计算准确率、召回率与精确率等性能指标。
部署
部署模型
将选定的模型嵌入到仪表板、应用程序或其他需要的地方。
监控模型表现
随着数据变化,定期测试模型表现,避免模型漂移。
改进模型
在部署后持续迭代并改进模型。用更新版本替换现有模型以提升表现。