El aprendizaje automático es una de las habilidades más útiles en la ciencia de datos. Con el aprendizaje automático, los profesionales de los datos pueden hacer predicciones sobre conjuntos de datos clave, automatizar flujos de trabajo y extraer información. ¿Cómo es el flujo de trabajo del aprendizaje automático? Esta infografía presenta una visión simplificada del flujo de trabajo del aprendizaje automático.
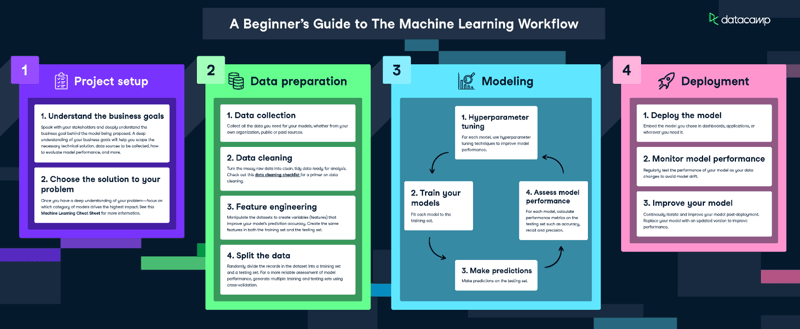
Descarga esta infografía pulsando sobre la imagen
Configuración del proyecto
Comprender los objetivos empresariales
Habla con tus interlocutores y comprende en profundidad el objetivo empresarial que hay detrás del modelo que se propone. Un conocimiento profundo de tus objetivos empresariales te ayudará a determinar el alcance de la solución técnica necesaria, las fuentes de datos que deben recopilarse, cómo evaluar el rendimiento del modelo y mucho más.
Elige la solución a tu problema
Una vez que tengas un conocimiento profundo de tu problema, céntrate en qué categoría de modelos genera el mayor impacto. Ver esto Hoja de trucos sobre aprendizaje automático para más información.
Preparación de datos
Recogida de datos
Recopila todos los datos que necesites para tus modelos, ya sea de tu propia organización, de fuentes públicas o de pago.
Limpieza de datos
Convierte los desordenados datos brutos en datos limpios y ordenados, listos para el análisis. Consulta esta lista de comprobación para la limpieza de datos para una introducción a la limpieza de datos.
Ingeniería de funciones
Manipula los conjuntos de datos para crear variables (características) que mejoren la precisión de predicción de tu modelo. Crea las mismas características en el conjunto de entrenamiento y en el conjunto de prueba.
Divide los datos
Divide aleatoriamente los registros del conjunto de datos en un conjunto de entrenamiento y un conjunto de prueba. Para una evaluación más fiable del rendimiento del modelo, genera múltiples conjuntos de entrenamiento y prueba utilizando la validación cruzada
Modelado
Ajuste de hiperparámetros
Para cada modelo, utiliza técnicas de ajuste de hiperparámetros para mejorar el rendimiento del modelo.
Entrena tus modelos
Ajusta cada modelo al conjunto de entrenamiento.
Haz predicciones
Haz predicciones sobre el conjunto de pruebas.
Evaluar el rendimiento del modelo
Para cada modelo, calcula las métricas de rendimiento en el conjunto de pruebas, como la exactitud, la recuperación y la precisión.
Despliegue
Despliega el modelo
Incrusta el modelo que hayas elegido en cuadros de mando, aplicaciones o donde lo necesites.
Supervisar el rendimiento del modelo
Prueba regularmente el rendimiento de tu modelo a medida que cambian tus datos para evitar la deriva del modelo
Mejora tu modelo
Repite y mejora continuamente tu modelo tras la implantación. Sustituye tu modelo por una versión actualizada para mejorar el rendimiento.


 Zoumana Keita · 14 min

 Moez Ali · 8 min
 Abid Ali Awan · 10 min



El aprendizaje automático es una de las habilidades más útiles en la ciencia de datos. Con el aprendizaje automático, los profesionales de los datos pueden hacer predicciones sobre conjuntos de datos clave, automatizar flujos de trabajo y extraer información. ¿Cómo es el flujo de trabajo del aprendizaje automático? Esta infografía presenta una visión simplificada del flujo de trabajo del aprendizaje automático.
Descarga esta infografía pulsando sobre la imagen
Configuración del proyecto
Comprender los objetivos empresariales
Habla con tus interlocutores y comprende en profundidad el objetivo empresarial que hay detrás del modelo que se propone. Un conocimiento profundo de tus objetivos empresariales te ayudará a determinar el alcance de la solución técnica necesaria, las fuentes de datos que deben recopilarse, cómo evaluar el rendimiento del modelo y mucho más.
Elige la solución a tu problema
Una vez que tengas un conocimiento profundo de tu problema, céntrate en qué categoría de modelos genera el mayor impacto. Ver esto Hoja de trucos sobre aprendizaje automático para más información.
Preparación de datos
Recogida de datos
Recopila todos los datos que necesites para tus modelos, ya sea de tu propia organización, de fuentes públicas o de pago.
Limpieza de datos
Convierte los desordenados datos brutos en datos limpios y ordenados, listos para el análisis. Consulta esta lista de comprobación para la limpieza de datos para una introducción a la limpieza de datos.
Ingeniería de funciones
Manipula los conjuntos de datos para crear variables (características) que mejoren la precisión de predicción de tu modelo. Crea las mismas características en el conjunto de entrenamiento y en el conjunto de prueba.
Divide los datos
Divide aleatoriamente los registros del conjunto de datos en un conjunto de entrenamiento y un conjunto de prueba. Para una evaluación más fiable del rendimiento del modelo, genera múltiples conjuntos de entrenamiento y prueba utilizando la validación cruzada
Modelado
Ajuste de hiperparámetros
Para cada modelo, utiliza técnicas de ajuste de hiperparámetros para mejorar el rendimiento del modelo.
Entrena tus modelos
Ajusta cada modelo al conjunto de entrenamiento.
Haz predicciones
Haz predicciones sobre el conjunto de pruebas.
Evaluar el rendimiento del modelo
Para cada modelo, calcula las métricas de rendimiento en el conjunto de pruebas, como la exactitud, la recuperación y la precisión.
Despliegue
Despliega el modelo
Incrusta el modelo que hayas elegido en cuadros de mando, aplicaciones o donde lo necesites.
Supervisar el rendimiento del modelo
Prueba regularmente el rendimiento de tu modelo a medida que cambian tus datos para evitar la deriva del modelo
Mejora tu modelo
Repite y mejora continuamente tu modelo tras la implantación. Sustituye tu modelo por una versión actualizada para mejorar el rendimiento.