在过去几个月里,数据科学和人工智能领域因 GPT-3(OpenAI 最新的语言模型)的到来而热议不断。对许多人而言,该模型标志着单一算法在多种任务上以人类语言进行推理能力的一次重大飞跃。
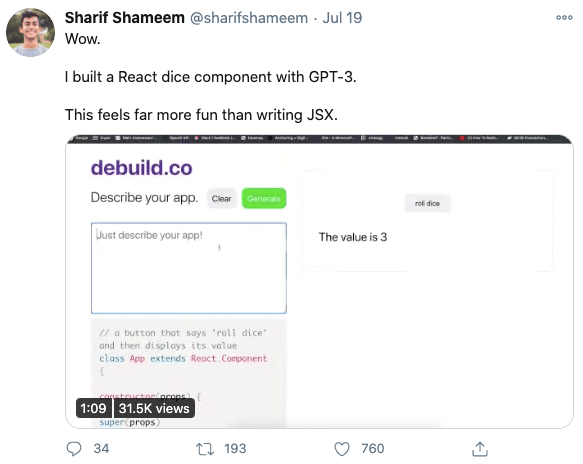
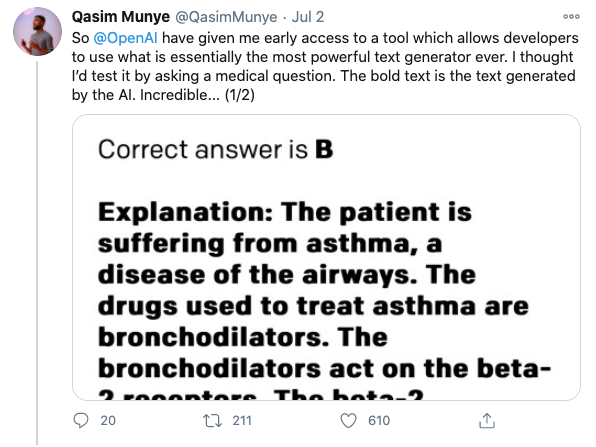
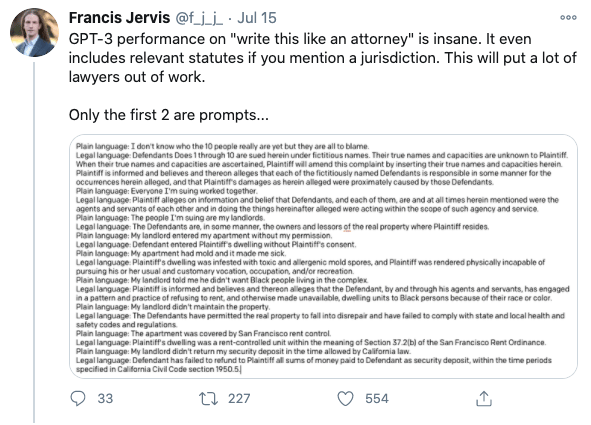
测试 GPT-3 的开发者给出了许多耐人寻味的用例。基于英文提示自动生成代码、回答医学问题、翻译法律语言等示例,点燃了众多数据科学家对下一代 AI 驱动软件的想象力。
尽管在组织层面,机器学习的许多价值体现在诸如预测流失、简单的销售预测、客户细分等“低垂果实”上——但从长远看,思考GPT-3 商业化意味着什么仍很有意义。它有潜力重塑我们对人工智能的认知和落地方式。
人工智能、机器学习与深度学习的定义
商业世界和媒体中充斥着人工智能(AI)、机器学习(ML)、深度学习(DL)等流行词。在深入探讨 GPT-3 的工作原理之前,先快速厘清这些术语。
Google Brain 联合创始人、前百度首席科学家 Andrew Ng 将人工智能描述为“一整套能让计算机表现出智能行为的庞大工具”。这既包括像计算器那样显式编程的软件,也包括推荐系统、自动驾驶汽车等 ML 应用。
人工智能与计算机博弈先驱 Arthur Samuel 将机器学习定义为“让计算机具备无需显式编程即可学习的能力的研究领域”。机器学习算法大致分为两类。第一类是监督学习,算法学习现有数据(输入)与标签(输出)之间的模式,并在未见过的数据上预测输出,例如基于历史流失数据预测新客户是否会流失。第二类是无监督学习,算法在数据中发现一般性模式,并将相似的数据点聚成一簇,例如基于共同的行为模式对客户进行分群。
深度学习是一种基于多层人工神经网络的机器学习形式,松散借鉴了大脑中的生物神经网络。它既可用于监督学习,也可用于无监督学习,并在过去十年中支撑了诸如图像识别、情感分析等高曝光的 ML 用例。深度学习模型的架构多种多样,取决于神经网络中层数与节点数的多少而从简单到复杂不等。模型越复杂,参数越多。若您想进一步了解深度学习模型如何构建,欢迎查看 DataCamp 的深度学习技能路径。
想更深入地探索这些主题,请阅读我们的电子书《企业领导者机器学习权威指南》。
GPT-3 的工作原理
那么,GPT-3 与人工智能、机器学习、深度学习的交集在哪里?缩写 GPT 指的是“生成式预训练 Transformer”——一种通常在大量未标注文本上进行预训练的无监督深度学习算法。它会在大规模、特定任务的标注数据集上进行微调与训练(例如英法翻译),随后在给定特定输入(英文单词)时,推断最可能的输出集合(法语翻译)。您可以将其视为适用于多种语言任务的高度复杂的自动补全。
GPT-3 是这一模型的第三次迭代。虽然其架构并未在前代基础上创新,但它在极其庞大的数据集上进行了预训练,覆盖了互联网的大量内容,包括 Common Crawl 数据集,并在网络架构中引入了更多层。这使得 GPT-3 成为迄今最复杂的语言模型,拥有 1750 亿个参数。这一规模是 GPT-3 发布前最复杂模型(微软的 Turing-NLG)的 10 倍,是 GPT-2 的 117 倍。
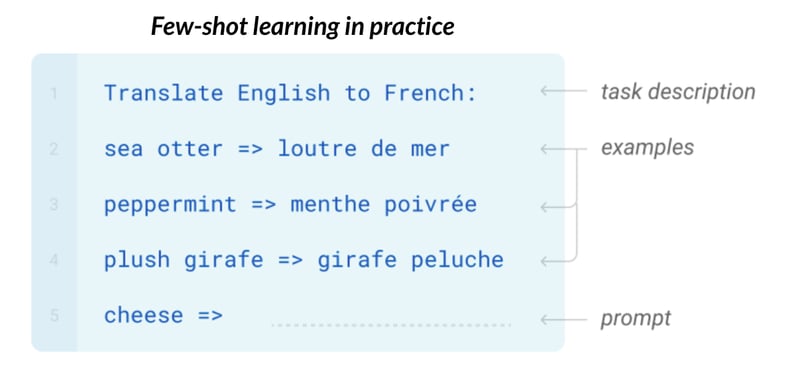
更重要的是,GPT-3 受益于小样本学习(few-shot learning):预训练模型无需为特定语言任务用大量标注数据进行微调,仅需提供任务描述——如“将英文翻译成法文”——以及少量输入-输出示例。再辅以易于使用的即插即用界面,GPT-3 在很大程度上降低了门槛,使非专家也能在不同的语言任务上产出有意义的结果。
GPT-3 的重要性
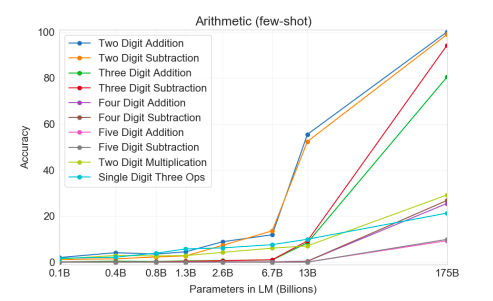
只需少量示例和任务描述,GPT-3 在多种语言任务上就能与那些在特定任务数据上经过精细微调的语言模型相媲美。GPT-3 还在某些需要推理的任务(如算术)上表现出一定成功,这些任务并不必然属于语言任务。例如,在提供了若干加减法示例后,GPT-3 在两位数加减法上达到了 100% 的准确率。参数更少、复杂度更低的模型在这些任务上的准确率一直难以突破 60% 的天花板。尽管 GPT-3 在更复杂的算术形式上会出现失误,但这暗示着更复杂的模型可能具备跨越训练领域进行泛化的能力。
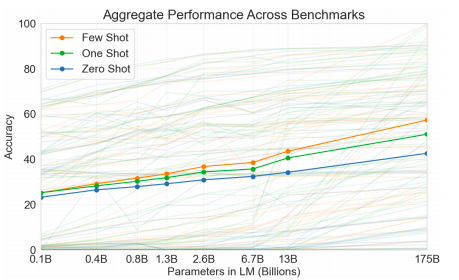
有趣的是,这表明仅通过扩大数据集与模型规模仍可获得进一步收益。目前看来,模型在不同任务上的整体表现并未在 1750 亿参数处出现平台期。假设从 GPT-2 到 GPT-3 的参数扩展趋势延续,不禁让人好奇:若 GPT-4 的参数量是 GPT-3 的 117 倍,性能会如何扩展。
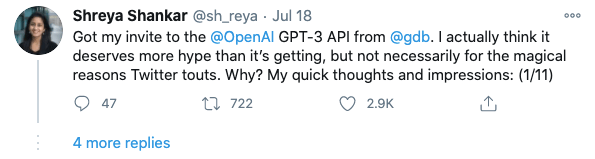
目前,GPT-3 正在私测阶段进行校准,但将其打包为即插即用的 API 意味着一旦走出私测,即可规模化使用。正如 AI 研究者 Shreya Shankar 所指出的,一个重要挑战将是如何高效、便捷地向组织提供这一 API 服务。
这对未来意味着什么
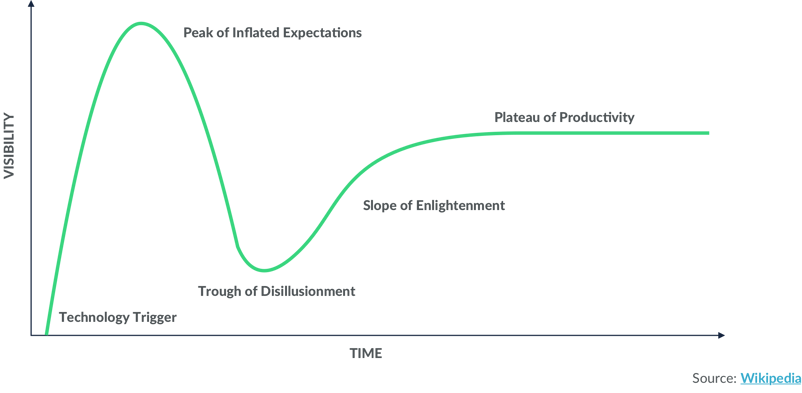
新技术往往会遵循 Gartner 的炒作周期——事实上,OpenAI CEO Sam Altman 已经对 GPT-3 的炒作敲响了警钟。
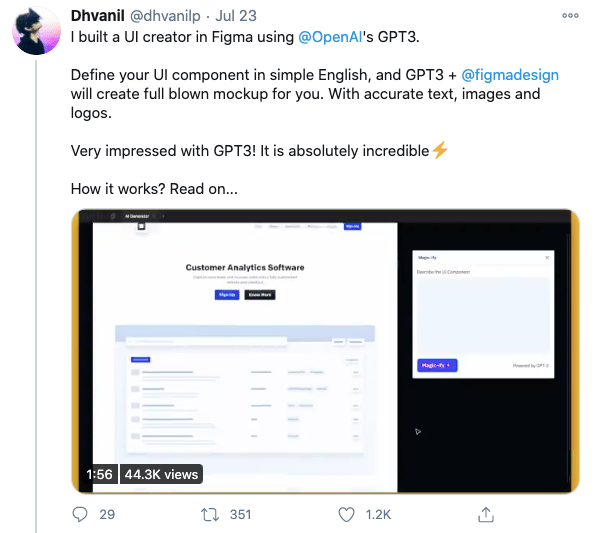
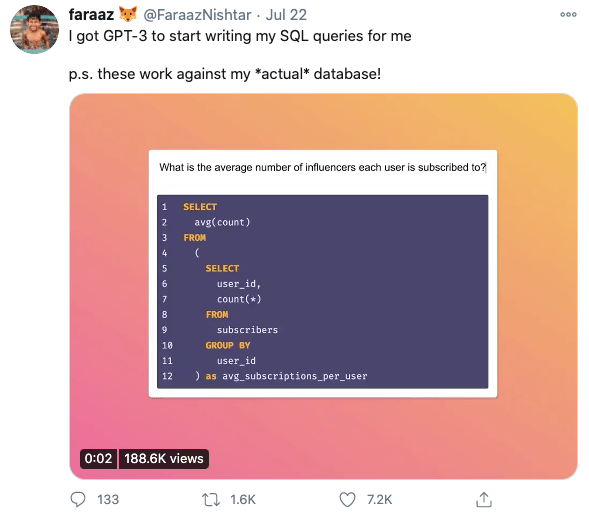
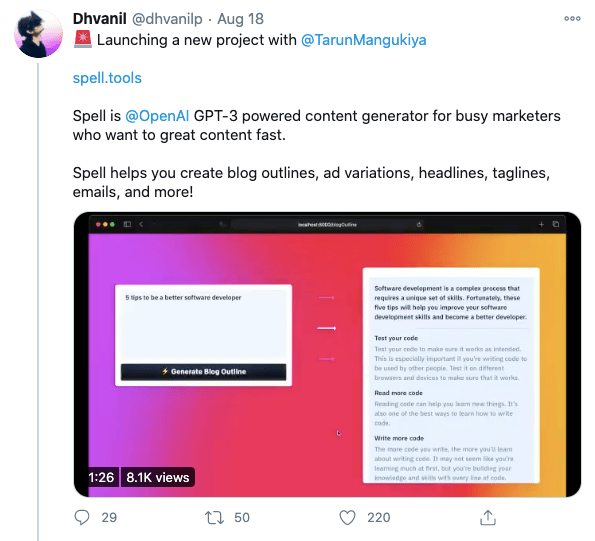
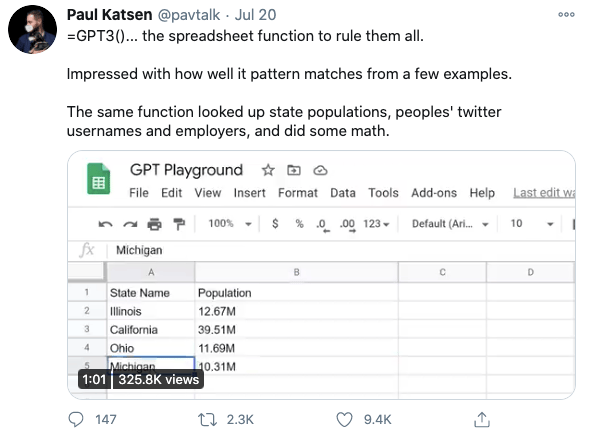
然而,来自 GPT-3 开发者的用例为我们揭示了中长期内可期的 AI 驱动应用类型。潜在应用包括:帮助设计师更轻松地制作原型、精简数据分析流程、支持更稳健的研究、为内容营销人员自动生成内容,等等。
此外,将模型封装为易用的即插即用界面,可能改变 AI 在组织内被工具化的方式。例如,这可能降低组织自研模型的意愿,并让技术背景较弱的专家也能基于 GPT-3 构建解决方案。
最后,在考虑大规模部署 AI 系统时,您必须意识到偏见所带来的潜在危害扩散能力。正如许多研究者在测试 GPT-3 时指出的,仅基于中性输入,就相对容易生成强化刻板印象与偏见的有害输出。
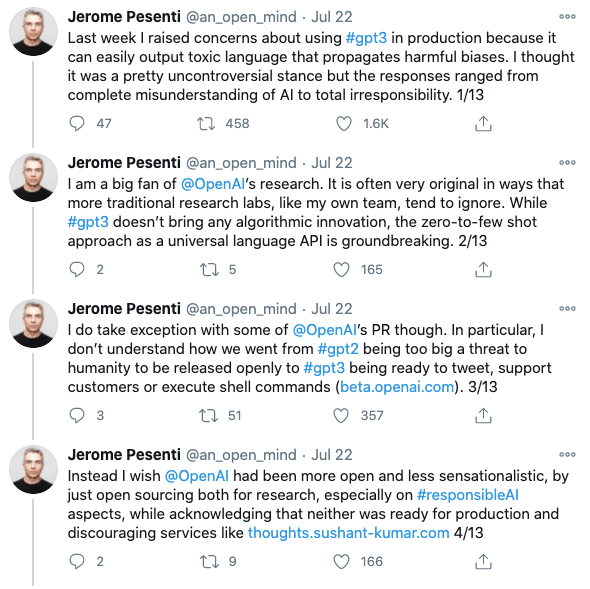
与任何大规模部署的机器学习算法一样,GPT-3 需要就潜在危害进行严谨的审视与监控。


在过去几个月里,数据科学和人工智能领域因 GPT-3(OpenAI 最新的语言模型)的到来而热议不断。对许多人而言,该模型标志着单一算法在多种任务上以人类语言进行推理能力的一次重大飞跃。
测试 GPT-3 的开发者给出了许多耐人寻味的用例。基于英文提示自动生成代码、回答医学问题、翻译法律语言等示例,点燃了众多数据科学家对下一代 AI 驱动软件的想象力。
尽管在组织层面,机器学习的许多价值体现在诸如预测流失、简单的销售预测、客户细分等“低垂果实”上——但从长远看,思考GPT-3 商业化意味着什么仍很有意义。它有潜力重塑我们对人工智能的认知和落地方式。
人工智能、机器学习与深度学习的定义
商业世界和媒体中充斥着人工智能(AI)、机器学习(ML)、深度学习(DL)等流行词。在深入探讨 GPT-3 的工作原理之前,先快速厘清这些术语。
Google Brain 联合创始人、前百度首席科学家 Andrew Ng 将人工智能描述为“一整套能让计算机表现出智能行为的庞大工具”。这既包括像计算器那样显式编程的软件,也包括推荐系统、自动驾驶汽车等 ML 应用。
人工智能与计算机博弈先驱 Arthur Samuel 将机器学习定义为“让计算机具备无需显式编程即可学习的能力的研究领域”。机器学习算法大致分为两类。第一类是监督学习,算法学习现有数据(输入)与标签(输出)之间的模式,并在未见过的数据上预测输出,例如基于历史流失数据预测新客户是否会流失。第二类是无监督学习,算法在数据中发现一般性模式,并将相似的数据点聚成一簇,例如基于共同的行为模式对客户进行分群。
深度学习是一种基于多层人工神经网络的机器学习形式,松散借鉴了大脑中的生物神经网络。它既可用于监督学习,也可用于无监督学习,并在过去十年中支撑了诸如图像识别、情感分析等高曝光的 ML 用例。深度学习模型的架构多种多样,取决于神经网络中层数与节点数的多少而从简单到复杂不等。模型越复杂,参数越多。若您想进一步了解深度学习模型如何构建,欢迎查看 DataCamp 的深度学习技能路径。
想更深入地探索这些主题,请阅读我们的电子书《企业领导者机器学习权威指南》。
GPT-3 的工作原理
那么,GPT-3 与人工智能、机器学习、深度学习的交集在哪里?缩写 GPT 指的是“生成式预训练 Transformer”——一种通常在大量未标注文本上进行预训练的无监督深度学习算法。它会在大规模、特定任务的标注数据集上进行微调与训练(例如英法翻译),随后在给定特定输入(英文单词)时,推断最可能的输出集合(法语翻译)。您可以将其视为适用于多种语言任务的高度复杂的自动补全。
GPT-3 是这一模型的第三次迭代。虽然其架构并未在前代基础上创新,但它在极其庞大的数据集上进行了预训练,覆盖了互联网的大量内容,包括 Common Crawl 数据集,并在网络架构中引入了更多层。这使得 GPT-3 成为迄今最复杂的语言模型,拥有 1750 亿个参数。这一规模是 GPT-3 发布前最复杂模型(微软的 Turing-NLG)的 10 倍,是 GPT-2 的 117 倍。
更重要的是,GPT-3 受益于小样本学习(few-shot learning):预训练模型无需为特定语言任务用大量标注数据进行微调,仅需提供任务描述——如“将英文翻译成法文”——以及少量输入-输出示例。再辅以易于使用的即插即用界面,GPT-3 在很大程度上降低了门槛,使非专家也能在不同的语言任务上产出有意义的结果。
GPT-3 的重要性
只需少量示例和任务描述,GPT-3 在多种语言任务上就能与那些在特定任务数据上经过精细微调的语言模型相媲美。GPT-3 还在某些需要推理的任务(如算术)上表现出一定成功,这些任务并不必然属于语言任务。例如,在提供了若干加减法示例后,GPT-3 在两位数加减法上达到了 100% 的准确率。参数更少、复杂度更低的模型在这些任务上的准确率一直难以突破 60% 的天花板。尽管 GPT-3 在更复杂的算术形式上会出现失误,但这暗示着更复杂的模型可能具备跨越训练领域进行泛化的能力。
有趣的是,这表明仅通过扩大数据集与模型规模仍可获得进一步收益。目前看来,模型在不同任务上的整体表现并未在 1750 亿参数处出现平台期。假设从 GPT-2 到 GPT-3 的参数扩展趋势延续,不禁让人好奇:若 GPT-4 的参数量是 GPT-3 的 117 倍,性能会如何扩展。
目前,GPT-3 正在私测阶段进行校准,但将其打包为即插即用的 API 意味着一旦走出私测,即可规模化使用。正如 AI 研究者 Shreya Shankar 所指出的,一个重要挑战将是如何高效、便捷地向组织提供这一 API 服务。
这对未来意味着什么
新技术往往会遵循 Gartner 的炒作周期——事实上,OpenAI CEO Sam Altman 已经对 GPT-3 的炒作敲响了警钟。
然而,来自 GPT-3 开发者的用例为我们揭示了中长期内可期的 AI 驱动应用类型。潜在应用包括:帮助设计师更轻松地制作原型、精简数据分析流程、支持更稳健的研究、为内容营销人员自动生成内容,等等。
此外,将模型封装为易用的即插即用界面,可能改变 AI 在组织内被工具化的方式。例如,这可能降低组织自研模型的意愿,并让技术背景较弱的专家也能基于 GPT-3 构建解决方案。
最后,在考虑大规模部署 AI 系统时,您必须意识到偏见所带来的潜在危害扩散能力。正如许多研究者在测试 GPT-3 时指出的,仅基于中性输入,就相对容易生成强化刻板印象与偏见的有害输出。
与任何大规模部署的机器学习算法一样,GPT-3 需要就潜在危害进行严谨的审视与监控。