

配置 Azure 应用服务
应用部署完成后,下一步是配置 Azure 应用服务的各个方面,确保其以最佳与安全的方式运行。本节将介绍自定义域、身份验证与应用设置。
配置自定义域
默认情况下,您的应用服务可通过 your-app-name.azurewebsites.net 访问。对于生产应用,您很可能希望使用自有域名。以下是设置自定义域的方法:
- 如未拥有域名,请先在域名注册商处购买
- 在应用服务中,前往左侧栏的“自定义域”
- 点击“添加自定义域”
- 输入您的域名(如
myapp.example.com) - 按照指引验证域名所有权
- 您需要在 DNS 设置中添加
TXT或CNAME记录
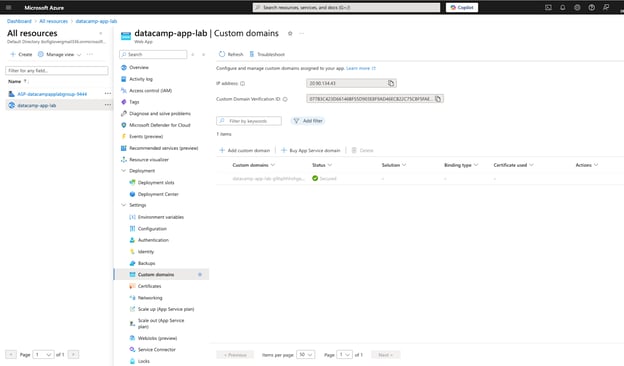
对于顶级域(如不带 www 的 example.com),您需要创建一个指向应用服务 IP 地址的 A 记录。该 IP 地址可在自定义域配置页找到。
您也可以通过 Azure CLI 管理自定义域:
# Add a custom domain
az webapp config hostname add --webapp-name MyWebApp --resource-group MyResourceGroup --hostname www.example.com绑定 SSL 证书
对于需要处理敏感数据的安全应用,启用 HTTPS 至关重要。Azure 应用服务支持免费托管证书,也允许您上传自有证书,配置十分简便。
添加 SSL 证书的步骤:
- 在应用服务中进入“TLS/SSL 设置”
- 选择“私钥证书”
- 选择以下任一选项:
- 创建免费应用服务托管证书
- 导入应用服务证书
- 上传 PFX 证书
- 添加证书后,前往“绑定”
- 为您的自定义域添加 SSL 绑定
对于处理敏感信息的数据应用,我建议启用“仅 HTTPS”模式,确保所有流量均已加密:
- 在“TLS/SSL 设置”中,进入“仅 HTTPS”部分
- 将开关切换为“开”
- 点击“保存”
配置身份验证与授权
许多数据应用需要用户身份验证,以控制对敏感数据或功能的访问。Azure 应用服务提供内置身份验证选项,可免去您在代码中自行实现认证逻辑。
设置身份验证:
- 在应用服务中,进入左侧栏的“身份验证”
- 点击“添加标识提供者”
- 选择您的标识提供者:
- Microsoft(Azure AD)
- GitHub
- OpenID Connect
- 配置提供者设置
- 设置重定向 URL 与令牌存储配置
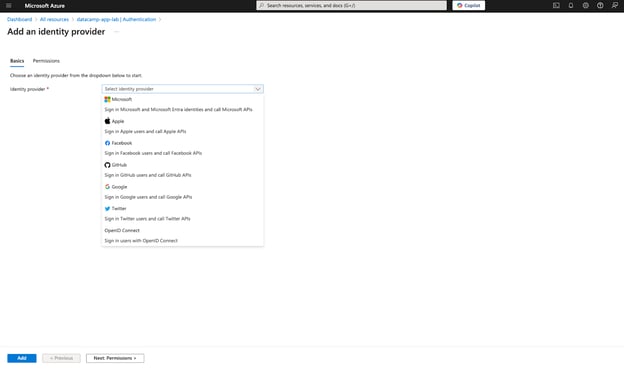
对于企业级数据应用,Azure Active Directory 往往是首选,因为它能与现有企业身份集成,并支持条件访问与多重身份验证等功能。
您还可以配置授权限制以控制谁能访问您的应用:
- 在身份验证设置中,选择您的标识提供者旁的“编辑”
- 在“限制访问”下选择以下选项之一:
- 允许未验证请求
- 要求进行身份验证
- 允许匿名请求(无操作)
- 如有需要,配置允许的外部重定向 URL
应用设置与连接字符串
我们之前简要介绍了应用设置,下面更深入地说明如何有效利用它们为数据应用配置参数。
Azure 应用服务中的应用设置会作为环境变量提供给应用。它们尤其适用于:
- 数据库连接字符串
- API 密钥
- 功能开关(Feature Flags)
- 特定环境配置
添加或修改应用设置:
- 在应用服务中,前往左侧栏的“配置”
- 选择“应用程序设置”选项卡
- 点击“新建应用程序设置”以添加键值对
- 对于敏感值,您可以切换“部署槽设置”以在槽位交换时避免被替换
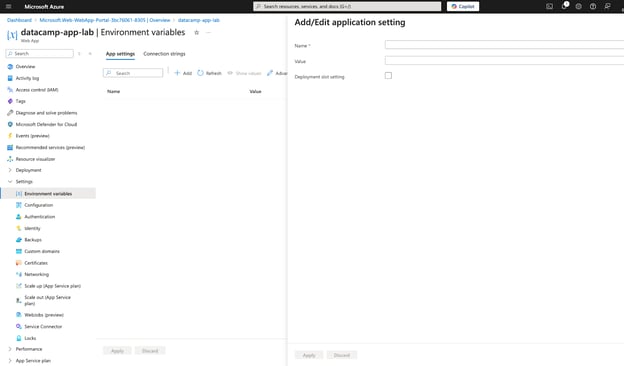
对于数据应用,常见设置包括:
- 数据库连接字符串
- 存储帐户访问密钥
- 机器学习模型端点
- 用于 A/B 测试的功能开关
您还可以单独配置连接字符串,这对数据库连接尤其有用:
- 在“配置”页面选择“连接字符串”选项卡
- 点击“新建连接字符串”
- 提供名称、值与类型(SQL Server、MySQL、PostgreSQL 等)
连接字符串同样会以环境变量形式提供给您的应用,但具体命名约定会因语言/框架而异。
在 Python 应用中获取设置:
import os
# Retrieve an application setting
api_key = os.environ.get('API_KEY')
# Retrieve a connection string (Python)
connection_string = os.environ.get('SQLCONNSTR_MyDatabase')使用 Key Vault 引用
对于数据库凭据或 API 密钥等高度敏感信息,Azure Key Vault 提供了额外的安全层。您可以在应用设置中直接引用 Key Vault 机密:
- 创建 Azure Key Vault 并添加机密
- 确保您的应用服务拥有托管标识
- 授予该标识访问 Key Vault 的权限
- 在应用设置中使用如下格式引用机密:@Microsoft.KeyVault(SecretUri=https://myvault.vault.azure.net/secrets/mysecret/)
这种方式将敏感信息与应用配置解耦,并提供集中化的机密管理。
扩展与管理 Azure 应用服务
应用部署与配置完成后,接下来要确保其性能良好、可靠并能适应变化的工作负载。
正确扩展与管理 Azure 应用服务对数据应用尤为重要,因为它们通常具有可变的资源需求,并可能处理敏感信息。
扩展应用服务计划
云平台如 Azure 的一大优势是能根据需求随时扩缩资源。对数据应用而言,这一点尤为宝贵,因为工作负载常在高强度数据处理与低流量闲时之间大幅波动。
Azure 应用服务提供两种主要的扩展方式:
纵向扩展(向上/向下扩展)
纵向扩展是指更改应用服务计划的规格,以提供更多或更少的 CPU、内存与磁盘空间。当应用的性能受限于单个实例的资源时,这种方式很有用。
纵向扩展步骤:
- 在应用服务计划中,选择左侧栏的“纵向扩展(应用服务计划)”
- 根据需要选择不同的定价层或实例大小
- 点击“应用”
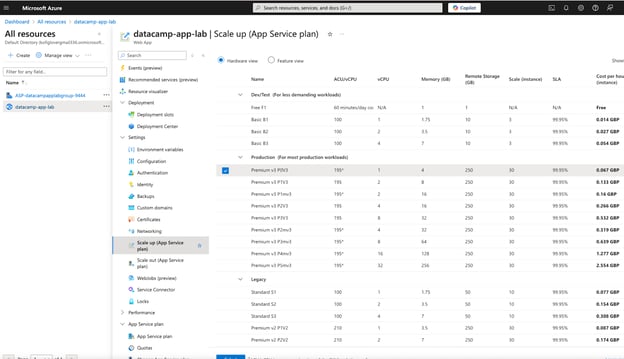
对于数据应用,建议在以下情况下考虑纵向扩展:
- 应用因大规模数据处理出现内存压力
- 模型推理时触及 CPU 上限
- 需要更多存储用于数据缓存或临时文件
横向扩展(向外/向内扩展)
横向扩展是指更改运行应用的虚拟机实例数量。此方式适合分散负载并提升可用性。
横向扩展步骤:
- 在应用服务计划中,选择左侧栏的“横向扩展(应用服务计划)”
- 手动设置实例数或配置自动扩展规则
- 点击“保存”
若手动扩展,只需将实例数调整到目标值即可。不过,自动扩展能根据指标自动调整资源,更具灵活性。
设置自动扩展规则
自动扩展对具有可变工作负载的数据应用尤其有价值。例如,机器学习模型服务 API 在工作时间可能面临更高流量,而在夜间流量较低。
配置自动扩展:
- 在“横向扩展”部分选择“启用自动扩展”
- 定义扩展条件,包含以下组件:
- 默认实例数
- 扩容规则(何时增加实例)
- 缩容规则(何时减少实例)
- 可选的基于日程的规则
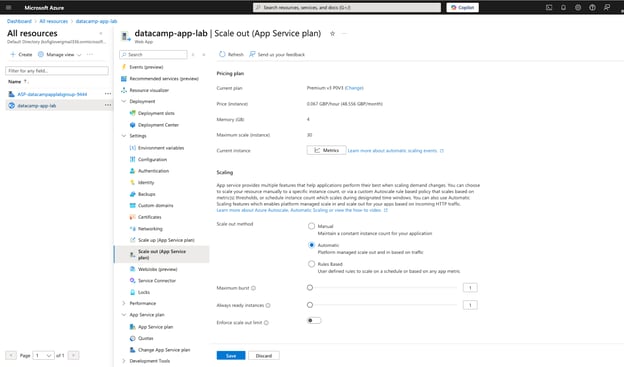
以下是常见的自动扩展规则示例:
- 扩容:当 CPU 百分比 > 70% 且持续 10 分钟时增加一个实例
- 缩容:当 CPU 百分比 < 30% 且持续 10 分钟时减少一个实例
您还可以基于以下指标创建更复杂的规则:
- 内存使用率
- 数据队列长度
- 来自 Application Insights 的自定义指标
针对数据科学工作负载,考虑以下自动扩展策略:
- 若应用用于服务机器学习模型,可基于请求队列长度扩展,以确保预测延迟保持较低
- 对于 ETL 流程,在已知处理时段安排额外产能
- 面对全球用户的应用,使用基于日程的扩展以保证不同时区的充足产能
您也可以使用 Azure CLI 配置自动扩展:
# Create an autoscale setting with a rule to scale out when CPU > 70%
az monitor autoscale create --resource-group MyResourceGroup --resource MyAppServicePlan --resource-type "Microsoft.Web/serverfarms" --name MyAutoScaleConfig --min-count 2 --max-count 5 --count 2
# Add a scale out rule
az monitor autoscale rule create --resource-group MyResourceGroup --autoscale-name MyAutoScaleConfig --scale out 1 --condition "Percentage CPU > 70 avg 10m"
# Add a scale in rule
az monitor autoscale rule create --resource-group MyResourceGroup --autoscale-name MyAutoScaleConfig --scale in 1 --condition "Percentage CPU < 30 avg 10m"监控与诊断
有效的监控对于维护可靠的数据应用至关重要。Azure 提供了全面的监控工具,为您提供关于应用性能、使用模式与潜在问题的可见性。
Azure Monitor 与 Application Insights
Azure Monitor 是监控 Azure 服务的基础,而 Application Insights 则提供更深入的应用级洞察。
为应用服务启用 Application Insights:
- 在您的应用服务中,选择左侧栏的“Application Insights”
- 点击“开启 Application Insights”
- 配置新建或现有的 Application Insights 资源
- 点击“应用”
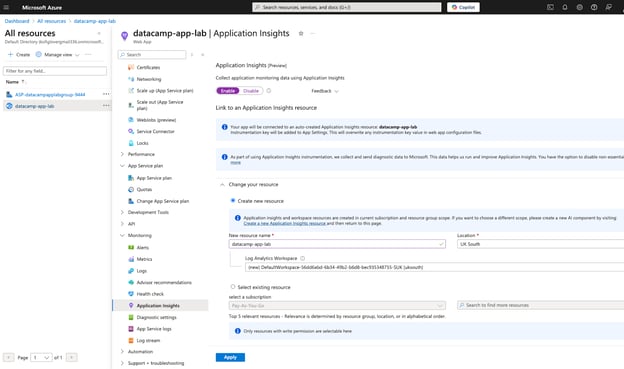
启用后,Application Insights 将收集丰富的应用数据,包括:
- 请求率、响应时间与失败率
- 依赖调用(数据库、外部 API)
- 页面视图性能
- 异常日志
- 您在代码中定义的自定义事件
对于 Python 应用,您需要安装 Application Insights SDK:
pip install opencensus-ext-azure然后为应用添加埋点:
from opencensus.ext.azure.trace_exporter import AzureExporter
from opencensus.trace.samplers import ProbabilitySampler
from opencensus.trace.tracer import Tracer
# Configure the Azure exporter
azure_exporter = AzureExporter(
connection_string='InstrumentationKey=00000000-0000-0000-0000-000000000000'
)
# Create a tracer
tracer = Tracer(exporter=azure_exporter, sampler=ProbabilitySampler(1.0))
# Use the tracer in your application
with tracer.span(name="main_function"):
# Your code here
pass查看日志并设置警报
Azure 应用服务会自动收集可帮助您诊断问题的日志:
- 在应用服务中选择“日志流”以查看实时日志
- 如需更详细分析,前往“诊断日志”并启用应用日志
- 配置日志级别(错误、警告、信息、详细)
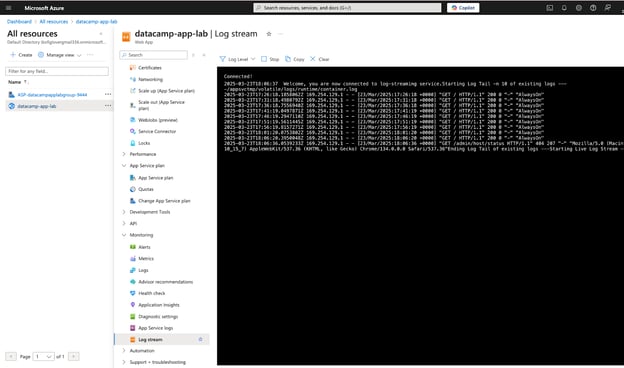
对于数据应用,重点关注:
- 内存不足异常——在处理大数据集时常见
- 与数据源的连接超时
- 数据转换操作中的性能瓶颈
设置警报可确保在问题影响用户前得到通知:
- 在 Azure Monitor 中选择“警报”
- 点击“新建警报规则”
- 选择您的应用服务作为资源
- 定义触发警报的条件
- 配置操作组,指定通知对象与方式
- 为警报命名并保存
数据应用的常见警报包括:
- 高内存使用率(>80%)
- 服务器错误(5xx 响应)
- 关键操作的长处理时间
- 数据连接失败尝试
数据应用的自定义监控
对于数据特定的监控需求,考虑追踪以下自定义指标:
- 数据处理吞吐量(每分钟处理记录数)
- 模型推理延迟
- 特征计算时间
- 缓存命中/未命中比
您可以使用 SDK 将自定义指标发送到 Application Insights:
from opencensus.ext.azure import metrics_exporter
from opencensus.stats import aggregation, measure, stats, view
# Create a metrics exporter
exporter = metrics_exporter.new_metrics_exporter(
connection_string='InstrumentationKey=00000000-0000-0000-0000-000000000000')
# Create and record custom metrics
prediction_time = measure.MeasureFloat(
"prediction_time", "Time taken for model inference", "ms")
prediction_time_view = view.View(
"prediction_time_view", "Model inference time", [], prediction_time, aggregation.LastValueAggregation())
# Register the view
stats.stats.view_manager.register_view(prediction_time_view)
# Record metrics
mmap = stats.stats.stats_recorder.new_measurement_map()
mmap.measure_float_put(prediction_time, 175.5) # Record 175.5ms inference time
mmap.record()
# Force metrics to be sent immediately
exporter.export_metrics([])备份与还原
数据应用往往管理着重要信息,因此备份与恢复能力必不可少。Azure 应用服务提供内置备份功能,可捕获应用文件、配置与连接的数据库。
设置自动备份
配置备份:
- 在应用服务中选择左侧栏的“备份”
- 点击“配置”
- 设置备份计划(每日、每周或自定义)
- 指定用于存放备份文件的存储帐户
- 可选:将数据库包含在备份中
- 点击“保存”
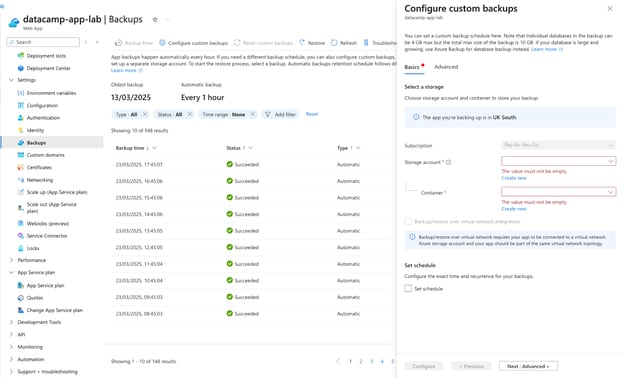
针对数据应用,建议遵循以下备份最佳实践:
- 在低活动时段安排备份
- 确保存储帐户与应用服务位于同一区域以加快备份速度
- 对于数据变更频繁的应用,配置更高频率的备份
- 注意大型数据库可能超出备份大小限制;此类情况请考虑数据库专用的备份策略
从备份还原
如需还原应用:
- 在“备份”部分选择要还原的备份点
- 点击“还原”
- 选择是否还原应用内容、配置与连接的数据库
- 指定目标应用服务(可为同一个或不同应用)
- 点击“确定”开始还原流程
对于关键数据应用,建议定期演练还原流程,确保恢复策略如预期运行。
数据库专用备份策略
虽然应用服务备份可包含连接的数据库,但数据密集型应用通常从数据库专用备份策略中获益更多:
- 对于 Azure SQL 数据库,配置自动备份与时间点还原
- 对于 Cosmos DB,使用连续备份模式
- 对于存放在 Azure 存储中的海量数据,考虑使用存储帐户复制与版本控制
Azure 应用服务中的安全与合规
对于处理敏感或受监管信息的数据应用,安全至关重要。Azure 应用服务提供多项安全功能,帮助保护您的应用。
基于角色的访问控制(RBAC)
RBAC 允许您控制谁能管理您的应用服务资源:
- 在 Azure 门户中导航至您的应用服务
- 选择左侧栏的“访问控制(IAM)”
- 点击“添加”,然后选择“添加角色分配”
- 选择合适的角色:
- 参与者(Contributor):可管理应用服务,但不能授予他人访问权限
- 读取者(Reader):可查看但不能更改
- 网站参与者(Website Contributor):可管理网站,而非应用服务计划
- 选择要分配角色的用户、组或服务主体
- 点击“保存”
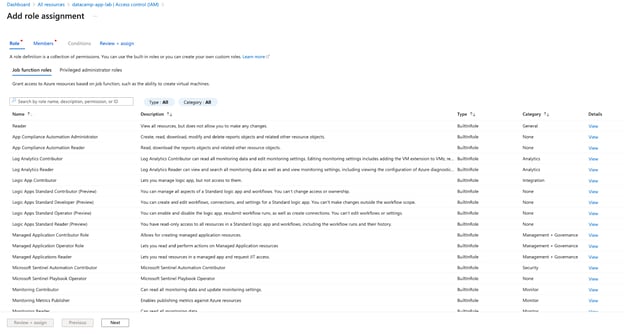
对于数据团队,考虑创建自定义角色,以根据岗位职责限制访问到特定操作。
IP 限制与网络
IP 限制允许您控制哪些 IP 地址可以访问您的应用服务:
- 在应用服务中选择左侧栏的“网络”
- 进入“访问限制”
- 点击“添加规则”
- 指定 IP 地址范围、操作(允许/拒绝)、优先级与名称
- 点击“添加规则”
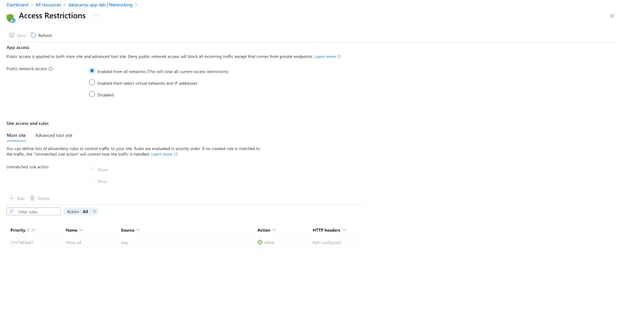 对于连接内部资源的数据应用,请考虑:
- VNet 集成:将应用服务连接到您的虚拟网络
- 服务终结点:保护到 Azure 服务(如 SQL 与存储)的连接
- 专用终结点:从虚拟网络为应用服务创建专用链接
设置 VNet 集成:
- 在“网络”部分选择“VNet 集成”
- 点击“添加 VNet”
- 选择或创建虚拟网络与子网
- 点击“确定”
此集成对于安全连接位于您网络内的数据库或其他数据源尤为有用。
排查常见 Azure 应用服务问题
即便经过周密规划,应用服务仍可能出现问题。以下是常见问题与对应解决方案,聚焦于数据应用场景。
诊断应用崩溃
如果您的应用崩溃或无响应:
- 检查应用服务日志:
- 进入“日志流”查看实时日志
- 查看“诊断日志”中的历史数据
- 使用 Application Insights 定位异常
- 运行 Kudu 诊断工具:
- 访问
https://<your-app-name>.scm.azurewebsites.net/DebugConsole - 使用控制台检查文件与进程
数据应用崩溃的常见原因包括:
- 内存限制:处理大数据集可能超出可用内存
- 依赖问题:缺失或不兼容的软件包
- 配置错误:连接字符串或环境变量不正确
针对内存密集操作,考虑:
- 将规格纵向扩展到内存更大的层级
- 实现数据分块,以较小批次处理
- 采用更高效的算法或数据结构
调试性能问题
如果您的应用运行缓慢:
- 使用 Application Insights 的性能监控:
- 在“性能”页查看慢请求
- 查找可能导致瓶颈的依赖调用
- 查看 Azure Monitor 中的服务器指标:
- CPU 与内存使用率
- HTTP 队列长度
- 针对数据密集操作检查数据库查询性能
改进性能的方法:
- 为高频查询实现缓存
- 优化数据库索引
- 考虑纵向或横向扩展
- 对长耗时流程使用异步操作
查看日志与错误信息
Azure 应用服务提供多种日志选项:
- 应用日志:应用自身输出的日志
- Web 服务器日志:HTTP 请求与错误日志
- 部署日志:关于部署过程的信息
- 详细错误日志:关于 HTTP 错误的更多信息
配置更详细的日志:
- 在应用服务中进入“诊断日志”
- 启用相应日志类型
- 设置合适的级别(错误、警告、信息、详细)
- 选择将日志存储在文件系统或 Blob 存储
对于 Python 应用,您可以通过以下方式增强日志记录:
import logging
import sys
# Configure logging
logging.basicConfig(
level=logging.INFO,
format='%(asctime)s - %(name)s - %(levelname)s - %(message)s',
handlers=[
logging.StreamHandler(sys.stdout)
]
)
# Use logging in your application
logger = logging.getLogger(__name__)
logger.info("Processing data batch")
logger.error("Failed to connect to database", exc_info=True)使用 Azure 应用服务的成本管理
数据应用常常消耗大量资源,因此理解并优化成本尤为重要。在最后一节,我们将探讨 Azure 应用服务的定价模型与高效管理成本的策略。
了解 Azure 应用服务定价
Azure 应用服务的定价主要基于您选择的应用服务计划。我们来分解需要考虑的成本因素:
应用服务计划层级
如前所述,Azure 提供多个定价层级,每个层级具备不同的能力与成本:
|
层级 |
月度费用范围(美元) |
功能 |
最佳适用场景 |
|
Free |
$0 |
1GB 存储,共享基础设施,每日 60 分钟计算 |
开发、学习 |
|
Shared (D1) |
$10-15 |
1GB 存储,每日 240 分钟计算 |
低流量站点、测试 |
|
Basic (B1-B3) |
$55-220 |
专用虚拟机、手动扩展、自定义域名 |
生产工作负载、低至中等流量 |
|
Standard (S1-S3) |
$70-400 |
自动扩展、预备插槽、每日备份 |
流量波动的生产应用 |
|
Premium (P1V2-P3V2) |
$80-500 |
增强性能、更多扩展选项 |
高性能需求、大型应用 |
|
Isolated |
$300-1000+ |
专用网络/计算隔离 |
具严格合规要求的应用 |
注意:以上价格为大致范围,可能因地区或 Azure 价格变动而有所不同。最新信息请查看 官方定价页面。
其他成本因素
除基础的应用服务计划外,还需考虑以下额外成本:
- 出站数据传输:每月前 5GB 免费,之后按量计费。对向用户提供大数据集的应用,这部分开销可能较大。
- SSL 证书:Azure 提供免费证书,但自定义证书会产生费用。
- 自定义域:第一个自定义域免费,额外域名可能收取费用。
- 存储:超出所在层级包含的存储将产生额外费用。
- 附加组件与连接服务:与应用服务相连的数据库、缓存服务及其他 Azure 资源各自计费。
监控成本
Azure 提供工具用于监控与预测支出:
- Azure 成本管理:在 Azure 门户中查看按资源的成本、设置预算与创建警报。
- 定价计算器:使用 Azure 定价计算器 预估部署前的成本。
- 顾问建议:Azure Advisor 根据使用模式提供成本优化建议。
> 若要在 Azure 服务中高效管理成本、安全与性能,强烈推荐这门 Azure 管理与治理课程。
成本优化策略
在了解定价模型后,我们来探讨在 Azure 应用服务上为数据应用优化成本的策略。
合理选择应用服务计划规格
控制成本的有效方式之一是确保所用的应用服务计划与需求相匹配:
- 设置合理基线:不要默认选择高阶计划,从中等计划开始,仅在必要时再升级。
- 监控资源使用率:通过 Azure Monitor 追踪 CPU、内存与磁盘使用。如果持续低于 50%,考虑降配。
- 将层级与工作负载匹配:对于可预测、稳定的工作负载,Basic 或 Standard 层或许足够。将 Premium 层留给性能要求严苛的应用。
针对数据科学应用,有以下建议:
- 模型服务 API 对低延迟有要求但流量适中时,常见做法是在 Standard 计划上启用自动扩展。
- 按计划运行的数据处理流水线 若处理时间不关键,通常可使用 Basic 计划。
- 交互式仪表板 若并发用户较多,通常需要 Standard 或 Premium 计划以保持响应性。
高效使用自动扩展
自动扩展不仅用于应对流量高峰——也是强大的成本优化工具:
- 可行时缩容至零:对于非关键应用或开发环境,在非工作时间考虑将实例最小化至 0。
- 设置合适的扩展阈值:不要过于激进地扩容。先从保守阈值(如 70% CPU)开始,并根据性能观测进行调整。
- 实施计划性扩展:对于可预测的工作负载,优先使用基于日程的扩展规则而非基于指标的自动扩展。例如,工作时间扩容,夜间与周末缩容。
# Example: Create a scheduled autoscale rule to scale down at night
az monitor autoscale rule create --resource-group MyResourceGroup --autoscale-name MyAutoScaleConfig --scale to 1 --condition "Current time is between 22:00 and 06:00 recurring"优化开发与测试环境
开发与测试环境具有巨大的节省空间:
- 尽可能使用 Free 或 Shared 层 作为开发环境。
- 实施自动停机:对非生产环境在非工作时间自动停止。尽管应用服务没有内置停机功能,您可以使用 Azure Automation 或 Logic Apps 按计划停止与启动应用。
- 高效使用部署槽位:与其维护独立的预生产环境,不如在单个生产应用服务中使用部署槽位。此举可在不重复成本的情况下进行环境切换。
# Create a staging slot
az webapp deployment slot create --name MyWebApp --resource-group MyResourceGroup --slot staging
# Swap staging to production
az webapp deployment slot swap --name MyWebApp --resource-group MyResourceGroup --slot staging --target-slot production数据特定的成本优化
针对数据应用,考虑以下专业节省方案:
- 卸载重型计算:不要在应用服务中执行密集数据处理,考虑使用 Azure Functions(无服务器处理)或 Azure Data Factory(ETL 流程)。
- 实施缓存:对变化不频繁的数据实施缓存以减少数据库调用与计算。Azure Cache for Redis 与应用服务集成良好。
- 优化数据库成本:往往与应用服务相连的数据库成本更高。请考虑:
- 为 SQL 数据库使用弹性池
- 实施合适的索引
- 对低频访问数据使用分层存储
- 压缩响应:对于向用户提供大数据集的应用,启用压缩以减少出站数据传输成本:
# Example for Flask applications
from flask import Flask
from flask_compress import Compress
app = Flask(__name__)
Compress(app)数据应用的高级技巧
除成本优化外,还有多种高级技巧可提升您在 Azure 应用服务上的数据应用性能与能力。
容器化数据应用
容器可在各环境间提供一致性,并简化依赖管理——这对依赖复杂的数据应用尤为常见与关键:
- 在 Azure 门户中创建新的 Web 应用
- 在发布选项中选择“Docker Container”而非“Code”
- 选择单容器并指定您的 Docker 镜像
对于数据科学应用,考虑维护一个包含 NumPy、pandas、scikit-learn 等常用库的基础镜像,以加速部署。
为数据工作流实施 CI/CD
在基础 CI/CD 之外,考虑为数据应用实施自动化测试:
- 数据验证测试:验证数据处理是否产生预期结果
- 模型性能测试:确保机器学习模型达到准确度与性能阈值
- 压测:验证应用能处理预期数据量
数据应用的 GitHub Actions 工作流示例:
name: Data App CI/CD
on:
push:
branches: [ main ]
jobs:
test:
runs-on: ubuntu-latest
steps:
- uses: actions/checkout@v2
- name: Set up Python
uses: actions/setup-python@v2
with:
python-version: '3.8'
- name: Install dependencies
run: |
python -m pip install --upgrade pip
pip install -r requirements.txt
pip install pytest pytest-cov
- name: Test with pytest
run: |
pytest tests/data_validation_tests.py
pytest tests/model_performance_tests.py
deploy:
needs: test
runs-on: ubuntu-latest
steps:
- uses: actions/checkout@v2
- name: Deploy to Azure
uses: azure/webapps-deploy@v2
with:
app-name: 'my-data-app'
publish-profile: ${{ secrets.AZURE_WEBAPP_PUBLISH_PROFILE }}使用 WebJobs 进行后台处理
对于需要后台处理的数据应用,Azure WebJobs 可在与应用服务相同的上下文中运行脚本或程序:
- 在应用服务中进入左侧栏的“WebJobs”
- 点击“添加”
- 上传您的脚本文件(如用于数据处理的 Python 脚本)
- 选择触发类型(手动、计划或持续)
- 点击“确定”
WebJobs 尤其适用于:
- 定期数据清理
- 常规报表生成
- 周期性模型再训练
- 系统间数据同步
面向本地数据的混合连接
许多组织仍保留部分本地数据。Azure 应用服务可通过以下方式连接这些数据:
- VNet 集成:将应用服务连接到通过 ExpressRoute 或 VPN 与本地网络相连的虚拟网络。
- 混合连接:无需 VPN 的更简方式,使应用服务可通过主机名与端口访问特定本地服务器。
设置混合连接:
- 在应用服务中选择左侧栏的“网络”
- 进入“混合连接”
- 点击“添加混合连接”
- 新建或使用现有连接
- 指定终结点主机名与端口
- 在本地服务器上安装 Hybrid Connection Manager
为数据应用实施功能开关
功能开关允许选择性启用功能,这对数据功能的 A/B 测试或逐步发布新模型很有价值:
{
"FeatureFlags": {
"NewRecommendationModel": false,
"AdvancedDataFiltering": true
}
}在代码中读取这些开关:
import os
import json
feature_flags = json.loads(os.environ.get('FeatureFlags', '{}'))
use_new_model = feature_flags.get('NewRecommendationModel', False)
if use_new_model:
# Use new recommendation model
else:
# Use existing model这种方式可让您在少量用户中测试新功能,或在无需重新部署的情况下快速禁用有问题的功能。
> 如需深入了解自动化部署机器学习模型,请查阅这门 CI/CD for Machine Learning 课程。
结语
本教程带您全面了解如何为数据应用在 Azure 应用服务上进行搭建、部署、配置、扩展与优化。从创建第一个应用服务到实现自动扩展与混合连接等高级功能,您已具备利用 Azure 平台承载数据工作负载的知识。
要点回顾
- Azure 应用服务提供全托管平台,让数据从业者专注于应用逻辑而非基础设施管理。
- 多种部署选项可无缝融入现有开发工作流,无论您使用 GitHub、Azure DevOps 还是本地 Git 仓库。
- 强大的扩展能力确保您的应用可应对不同工作负载,从开发测试到生产流量高峰。
- 内置监控与诊断工具有助于维护可靠性与性能,并可针对数据应用设置专属指标。
- 成本优化策略帮助您在降低开销的同时最大化价值,尤其适用于资源密集型数据工作负载。
后续步骤
若要继续深入 Azure 应用服务,建议探索:
- 与 Azure ML 集成:将 Azure 机器学习中训练的模型部署到应用服务用于推理。
- Azure Functions:用于事件驱动的无服务器计算,与应用服务应用相辅相成。
- Azure API 管理:用于保护与管理公开数据服务的 API。
- Azure Logic Apps:在应用服务与其他数据源之间实现工作流自动化。
- 如果您正准备认证或想要系统化学习,Microsoft Azure 基础(AZ-900)学习路径 也很有帮助。
请记住云端生态发展迅速,因此请关注Azure 更新页面,发现可增强您数据应用的新功能与服务!

具备广泛的技术背景,涵盖机器学习、数据科学、量化建模、软件工程、DevOps 与云计算。
高效部署应用已与开发同等重要。作为一名数据从业者,我常常发现,我们在打磨模型和应用上投入了大量时间,但部署流程有时却被放到次要位置。Azure 应用服务正是为此而来——它简化了部署流程,并提供可扩展性、安全性与监控等强大功能。
在这份全面教程中,我将带您在 Azure 应用服务上完成应用的搭建、部署与扩展。
无论您是首次部署应用的初级数据从业者,还是希望优化云端基础设施的资深专业人士,本指南都将提供实用步骤与最佳实践。
什么是 Azure 应用服务?
Azure 应用服务是微软提供的 PaaS(平台即服务),让您无需管理底层基础设施即可构建与托管 Web 应用。它支持多种编程语言与框架,包括 Python、Java、Node.js、.NET 等。
在开始搭建流程前,让我们先了解 Azure 应用服务对数据从业者的独特价值:
作为数据科学家或工程师,您可能会思考应用服务与 Azure Functions 或 Azure Kubernetes Service 等产品的区别。关键在于,应用服务提供恰到好处的平衡点——比无服务器选项更灵活,同时又比容器编排平台更简单。
> 如需了解 Azure 生态与服务的基础概览,请参阅 这门 Microsoft Azure 入门课程。
设置 Azure 应用服务
既然我们已经了解了 Azure 应用服务是什么,接下来就动手创建我们的第一个应用服务。该流程包含两个主要步骤:创建应用服务计划,然后在该计划内创建 Web 应用。
创建 Azure 应用服务计划
应用服务计划定义了您的应用所用的计算资源、区域与定价层。您可以将它视作承载应用的服务器场。多个应用可以共享同一个应用服务计划,这对于同时运行多个小型应用来说很划算。
创建应用服务计划的方法如下:
说到定价层,Azure 应用服务提供多种选项:
层级
功能
最佳适用场景
Free
1GB 存储,共享基础设施,每日 60 分钟计算
开发与测试
Shared
1GB 存储,每日 240 分钟计算
低流量应用、开发
Basic
10GB 存储,专用虚拟机,自定义域名
中等流量的生产工作负载
Standard
50GB 存储,自动扩展,预备插槽
较高流量的生产应用
Premium
250GB 存储,增强性能,更多扩展选项
企业应用,高性能需求
对于数据应用,我通常建议在生产环境至少从 Basic 层开始,因为数据处理通常比简单的网页服务需要更多资源。如果您要服务对计算要求较高的机器学习模型,可考虑使用具备自动扩展能力的 Standard 层。
您也可以使用 Azure CLI 创建应用服务计划:
创建应用服务 Web 应用
创建好应用服务计划后,您可以在计划内创建 Web 应用。Web 应用是实际运行您代码的应用实例。
按照以下步骤创建 Web 应用:
myapp.azurewebsites.net)如果您使用 Azure CLI,只需一条命令即可创建 Web 应用:
创建 Web 应用后,Azure 会预配所需资源。完成后,您可以点击“转到资源”或在资源组中找到并进入该 Web 应用。
此时访问应用 URL(
https://your-app-name.azurewebsites.net)应能看到默认页面。这表明应用已在运行,但尚未包含您的代码——我们将在下一节介绍部署。配置基础应用设置
在进行部署前,先为应用配置一些基础设置。对于数据应用,您可能需要为数据库连接或 API 密钥设置特定环境变量。
配置应用设置的方法:
您也可以通过 Azure CLI 设置:
这些设置将作为环境变量提供给您的应用,是在不将配置硬编码到源码的前提下,安全存储配置的方式。
部署您的第一个应用
我们已完成 Azure 应用服务基础设施的搭建,现在该部署应用了。Azure 应用服务提供多种部署方式,能根据您的工作流与偏好提供灵活性。本节将介绍如何通过源代码管理(GitHub 或 Azure Repos)、FTP 以及本地 Git 仓库进行部署。
对数据从业者而言,此步骤至关重要,因为它将本地开发环境与可用于生产的应用连接起来,从而服务您的模型或数据处理流水线。
> 如果您是部署原则的新手,这门 DevOps 课程能清晰介绍核心概念与工具。
从 GitHub 或 Azure Repos 部署
Azure 应用服务的一大亮点是内置的持续部署(CD)能力。将应用服务连接到 GitHub 或 Azure DevOps 仓库后,只要向特定分支推送代码,即可自动部署变更。
这种方式对协作型数据团队尤为有价值,因为它可以:
> 如果您对版本控制还不熟悉,GitHub Foundations 学习路径能帮助您快速入门基础知识。您也可以将Azure DevOps作为管理部署流水线与版本控制的强大备选方案。
以下是从 GitHub 设置持续部署的步骤:
Azure 会在您的仓库中创建一个 GitHub 工作流文件,当所选分支有变更推送时,它将自动构建并部署您的应用。该工作流使用 GitHub Actions 处理 CI/CD 过程。
> 如需进一步自动化部署,考虑将 Makefile 与 GitHub Actions 结合以精简 CI/CD 流程。
对于 Python 应用,工作流通常包括以下步骤:
requirements.txt安装依赖您也可以使用 Azure CLI 设置持续部署:
配置部署设置
要更精细地控制部署,您可以在 GitHub 工作流文件或 Azure 门户中配置附加设置:
对于数据科学应用,您可能需要添加自定义构建步骤,以安装科学计算包或运行模型训练脚本。这些都可以直接添加到仓库中的工作流文件中。
使用 FTP 或本地 Git 部署
尽管推荐在团队环境中使用来自 GitHub 或 Azure Repos 的持续部署,但有时您可能需要更直接的部署方式。针对这些场景,Azure 应用服务同时支持 FTP 与本地 Git。
FTP 部署
FTP 部署是一种直接将应用文件上传到 Azure 应用服务的简便方式。对于需要快速更新或不涉及复杂构建流程的应用,此方法很实用。
通过 FTP 部署:
/site/wwwroot/目录对于 Python 应用,请确保上传时包含
requirements.txt文件。Azure 应用服务会自动安装所需依赖。本地 Git 部署
本地 Git 部署允许您直接从本地 Git 仓库将代码推送到 Azure。此方法在保留 Git 版本控制优势的同时,赋予您更多部署过程的掌控力。
设置本地 Git 部署:
当您将代码推送到 Azure 远程仓库时,平台将自动构建并部署您的应用。
监控部署状态
无论您选择哪种部署方式,监控部署过程以便尽早发现问题都很重要。Azure 提供多种途径跟踪部署状态:
若部署失败,日志会提供问题原因。常见问题包括:
requirements.txt中缺失依赖排查部署问题的方法:
requirements.txt对于数据科学应用,部署失败常见于安装大型软件包或启动时内存密集操作。如遇此类问题,可考虑: