在数据可视化中,选择合适的颜色与选择正确的图表类型或数据呈现方式同样重要。好在 Python 借助 Seaborn 让您可以轻松找到合适的配色方案。继续阅读,了解如何创建既信息丰富又视觉醒目且易于理解的可视化。
如果您是 Python 新手,建议从 Introduction to Python 课程或 Python Programming 技能路径开始学习。这些资源将为您提供跟进示例并充分使用 Seaborn 功能所需的技能。
关于颜色基础的快速提示
定义任意颜色有三个主要要素:色相(hue)、饱和度(saturation)和明度(value)。它们各自都很重要,因为能传达不同类型的信息。
色相(Hue)
色相就是我们通常所说的“颜色”——即纯色本身,例如红、蓝或绿。

色相示意图。作者供图。
该图展示了不同的色相,沿着色轮从红色过渡到紫色。不同色相适合表示分类数据或突出特定元素。例如,您可以在条形图或散点图中使用不同色相来区分彼此无关的类别。
饱和度(Saturation)
饱和度表示颜色的强度或纯度。饱和度越高颜色越鲜艳,饱和度较低则显得更柔和或偏灰。
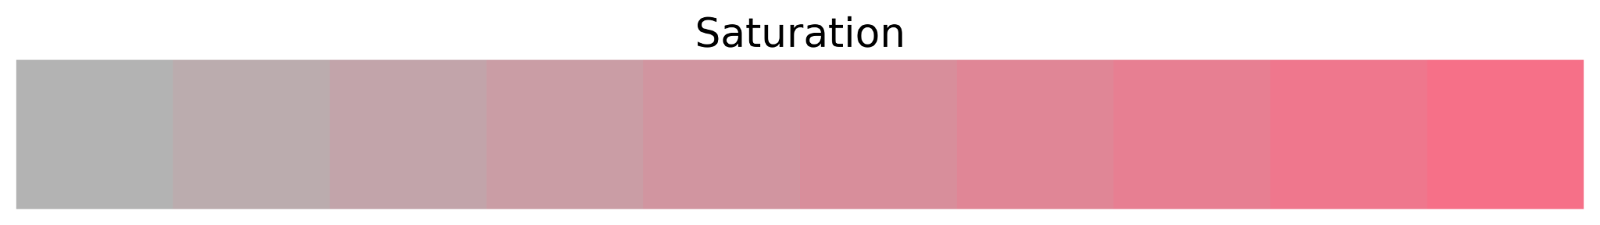
饱和度示意图。作者供图。
该渐变展示了同一色相下不同的饱和度。右侧颜色为完全饱和。向左移动时颜色逐渐去饱和,最终几乎呈现灰色。更高的饱和度可以吸引对关键数据点或关注区域的注意。
明度(Value)
明度亦称亮度,表示颜色的明暗程度。加入白色会提高明度,加入黑色会降低明度。
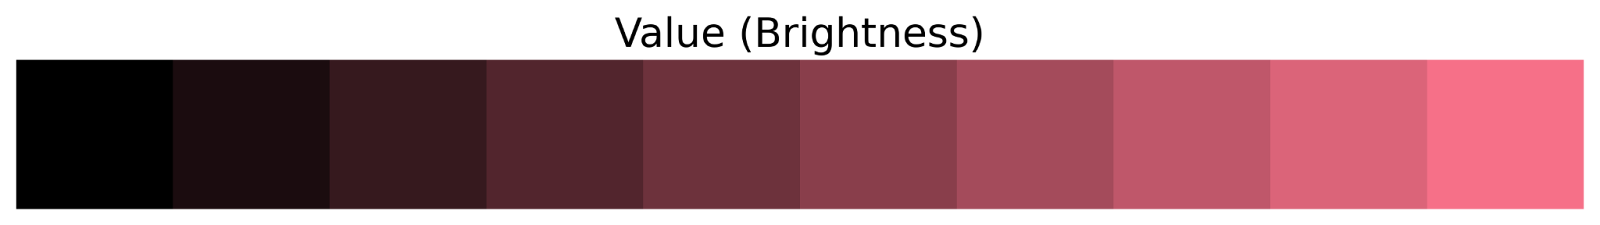
明度(亮度)示意图。作者供图。
该渐变展示了同一色相在不同亮度下的变化。右侧是最亮的颜色,向左移动明度降低,颜色变得更暗。明度有助于展示数据中的进程或层级。例如,您可以在热力图中使用明度渐变来显示二维网格上数据强度的变化。
Seaborn 配色方案类型
我们来看看 Seaborn 中三种主要的配色方案:定性(qualitative)、顺序(sequential)和发散(diverging)。
使用 color_palette() 的定性配色
定性配色用于类别型数据,其中各类别之间没有固有的顺序或关系。此类配色通过不同色相来区分类别。
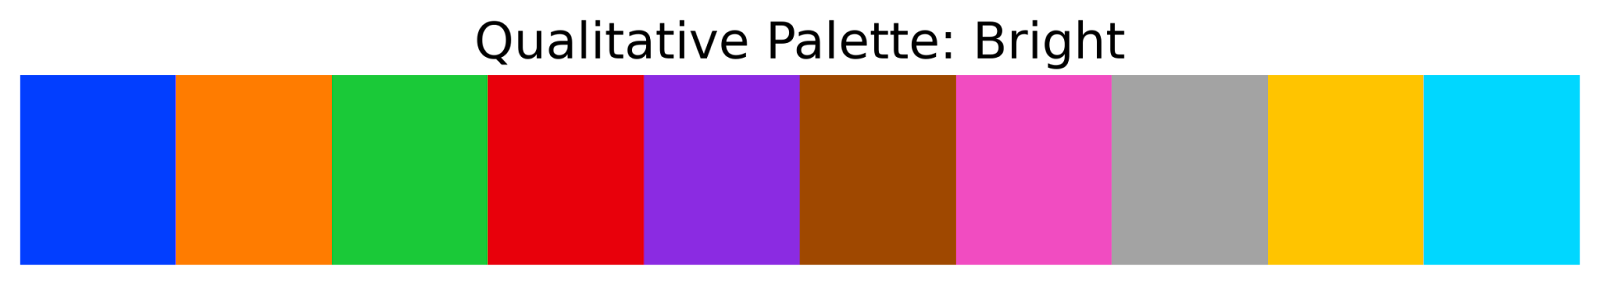
定性配色示意。作者供图。
上图的 "Bright" 配色是 Seaborn 内置定性配色的一个示例。它使用鲜明的色相来区分类别。颜色彼此易于分辨,非常适合没有内在顺序或关系的类别型数据。
color_palette() 函数是 Seaborn 创建自定义配色方案的方式。通过更改配色名称和颜色数量,您可以在不同类型的配色之间切换。使用命名配色(如 "pastel" 或 "Blues")时,number 参数决定显示的颜色数量。通常,您会将颜色数量与数据类别匹配,或创建具有特定步数的渐变。
若需更精确的控制,您可以使用 HEX 代码定义确切颜色。这在需要匹配特定品牌色或创建内置配色中没有的独特方案时尤其有用。以下展示了如何使用 color_palette() 创建不同类型的配色:
import seaborn as sns# Create a qualitative palette with 4 colors
qual_palette = sns.color_palette("pastel", 4)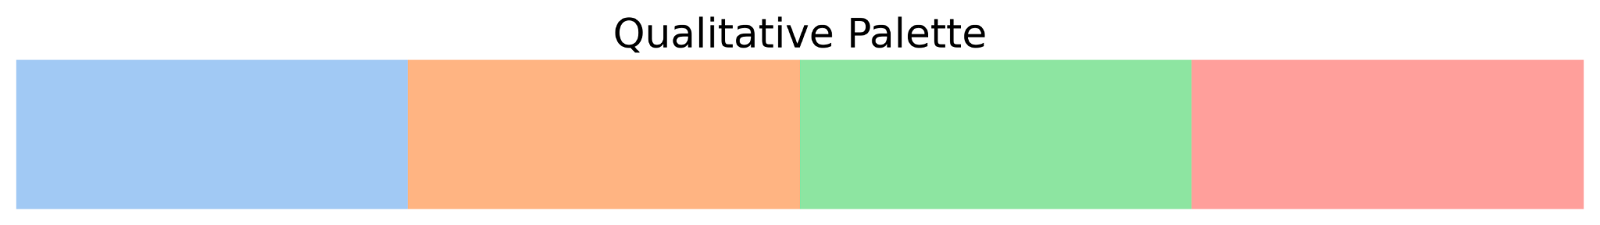
创建一个包含四种颜色的定性配色。作者供图。
# Create a sequential palette with 6 colors
seq_palette = sns.color_palette("Blues", 6)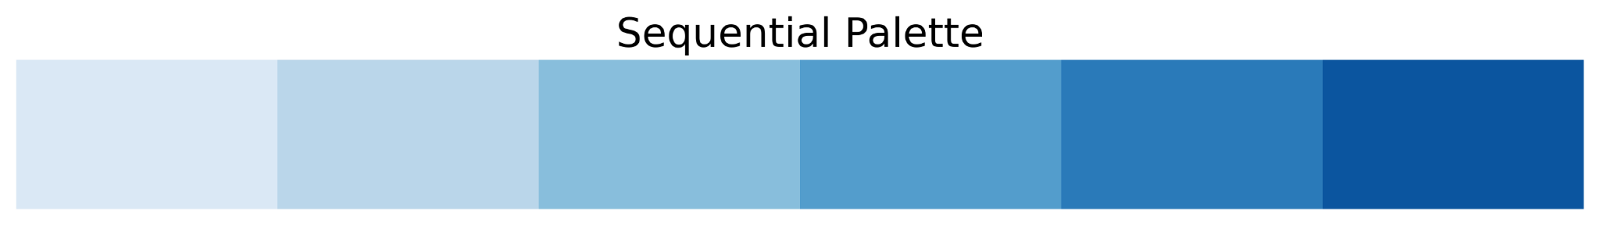
创建一个包含六种颜色的顺序配色。作者供图。
# Create a diverging palette with 12 colors
div_palette = sns.color_palette("RdBu", 12)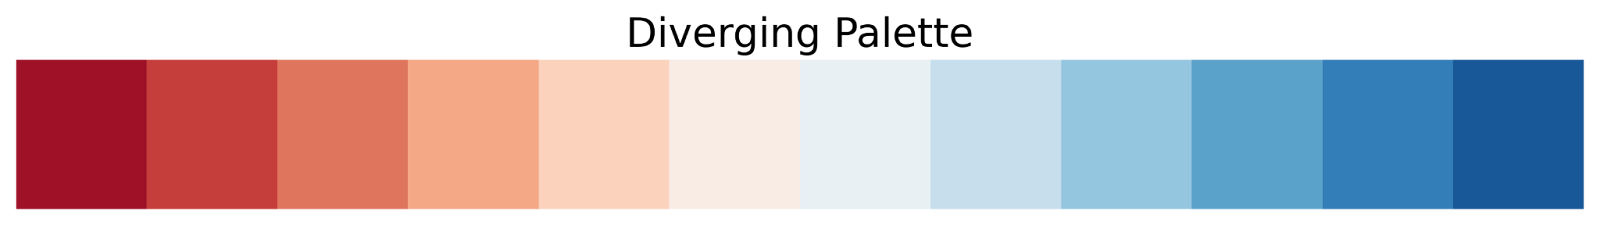
创建一个包含 12 种颜色的发散配色。作者供图。
# Create a custom palette using HEX codes
hex = sns.color_palette(["#FF6B6B", "#4ECDC4", "#45B7D1","#FAD02E", "#594F4F"])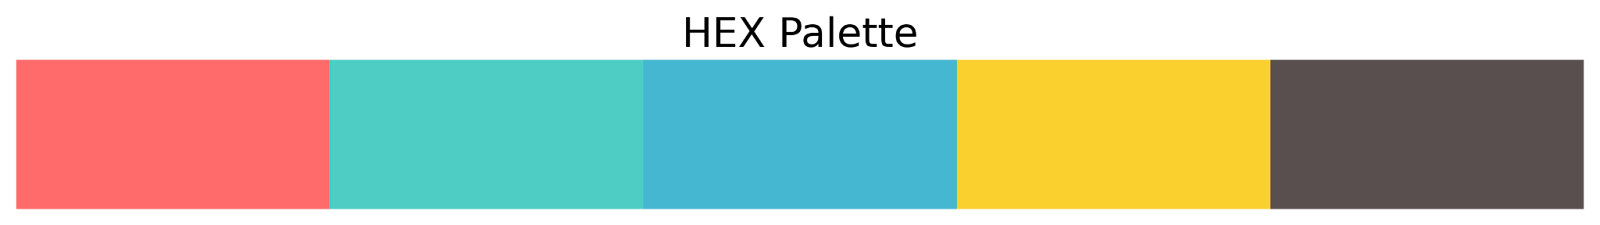
使用 HEX 代码创建自定义配色。作者供图。
使用 cubehelix_palette() 的顺序配色
顺序配色非常适合具有自然顺序的数值型数据。这类配色通过单一或多个色相的明度和/或饱和度变化来展示从低到高的进程。
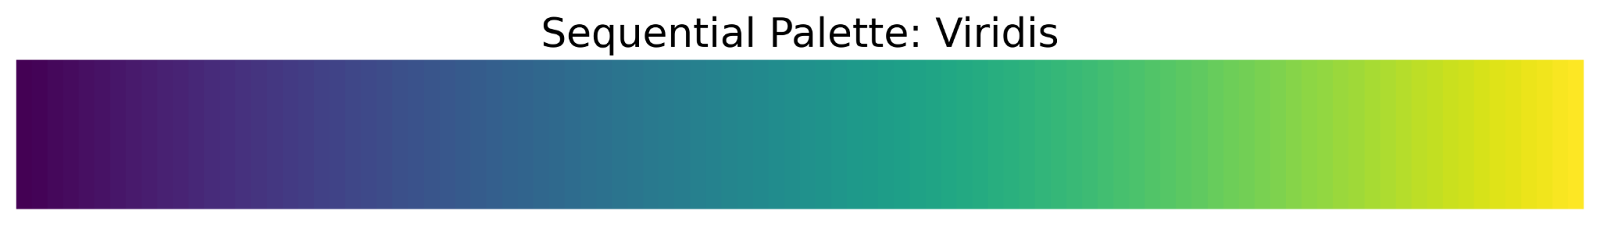
Viridis 顺序配色示意。作者供图。
"Viridis" 配色展示了从深紫到亮黄的渐变。这类配色适合展示从低到高的取值范围,尤其适用于温度范围、人口密度等连续数据,或任何需要清晰体现低-高关系的数据集。其他内置选项包括:‘Blues’、‘Greens’、‘Reds’、‘YlOrBr’ 和 ‘rocket’。
cubehelix_palette() 函数可用于创建在亮度和颜色推进上具有精细控制的顺序配色。当您需要在亮度上平滑递增且色相轻微变化的配色时,该函数尤其实用。以下是可自定义的参数:
-
n_colors:配色中的颜色数量。 -
start:颜色循环的起始位置(0-3)。 -
rot:决定色相变化幅度。 -
dark:配色中最暗的颜色。 -
light:配色中最亮的颜色。 -
reverse:是否反转配色方向。
import seaborn as sns# Create a default cubehelix palette
default_cube = sns.cubehelix_palette(8)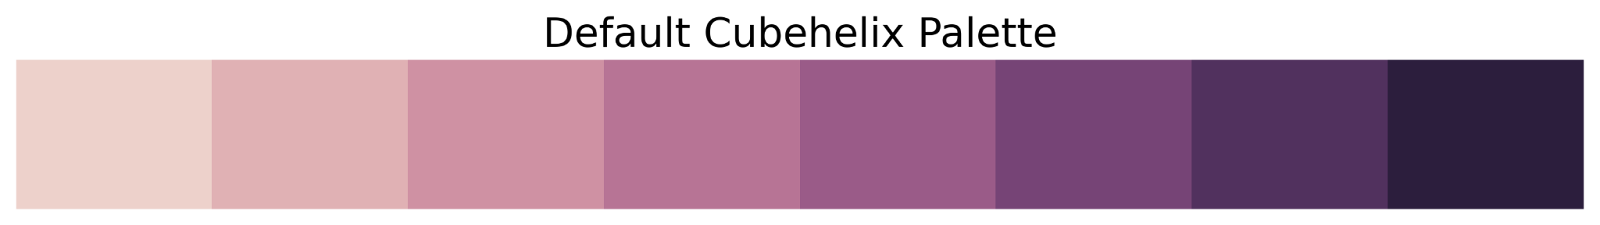
默认 cubehelix 配色示意。作者供图。
# Create a custom cubehelix palette
custom_cube = sns.cubehelix_palette(8, start=.5, rot=-.75, dark=.3, light=.8)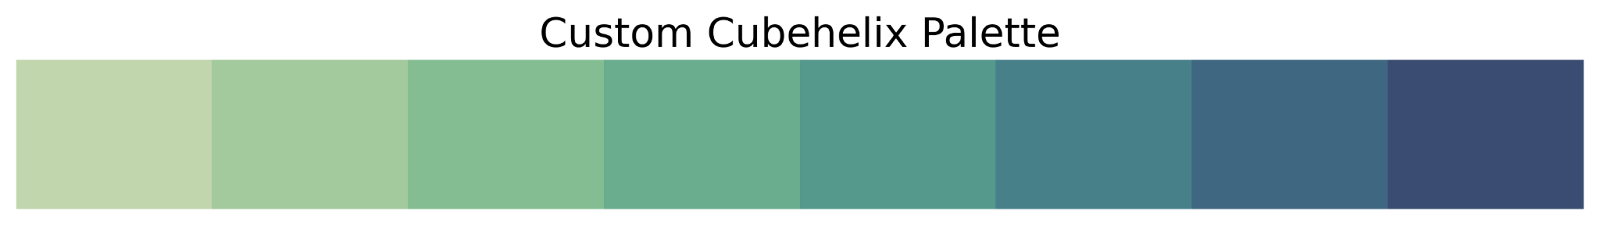
自定义 cubehelix 配色示意。作者供图。
# Create a reversed cubehelix palette
reversed_cube = sns.cubehelix_palette(8, start=2, rot=0, dark=0, light=.95, reverse=True)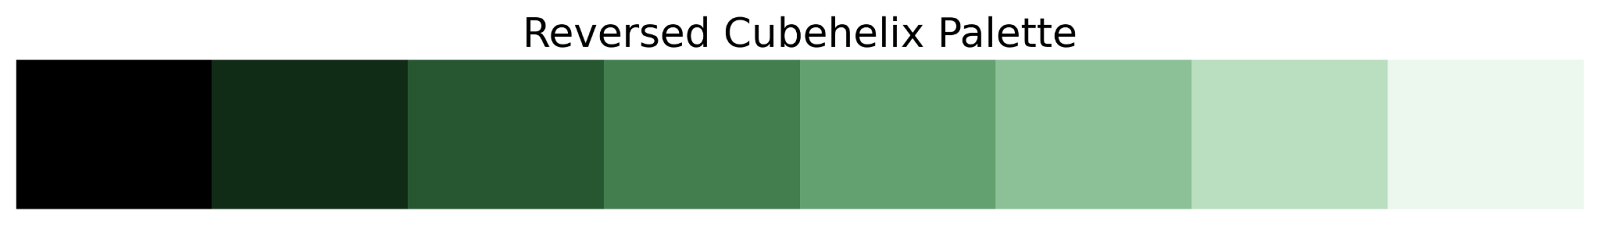
反转的 cubehelix 配色示意。作者供图。
使用 diverging_palette() 的发散配色
发散配色用于具有有意义中点或零值的数据。此类配色以两个对比色相围绕中心点展开,数值远离中心时颜色逐渐更饱和,以突出偏离程度。
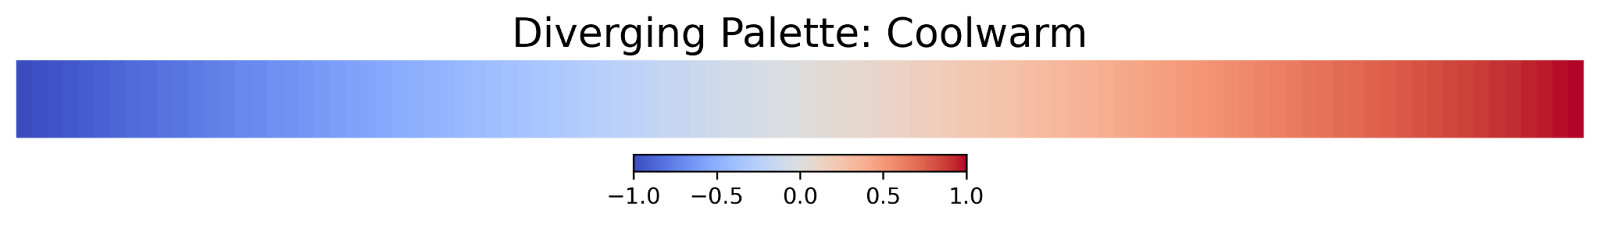
发散配色示意。作者供图。
上述示例很好地展示了这类配色如何突出围绕中心点的分歧。配色从冷蓝经中性的白色到暖红过渡,并具有清晰的中点。这种配色可用于可视化温度异常(0 表示平均温度)或财务数据中的盈亏情境。其他内置选项包括:'RdBu'、'RdYlGn' 和 'PiYG'。我们来看一下其参数:
-
h_neg和h_pos:配色负向与正向端点的色相。 -
n:配色中的颜色数量。 -
s:颜色的饱和度。 -
l:颜色的明度。 -
center:中心点的颜色('light'或'dark')。
import seaborn as sns# Create a default diverging palette
default_div = sns.diverging_palette(220, 20, n=7)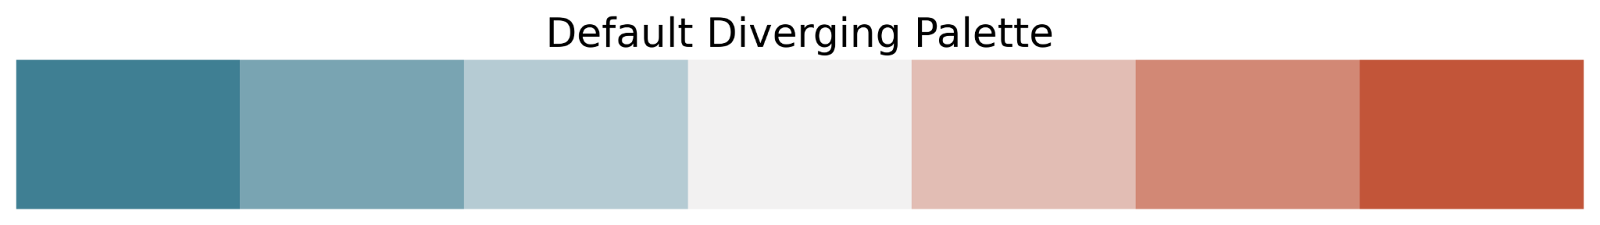
默认发散配色示意。作者供图。
# Create a diverging palette with more saturation
saturated_div = sns.diverging_palette(250, 30, l=65, s=75, n=7)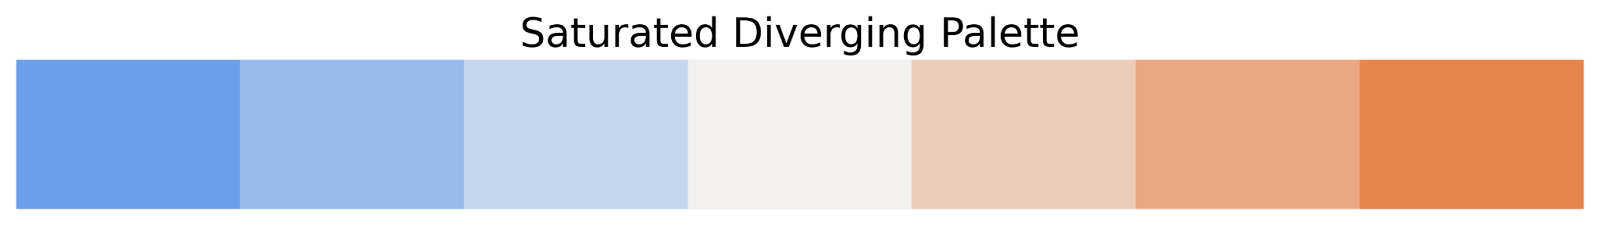
更高饱和度的发散配色。作者供图。
# Create a diverging palette with a darker center
dark_center_div = sns.diverging_palette(150, 275, s=80, l=55, n=9, center="dark")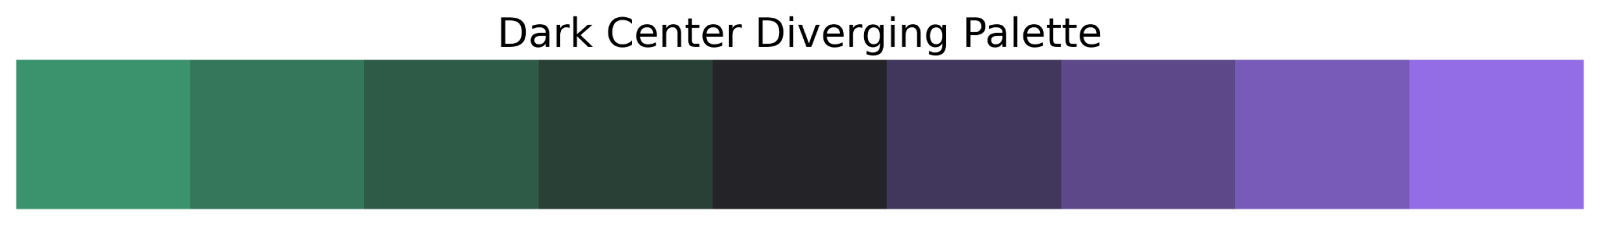
中心更暗的发散配色。作者供图。
关于 Seaborn 配色方案的最后提示
选择合适的配色方案是打造高效数据可视化的关键环节。Seaborn 多样且可定制的配色选项,为提升数据呈现的清晰度与影响力提供了有力工具。
当您将这些颜色概念应用到可视化项目并希望进一步提升技能时,建议探索系统的学习路径,例如 Python Developer 或 Data Analyst with Python 职业路径。这些面向职业的路径旨在帮助您从基础概念进阶到更高级的应用,而理解优秀的可视化始终至关重要。