在本教程中,您将专注于适用于 Oracle、MySQL、Microsoft SQL Server 等所有数据库的 ANSI(美国国家标准学会)SQL!让我们从SQL(结构化查询语言)的简介以及数据科学家为何需要它开始。
SQL 与数据科学
在本教程的这一部分,您将了解为什么数据科学家应该学习 SQL。让我们看看 SQL 将如何助力您的数据科学职业生涯:
- SQL 已成为大多数数据科学岗位(如数据分析师、BI(商业智能)开发者、程序员、数据库程序员)的必备技能。SQL 能让您与数据库沟通并处理您的数据。
- 如果您使用过 Tableau 或其他数据报表或可视化软件,您可能见过如何将项目连接到数据库,只需拖拽图表到报表并指定字段,其余由软件代劳。当您通过拖拽数据属性或使用图形界面一键完成各项操作时,软件背后运行的正是与数据库交互的 SQL。学习 SQL 后,您可以直接与数据库交互。
- SQL 可与所有应用程序编程语言(如 PHP、Java)配合使用。您可以在应用中集成 SQL 自行创建可视化,或从数据库获取数据并转换为 XML、JSON 格式以用于 Web 服务或 API。
- 数据库多年来不断演进。随着大数据成为热议话题、数据渗透日常生活,NoSQL 数据库日益流行。学习 SQL 将帮助您夯实数据库基础,理解何时使用结构化数据库、何时使用 NoSQL 数据库,并理解其差异。
这里我将简要介绍 SQL 与数据库中的一些术语,帮助您更快上手编码!如果您已了解关系型数据库与 SQL 是什么,可以直接跳到代码。
SQL 与数据库简介
数据库是信息的有序集合。要管理数据库,我们需要数据库管理系统(DBMS)。DBMS 是一种程序,可根据请求在数据库中存储、检索和修改数据。
历年来数据库类型多种多样:层次型、网状型、关系型,以及如今的 NoSQL 数据库。关系型数据库是关系(二维表)的集合。

以下是 RDBMS 中常用术语:
| Term | Description |
|---|
| Table | 表是 RDBMS 的基本存储结构。表存储关于现实世界某个对象的全部必要数据。例如:员工。 |
| Single Row or Tuple | 表示某个特定员工所需的全部数据。表中的每一行可通过主键标识,主键不允许重复行。 |
| Column or Attribute | 通常指实体的某个特征 |
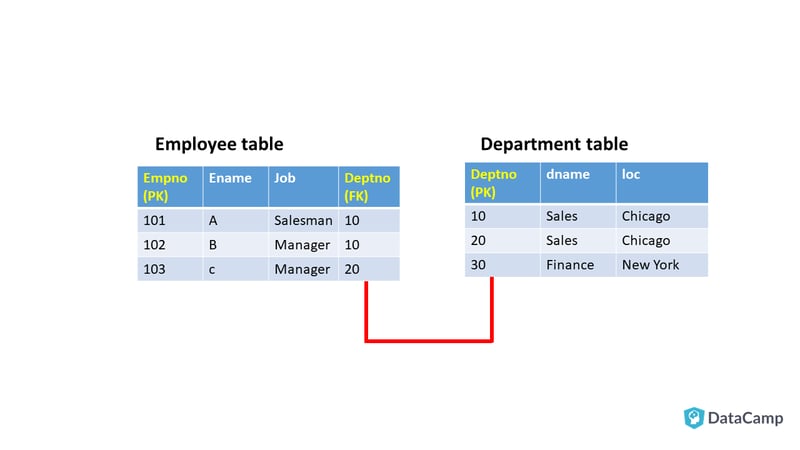
| Primary Key | 唯一标识一行的字段 |
| Foreign Key | 标识表与表之间关系的列。外键引用另一张表中的主键。 |
您可以使用主键和外键关联多张表。关系型数据库中的每一行都由主键(PK)唯一标识。您可以通过外键(FK)引用另一张表。例如:
可以使用结构化查询语言(SQL)访问关系型数据库。每种数据库都会支持标准的 ANSI SQL,同时也会为某些操作提供自有语法。本文将讲解 ANSI SQL,以便您能在所有数据库上工作。ANSI SQL 可分为五个部分。这里我会全部列出,但仅讲与数据检索和 DML 相关的两部分:
- 数据检索:
- 数据操作语言(DML):
- Insert、Update、Delete、Merge
- 数据定义语言(DDL):
- Create、Alter、Drop、Rename、Truncate。
- 数据控制语言(DCL):
- 事务控制:
- Commit、Rollback、Savepoint。
市面上有多家 RDBMS 供应商。最常见、使用最广的包括:
- Oracle(甲骨文公司)
- Microsoft SQL Server(微软)
- MySQL(甲骨文公司)
- PostgreSQL(PostgreSQL 全球开发组)
- SQLite(由 D. Richard Hipp 开发)
那么,在哪里运行 SQL 查询?可能的场景包括:
- 可从数据库读取并查看数据的报表软件(例如:Tableau、Microsoft BI)
- 数据库管理的图形界面工具(例如:Oracle 的 TOAD、SQL Developer,MySQL 的 phpMyAdmin)
- 基于控制台的数据库直连界面(例如:Oracle 数据库的 SQL Plus)
如果您拥有登录数据库的凭据,您可以通过查询或使用 GUI(具体取决于数据库供应商)查看数据库对象。
就是这样!让我们开始学习 SQL……
SQL 数据类型
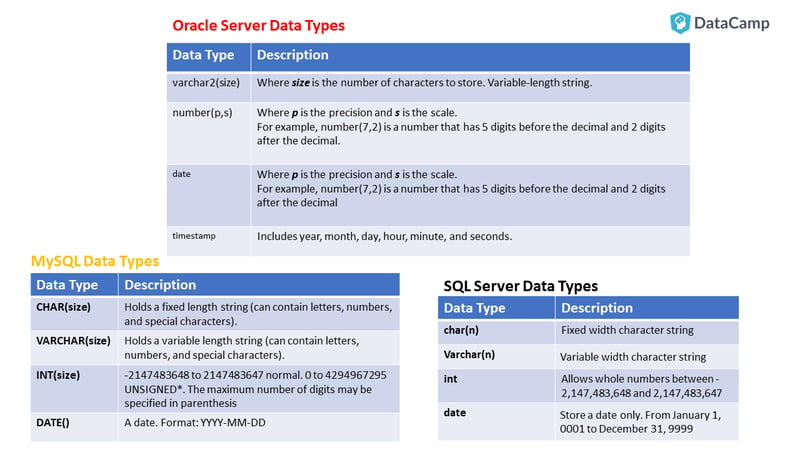
数据库中的每一列都有名称与数据类型,有时还会指定大小。由数据库开发人员根据需求与数据量设计数据库,并决定使用何种数据类型。
作为数据科学家,您需要熟悉数据类型,这将有助于您正确使用数据库函数并准确编写查询。数据库中每类列(如人名、文本、数字、存储在数据库中的图像等)都有相应的数据类型。
这里将向您展示 Oracle Server、SQL Server 和 MySQL Server 的基础数据类型:
延伸阅读:
SQL 与数据报表
本教程中使用的所有 SQL 基于以下示例数据库模式:
设有一个包含两张表的数据库,emp 表存放员工数据,dept 表存放部门数据。
emp 表包含员工编号(empno)、员工姓名(ename)、薪资(sal)、提成(comm)、职位名称(job)、经理编号(mgr)、入职日期(hiredate)和部门编号(deptno)。由于经理也是员工并拥有员工编号,mgr 来自某个职位为 "MANAGER" 的 empno。
dept 表包含部门编号(deptno)、部门名称(dname)以及部门所在地(loc)。
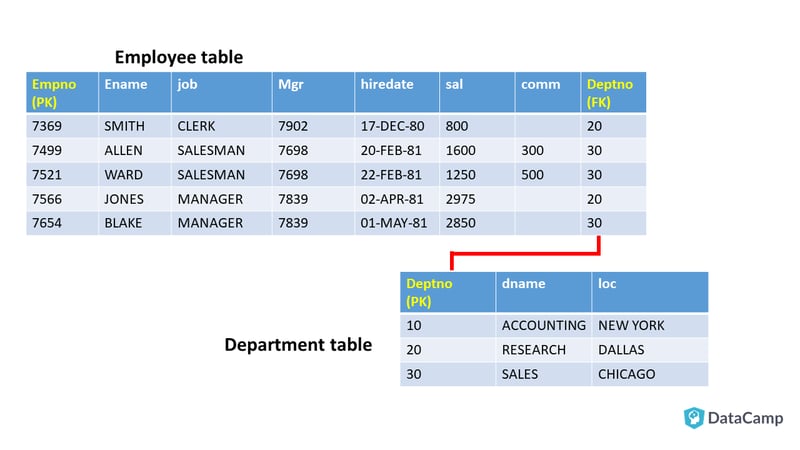
请注意,不同数据库的日期格式不同。这里的 DD-MON-YY 是 Oracle 数据库的默认日期格式。Microsoft SQL Server 和 MySQL 的默认格式是 YYYY-MM-DD。
您的数据库表可能不同,因此只需根据您的表名与属性名进行调整即可。在本教程中,您只会从数据库读取数据,不会写入、更新或创建新表和对象。因此无需担心任何数据丢失或变更!
信息:Schema(模式)是属于某个用户的对象集合,如表、函数、存储过程、视图等
在上述数据库模式中,您可以看到 emp 表为员工实体包含六个属性。dept 表为部门实体包含三个属性。
使用 SELECT 语句检索数据
SELECT 语句用于从数据库检索信息。使用 SELECT 语句,您可以进行以下操作:
1. 投影(Projection):您可以选择希望查询返回的表中列。可根据需要选择任意数量的列。
2. 选择(Selection):您可以选择希望查询返回的表中行。
您可以使用多种条件限制要查看的行。
3. 连接(Joining):您可以通过在不同表之间创建链接,将分散在不同表中的数据汇集在一起。
基本的 SELECT 语句允许您指定需要从哪张表中取哪些列。SELECT 子句指定列与表达式,FROM 子句指定取数的表。
例如,查询所有员工的姓名及其职位:SELECT ename, job FROM employee; 基于上文讨论的数据库模式,上述 SQL 将返回如下输出:
| ename | job |
|---|
| A | Salesman |
| B | Manager |
| C | Manager |
要选择表中的所有属性和所有行,使用 * 运算符:
SELECT *
FROM employee;
The output will be:

     EMPNO ENAME      JOB              MGR HIREDATE         SAL       COMM     DEPTNO
---------- ---------- --------- ---------- --------- ---------- ---------- ----------
      7369 SMITH      CLERK           7902 17-DEC-80        800                    20
      7499 ALLEN      SALESMAN        7698 20-FEB-81       1600        300         30
      7521 WARD       SALESMAN        7698 22-FEB-81       1250        500         30
      7566 JONES      MANAGER         7839 02-APR-81       2975                    20
      7698 BLAKE      MANAGER         7839 01-MAY-81       2850                    30
编写 SQL 的一些提示:
- SQL 语句不区分大小写
- 将子句分别写在独立行上可提高可读性
- SQL 语句可以写在一行或多行
您还可以对日期和数值数据使用 +、-、/、* 运算符创建表达式以生成所需数据。例如,要求计算所有员工薪资的 20%。查询如下:
SELECT ename, sal*(20/100)
FROM employee;
Output:

    ENAME      SAL*(20/100)
   ---------- ------------
    SMITH               160
    ALLEN               320
    WARD                250
    JONES               595
    BLAKE               570
信息:
- 使用括号以明确表达式
- 除法与乘法优先于加法与减法
- 当优先级相同时,表达式按从左到右求值
数据库对 NULL 值的处理不同。NULL 表示未知值。任何与 NULL 的运算结果都是 NULL。不同数据库处理 NULL 的函数不同。但在 MySQL、Microsoft SQL Server 和 Oracle 中有一个通用函数可用于处理 NULL。
SELECT ename, sal+COALESCE(comm,0)
FROM employee;
Output:

    ENAME      SAL+COALESCE(COMM,0)
---------- --------------------
    SMITH                       800
    ALLEN                      1900
    WARD                       1750
    JONES                      2975
    BLAKE                      2850
列别名与拼接
您可以看到上述输出中,列名与所选的数据库字段或表达式相同。有时在生成报告时,您希望为表头自定义名称。这可以通过别名实现。
SELECT ename AS "Emp Name", sal*(20/100) as "20% of Salary"
FROM employee;
Output:

    Emp Name      20% of Salary
   ---------- ------------
    SMITH               160
    ALLEN               320
    WARD                250
    JONES               595
    BLAKE               570
当别名中包含空格时,必须使用双引号。否则,AS 后无需加双引号。有时也可省略 AS 关键字。
您可以通过拼接来格式化输出。您可以使用 CONCAT 函数或根据数据库不同使用 || 或 + 运算符,将自定义文本加入输出:
- Oracle 支持 CONCAT() 和 ||,但 CONCAT() 仅接受两个参数,需使用嵌套 CONCAT()。
- MySQL 使用 CONCAT()
- Microsoft SQL Server 使用“+”运算符和 CONCAT()。
Oracle:SELECT '20% of salary of '||ename||' is '||sal*(20/100) as "20% of salary" FROM employee;
SELECT CONCAT(CONCAT('20% of salary of',ename),CONCAT(' is ',sal(20/100))) as "20% of salary" FROM employee; MySQL 与 Microsoft SQL Server:SELECT CONCAT('20% of salary of ',ename,' is ',sal(20/100)) as "20% of salary" FROM employee; 以上将得到相同的输出:
    20% of salary
-----------------------------------------------------------------------
    20% of salary of SMITH is 160
    20% of salary of ALLEN is 320
    20% of salary of WARD is 250
    20% of salary of JONES is 595
    20% of salary of BLAKE is 570
使用 DISTINCT 消除重复行
SELECT deptno
FROM employee;
Above query will result in:


    DEPTNO
----------
        20
        30
        30
        20
        30
这里 deptno 为 20 与 30 的行重复。您可以在 SELECT 子句中使用 DISTINCT 关键字消除此类行。
SELECT distinct ename, deptno, job
FROM employee;


    DEPTNO
----------
        30
        20
限制与排序数据
WHERE 子句用于基于某些条件筛选数据。
查找职位为 CLERK 的所有员工:
SELECT ename, job
FROM employee
WHERE job='CLERK';
    ENAME      JOB
---------- ---------
    SMITH      CLERK
您可能希望按不同条件筛选结果。为此会用到运算符、条件符号和特定关键字:
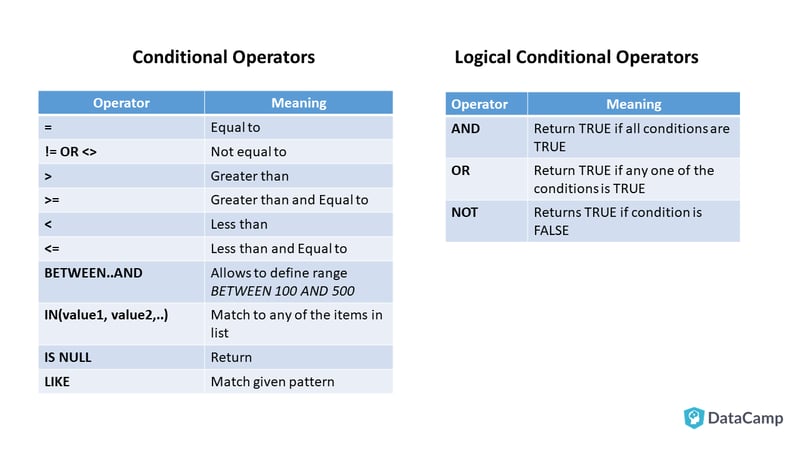
=、<>、!=、>=、<=、>、< 的用法很简单,如上例使用 = 所示。
AND 与 OR 语法:SELECT column1, column2,.. FROM table_name WHERE condition1 AND condition2 AND condition 3...;
SELECT column1, column2,.. FROM table_name WHERE condition1 OR condition2 OR condition 3...; 查找职位为 MANAGER 且属于 30 部门的员工姓名:
SELECT ename
FROM employee
WHERE job='MANAGER' AND deptno=30;
    ENAME
    ----------
    BLAKE
SELECT ename
FROM employee
WHERE job='MANAGER' OR deptno=30;
    ENAME
    ----------
    ALLEN
    WARD
    JONES
    BLAKE
NOT 语法:SELECT column1, column2, ... FROM table_name WHERE NOT condition; 查找职位不是 SALESMAN 的所有员工:
SELECT ename, job
from employee
WHERE NOT job='SALESMAN';
    ENAME      JOB
    ---------- ---------
    SMITH      CLERK
    JONES      MANAGER
    BLAKE      MANAGER
您可以使用 AND、OR 与 NOT 组合构建复杂条件。其优先级为:
- NOT
- AND
- OR
查找职位不是 CLERK 且属于 20 部门的所有员工:
SELECT ename, job
from employee
WHERE NOT job='SALESMAN' AND sal>800;
    ENAME      JOB
    ---------- ---------
    JONES      MANAGER
    BLAKE      MANAGER
这里首先执行 NOT,然后再计算 AND。
其他常用条件运算符如下:
BETWEEN...AND:
SELECT *
FROM employee
WHERE sal BETWEEN 1000 AND 2000;
     EMPNO ENAME      JOB              MGR HIREDATE         SAL       COMM     DEPTNO
---------- ---------- --------- ---------- --------- ---------- ---------- ----------
      7499 ALLEN      SALESMAN        7698 20-FEB-81       1600        300         30
      7521 WARD       SALESMAN        7698 22-FEB-81       1250        500         30
LIKE:
LIKE 使用两个通配符:百分号 % 与下划线 _,用于表示模式中的字符数量。
- % 表示任意数量(零个、一个或多个)字符
- %M%:匹配任意位置包含 M 的字符串
- M%:匹配以 M 开头的值
- %M:匹配以 M 结尾的值
- M%A:以 M 开头、以 A 结尾
注意模式大小写敏感。
- _ 指定已知字符前后未知字符的数量。一个下划线代表一个字符。
获取所有以“B”开头的员工姓名:
SELECT *
FROM employee
WHERE ename LIKE 'B%';

     EMPNO ENAME      JOB              MGR HIREDATE         SAL       COMM     DEPTNO
---------- ---------- --------- ---------- --------- ---------- ---------- ----------
      7698 BLAKE      MANAGER         7839 01-MAY-81       2850                    30
获取所有以“A”开头且在“A”之后任意位置包含“E”的员工姓名:
SELECT *
FROM employee
WHERE ename LIKE 'A%E%';

        EMPNO ENAME      JOB              MGR HIREDATE         SAL       COMM     DEPTNO
---------- ---------- --------- ---------- --------- ---------- ---------- ----------
      7499 ALLEN      SALESMAN        7698 20-FEB-81       1600        300         30
IN(value1,value2, value3,..):
IN() 函数可接受一个、两个或多个值,允许您在 WHERE 子句中将列与括号内给定的值进行匹配:
SELECT ename, job, hiredate
FROM employee
WHERE job IN ('CLERK','SALESMAN');
    ENAME      JOB       HIREDATE
    ---------- --------- ---------
    SMITH      CLERK     17-DEC-80
    ALLEN      SALESMAN  20-FEB-81
    WARD       SALESMAN  22-FEB-81
您也可以在 IN() 中使用返回若干值的 SELECT 语句。例如:
SELECT ename, job, hiredate
FROM employee
WHERE deptno IN (select deptno FROM department WHERE loc='CHICAGO');
    ENAME      JOB       HIREDATE
    ---------- --------- ---------
    ALLEN      SALESMAN  20-FEB-81
    WARD       SALESMAN  22-FEB-81
    BLAKE      MANAGER   01-MAY-81
IN() 中的 SELECT 也称为子查询。稍后您将进一步学习子查询!
IS NULL:
IS NULL 用于检查某个属性中的 NULL 值。例如,查找没有提成的所有员工:
SELECT ename, job, sal
FROM employee
WHERE comm IS NULL;
    ENAME      JOB              SAL
    ---------- --------- ----------
    SMITH      CLERK            800
    JONES      MANAGER         2975
    BLAKE      MANAGER         2850
如果要获取有提成的员工姓名,使用 IS NOT NULL:
SELECT ename, job, sal, comm
FROM employee
WHERE comm IS NOT NULL;
    ENAME      JOB              SAL       COMM
    ---------- --------- ---------- ----------
    ALLEN      SALESMAN        1600        300
    WARD       SALESMAN        1250        500
若要基于日期列筛选结果,必须使用默认日期格式。若需使用其他格式,需要应用日期函数,稍后会讲到。查找 1981 年 2 月 21 日之后入职的所有员工:
(此处使用 Oracle 默认日期格式)
SELECT ename, job, sal, comm
FROM employee
WHERE hiredate>'21-FEB-81';
    ENAME      JOB              SAL       COMM
    ---------- --------- ---------- ----------
    WARD       SALESMAN        1250        500
    JONES      MANAGER         2975
    BLAKE      MANAGER         2850
可以使用上述所有运算符的组合构建复杂条件,但需注意优先级。优先级是运算符求值的顺序。以下是不同数据库的优先级规则:
有两个有用的函数:ANY()、ALL(),可用于条件中。例如:
SELECT ename, job, sal, comm
FROM employee
WHERE deptno=ANY(SELECT deptno from dept WHERE loc='NEW YORK');
SELECT ename, job, sal, comm
FROM employee
WHERE deptno=ALL(SELECT deptno from dept WHERE dname='SALES');
注意上例中对子查询的使用。稍后您将进一步学习子查询。
使用 ORDER BY 子句对结果排序
您可以按任意一个或多个属性对结果进行升序(ASC)或降序(DESC)排序。也可以按您在 SELECT 子句中指定的别名进行排序:
SELECT ename, job, sal, comm
FROM employee
WHERE hiredate>'21-FEB-81'
ORDER BY sal desc;
    ENAME      JOB              SAL       COMM
    ---------- --------- ---------- ----------
    JONES      MANAGER         2975
    BLAKE      MANAGER         2850
    WARD       SALESMAN        1250        500
注意:默认排序为升序,记作 ASC,一般无需显式指定 ASC。
SELECT ename, job, sal, comm
FROM employee
WHERE hiredate>'21-FEB-81'
ORDER BY sal;
    ENAME      JOB              SAL       COMM
    ---------- --------- ---------- ----------
    WARD       SALESMAN        1250        500
    BLAKE      MANAGER         2850
    JONES      MANAGER         2975
您可以在 ORDER BY 子句中指定多个列,按指定顺序依次排序。例如,先按部门号升序,再按姓名降序排序员工:
SELECT ename, job, sal, comm, deptno
FROM employee
WHERE hiredate>'21-FEB-81'
ORDER BY deptno ASC, ename DESC;
    ENAME      JOB              SAL       COMM     DEPTNO
    ---------- --------- ---------- ---------- ----------
    JONES      MANAGER         2975                    20
    WARD       SALESMAN        1250        500         30
    BLAKE      MANAGER         2850                    30
使用单行函数定制输出
各类 RDBMS 中都有大量函数,帮助您完成常见任务,如获取字符串长度、拼接字符串、格式化、数学函数等。SQL 中的行函数分为两类:
单行函数:
这些函数逐行应用,对每一行返回一个结果。CONCAT() 是字符处理的单行函数。它们可用于 SELECT、WHERE 与 ORDER BY 子句。在所有 RDBMS 中,单行函数大致涵盖:
不同数据库对相同功能可能采用不同的函数名。这里我将介绍 Microsoft SQL Server、Oracle 与 MySQL 中通用且实用的函数。部分已在前文出现。本节末将提供这些供应商的完整函数列表链接,供进一步练习。
让我们逐类来看:
字符处理函数
LOWER():将字符串转换为小写。
SELECT lower(ename) as ename
FROM employee;
    ENAME
    ----------
    smith
    allen
    ward
    jones
    blake
UPPER():将字符串转换为大写。
SELECT upper(ename) as ename
FROM employee;
    ENAME
    ----------
    SMITH
    ALLEN
    WARD
    JONES
    BLAKE
SUBSTR()[Oracle, MySQL]:按指定返回子串 SUBSTR(string, start-position,length)
SUBSTRING()[SQL Server]:按指定返回子串 SUBSTRING(string, start-position,length)。
SELECT SUBSTR(ename,2,3) as substr_ename
FROM employee;
在 SQL Server 中只需将函数名替换为 SUBSTRING。
SUBSTR_ENAME
------------
MIT
LLE
ARD
ONE
LAK
LENGTH()[Oracle, MySQL]:返回括号内字符串的长度
LEN()[SQL Server]:返回括号内字符串的长度
SELECT LENGTH(ename) as len_ename
FROM employee;
在 SQL Server 中只需将函数名替换为 LEN。
     LEN_ENAME
    ----------
             5
             5
             4
             5
             5
诸如左/右侧填充、替换起始位置等函数在不同数据库中的语法有所差异。三大供应商数据库的字符与字符串函数列表:
数值函数
| Function name | Function |
|---|
| ROUND(m,n): | 将值 m 四舍五入到指定位数 n。 |
| ABS(m,n): | 返回数值的绝对值 |
| FLOOR(n): | 返回小于或等于 n 的最大整数。 |
| MOD(m,n): | 返回 m 除以 n 的余数(SQL Server 无此函数,但可用 % 运算符:35 % 6) |
Oracle:
    SELECT ROUND(45.926,2),MOD(11,5),FLOOR(34.4),ABS(-24) from dual;

OUTPUT:

    ROUND(45.926,2)  MOD(11,5) FLOOR(34.4)   ABS(-24)
--------------- ---------- ----------- ----------
          45.93          1          34         24
MySQL:
SELECT ROUND(45.926,2),MOD(11,5),FLOOR(34.4),ABS(-24);
SQL Server:
SELECT ROUND(45.926,2) as round,11%5 as mod, FLOOR(34.4) as floor,ABS(-24) as abs;
三大供应商数据库的数值函数列表:
转换函数
转换函数用于在数据类型之间转换。不同服务器的转换函数各不相同。这里以 Oracle 服务器的 to_char 函数为例,帮助您理解如何利用转换函数定制输出。Oracle 的默认日期格式为 DD-MON-YY
SELECT ename, to_char(hiredate,'DD, MONTH YYYY') as Hiredate, to_char(hiredate,'DY') as Day
from employee;
    ENAME      Hiredate                                     DAY
    ---------- -------------------------------------------- ------------
    SMITH      17,DECEMBER  1980                            WED
    ALLEN      20,FEBRUARY  1981                            FRI
    WARD       22,FEBRUARY  1981                            SUN
    JONES      02,APRIL     1981                            THU
    BLAKE      01,MAY       1981                            FRI
各数据库服务器都有大量转换函数。想要进一步阅读与探索,请参阅以下链接:
日期与时间函数
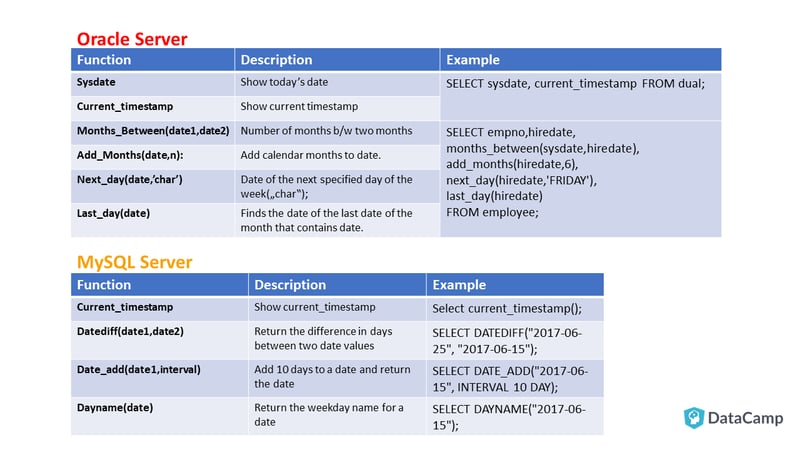
日期与时间函数允许您对日期进行操作,如加天数、计算两日期之间的月份数等。这类函数在生成报告时非常有用。不同数据库的日期函数也有所不同。同一功能在另一数据库中可能有不同的名称。这里先看几个示例,然后我会提供最常见的三种数据库(Oracle、SQL Server 和 MySQL)的日期函数链接。请在您的数据库服务器上试试这些示例!
对 SQL 结果分组
分组函数或多行函数作用于分组,并对每个分组返回一个结果。当您想要统计每季度销售总额、某段时间内产品平均价格、本月公司获得的最高投资额等信息时,就需要用到分组函数。
使用分组函数报告汇总数据
GROUP BY 子句用于分组结果,常与 COUNT、MAX、MIN、AVG 和 SUM 等函数搭配使用。GROUP BY 的语法为:
SELECT column_name(s)
FROM table_name
WHERE condition
GROUP BY column_name(s)
HAVING condition
ORDER BY column_name(s);
使用 GROUP BY 需注意以下几点:
- 别名不能用于 GROUP BY 子句
- WHERE 子句总是在 GROUP BY 之前
- HAVING 子句在 GROUP BY 之后,用于对分组函数施加条件
- ORDER BY 子句总是最后出现
COUNT 是一种分组函数,用于统计满足条件或无条件时的数据行数。COUNT 会忽略 NULL 值。
统计姓名以“A”开头的员工数量:
SELECT count(ename)
FROM employee
WHERE ename LIKE 'A%';

Output:

COUNT(ENAME)
------------
           1
查询 employee 表中的总薪资、平均薪资、最低薪资与最高薪资:
SELECT sum(sal) as "TOTAL SAL", avg(sal) as "AVG SAL", min(sal) as "MIN SAL", max(sal) as "MAX SAL"
FROM employee;

     TOTAL SAL    AVG SAL    MIN SAL    MAX SAL
    ---------- ---------- ---------- ----------
      9475       1895        800       2975
您可能希望按部门对上述结果进行分组:
SELECT sum(sal) as "TOTAL SAL", avg(sal) as "AVG SAL", min(sal) as "MIN SAL", max(sal) as "MAX SAL", deptno
FROM employee
GROUP BY deptno;
     TOTAL SAL    AVG SAL    MIN SAL    MAX SAL     DEPTNO
    ---------- ---------- ---------- ---------- ----------
      5700       1900       1250       2850         30
      3775     1887.5        800       2975         20
您还可以使用以下函数计算方差与标准差:
| For Oracle and MySQL | MS SQL SERVER |
|---|
| SELECT STDDEV(column_name) FROM table_name; | SELECT STDEV(column_name) FROM table_name; |
| SELECT VARIANCE(column_name) FROM table_name; | SELECT VAR(column_name) FROM table_name; |
您可以按多个列进行分组。
按每个部门内的每种职位汇总薪资:
SELECT sum(sal) as "TOTAL SAL", deptno, job
FROM employee
GROUP BY deptno, job;

     TOTAL SAL     DEPTNO   JOB
    ---------- ---------- ---------
       800         20       CLERK
      2850         30       SALESMAN
      2975         20       MANAGER
      2850         30       MANAGER
您可以使用 HAVING 子句限制分组结果。它仅用于分组条件。
注意:不要使用 WHERE 对分组函数施加条件。
SELECT sum(sal) as "TOTAL SAL", deptno, job
FROM employee
GROUP BY deptno, job
HAVING sum(sal)>1000
ORDER BY sum(sal);
    TOTAL SAL     DEPTNO    JOB
    ---------- ---------- ---------
      2850         30       SALESMAN
      2850         30       MANAGER
      2975         20       MANAGER
显示来自多表的数据
本节将讨论以下连接:
- 笛卡儿积/交叉连接
- 内连接/等值连接
- 自然连接
- 外连接(左、右、全)
- 自连接
您可能需要生成跨多张表取数的报表。请看下面的示例:
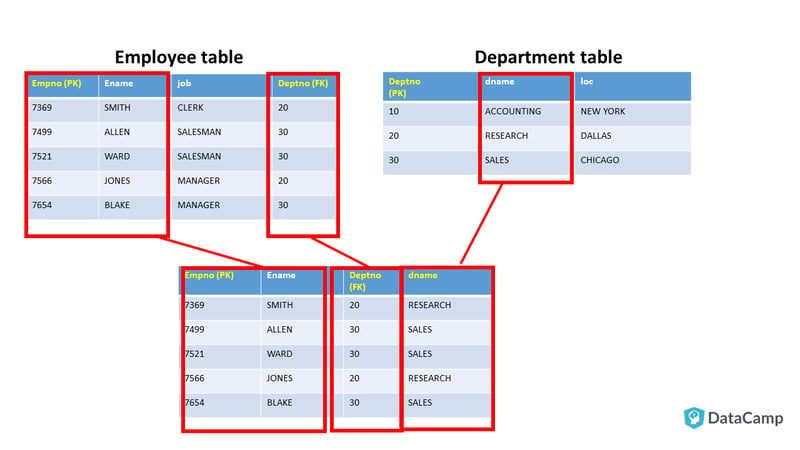
要生成如上报表,您需要将员工表与部门表关联,并从两者取数。为此,SQL 中使用连接(Join)。
笛卡儿积/交叉连接:
当关系 R 的每个元组与关系 S 的每个元组组合时,即形成笛卡儿积。
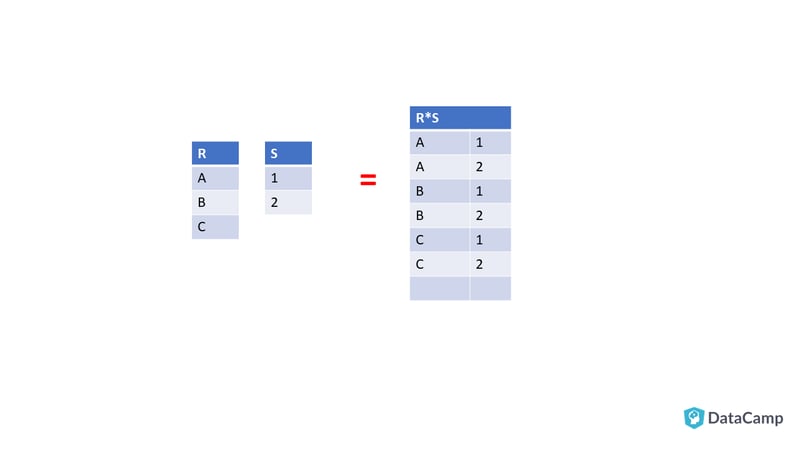
笛卡儿积操作也称交叉连接(Cross Join),将两张表相乘,形成包含两表所有可能元组对的关系。若关系 R 含 I 个元组、M 个属性,关系 S 含 J 个元组、N 个属性,则笛卡儿积含 I×J 个元组、M+N 个属性。也可使用符合 SQL 标准的 CROSS JOIN 形成笛卡儿积。
SELECT empno, ename, dname
FROM employee, department;

OR

SELECT empno, ename, dname
FROM employee CROSS JOIN department;
       EMPNO      ENAME      DNAME
    ---------- ---------- --------------
      7369        SMITH      ACCOUNTING
      7499        ALLEN      ACCOUNTING
      7521        WARD       ACCOUNTING
      7566        JONES      ACCOUNTING
      7698        BLAKE      ACCOUNTING
      7369        SMITH      RESEARCH
      7499        ALLEN      RESEARCH
      7521        WARD       RESEARCH
      7566        JONES      RESEARCH
      7698        BLAKE      RESEARCH
      7369        SMITH      SALES

     EMPNO        ENAME      DNAME
    ---------- ---------- --------------
      7499        ALLEN      SALES
      7521        WARD       SALES
      7566        JONES      SALES
      7698        BLAKE      SALES
共选出 15 行。
由于 employee 表有 5 个元组、department 表有 3 个元组,笛卡儿积共有 5×3=15 行。以下情况会生成笛卡儿积:
当需要从两个或更多表取数时,应使用参与表的共同属性(最常见为主键与外键)构造连接条件。
笛卡儿积可用于模拟大量数据以进行测试。
*内连接/等值连接:
内连接或等值连接(Oracle 开发者常用术语)使用主键与外键关系来连接两张或多张表:
SELECT ename, dname
FROM employee e,department d
WHERE e.deptno=d.deptno;

OR

SELECT ename, dname
FROM employee e
JOIN department d
ON e.deptno=d.deptno;

    ENAME      DNAME
    ---------- --------------
    SMITH      RESEARCH
    ALLEN      SALES
    WARD       SALES
    JONES      RESEARCH
    BLAKE      SALES
在上述查询中,deptno 是 department 表的主键、employee 表的外键。您可以按前文所述,使用逻辑运算添加附加条件。
关于连接(JOIN)的注意事项:
- 如果同名列出现在多张表中,必须使用表名作为列前缀。即便不重名,为了清晰起见,这也是一种良好实践。
- 要连接 n 张表,至少需要 n-1 个连接条件。例如,连接四张表,至少需要三个连接。
表别名:在 FROM employee e, department d 这样的语句中,会使用表别名 e 和 d,便于数据库引擎识别列来自哪张表,尤其是在多个参与的表中存在同名列时,否则会报“列不明确”的错误。此外,使用别名还能避免一遍遍书写冗长的表名,节省时间。
您也可以创建非等值连接(nonequi-join),即基于非等于条件进行的连接。再看另一张表 salgrade,其中包含基于工资确定员工等级的信息:
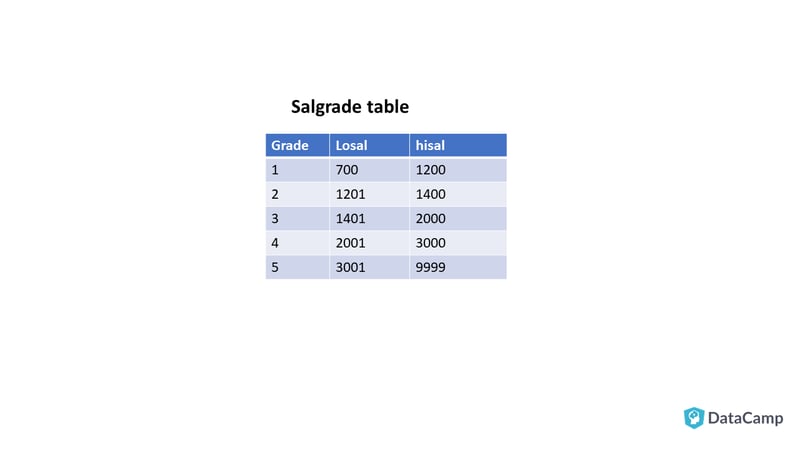
您希望根据工资找出每位员工的等级,其中等级存储在 salgrade 表,工资存储在 employee 表:
SELECT e.ename, e.sal, s.grade
FROM employee e, salgrade s
WHERE e.sal between s.losal AND s.hisal;
    ENAME             SAL      GRADE
    ---------- ---------- ----------
    JONES            2975          4
    BLAKE            2850          4
    ALLEN            1600          3
    WARD             1250          2
    SMITH             800          1
示例:现在需要给出员工姓名、工资、等级以及部门名称。如您所知,工资在 employee 表,等级在 salgrade 表,部门名称在 department 表,因此需要将三张表连接起来:
SELECT e.ename, e.sal, d.dname, s.grade
FROM employee e, department d, salgrade s
WHERE e.deptno=d.deptno
AND e.sal BETWEEN s.losal AND s.hisal;

Output:
ENAME             SAL DNAME               GRADE
---------- ---------- -------------- ----------
JONES            2975 RESEARCH                4
BLAKE            2850 SALES                   4
ALLEN            1600 SALES                   3
WARD             1250 SALES                   2
SMITH             800 RESEARCH                1
在上述示例中,涉及三张表并有两个连接条件,其中一个为非等值连接。
自然连接(Natural Join):
自然连接允许数据库通过匹配同名列自动连接表。如果同名列的数据类型不同,则会报错。
语法:SELECT FROM table1 NATURAL JOIN table2; SELECT FROM employee NATURAL JOIN department; 由于自然连接会自动寻找匹配列,可能会找到多个同名列但数据类型不同,从而导致错误。因此可以使用 USING 子句来指定进行等值连接的列。
注意:NATURAL JOIN 和 USING 是两个不同的子句,分别使用,互斥不可同时使用。
SELECT e.ename, d.dname, e.sal
FROM employee e JOIN department d
USING (deptno)
WHERE deptno=20;

output:

ENAME      DNAME                 SAL
---------- -------------- ----------
SMITH      RESEARCH              800
JONES      RESEARCH             2975
USING 子句中的列在 SQL 语句的任意位置都不能使用表名或表前缀。例如,下面的写法是不正确的:
SELECT e.ename, d.dname, e.sal
FROM employee e JOIN department d
USING (d.deptno)
WHERE d.deptno=20;
d.deptno 是不正确的,只应使用 deptno。外连接(Outer Joins):
外连接有三种:
- 左外连接(Left Outer Join):两表连接中,返回内连接结果以及左表中未匹配的行,称为 LEFT OUTER JOIN。
- 右外连接(Right Outer Join):两表连接中,返回内连接结果以及右表中未匹配的行,称为 RIGHT OUTER JOIN。
- 全外连接(Full Outer Join):两表连接中,返回内连接结果以及左右两表中未匹配的行,称为 FULL OUTER JOIN。
下面分别来看:
SELECT e.ename, s.grade
FROM salgrade s LEFT OUTER JOIN employee e
ON e.sal BETWEEN s.losal AND s.hisal;

Output:

ENAME          DEPTNO DNAME
---------- ---------- --------------
SMITH              20 RESEARCH
JONES              20 RESEARCH
ALLEN              30 SALES
WARD               30 SALES
BLAKE              30 SALES.sal BETWEEN s.losal AND s.hisal;

Output:

ENAME          DEPTNO DNAME
---------- ---------- --------------
SMITH              20 RESEARCH
JONES              20 RESEARCH
ALLEN              30 SALES
WARD               30 SALES
BLAKE              30 SALESSELECT e.ename, d.deptno, d.dname
FROM employee e RIGHT OUTER JOIN department d
ON e.deptno=d.deptno;

output:

ENAME          DEPTNO DNAME
---------- ---------- --------------
SMITH              20 RESEARCH
ALLEN              30 SALES
WARD               30 SALES
JONES              20 RESEARCH
BLAKE              30 SALES
                   10 ACCOUNTINGSELECT e.ename, d.deptno, d.dname
FROM employee e FULL OUTER JOIN department d
ON e.deptno=d.deptno;

Output:
ENAME          DEPTNO DNAME
---------- ---------- --------------
SMITH              20 RESEARCH
ALLEN              30 SALES
WARD               30 SALES
JONES              20 RESEARCH
BLAKE              30 SALES
                   10 ACCOUNTING
department 表中 deptno 为 10 的一行未匹配,而 employee 表中未发现未匹配的行。类似地,salgrade 对于等级 5 也有一行未匹配。
自连接(Self-Join):
有时您需要将一张表与其自身连接。例如,employee 表包含所有员工(包括经理)的信息(参见上文 employee 表)。如果要找出员工及其经理,就需要对表自身进行连接。自连接的写法如下:
SELECT e.ename as Employee, m.ename as Manager
FROM employee e, employee m
WHERE e.mgr=m.empno;
    EMPLOYEE   MANAGER
    ---------- ----------
    ALLEN      BLAKE
    WARD       BLAKE
使用子查询解决查询问题
子查询是查询中的查询。子查询有助于将大型查询拆分为若干部分。子查询可以嵌套,并可用于以下 SQL 子句中:
举个例子:您需要找出工资高于某个员工(例如 James)的员工。如何实现?可以将查询拆解为:
- 查找 James 的工资
- 将 James 的工资与所有员工比较
这可以用子查询来解决。子查询(内层查询)会在主查询(外层查询)之前执行一次。
SELECT empno, ename
FROM employee
WHERE sal>(SELECT sal from employee where ename='JAMES');
子查询类型:
注意事项:
- 将子查询用括号括起来。
- 将子查询放在比较运算符的右侧。
- 对单行子查询使用单行运算符(>, < , >= , <= , < >)。
- 对多行子查询使用多行运算符(IN、ANY、ALL)。
单行子查询:
查找职位与 empno 7521 相同的员工姓名
SELECT ename, job
FROM employee
WHERE job=(SELECT job FROM employee WHERE empno=7521);
    ENAME      JOB
    ---------- ---------
    ALLEN      SALESMAN
    WARD       SALESMAN
选择那些其部门最高工资大于等于20号部门最高工资的部门及其最高工资
SELECT deptno, max(sal)
FROM employee
GROUP BY deptno
HAVING max(sal)>=(SELECT max(sal) FROM employee WHERE deptno=20);
    DEPTNO   MAX(SAL)
---------- ----------
        20       2975
多行子查询:
查找工资等于任一“MANAGER”职位员工工资的员工。这是一个多行子查询,因为子查询可能返回多行。
SELECT ename, job, sal
FROM employee
WHERE sal IN (SELECT sal FROM employee WHERE job='MANAGER');
    ENAME      JOB              SAL
    ---------- --------- ----------
    JONES      MANAGER         2975
    BLAKE      MANAGER         2850
当在 FROM 子句中使用子查询时,它相当于一个临时表,不会实际存储在磁盘上,而是数据视图。例如:
SELECT e.ename, e.job, e.sal
FROM employee e, (SELECT deptno FROM department WHERE loc='DALLAS') d
WHERE e.deptno=d.deptno;
    ENAME      JOB              SAL
    ---------- --------- ----------
    SMITH      CLERK            800
    JONES      MANAGER         2975
使用集合运算符
在 SQL 中,集合运算符用于将多个查询的结果组合为一个结果集。它借鉴数学中的集合论及其操作,如 UNION、MINUS、INTERSECT。下面您将看到如何使用集合运算符优化查询。本教程将讨论以下集合运算符。
信息:使用集合运算符的查询称为复合语句。
- UNION 与 UNION ALL
- INTERSECT
- EXCEPT(SQL 标准)与 MINUS(Oracle 专有)
UNION
设有两个关系(表)R 与 S,UNION 会选取 R 的所有行与 S 的所有行,并去除重复。返回的行数最多为 r+s,其中 r 为 R 的行数,s 为 S 的行数。
选出所有部门名称,包括那些在 23-OCT-1999 之前聘用员工所属的部门名称
SELECT dname
FROM department
UNION
SELECT dname
FROM department, employee
WHERE department.deptno=employee.deptno AND employee.hiredate<to_date('23-OCT-1999');
    DNAME
    --------------
    ACCOUNTING
    OPERATIONS
    RESEARCH
    SALES
UNION 注意事项:
- 参与组合的各个 SELECT 语句中,被选取的列数与对应列的数据类型必须一致。
- 列名无需一致。
- 输出按第一个 SELECT 子句中的第一列升序排序。
- 在检查重复时不会忽略 NULL 值。
UNION ALL 将一个或多个查询的结果合并且不去重,因此不能使用 DISTINCT 关键字。再看另一张表 emp,包含 2000 年的员工。从 emp 与 employee 两表中获取所有员工编号、姓名和职位:
SELECT empno, ename, job
FROM employee
UNION ALL
SELECT empno, ename, job
FROM emp;
       EMPNO      ENAME      JOB
    ---------- ---------- ---------
      7369        SMITH      CLERK
      7499        ALLEN      SALESMAN
      7521        WARD       SALESMAN
      7566        JONES      MANAGER
      7698        BLAKE      MANAGER
      7369        SMITH      CLERK
      7499        ALLEN      SALESMAN
      7521        WARD       SALESMAN
      7566        JONES      MANAGER
      7654        MARTIN     SALESMAN
      7698        BLAKE      MANAGER

     EMPNO        ENAME      JOB
    ---------- ---------- ---------
      7782        CLARK      MANAGER
      7788        SCOTT      ANALYST
      7839        KING       PRESIDENT
      7844        TURNER     SALESMAN
      7876        ADAMS      CLERK
      7900        JAMES      CLERK
INTERSECT
交集与集合论一致,用于返回两个集合的共同元素。设两个关系 R 与 S,INTERSECT 将返回同时出现在 R 和 S 中的所有元组。
SELECT empno, ename, job
FROM employee
INTERSECT
SELECT empno, ename, job
FROM emp;
     EMPNO ENAME      JOB
---------- ---------- ---------
      7369 SMITH      CLERK
      7499 ALLEN      SALESMAN
      7521 WARD       SALESMAN
      7566 JONES      MANAGER
      7698 BLAKE      MANAGER
INTERSECT 注意事项:
- 参与组合的各个 SELECT 语句中,被选取的列数与对应列的数据类型必须一致。
- 列名无需一致。
- INTERSECT 不会忽略 NULL 值。
EXCEPT 与 MINUS:
EXCEPT(用于 SQL Server)与 MINUS(Oracle 专有)功能相同:选取被第一个查询选中但不在第二个查询中的所有不重复行。为理解该运算符,请看下表:
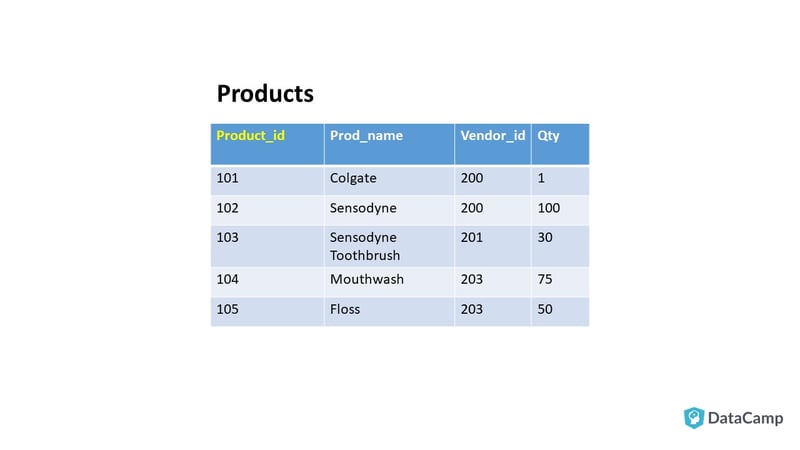
假设需要查找数量在 1 到 100 之间、但不包含 50–75 的产品。在 SQL Server 中使用 EXCEPT,在 Oracle 中使用 MINUS。
SELECT prod_name, qty
FROM products
WHERE qty BETWEEN 1 AND 100
EXCEPT
SELECT prod_name, qty
FROM products
WHERE qty BETWEEN 50 AND 75;
对于 Oracle:
SELECT prod_name, qty
FROM products
WHERE qty BETWEEN 1 AND 100
MINUS
SELECT prod_name, qty
FROM products
WHERE qty BETWEEN 50 AND 75;

      PROD_NAME               QTY
    -------------       ----------
          COLGATE               1
          SENSODYNE             100
          SENSODYNE TOOTHBRUSH  30
EXCEPT/MINUS 注意事项:
- 参与组合的各个 SELECT 语句中,被选取的列数与对应列的数据类型必须一致。
- 列名无需一致。
- 对 MINUS 运算符而言,WHERE 子句中出现的所有列都必须出现在 SELECT 子句中。
恭喜!
本教程到此结束。在本教程中,您学习了大量有助于您在数据科学之路上掌握 SQL 的知识。SQL 用于从数据库生成报告。您已经学习了数据库与 SQL 的基础、常用数据类型、用于格式化报表的函数、用于汇总结果的聚合,以及如何根据需求从数据库中的不同表中获取数据的方法!本教程专为数据科学学习者设计,不仅有助于掌握关系型数据库,也能顺利过渡到 NoSQL 数据库,并在大数据学习中运用 SQL 技能。
如果您想进一步学习 SQL,请学习 DataCamp 的免费课程 Intro to SQL for Data Science。
参考资料
- https://docs.oracle.com/cd/B19306_01/server.102/b14200/operators005.htm
- https://en.wikipedia.org/wiki/Set_operations_(SQL)#EXCEPT_operator
- https://www.w3schools.com/sql/sql_datatypes.asp
- https://docs.oracle.com/cd/B28359_01/server.111/b28318/datatype.htm#CNCPT012


在本教程中,您将专注于适用于 Oracle、MySQL、Microsoft SQL Server 等所有数据库的 ANSI(美国国家标准学会)SQL!让我们从SQL(结构化查询语言)的简介以及数据科学家为何需要它开始。
SQL 与数据科学
在本教程的这一部分,您将了解为什么数据科学家应该学习 SQL。让我们看看 SQL 将如何助力您的数据科学职业生涯:
这里我将简要介绍 SQL 与数据库中的一些术语,帮助您更快上手编码!如果您已了解关系型数据库与 SQL 是什么,可以直接跳到代码。
SQL 与数据库简介
数据库是信息的有序集合。要管理数据库,我们需要数据库管理系统(DBMS)。DBMS 是一种程序,可根据请求在数据库中存储、检索和修改数据。
历年来数据库类型多种多样:层次型、网状型、关系型,以及如今的 NoSQL 数据库。关系型数据库是关系(二维表)的集合。
以下是 RDBMS 中常用术语:
您可以使用主键和外键关联多张表。关系型数据库中的每一行都由主键(PK)唯一标识。您可以通过外键(FK)引用另一张表。例如:
可以使用结构化查询语言(SQL)访问关系型数据库。每种数据库都会支持标准的 ANSI SQL,同时也会为某些操作提供自有语法。本文将讲解 ANSI SQL,以便您能在所有数据库上工作。ANSI SQL 可分为五个部分。这里我会全部列出,但仅讲与数据检索和 DML 相关的两部分:
市面上有多家 RDBMS 供应商。最常见、使用最广的包括:
那么,在哪里运行 SQL 查询?可能的场景包括:
如果您拥有登录数据库的凭据,您可以通过查询或使用 GUI(具体取决于数据库供应商)查看数据库对象。
就是这样!让我们开始学习 SQL……
SQL 数据类型
数据库中的每一列都有名称与数据类型,有时还会指定大小。由数据库开发人员根据需求与数据量设计数据库,并决定使用何种数据类型。
作为数据科学家,您需要熟悉数据类型,这将有助于您正确使用数据库函数并准确编写查询。数据库中每类列(如人名、文本、数字、存储在数据库中的图像等)都有相应的数据类型。
这里将向您展示 Oracle Server、SQL Server 和 MySQL Server 的基础数据类型:
延伸阅读:
SQL 与数据报表
本教程中使用的所有 SQL 基于以下示例数据库模式:
设有一个包含两张表的数据库,emp 表存放员工数据,dept 表存放部门数据。
emp 表包含员工编号(empno)、员工姓名(ename)、薪资(sal)、提成(comm)、职位名称(job)、经理编号(mgr)、入职日期(hiredate)和部门编号(deptno)。由于经理也是员工并拥有员工编号,mgr 来自某个职位为 "MANAGER" 的 empno。
dept 表包含部门编号(deptno)、部门名称(dname)以及部门所在地(loc)。
请注意,不同数据库的日期格式不同。这里的 DD-MON-YY 是 Oracle 数据库的默认日期格式。Microsoft SQL Server 和 MySQL 的默认格式是 YYYY-MM-DD。
您的数据库表可能不同,因此只需根据您的表名与属性名进行调整即可。在本教程中,您只会从数据库读取数据,不会写入、更新或创建新表和对象。因此无需担心任何数据丢失或变更!
在上述数据库模式中,您可以看到 emp 表为员工实体包含六个属性。dept 表为部门实体包含三个属性。
使用 SELECT 语句检索数据
SELECT 语句用于从数据库检索信息。使用 SELECT 语句,您可以进行以下操作:
1. 投影(Projection):您可以选择希望查询返回的表中列。可根据需要选择任意数量的列。
2. 选择(Selection):您可以选择希望查询返回的表中行。
您可以使用多种条件限制要查看的行。
3. 连接(Joining):您可以通过在不同表之间创建链接,将分散在不同表中的数据汇集在一起。
基本的 SELECT 语句允许您指定需要从哪张表中取哪些列。SELECT 子句指定列与表达式,FROM 子句指定取数的表。
例如,查询所有员工的姓名及其职位:SELECT ename, job FROM employee; 基于上文讨论的数据库模式,上述 SQL 将返回如下输出:
要选择表中的所有属性和所有行,使用 * 运算符:
SELECT * FROM employee; The output will be: EMPNO ENAME JOB MGR HIREDATE SAL COMM DEPTNO ---------- ---------- --------- ---------- --------- ---------- ---------- ---------- 7369 SMITH CLERK 7902 17-DEC-80 800 20 7499 ALLEN SALESMAN 7698 20-FEB-81 1600 300 30 7521 WARD SALESMAN 7698 22-FEB-81 1250 500 30 7566 JONES MANAGER 7839 02-APR-81 2975 20 7698 BLAKE MANAGER 7839 01-MAY-81 2850 30您还可以对日期和数值数据使用 +、-、/、* 运算符创建表达式以生成所需数据。例如,要求计算所有员工薪资的 20%。查询如下:
SELECT ename, sal*(20/100) FROM employee; Output: ENAME SAL*(20/100) ---------- ------------ SMITH 160 ALLEN 320 WARD 250 JONES 595 BLAKE 570数据库对 NULL 值的处理不同。NULL 表示未知值。任何与 NULL 的运算结果都是 NULL。不同数据库处理 NULL 的函数不同。但在 MySQL、Microsoft SQL Server 和 Oracle 中有一个通用函数可用于处理 NULL。
SELECT ename, sal+COALESCE(comm,0) FROM employee; Output: ENAME SAL+COALESCE(COMM,0) ---------- -------------------- SMITH 800 ALLEN 1900 WARD 1750 JONES 2975 BLAKE 2850列别名与拼接
您可以看到上述输出中,列名与所选的数据库字段或表达式相同。有时在生成报告时,您希望为表头自定义名称。这可以通过别名实现。
SELECT ename AS "Emp Name", sal*(20/100) as "20% of Salary" FROM employee; Output: Emp Name 20% of Salary ---------- ------------ SMITH 160 ALLEN 320 WARD 250 JONES 595 BLAKE 570当别名中包含空格时,必须使用双引号。否则,AS 后无需加双引号。有时也可省略 AS 关键字。
您可以通过拼接来格式化输出。您可以使用 CONCAT 函数或根据数据库不同使用 || 或 + 运算符,将自定义文本加入输出:
Oracle:SELECT '20% of salary of '||ename||' is '||sal*(20/100) as "20% of salary" FROM employee;
SELECT CONCAT(CONCAT('20% of salary of',ename),CONCAT(' is ',sal(20/100))) as "20% of salary" FROM employee; MySQL 与 Microsoft SQL Server:SELECT CONCAT('20% of salary of ',ename,' is ',sal(20/100)) as "20% of salary" FROM employee; 以上将得到相同的输出:
20% of salary ----------------------------------------------------------------------- 20% of salary of SMITH is 160 20% of salary of ALLEN is 320 20% of salary of WARD is 250 20% of salary of JONES is 595 20% of salary of BLAKE is 570使用 DISTINCT 消除重复行
SELECT deptno FROM employee; Above query will result in: DEPTNO ---------- 20 30 30 20 30这里 deptno 为 20 与 30 的行重复。您可以在 SELECT 子句中使用 DISTINCT 关键字消除此类行。
SELECT distinct ename, deptno, job FROM employee; DEPTNO ---------- 30 20限制与排序数据
WHERE 子句用于基于某些条件筛选数据。
查找职位为 CLERK 的所有员工:
SELECT ename, job FROM employee WHERE job='CLERK'; ENAME JOB ---------- --------- SMITH CLERK您可能希望按不同条件筛选结果。为此会用到运算符、条件符号和特定关键字:
=、<>、!=、>=、<=、>、< 的用法很简单,如上例使用 = 所示。
AND 与 OR 语法:SELECT column1, column2,.. FROM table_name WHERE condition1 AND condition2 AND condition 3...;
SELECT column1, column2,.. FROM table_name WHERE condition1 OR condition2 OR condition 3...; 查找职位为 MANAGER 且属于 30 部门的员工姓名:
SELECT ename FROM employee WHERE job='MANAGER' AND deptno=30; ENAME ---------- BLAKESELECT ename FROM employee WHERE job='MANAGER' OR deptno=30; ENAME ---------- ALLEN WARD JONES BLAKENOT 语法:SELECT column1, column2, ... FROM table_name WHERE NOT condition; 查找职位不是 SALESMAN 的所有员工:
SELECT ename, job from employee WHERE NOT job='SALESMAN'; ENAME JOB ---------- --------- SMITH CLERK JONES MANAGER BLAKE MANAGER您可以使用 AND、OR 与 NOT 组合构建复杂条件。其优先级为:
查找职位不是 CLERK 且属于 20 部门的所有员工:
SELECT ename, job from employee WHERE NOT job='SALESMAN' AND sal>800; ENAME JOB ---------- --------- JONES MANAGER BLAKE MANAGER这里首先执行 NOT,然后再计算 AND。
其他常用条件运算符如下:
BETWEEN...AND:
SELECT * FROM employee WHERE sal BETWEEN 1000 AND 2000; EMPNO ENAME JOB MGR HIREDATE SAL COMM DEPTNO ---------- ---------- --------- ---------- --------- ---------- ---------- ---------- 7499 ALLEN SALESMAN 7698 20-FEB-81 1600 300 30 7521 WARD SALESMAN 7698 22-FEB-81 1250 500 30LIKE:
LIKE 使用两个通配符:百分号 % 与下划线 _,用于表示模式中的字符数量。
注意模式大小写敏感。
获取所有以“B”开头的员工姓名:
SELECT * FROM employee WHERE ename LIKE 'B%'; EMPNO ENAME JOB MGR HIREDATE SAL COMM DEPTNO ---------- ---------- --------- ---------- --------- ---------- ---------- ---------- 7698 BLAKE MANAGER 7839 01-MAY-81 2850 30获取所有以“A”开头且在“A”之后任意位置包含“E”的员工姓名:
SELECT * FROM employee WHERE ename LIKE 'A%E%'; EMPNO ENAME JOB MGR HIREDATE SAL COMM DEPTNO ---------- ---------- --------- ---------- --------- ---------- ---------- ---------- 7499 ALLEN SALESMAN 7698 20-FEB-81 1600 300 30IN(value1,value2, value3,..):
IN() 函数可接受一个、两个或多个值,允许您在 WHERE 子句中将列与括号内给定的值进行匹配:
SELECT ename, job, hiredate FROM employee WHERE job IN ('CLERK','SALESMAN'); ENAME JOB HIREDATE ---------- --------- --------- SMITH CLERK 17-DEC-80 ALLEN SALESMAN 20-FEB-81 WARD SALESMAN 22-FEB-81您也可以在 IN() 中使用返回若干值的 SELECT 语句。例如:
SELECT ename, job, hiredate FROM employee WHERE deptno IN (select deptno FROM department WHERE loc='CHICAGO'); ENAME JOB HIREDATE ---------- --------- --------- ALLEN SALESMAN 20-FEB-81 WARD SALESMAN 22-FEB-81 BLAKE MANAGER 01-MAY-81IN() 中的 SELECT 也称为子查询。稍后您将进一步学习子查询!
IS NULL:
IS NULL 用于检查某个属性中的 NULL 值。例如,查找没有提成的所有员工:
SELECT ename, job, sal FROM employee WHERE comm IS NULL; ENAME JOB SAL ---------- --------- ---------- SMITH CLERK 800 JONES MANAGER 2975 BLAKE MANAGER 2850如果要获取有提成的员工姓名,使用 IS NOT NULL:
SELECT ename, job, sal, comm FROM employee WHERE comm IS NOT NULL; ENAME JOB SAL COMM ---------- --------- ---------- ---------- ALLEN SALESMAN 1600 300 WARD SALESMAN 1250 500若要基于日期列筛选结果,必须使用默认日期格式。若需使用其他格式,需要应用日期函数,稍后会讲到。查找 1981 年 2 月 21 日之后入职的所有员工:
(此处使用 Oracle 默认日期格式)
SELECT ename, job, sal, comm FROM employee WHERE hiredate>'21-FEB-81'; ENAME JOB SAL COMM ---------- --------- ---------- ---------- WARD SALESMAN 1250 500 JONES MANAGER 2975 BLAKE MANAGER 2850可以使用上述所有运算符的组合构建复杂条件,但需注意优先级。优先级是运算符求值的顺序。以下是不同数据库的优先级规则:
有两个有用的函数:ANY()、ALL(),可用于条件中。例如:
注意上例中对子查询的使用。稍后您将进一步学习子查询。
使用 ORDER BY 子句对结果排序
您可以按任意一个或多个属性对结果进行升序(ASC)或降序(DESC)排序。也可以按您在 SELECT 子句中指定的别名进行排序:
SELECT ename, job, sal, comm FROM employee WHERE hiredate>'21-FEB-81' ORDER BY sal desc; ENAME JOB SAL COMM ---------- --------- ---------- ---------- JONES MANAGER 2975 BLAKE MANAGER 2850 WARD SALESMAN 1250 500SELECT ename, job, sal, comm FROM employee WHERE hiredate>'21-FEB-81' ORDER BY sal; ENAME JOB SAL COMM ---------- --------- ---------- ---------- WARD SALESMAN 1250 500 BLAKE MANAGER 2850 JONES MANAGER 2975您可以在 ORDER BY 子句中指定多个列,按指定顺序依次排序。例如,先按部门号升序,再按姓名降序排序员工:
SELECT ename, job, sal, comm, deptno FROM employee WHERE hiredate>'21-FEB-81' ORDER BY deptno ASC, ename DESC; ENAME JOB SAL COMM DEPTNO ---------- --------- ---------- ---------- ---------- JONES MANAGER 2975 20 WARD SALESMAN 1250 500 30 BLAKE MANAGER 2850 30使用单行函数定制输出
各类 RDBMS 中都有大量函数,帮助您完成常见任务,如获取字符串长度、拼接字符串、格式化、数学函数等。SQL 中的行函数分为两类:
单行函数:
这些函数逐行应用,对每一行返回一个结果。CONCAT() 是字符处理的单行函数。它们可用于 SELECT、WHERE 与 ORDER BY 子句。在所有 RDBMS 中,单行函数大致涵盖:
不同数据库对相同功能可能采用不同的函数名。这里我将介绍 Microsoft SQL Server、Oracle 与 MySQL 中通用且实用的函数。部分已在前文出现。本节末将提供这些供应商的完整函数列表链接,供进一步练习。
让我们逐类来看:
字符处理函数
LOWER():将字符串转换为小写。
SELECT lower(ename) as ename FROM employee; ENAME ---------- smith allen ward jones blakeUPPER():将字符串转换为大写。
SELECT upper(ename) as ename FROM employee; ENAME ---------- SMITH ALLEN WARD JONES BLAKESUBSTR()[Oracle, MySQL]:按指定返回子串 SUBSTR(string, start-position,length)
SUBSTRING()[SQL Server]:按指定返回子串 SUBSTRING(string, start-position,length)。
在 SQL Server 中只需将函数名替换为 SUBSTRING。
LENGTH()[Oracle, MySQL]:返回括号内字符串的长度
LEN()[SQL Server]:返回括号内字符串的长度
在 SQL Server 中只需将函数名替换为 LEN。
LEN_ENAME ---------- 5 5 4 5 5诸如左/右侧填充、替换起始位置等函数在不同数据库中的语法有所差异。三大供应商数据库的字符与字符串函数列表:
数值函数
Oracle:
SELECT ROUND(45.926,2),MOD(11,5),FLOOR(34.4),ABS(-24) from dual; OUTPUT: ROUND(45.926,2) MOD(11,5) FLOOR(34.4) ABS(-24) --------------- ---------- ----------- ---------- 45.93 1 34 24MySQL:
SQL Server:
三大供应商数据库的数值函数列表:
转换函数
转换函数用于在数据类型之间转换。不同服务器的转换函数各不相同。这里以 Oracle 服务器的 to_char 函数为例,帮助您理解如何利用转换函数定制输出。Oracle 的默认日期格式为 DD-MON-YY
SELECT ename, to_char(hiredate,'DD, MONTH YYYY') as Hiredate, to_char(hiredate,'DY') as Day from employee; ENAME Hiredate DAY ---------- -------------------------------------------- ------------ SMITH 17,DECEMBER 1980 WED ALLEN 20,FEBRUARY 1981 FRI WARD 22,FEBRUARY 1981 SUN JONES 02,APRIL 1981 THU BLAKE 01,MAY 1981 FRI各数据库服务器都有大量转换函数。想要进一步阅读与探索,请参阅以下链接:
日期与时间函数
日期与时间函数允许您对日期进行操作,如加天数、计算两日期之间的月份数等。这类函数在生成报告时非常有用。不同数据库的日期函数也有所不同。同一功能在另一数据库中可能有不同的名称。这里先看几个示例,然后我会提供最常见的三种数据库(Oracle、SQL Server 和 MySQL)的日期函数链接。请在您的数据库服务器上试试这些示例!
对 SQL 结果分组
分组函数或多行函数作用于分组,并对每个分组返回一个结果。当您想要统计每季度销售总额、某段时间内产品平均价格、本月公司获得的最高投资额等信息时,就需要用到分组函数。
使用分组函数报告汇总数据
GROUP BY 子句用于分组结果,常与 COUNT、MAX、MIN、AVG 和 SUM 等函数搭配使用。GROUP BY 的语法为:
使用 GROUP BY 需注意以下几点:
COUNT 是一种分组函数,用于统计满足条件或无条件时的数据行数。COUNT 会忽略 NULL 值。
统计姓名以“A”开头的员工数量:
SELECT count(ename) FROM employee WHERE ename LIKE 'A%'; Output: COUNT(ENAME) ------------ 1查询 employee 表中的总薪资、平均薪资、最低薪资与最高薪资:
SELECT sum(sal) as "TOTAL SAL", avg(sal) as "AVG SAL", min(sal) as "MIN SAL", max(sal) as "MAX SAL" FROM employee; TOTAL SAL AVG SAL MIN SAL MAX SAL ---------- ---------- ---------- ---------- 9475 1895 800 2975您可能希望按部门对上述结果进行分组:
SELECT sum(sal) as "TOTAL SAL", avg(sal) as "AVG SAL", min(sal) as "MIN SAL", max(sal) as "MAX SAL", deptno FROM employee GROUP BY deptno; TOTAL SAL AVG SAL MIN SAL MAX SAL DEPTNO ---------- ---------- ---------- ---------- ---------- 5700 1900 1250 2850 30 3775 1887.5 800 2975 20您还可以使用以下函数计算方差与标准差:
您可以按多个列进行分组。
按每个部门内的每种职位汇总薪资:
SELECT sum(sal) as "TOTAL SAL", deptno, job FROM employee GROUP BY deptno, job; TOTAL SAL DEPTNO JOB ---------- ---------- --------- 800 20 CLERK 2850 30 SALESMAN 2975 20 MANAGER 2850 30 MANAGER您可以使用 HAVING 子句限制分组结果。它仅用于分组条件。
SELECT sum(sal) as "TOTAL SAL", deptno, job FROM employee GROUP BY deptno, job HAVING sum(sal)>1000 ORDER BY sum(sal); TOTAL SAL DEPTNO JOB ---------- ---------- --------- 2850 30 SALESMAN 2850 30 MANAGER 2975 20 MANAGER显示来自多表的数据
本节将讨论以下连接:
您可能需要生成跨多张表取数的报表。请看下面的示例:
要生成如上报表,您需要将员工表与部门表关联,并从两者取数。为此,SQL 中使用连接(Join)。
笛卡儿积/交叉连接:
当关系 R 的每个元组与关系 S 的每个元组组合时,即形成笛卡儿积。
笛卡儿积操作也称交叉连接(Cross Join),将两张表相乘,形成包含两表所有可能元组对的关系。若关系 R 含 I 个元组、M 个属性,关系 S 含 J 个元组、N 个属性,则笛卡儿积含 I×J 个元组、M+N 个属性。也可使用符合 SQL 标准的 CROSS JOIN 形成笛卡儿积。
SELECT empno, ename, dname FROM employee, department; OR SELECT empno, ename, dname FROM employee CROSS JOIN department; EMPNO ENAME DNAME ---------- ---------- -------------- 7369 SMITH ACCOUNTING 7499 ALLEN ACCOUNTING 7521 WARD ACCOUNTING 7566 JONES ACCOUNTING 7698 BLAKE ACCOUNTING 7369 SMITH RESEARCH 7499 ALLEN RESEARCH 7521 WARD RESEARCH 7566 JONES RESEARCH 7698 BLAKE RESEARCH 7369 SMITH SALES EMPNO ENAME DNAME ---------- ---------- -------------- 7499 ALLEN SALES 7521 WARD SALES 7566 JONES SALES 7698 BLAKE SALES共选出 15 行。
由于 employee 表有 5 个元组、department 表有 3 个元组,笛卡儿积共有 5×3=15 行。以下情况会生成笛卡儿积:
当需要从两个或更多表取数时,应使用参与表的共同属性(最常见为主键与外键)构造连接条件。
笛卡儿积可用于模拟大量数据以进行测试。
*内连接/等值连接:
内连接或等值连接(Oracle 开发者常用术语)使用主键与外键关系来连接两张或多张表:
SELECT ename, dname FROM employee e,department d WHERE e.deptno=d.deptno; OR SELECT ename, dname FROM employee e JOIN department d ON e.deptno=d.deptno; ENAME DNAME ---------- -------------- SMITH RESEARCH ALLEN SALES WARD SALES JONES RESEARCH BLAKE SALES在上述查询中,deptno 是 department 表的主键、employee 表的外键。您可以按前文所述,使用逻辑运算添加附加条件。
表别名:在 FROM employee e, department d 这样的语句中,会使用表别名 e 和 d,便于数据库引擎识别列来自哪张表,尤其是在多个参与的表中存在同名列时,否则会报“列不明确”的错误。此外,使用别名还能避免一遍遍书写冗长的表名,节省时间。
您也可以创建非等值连接(nonequi-join),即基于非等于条件进行的连接。再看另一张表 salgrade,其中包含基于工资确定员工等级的信息:
您希望根据工资找出每位员工的等级,其中等级存储在 salgrade 表,工资存储在 employee 表:
SELECT e.ename, e.sal, s.grade FROM employee e, salgrade s WHERE e.sal between s.losal AND s.hisal; ENAME SAL GRADE ---------- ---------- ---------- JONES 2975 4 BLAKE 2850 4 ALLEN 1600 3 WARD 1250 2 SMITH 800 1示例:现在需要给出员工姓名、工资、等级以及部门名称。如您所知,工资在 employee 表,等级在 salgrade 表,部门名称在 department 表,因此需要将三张表连接起来:
在上述示例中,涉及三张表并有两个连接条件,其中一个为非等值连接。
自然连接(Natural Join):
自然连接允许数据库通过匹配同名列自动连接表。如果同名列的数据类型不同,则会报错。
语法:SELECT FROM table1 NATURAL JOIN table2; SELECT FROM employee NATURAL JOIN department; 由于自然连接会自动寻找匹配列,可能会找到多个同名列但数据类型不同,从而导致错误。因此可以使用 USING 子句来指定进行等值连接的列。
USING 子句中的列在 SQL 语句的任意位置都不能使用表名或表前缀。例如,下面的写法是不正确的:
d.deptno 是不正确的,只应使用 deptno。外连接(Outer Joins):
外连接有三种:
下面分别来看:
FROM employee e RIGHT OUTER JOIN department d ON e.deptno=d.deptno; output: ENAME DEPTNO DNAME ---------- ---------- -------------- SMITH 20 RESEARCH ALLEN 30 SALES WARD 30 SALES JONES 20 RESEARCH BLAKE 30 SALES 10 ACCOUNTINGSELECT e.ename, d.deptno, d.dnameFROM employee e FULL OUTER JOIN department d ON e.deptno=d.deptno; Output: ENAME DEPTNO DNAME ---------- ---------- -------------- SMITH 20 RESEARCH ALLEN 30 SALES WARD 30 SALES JONES 20 RESEARCH BLAKE 30 SALES 10 ACCOUNTINGdepartment 表中 deptno 为 10 的一行未匹配,而 employee 表中未发现未匹配的行。类似地,salgrade 对于等级 5 也有一行未匹配。
自连接(Self-Join):
有时您需要将一张表与其自身连接。例如,employee 表包含所有员工(包括经理)的信息(参见上文 employee 表)。如果要找出员工及其经理,就需要对表自身进行连接。自连接的写法如下:
SELECT e.ename as Employee, m.ename as Manager FROM employee e, employee m WHERE e.mgr=m.empno; EMPLOYEE MANAGER ---------- ---------- ALLEN BLAKE WARD BLAKE使用子查询解决查询问题
子查询是查询中的查询。子查询有助于将大型查询拆分为若干部分。子查询可以嵌套,并可用于以下 SQL 子句中:
举个例子:您需要找出工资高于某个员工(例如 James)的员工。如何实现?可以将查询拆解为:
这可以用子查询来解决。子查询(内层查询)会在主查询(外层查询)之前执行一次。
子查询类型:
单行子查询:内层 SELECT 语句仅返回一行的查询。
多行子查询:内层 SELECT 语句返回多行的查询。
单行子查询:
查找职位与 empno 7521 相同的员工姓名
SELECT ename, job FROM employee WHERE job=(SELECT job FROM employee WHERE empno=7521); ENAME JOB ---------- --------- ALLEN SALESMAN WARD SALESMAN选择那些其部门最高工资大于等于20号部门最高工资的部门及其最高工资
SELECT deptno, max(sal) FROM employee GROUP BY deptno HAVING max(sal)>=(SELECT max(sal) FROM employee WHERE deptno=20); DEPTNO MAX(SAL) ---------- ---------- 20 2975多行子查询:
查找工资等于任一“MANAGER”职位员工工资的员工。这是一个多行子查询,因为子查询可能返回多行。
SELECT ename, job, sal FROM employee WHERE sal IN (SELECT sal FROM employee WHERE job='MANAGER'); ENAME JOB SAL ---------- --------- ---------- JONES MANAGER 2975 BLAKE MANAGER 2850当在 FROM 子句中使用子查询时,它相当于一个临时表,不会实际存储在磁盘上,而是数据视图。例如:
SELECT e.ename, e.job, e.sal FROM employee e, (SELECT deptno FROM department WHERE loc='DALLAS') d WHERE e.deptno=d.deptno; ENAME JOB SAL ---------- --------- ---------- SMITH CLERK 800 JONES MANAGER 2975使用集合运算符
在 SQL 中,集合运算符用于将多个查询的结果组合为一个结果集。它借鉴数学中的集合论及其操作,如 UNION、MINUS、INTERSECT。下面您将看到如何使用集合运算符优化查询。本教程将讨论以下集合运算符。
UNION
设有两个关系(表)R 与 S,UNION 会选取 R 的所有行与 S 的所有行,并去除重复。返回的行数最多为 r+s,其中 r 为 R 的行数,s 为 S 的行数。
选出所有部门名称,包括那些在 23-OCT-1999 之前聘用员工所属的部门名称
SELECT dname FROM department UNION SELECT dname FROM department, employee WHERE department.deptno=employee.deptno AND employee.hiredate<to_date('23-OCT-1999'); DNAME -------------- ACCOUNTING OPERATIONS RESEARCH SALESUNION ALL 将一个或多个查询的结果合并且不去重,因此不能使用 DISTINCT 关键字。再看另一张表 emp,包含 2000 年的员工。从 emp 与 employee 两表中获取所有员工编号、姓名和职位:
SELECT empno, ename, job FROM employee UNION ALL SELECT empno, ename, job FROM emp; EMPNO ENAME JOB ---------- ---------- --------- 7369 SMITH CLERK 7499 ALLEN SALESMAN 7521 WARD SALESMAN 7566 JONES MANAGER 7698 BLAKE MANAGER 7369 SMITH CLERK 7499 ALLEN SALESMAN 7521 WARD SALESMAN 7566 JONES MANAGER 7654 MARTIN SALESMAN 7698 BLAKE MANAGER EMPNO ENAME JOB ---------- ---------- --------- 7782 CLARK MANAGER 7788 SCOTT ANALYST 7839 KING PRESIDENT 7844 TURNER SALESMAN 7876 ADAMS CLERK 7900 JAMES CLERKINTERSECT
交集与集合论一致,用于返回两个集合的共同元素。设两个关系 R 与 S,INTERSECT 将返回同时出现在 R 和 S 中的所有元组。
SELECT empno, ename, job FROM employee INTERSECT SELECT empno, ename, job FROM emp; EMPNO ENAME JOB ---------- ---------- --------- 7369 SMITH CLERK 7499 ALLEN SALESMAN 7521 WARD SALESMAN 7566 JONES MANAGER 7698 BLAKE MANAGEREXCEPT 与 MINUS:
EXCEPT(用于 SQL Server)与 MINUS(Oracle 专有)功能相同:选取被第一个查询选中但不在第二个查询中的所有不重复行。为理解该运算符,请看下表:
假设需要查找数量在 1 到 100 之间、但不包含 50–75 的产品。在 SQL Server 中使用 EXCEPT,在 Oracle 中使用 MINUS。
对于 Oracle:
SELECT prod_name, qty FROM products WHERE qty BETWEEN 1 AND 100 MINUS SELECT prod_name, qty FROM products WHERE qty BETWEEN 50 AND 75; PROD_NAME QTY ------------- ---------- COLGATE 1 SENSODYNE 100 SENSODYNE TOOTHBRUSH 30恭喜!
本教程到此结束。在本教程中,您学习了大量有助于您在数据科学之路上掌握 SQL 的知识。SQL 用于从数据库生成报告。您已经学习了数据库与 SQL 的基础、常用数据类型、用于格式化报表的函数、用于汇总结果的聚合,以及如何根据需求从数据库中的不同表中获取数据的方法!本教程专为数据科学学习者设计,不仅有助于掌握关系型数据库,也能顺利过渡到 NoSQL 数据库,并在大数据学习中运用 SQL 技能。
如果您想进一步学习 SQL,请学习 DataCamp 的免费课程 Intro to SQL for Data Science。
参考资料