

课程
Python for Developers 入门
3 小时
183.9K
实践并学习路径你的进步。
使用 Google 继续您是否遇到过这种情况:一个运行时间很长的 Python 脚本让您一直猜测屏幕后面到底有没有在执行?
对进度的不确定性可能会让您在快要完成时中断运行,或者对一个其实早已被中断的脚本无限等待。
tqdm Python 库通过为脚本提供进度指示器,解决了这个问题。
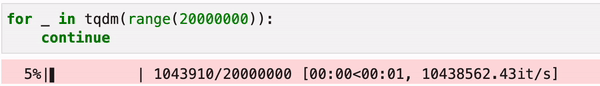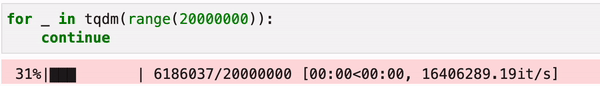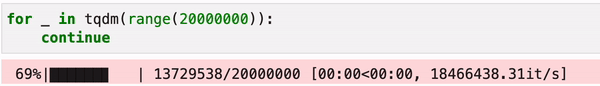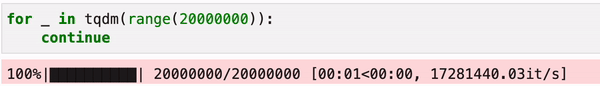
Tqdm 是一个 Python 库,为循环 和可迭代对象提供快速、可扩展的进度条。它能以简单的方式跟踪耗时任务的推进情况。
该库的名称在阿拉伯语中意为“进步”(taqadum,تقدّم),也是西班牙语中“I love you so much”(te quiero demasiado)的缩写。
Tdqm 通过计数迭代次数、计算已用时间和剩余时间,并在条形填充中可视化整体进度,以跟踪并更新进度条显示。
它使用智能算法预测剩余时间,并跳过不必要的迭代显示以尽量减少开销。使用 tqdm 具有多项优势,包括:
tqdm 可在任何平台(Linux、Windows、Mac、FreeBSD、NetBSD、SunOS)、任意控制台或 GUI 中运行。Tqdm 可与 Jupyter Notebook、常用库如Pandas,以及循环等常见 Python 结构无缝结合。与大多数 Python 库一样,安装 tqdm 最简单的方法是使用 pip 包管理器。
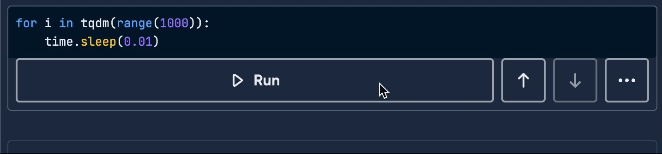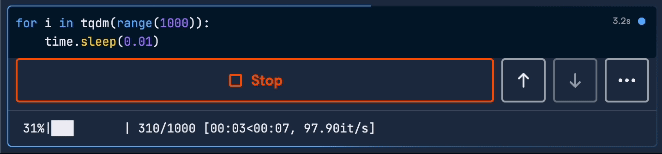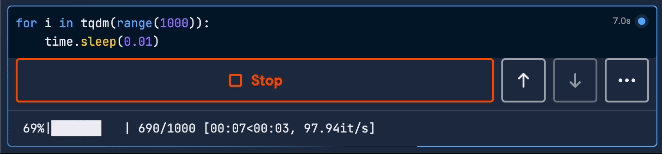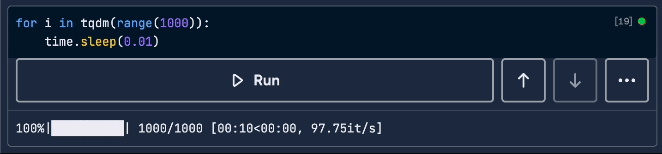
pip install tqdm要创建进度条,我们用 tqdm() 函数(从 tqdm 模块导入)包装可迭代对象。来看一个简单示例。函数 time.sleep(0.01) 用作占位,代表每次迭代中应运行的代码。
from tqdm import tqdm
    for i in tqdm(range(1000)):
    time.sleep(0.01)
    # …
作为 tdqm(range(n)) 的速记,您也可以使用 trange(n)。以下代码将返回与上一个示例完全相同的输出:
from tqdm import tqdm
    for i in trange(1000):
	time.sleep(0.01)
	# …
两个示例都会返回与上图类似的进度条。
仔细观察进度条,看看它提供了哪些信息。我们来分解一下 tqdm 展示的细节:
Tqdm 提供多种自定义选项来调整进度条的外观和行为。我们先来看最重要的参数,然后再探讨 tqdm 的高级用法。
常见的定制之一是使用 desc 参数添加描述性标签,使进度条更具信息量,也更便于区分不同的可迭代对象。
例如,添加参数 desc=”Processing large range” 会在进度条左侧显示标题“Processing large range”。
for _ in tqdm(range(20000000), desc="Processing large range"):
	continue
建议您在自己的环境中分别带和不带 desc 参数运行上述代码,观察差异。
total 参数用于指定循环的总迭代次数,从而让 tqdm 更准确地估算剩余时间与完成百分比。
在使用 tqdm(range()) 或 trange() 的基础示例中,这不是必需的,因为迭代次数已经在括号中给出。不过,有两种主要情形,添加 total=n(n 为总数)会很有帮助:
1. 没有 len() 方法的可迭代对象: 对于没有 len() 方法、项目数量未知的生成器等,您需要手动提供 total。若未指定该参数,tqdm() 只会显示已完成的迭代次数。请注意,如果实际项目数超过指定的 total,进度条会重新开始计数。
from tqdm import tqdm
import time
import random

# Function generating random number between 1 and 100
def generate_random_numbers():
	while True:
	        yield random.randint(1, 100)

# Without total: tqdm() only shows number of iterations, does not know total
for num in tqdm(generate_random_numbers(), desc=’Random Iteration’):
	time.sleep(0.01)
	# …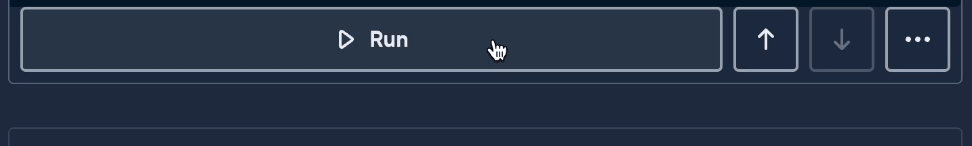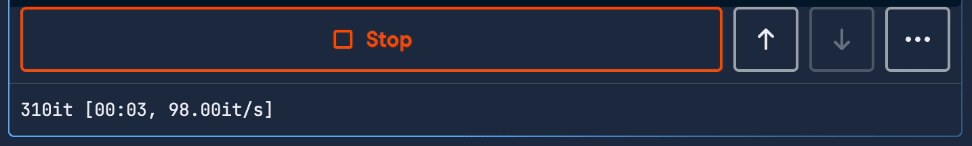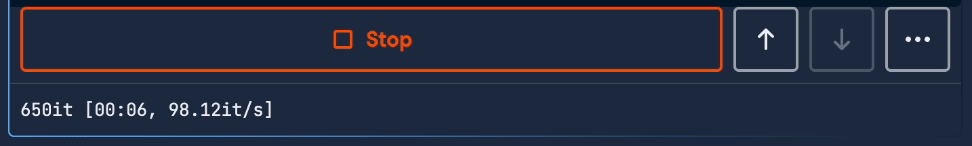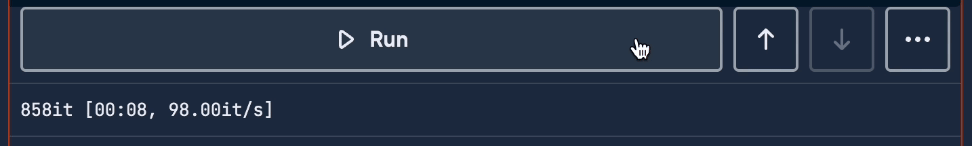
如果项目数量未知且未指定 total,输出会是这样。
# With total (assuming you know the desired number of iterations): tqdm() shows progress
num_iterations = 1000
for num in tqdm(generate_random_numbers(), total=num_iterations, desc="Random Iteration"):
	time.sleep(0.01)
	# …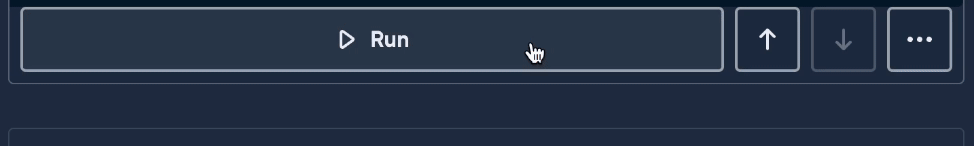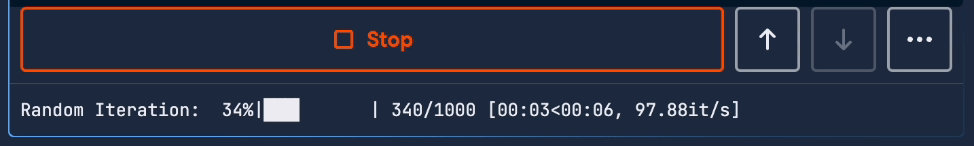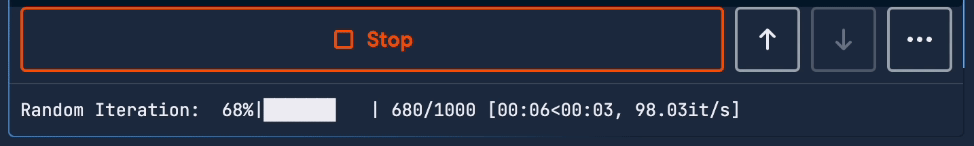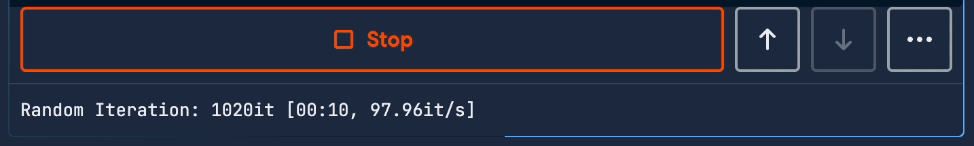
好多了,现在进度条显示出来了!
2. 手动更新: 如果我们在函数内使用 update() 方法手动更新进度条,则需要指定 total 值以确保正确跟踪进度。update() 方法可用于响应动态变化的过程或实现自定义的进度跟踪。我们稍后会介绍。
如果我们想调整进度条元素的显示顺序,可以通过设置 bar_format 为期望的格式字符串来实现。这样就可以控制诸如百分比、已用时间、条形填充字符等元素的摆放位置。详情可参考文档。
另一项外观调整可以通过 colour 参数完成。可以使用如“green”的颜色名称,或如“#00ff00”的十六进制颜色代码。
leave 参数与“消失”相关:它决定进度条在完成后是否保持可见。设为 True,循环结束后进度条仍会保留;设为 False,则会消失。
我们通过另一个示例来看不同输出的视觉差异。以下代码将创建三个进度条:一个为默认设置,一个更改了元素顺序与颜色,另一个在此基础上设置为完成后消失。输出见下方 GIF。
from tqdm import tqdm
import time

# Progress bar 1: Default settings
for i in tqdm(range(300)):
	time.sleep(0.01)

# Progress bar 2: Customized bar format and color
for i in tqdm(range(300), bar_format='[{elapsed}<{remaining}] {n_fmt}/{total_fmt} | {l_bar}{bar} {rate_fmt}{postfix}', colour='yellow'):
	time.sleep(0.01)

# Progress bar 3: Customized bar format and color, leave=False
for i in tqdm(range(300), bar_format='[{elapsed}<{remaining}] {n_fmt}/{total_fmt} | {l_bar}{bar} {rate_fmt}{postfix}', colour='red', leave=False):
	time.sleep(0.01)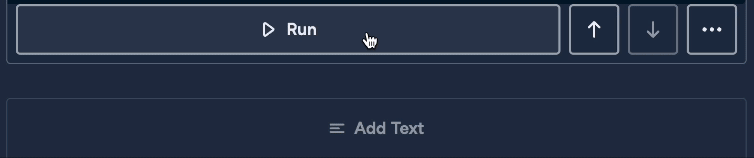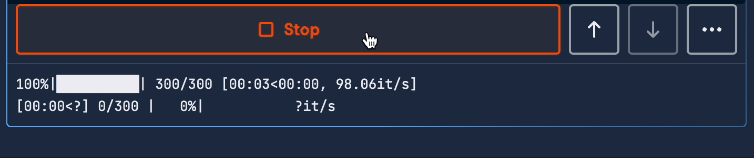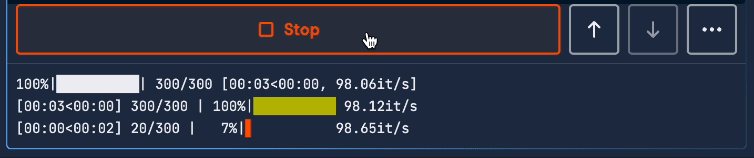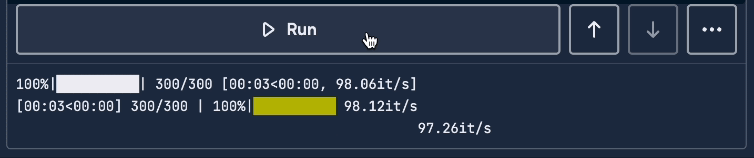
现在我们已经知道如何构建简单的进度条并进行定制,可以继续学习更多高级用例。
嵌套循环是包含在其他循环中的循环。相应地,嵌套进度条是为外层循环中的每次迭代而显示的一系列进度条。要创建它们,为每个循环都包上一层 tqdm(),并为每个可迭代对象添加描述标签。
下面的代码包含三个嵌套循环,展示嵌套进度条的显示效果:
from tqdm import trange
import time

for i in trange(3, desc='outer loop'):
	for j in trange(2, desc='middle loop'):
   		for k in trange(6, desc='inner loop'):
	time.sleep(0.01)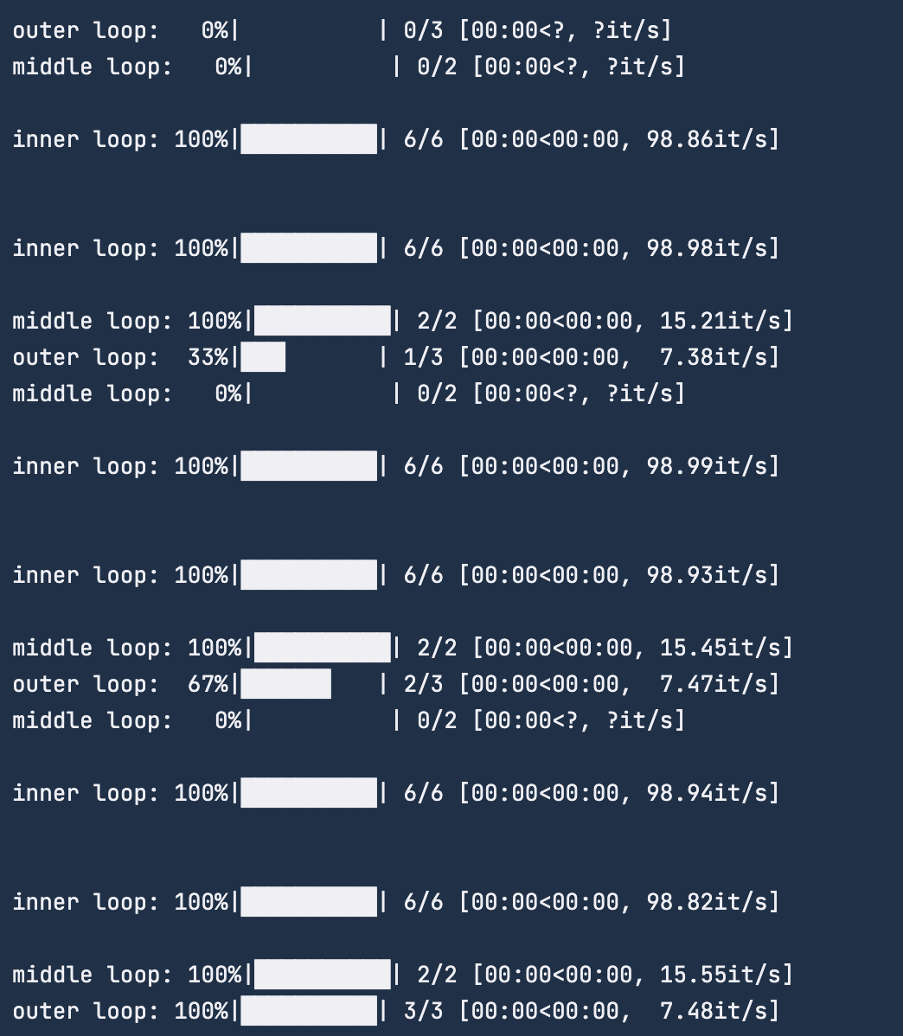
从上述最终输出中,我们可以看出不同进度条的更新模式。Tqdm 总是从最外层循环开始,直到进入最内层循环,再根据迭代进展更新对应的进度条。
假设我们有如示例所示的三个嵌套循环。在内层的首次迭代后,它会回到中间层,将其中一次迭代标记为完成,然后再回到内层。这个过程重复进行,直到中间层循环完成,随后外层进度条也会更新为完成一次迭代。
外层与中间层之间同样如此。最后,内层的最终一次运行将使中间层完成,进而完成外层的最后一次迭代。
在以下场景中,使用 tqdm 手动更新进度条会很有用:
要手动更新 tqdm 进度条,务必指定 total 参数,作为预估的最大迭代次数。然后,随着代码处理每个新元素,使用 update() 方法更新进度条。update 的值应表示自上次更新以来已处理的迭代数。
假设我们预期可迭代对象最多包含 750 个元素。在该示例中,实际长度是 100 到 1000 之间的随机数,我们并不知道具体数值。我们初始化 progress_bar,将 estimated_total 设为 750。然后遍历数据,并在每个数据点处理后更新进度条。
from tqdm import tqdm
def process_data(data):
	time.sleep(0.01)        	# simulate processing data
	processed_data = data
	return processed_data
# Generate an iterable with random length between 100 and 1,000
random_length = random.randint(100, 1000)
data_list = [i for i in range(random_length)]
# Define estimated maximum number of iterations
estimated_total = 750
# Define the progress bar using the estimated_total
progress_bar = tqdm(total=estimated_total)
# Iterating through data list of unknown length
for data in data_list:
	processed_data = process_data(data)
	progress_bar.update(1)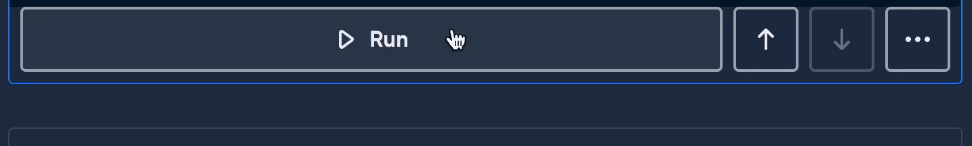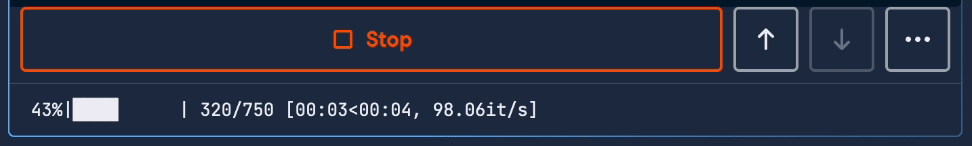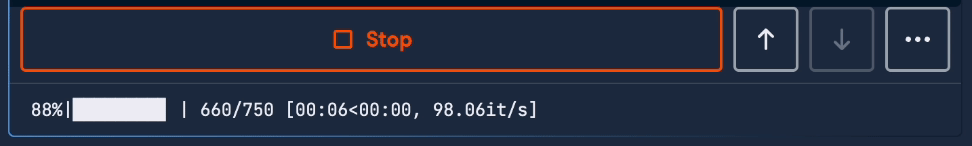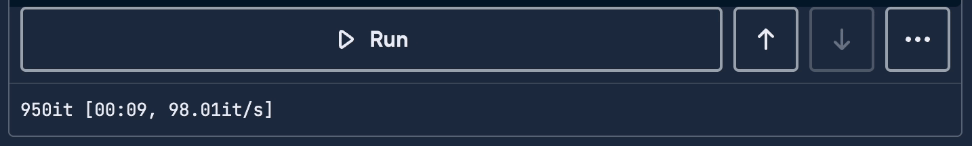
我们低估了可迭代对象的长度,因此在达到 100% 后,输出仍继续计数。
多进程与多线程是并发执行任务以提升性能和响应速度的技术。在这些场景中,跟踪各个任务或整体并行执行的进度可能具有挑战性。Tqdm 是提供可视化反馈、监控并发操作进度的有力工具。
tqdm.contrib.concurrent 模块为多进程或多线程环境提供了专用函数,以创建进度条。这些函数负责主进程与工作进程/线程之间的同步与通信,确保进度条正确更新。它们可与 concurrent.futures API 无缝配合,使用 ProcessPoolExecutor() 或 ThreadPoolExecutor()。
以下是一个使用 tqdm.contrib.concurrent.futures 模块的示例:
import concurrent.futures
from tqdm.contrib.concurrent import process_map

def process_data(data):
	for i in tqdm(range(100), desc=f"Processing {data['name']}"):
	    	# Process data
	    	time.sleep(0.01)

if __name__ == '__main__':
	with concurrent.futures.ProcessPoolExecutor() as executor:
	    	results = process_map(process_data, [
	        	{'name': 'dataset1'},
	        	{'name': 'dataset2'},
	# …
])在该示例中,process_data() 函数包含一个 tqdm 进度条来跟踪其进度。process_data() 会对列表中的每个数据项并发执行。这意味着会同时显示多个进度条,每个条对应一个独立进程的进度。desc 参数根据数据集名称动态生成描述,帮助我们区分不同的进度条。
tqdm.pandas 模块为 pandas 操作添加进度条提供了便捷方法。对于大DataFrame 上耗时的操作尤其实用,它能为任务进度提供可视化反馈。我们可以将 tqdm.pandas() 装饰器应用到任何按行或按列操作的 pandas 函数上。
首先,我们定义一个包含 100,000 行的随机 DataFrame,并调用 tqdm.pandas() 装饰器。若需自定义进度条,应在此时进行,因为 progress_apply() 和 progress_map() 不接收 tqdm() 的参数。这里我们希望为进度条命名,因此也指定 desc 参数。
import pandas as pd
import numpy as np
from tqdm import tqdm

df = pd.DataFrame(np.random.randint(0, 10, (100000, 6)))

tqdm.pandas(desc='DataFrame Operation')
现在可以将函数应用到行、列或整个 DataFrame。不要使用 apply() 或 map(),而是调用 progress_apply() 或 progress_map(),即可显示进度条。请记住,apply() 与 progress_apply() 可用于 DataFrame、行或列,而 map() 与 progress_map() 只能用于 Series 或列。例如:
# Halving each value in the DataFrame using progress_apply()
Result_apply = df.progress_apply(lambda x: x / 2)

# Doubling each element of the first column using progress_map()
result_map = df[0].progress_map(lambda x: x * 2)我们来讨论一些常见的 Tqdm 问题与错误,并了解如何修复。
使用 tqdm 时最常见的问题之一是进度条不更新。这通常源于缓冲问题,尤其是在Jupyter Notebook 等环境中。当输出被缓冲时,进度条可能不会立即显示或更新,从而给人一种冻结或无响应的感觉。
使用 tqdm.notebook 模块可以解决缓冲问题,并确保在 Jupyter Notebook 中正确更新进度条。该模块提供专为 Jupyter 环境设计的基于 GUI 的进度条。
此外,它还提供友好的颜色提示(蓝色:正常,绿色:完成,红色:错误/中断)。
如果我们中断了嵌套进度条示例中的代码,显示效果如下:
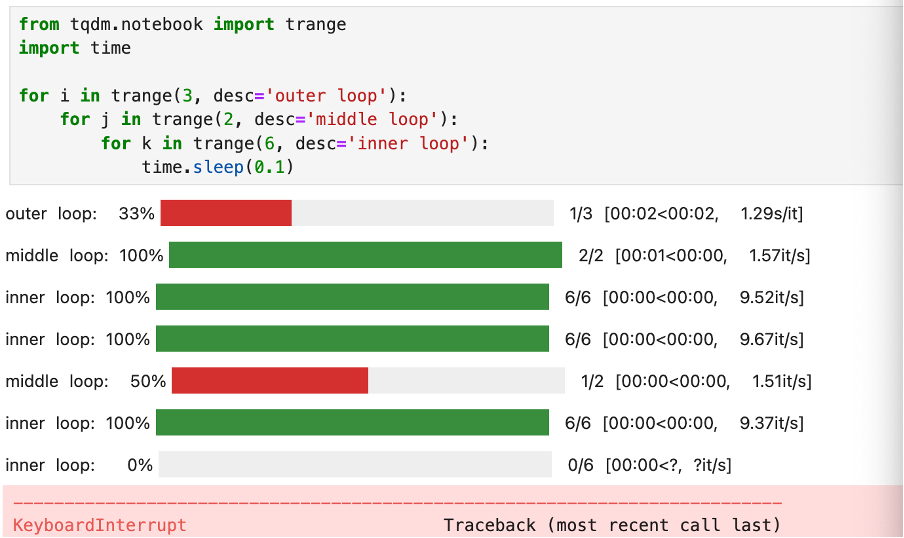
在 Python 中使用 tqdm.notebook 的嵌套进度条,展示完成与中断条的配色方案。
另一种排查进度条不更新的有效方法是显式刷新输出流。当数据写入标准输出(例如使用 print())时,通常会先被缓冲,再发送到实际的输出设备。刷新输出流会强制 Python 解释器立即将缓冲数据发送至输出设备,确保数据及时显示或写入。
要刷新输出,请使用标准输出流的 flush() 方法。若希望输出更及时,可更频繁地刷新输出流,例如每隔几次迭代或每隔一段时间刷新一次。请注意这会带来一定开销。以下示例展示了如何将该方法融入简单的 tqdm 过程:
import sys
import time
from tqdm import tqdm

for i in tqdm(range(100)):
	time.sleep(0.1)
sys.stdout.flush() # Flush the output stream after each iteration尽管 tqdm 通常与大多数 Python 环境和库兼容,但偶尔也会出现兼容性问题或意外行为。需要留意的常见情形包括:
tqdm 可能无法按预期工作。我们需要确保所用输出流支持显示进度条所需的操作。tqdm 可能与第三方库产生意外交互,尤其是那些自身也处理输出或进度跟踪的库。我们可以尝试禁用或修改相关第三方库的功能,看看是否能解决问题。tqdm 与其他库。请查看库文档,了解与特定 Python 版本或其他依赖的已知兼容性问题。遇到兼容性问题时,可以考虑以下权宜之计:
tqdm。tqdm 社区或在线论坛求助,寻找可能的解决方案。了解这些潜在的兼容性问题及其应对方法后,我们就能更有效地在Python 项目中排查与解决使用 tqdm 时遇到的问题。
总之,Tqdm 是一个为我们提供进度条和其他有用统计信息的 Python 库,使监控与管理代码执行变得更加容易。
无论您是在遍历大型数据集、训练机器学习模型,还是执行其他耗时操作,tqdm 都提供了一种简单而强大的方式来跟踪进度,并随时了解代码状态。
若想进一步探索,欢迎查阅其他 DataCamp 的 Python 教程、 Tqdm 文档,或其 GitHub 上的源代码与 Readme。
精选 Python 课程!
课程
课程
实践并学习路径你的进步。
使用 Google 继续