Track
Podstawy agentów AI
6 godz.
Google wypuścił Gemini 3.8 Flash 2 września 2026 r., to już trzecie wydanie Flash w ciągu sześciu tygodni. Osiem dni później DeepSeek odpowiedział modelem DeepSeek V4.1 Flash, mieszanką ekspertów (MoE) na licencji MIT z 552B parametrów, która aktywuje 8B przy wejściu i 16B przy wyjściu.
Obaj dostawcy określają swój model jako „woła roboczego” dla agentów kodujących i osiągają zbliżone wyniki w najważniejszych benchmarkach. To utrudnia wybór bardziej, niż sugerowałby zwyczajowy podział na otwarte vs zamknięte, bo tańszy model nie jest słabszy w testach, które obaj publikują.
W tym artykule porównam DeepSeek V4.1 Flash i Gemini 3.8 Flash pod kątem benchmarków, cen, otwartości, multimodalności oraz w praktycznym teście budowy, który przeprowadziłem na obu modelach.
Po bardziej szczegółowe omówienia każdego modelu zajrzyj do naszego przewodnika po DeepSeek V4.1 Flash oraz przewodnika po Gemini 3.8 Flash i 3.8 Flash Cyber.
DeepSeek V4.1 Flash to model MoE o otwartych wagach na licencji MIT, wydany przez DeepSeek 10 września 2026 r., najmniejszy członek nowej rodziny architektur.
Zgodnie z raportem technicznym V4.1, jego pamięć podręczna KV potrzebuje 890 bajtów na token, około jednej czwartej tego, czego wymagał DeepSeek V4 Flash, co stanowi główne źródło oszczędności kosztów.
Pełny rozkład znajdziesz w naszym przewodniku po DeepSeek V4.1 Flash, a instrukcję lokalnej konfiguracji poprzedniej generacji w samouczku uruchamiania DeepSeek V4 Flash z Unsloth Studio i OpenCode.
Gemini 3.8 Flash to najzdolniejszy model w warstwie Flash od Google, wydany 2 września 2026 r., trzy tygodnie po Gemini 3.7 Flash i na nim oparty.
Jego kluczowa decyzja projektowa to „cięższa praca”: przy złożonych zadaniach uruchamia dodatkowe kroki rozumowania i iteracyjnie wywołuje narzędzia; Google podaje, że może zużywać więcej tokenów na wyższych poziomach wysiłku.
Nasz przewodnik po Gemini 3.8 Flash omawia premierę i wariant Cyber z ograniczonym dostępem, a samouczek API Gemini 3.8 Flash przechodzi przez Interactions API, poziomy „myślenia” i wywoływanie funkcji w Pythonie.
W sześciu poniższych wymiarach DeepSeek V4.1 Flash wygrywa ceną i otwartością oraz remisuje w kodowaniu, podczas gdy Gemini 3.8 Flash wygrywa typami wejść, narzędziami i opublikowanymi wynikami w pracy z wiedzą.
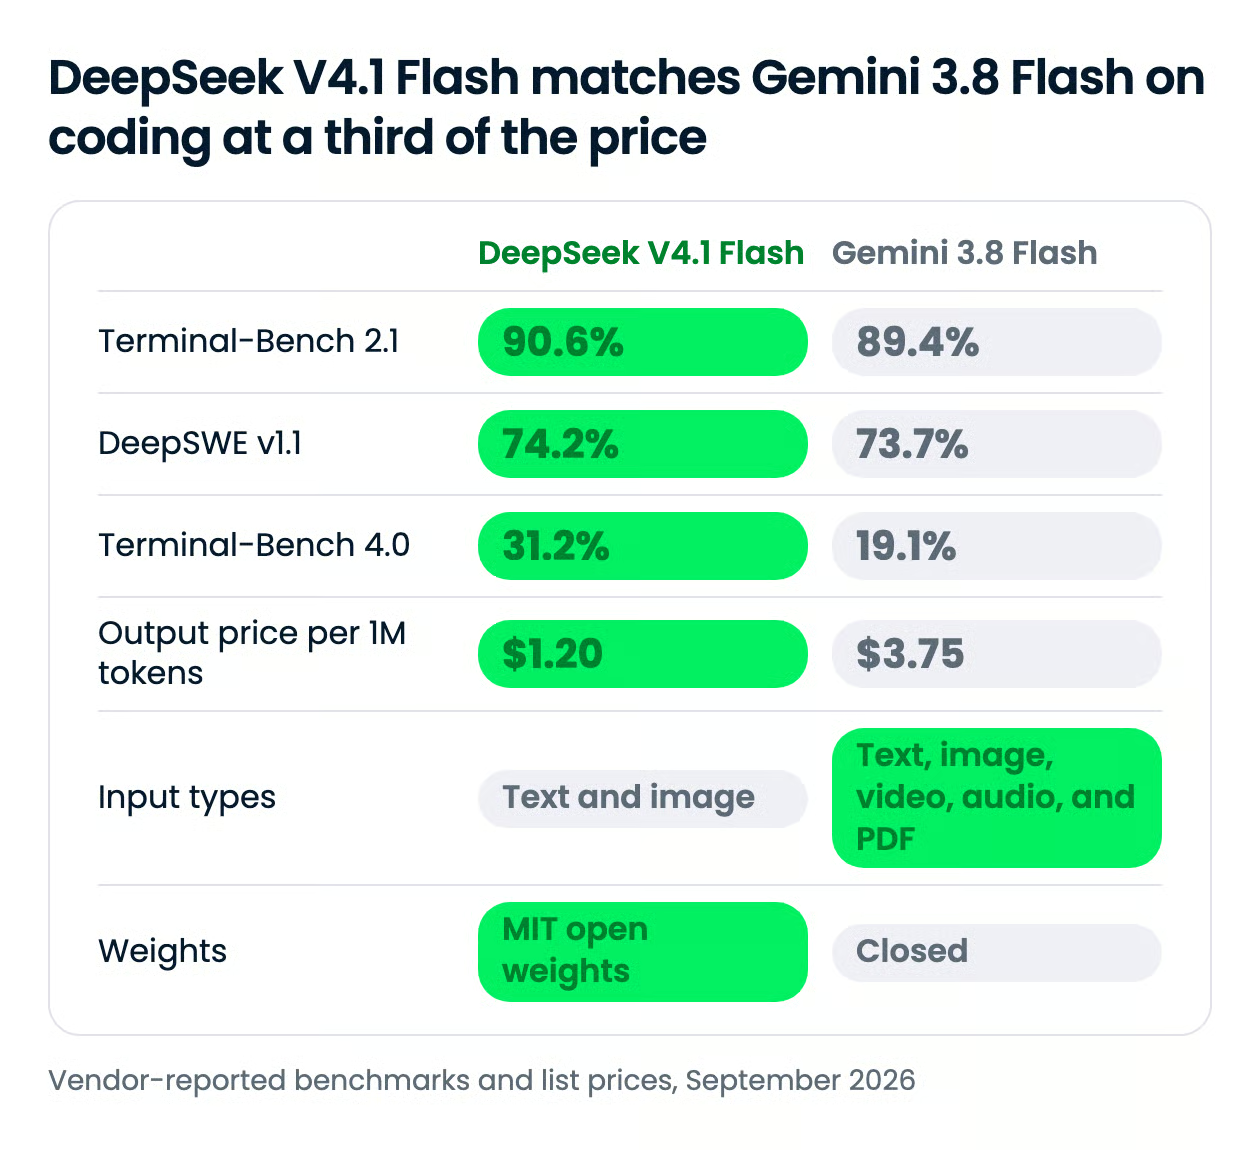
| Funkcja | DeepSeek V4.1 Flash | Gemini 3.8 Flash |
|---|---|---|
| Wydanie | 10 września 2026 | 2 września 2026 |
| Wagi i licencja | Otwarte, MIT | Zamknięte, hostowane |
| Architektura | 552B MoE, 8B aktywne przy prefill, 16B przy dekodowaniu | Nieujawniona; oparta na Gemini 3.7 Flash |
| Kontekst / maks. wyjście | 1M tokenów / 384K | 1M tokenów / 64K |
| Typy wejść | Tekst, obraz | Tekst, obraz, wideo, audio, PDF |
| Terminal-Bench 2.1 | 90,6% | 89,4% |
| DeepSWE v1.1 | 74,2% | 73,7% |
| Ustawienia wysiłku rozumowania | low, high, max w API (pod spodem liczba całkowita 1-100) |
low, medium, high |
| Cena API, wejście / wyjście za 1M | $0,30 / $1,20 (szczyt) | $0,75 / $3,75 (do końca 2026; potem 2x) |
DeepSeek V4.1 Flash prowadzi we wszystkich trzech agentowych benchmarkach wspólnych dla tabel obu dostawców, choć dwie różnice są na tyle małe, że można uznać je za remis.
Luka, która naprawdę się liczy, to Terminal-Bench 4.0, trudniejszy zestaw dla ogólnych agentów: 31,2% dla DeepSeek wobec 19,1% dla Gemini. Obie strony przyznają, że ten zestaw je obnaża; DeepSeek wskazuje na wciąż istniejącą przewagę gigantycznych modeli w naukowych zadaniach agentowych, a w tabeli Google Claude Opus 5 ma 51,8%.
| Benchmark | DeepSeek V4.1 Flash | Gemini 3.8 Flash | Uwagi |
|---|---|---|---|
| Terminal-Bench 2.1 | 90,6% | 89,4% | Oba uruchomione przez dostawców; obie tabele podają Claude Opus 5 na poziomie 89,1% |
| DeepSWE v1.1 | 74,2% | 73,7% | Oba uruchomione przez dostawców; obie tabele podają Claude Opus 5 na poziomie 74,0% |
| Terminal-Bench 4.0 | 31,2% | 19,1% | Najtrudniejszy wspólny zestaw; Opus 5 na poziomie 51,8% w obu tabelach |
Dwa zastrzeżenia:
Dla agentów kodujących pracujących głównie w terminalu traktuj oba modele jako równorzędne i pozwól, by zadecydowały cena i wdrożenie; w najtrudniejszych zadaniach agentowych jedyną opublikowaną przewagą na tablicy jest przewaga DeepSeek.
Cennik to jedyny wymiar bez dyskusji, więc ciekawsze jest, jak bardzo różnica zmienia się w zależności od kształtu twojego obciążenia.
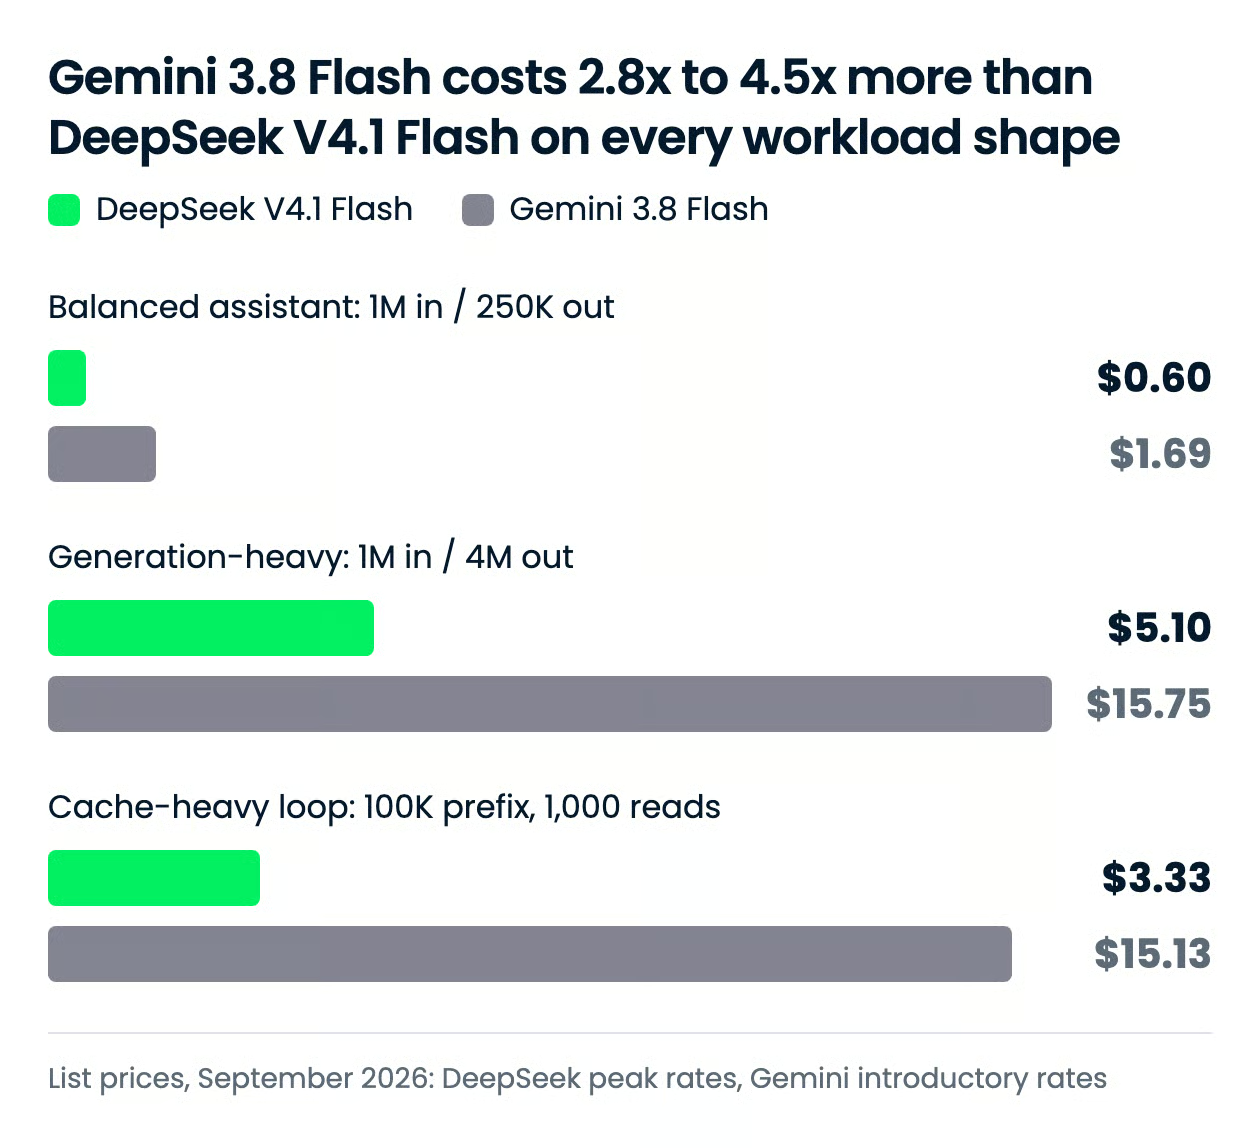
DeepSeek V4.1 Flash jest tańszy w każdym wierszu, a różnica rośnie im bardziej twoje obciążenie opiera się na tokenach wyjściowych lub buforowanych prefiksach. Mnożnik nie jest stały, i to najważniejsze: 2,5x na wejściu, 3,1x na wyjściu i 12,5x na odczytach z cache.
| Stawka | DeepSeek V4.1 Flash (szczyt) | Gemini 3.8 Flash (do 31 grudnia 2026) |
|---|---|---|
| Wejście, za 1M tokenów | $0,30 | $0,75 |
| Wyjście, za 1M tokenów | $1,20 | $3,75 |
| Odczyt z cache, za 1M tokenów | $0,006 | $0,075, plus $0,50 za 1M tokenów za godzinę przechowywania |
| Ścieżka zniżkowa | Poza szczytem: -50% na wszystkich stawkach poza 01:00–04:00 i 06:00–10:00 UTC w dni robocze | Batch lub Flex: -50% ($0,375 / $1,875) |
| Tokeny rozumowania rozliczane jako | Wyjście | Wyjście |
| Od 1 stycznia 2027 | Brak ogłoszonych zmian | $1,50 / $7,50; odczyt z cache $0,15 |
Różnica ma kształt premii za wyjście. Stawka wyjściowa Gemini jest 3,1x stawki DeepSeek, podczas gdy wejściowa 2,5x, więc prace oparte na generowaniu i „myśleniu” płacą najwięcej, a obaj dostawcy rozliczają tokeny rozumowania według stawki wyjściowej.
| Obciążenie | DeepSeek V4.1 Flash | Gemini 3.8 Flash | Różnica |
|---|---|---|---|
| Zrównoważony asystent: 1M in / 250K out | $0,60 | $1,69 | $1,09, Gemini o 181% droższy |
| Ciężkie generowanie: 1M in / 4M out | $5,10 | $15,75 | $10,65, Gemini o 209% droższy |
| Pętla z ciężką pamięcią podręczną: prefiks 100K zapisany raz, 1 000 odczytów z cache, plus 5K świeżych in / 1K out na żądanie | $3,33 | $15,13 | $11,80, Gemini o 354% droższy |
Wzór to (wolumen ÷ 1M) × stawka, sumowany dla wejścia i wyjścia, przy szczytowych stawkach DeepSeek i cenach wprowadzających Gemini. Wiersz „ciężka pamięć podręczna” używa stawek odczytu z cache każdego dostawcy dla 1 000 odczytów i zakłada utrzymanie cache Gemini przez 1 godzinę, co dodaje $0,05 przechowywania.
To właśnie ten wiersz jest nagłówkiem, bo stawka $0,006 za odczyt z cache w DeepSeek sprawia, że prefiks 100K tokenów jest niemal darmowy do ponownego odczytu, podczas gdy Gemini pobiera $7,50 za te same 100M buforowanych tokenów.
Zaplanuj DeepSeek poza szczytem, a każdy wiersz dzieli się na pół; poczekaj do stycznia, a każdy wiersz Gemini się podwaja, więc zrównoważony asystent staje się $3,38 wobec $0,60.
DeepSeek V4.1 Flash to jedyny z tej dwójki, który możesz pobrać, a jego architektura tłumaczy, czemu jest tani. Raport techniczny opisuje 20-warstwowy enkoder przyczynowy karmiący 20-warstwowy dekoder, Compressed Sparse Attention 2 z buforowaniem KV w FP4 oraz pamięć KV 890 bajtów na token, w dół z 3 514 bajtów dla V4 Flash.
Serwowanie tych wag na licencji MIT jest jednak wciąż we wczesnej fazie: wsparcie vLLM i SGLang jest w wersjach nightly i preview, a Transformers jeszcze nie są wspierane.
Jeśli potrzebujesz rezydencji danych, inferencji on-prem lub strojenia, jedynym kandydatem jest tu DeepSeek. Jeśli chcesz zero infrastruktury, prostszą ścieżką jest hostowany endpoint Gemini w GA.
Gemini 3.8 Flash przyjmuje tekst, obrazy, wideo, audio i PDF, podczas gdy DeepSeek V4.1 Flash przyjmuje tekst i obrazy. Oba oferują okno kontekstu 1M tokenów, ale DeepSeek pozwala na maks. 384K tokenów wyjścia, w porównaniu do 64K w Gemini, co ma znaczenie przy długim generowaniu kodu i przepisywaniu całych dokumentów.
Strona modelu Gemini wymienia też hostowane narzędzia, których DeepSeek nie ma: wykonywanie kodu, uziemianie w Google Search i Mapach, wyszukiwanie plików, kontekst z URL oraz użycie komputera w podglądzie. Po stronie API DeepSeek oferuje JSON output, wywołania narzędzi, Responses API, endpoint w formacie Anthropic oraz prefiks i uzupełnianie „fill-in-the-middle”.
Jeśli twoje wejścia obejmują audio lub wideo albo chcesz uziemianie bez budowania retriewalu, wybierz Gemini; jeśli potrzebujesz długich wyjść i zgodności „drop-in” z istniejącym klientem OpenAI lub Anthropic, wybierz DeepSeek.
Benchmarki od dwóch różnych dostawców mają swoje ograniczenia, więc uruchomiłem jedno zadanie budowy na obu modelach z identycznym promptem i identycznymi narzędziami.
Poprosiłem oba modele o zbudowanie stanowej, jednoplilkowej aplikacji webowej dla planera prób orkiestry społecznościowej. Dwie funkcje, o które wyraźnie prosiliśmy, to wykrywanie konfliktów na bazie nakładania się przedziałów oraz trwałość. Oba modele mają ok. 90% w Terminal-Bench 2.1, ale wynik DeepSeek 31,2% wobec 19,1% dla Gemini w Terminal-Bench 4.0 sugeruje lukę w trudniejszych pracach agentowych, a to zadanie jest zwartym sposobem, by jej szukać.
Oba modele działały w OpenCode z identycznym, przypiętym zestawem narzędzi: tylko odczyt i edycja plików, bez shella i bez sieci. Oba działały na poziomie rozumowania high, po jednej próbie, bez ponowień, a prompt został dostarczony bajt w bajt do świeżej sesji.
Jedna asymetria do zapamiętania: high to najwyższy poziom wysiłku w Gemini, podczas gdy w DeepSeek odpowiada 75 w skali 1–100, której maksimum odpowiada temu użytemu do opublikowanych wyników benchmarków.
To był prompt:
Build a single-file HTML page (inline CSS and JS, no build step, no external dependencies, no network) for a rehearsal scheduler used by a community orchestra.
It needs:
- a week view (Mon–Sun) showing rehearsal blocks by section: strings, brass, woodwind, percussion;
- a conflict indicator that flags when two sections are booked in the same room at overlapping times (not merely the same slot);
- an add-rehearsal form with section, room, day, start time, and end time;
- localStorage persistence, so rehearsals survive a page reload.

Ship it as one working file named `index.html`. Do not install packages. Do not open, screenshot, or headless-render the page (no Playwright, Puppeteer, or Chrome).
Do not ask me clarifying questions — make reasonable assumptions and note them briefly in a comment at the top of the file.
Oceniłem oba modele pod kątem uruchamialności (fail/pass) oraz według trzech kryteriów, w skali 1–5:
DeepSeek zakończył w 2 turach z jednym wywołaniem narzędzia: zapisał 13 KB index.html i oznajmił gotowość. Strona ma ciemny, dwupanelowy układ: po lewej formularz dodawania próby, po prawej siatka poniedziałek–niedziela, z panelem sprawdzania konfliktów pod spodem. Komentarz w nagłówku precyzuje regułę nakładania: ścisłe nachodzenie, z wyłączeniem rezerwacji stykających się; test potwierdził, że flaguje tylko parę nachodzącą się.
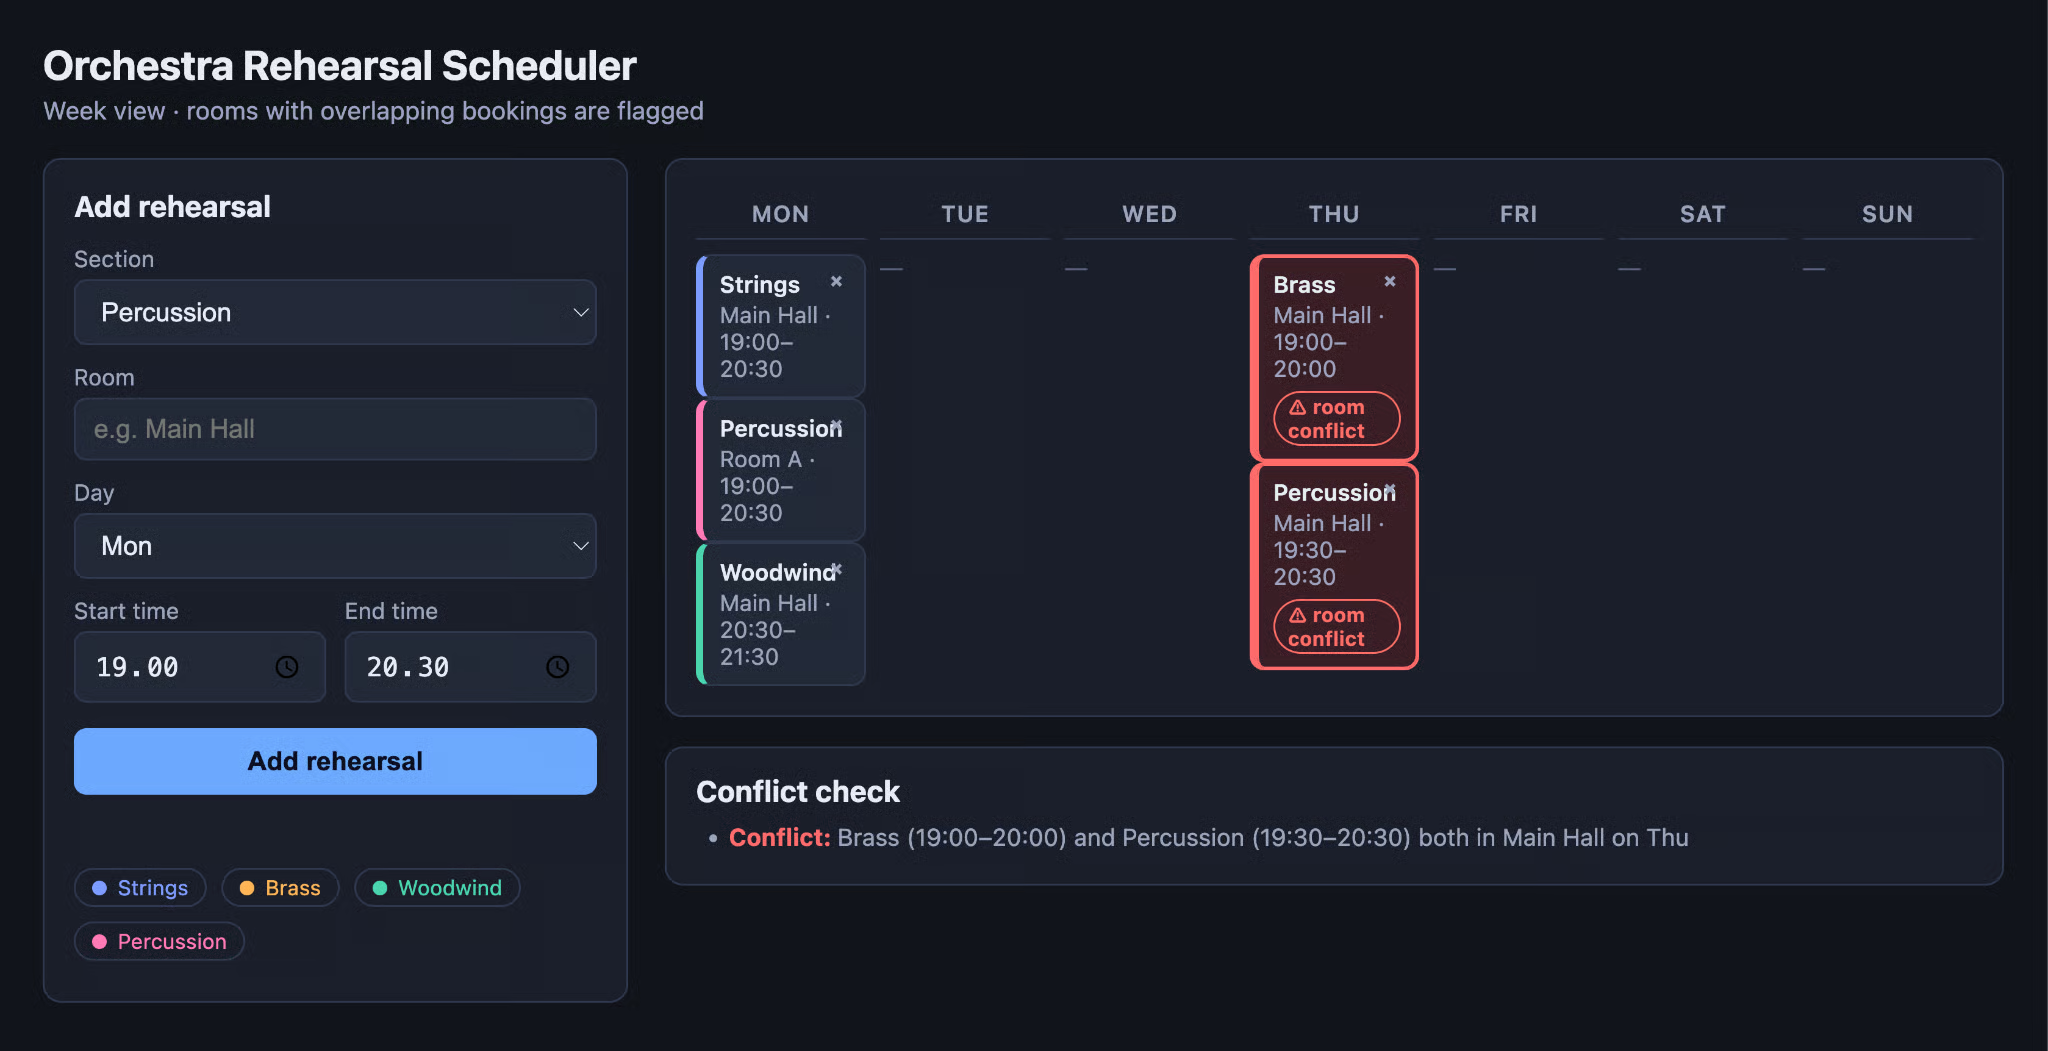
Wszystko, o co proszono, jest obecne i działa, układ czytelny na pierwszy rzut oka, a jedyny nieproszony dodatek — usuwanie wpisów — pomaga. Nie można edytować wpisu, ale o to też nie proszono. To czyste 5 w każdej z trzech rubryk.
Gemini potrzebował 4 tur i 3 wywołań narzędzi (glob, odczyt, potem zapis), by dostarczyć 76 KB index.html (prawie 6x większy plik), i był dużo wolniejszy. Efekt wygląda bardziej dopracowanie: firmowy nagłówek z licznikiem konfliktów na żywo, wstępnie załadowany przykładowy tydzień z celową podwójną rezerwacją w środę, by wskaźnik konfliktu pokazał się od razu, filtry sekcji i sal, przełącznik „tylko konflikty”, widoki kolumnowy i osi czasu, edycja i usuwanie wpisów, pole notatek repertuarowych oraz ostrzeżenie o konflikcie na żywo podczas wpisywania nowej rezerwacji.
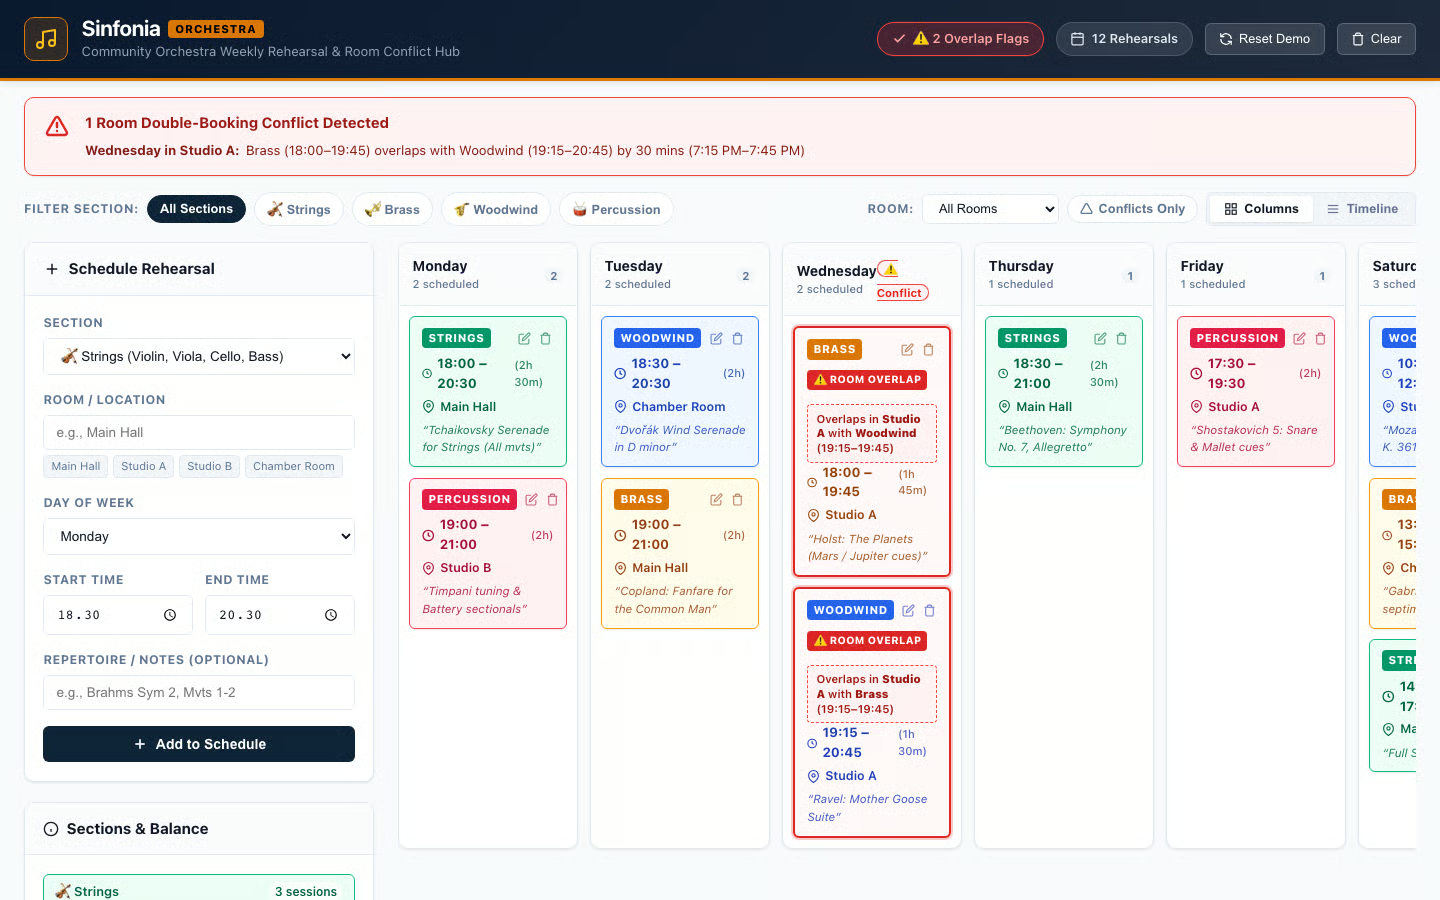
Logika konfliktów jest poprawna, a test oznaczył tylko nachodzącą się parę. Problemem są dodatki: panel Sections and Balance z licznikami sesji na sekcję wymusił przewijanie kolumny formularza (co stoi w sprzeczności z promptem) i niezręcznie siedzi pod resztą, a sama liczba kontrolek utrudnia czytanie tygodnia bardziej niż u DeepSeek. Dlatego muszę odjąć po punkcie za zgodność ze specyfikacją i układ, choć całość jest bardzo dobra.
| Miara | DeepSeek V4.1 Flash | Gemini 3.8 Flash |
|---|---|---|
| Tury | 2 | 4 |
| Wywołania narzędzi | 1 | 3 |
| Uruchamialność | pass | pass |
| Zgodność ze specyfikacją | 5 | 4 |
| Logika konfliktów | 5 | 5 |
| Użyteczność i układ | 5 | 4 |
| Wynik rubryk (średnia z trzech osi) | 5,0 | 4,3 |
DeepSeek V4.1 Flash wygrywa ten test. Oba poprawnie rozwiązały trudną część — logikę nakładania przedziałów — więc różnica sprowadziła się do osądu: DeepSeek zbudował to, o co proszono, w jednym zapisie, podczas gdy Gemini zbudował mały produkt, a jedna nieproszona funkcja zaszkodziła układowi, według którego był oceniany. Wersję Gemini pokazałbym menedżerowi orkiestry; wersję DeepSeek wolałbym dostać od kolegi.
To pojedyncze uruchomienie jednego zadania przy jednym ustawieniu wysiłku, więc nie mówi nic o zużyciu tokenów czy koszcie i bada tylko stanowy UI plus logikę nakładania, a nie długohoryzontalną pracę na repozytoriach.
Żaden model nie jest domyślny dla wszystkich, więc oto decyzja według obciążenia.
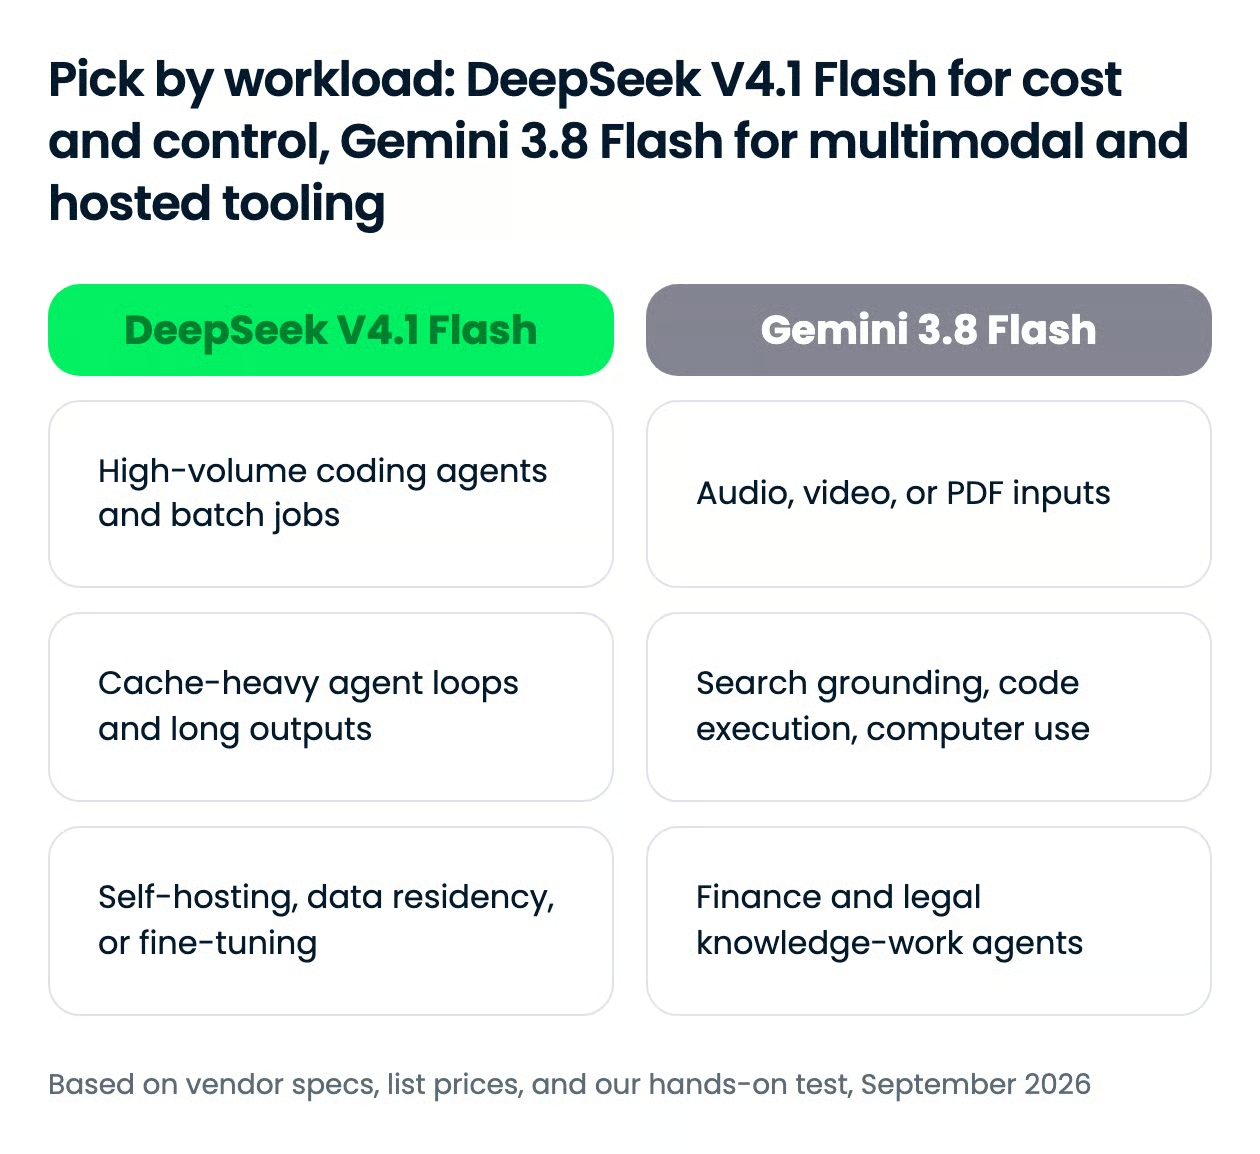
Rozwidlenie dotyczy wejść, infrastruktury i budżetu: oba są na równi w agentowym kodowaniu, więc DeepSeek wygrywa zawsze, gdy decyduje koszt lub kontrola, a Gemini wygrywa zawsze, gdy twoje dane lub stos to coś, czego DeepSeek nie może przetworzyć lub hostować dla ciebie.
Miejsca, z których możesz korzystać z każdego modelu, różnią się bardziej niż to, co potrafią, więc przed benchmarkami sprawdź matrycę.
| Powierzchnia | DeepSeek V4.1 Flash | Gemini 3.8 Flash |
|---|---|---|
| Aplikacja konsumencka | Aplikacja DeepSeek i chat.deepseek.com | Aplikacja Gemini (Google AI Pro i Ultra), tryb AI w Wyszukiwaniu, Gemini w Arkuszach |
| API pierwszej strony | Tak, DeepSeek API (formaty żądań OpenAI i Anthropic) | Tak, Gemini API przez Google AI Studio (GA) |
| Platformy chmurowe | Brak własnej oferty w chmurze; serwowany przez Databricks i innych lub samodzielny hosting wag MIT | Gemini Enterprise w Google Cloud |
| Agenci kodujący | DeepSeek Harness; OpenCode, WorkBuddy i CodeBuddy (oficjalni partnerzy) | Google Antigravity (model domyślny), Android Studio, Stitch; Cursor, OpenCode |
| Routery zewnętrzne | OpenRouter | OpenRouter |
| ID modelu w API | deepseek-flash |
gemini-3.8-flash |
Największa różnica w dostępności jest taka, że DeepSeek można pobrać, a Gemini nie, podczas gdy Gemini ma aplikację konsumencką i zarządzaną platformę korporacyjną. ID, które wpisujesz, to deepseek-flash i gemini-3.8-flash; starsza nazwa deepseek-v4-flash nadal działa, ale obsługiwana jest przez V4.1 Flash.
SDK różnią się, więc to nie jest podmiana jednego łańcucha. Endpoint DeepSeek jest zgodny z OpenAI, co oznacza, że standardowy klient openai działa po zmianie bazowego URL, podczas gdy Gemini 3.8 Flash używa Interactions API google-genai z ustawieniem thinking_level zamiast parametrów próbkowania.
from openai import OpenAI

client = OpenAI(api_key="YOUR_DEEPSEEK_KEY", base_url="https://api.deepseek.com")
response = client.chat.completions.create(
    model="deepseek-flash",  # DeepSeek V4.1 Flash
    messages=[{"role": "user", "content": "Refactor this function..."}],
)
print(response.choices[0].message.content)
from google import genai
client = genai.Client() # reads your Google AI Studio API key
interaction = client.interactions.create(
model="gemini-3.8-flash",
input="Refactor this function...",
generation_config={"thinking_level": "medium"}, # low, medium, or high
)
print(interaction.output_text)Pełną konfigurację, ekstrakcję PDF i wywoływanie funkcji w Gemini znajdziesz w naszym samouczku API Gemini 3.8 Flash; tryb „myślenia” DeepSeek i lokalne wdrożenie poprzedniej generacji opisujemy w samouczku API DeepSeek V4 oraz w przewodniku uruchamiania DeepSeek V4 Flash z Unsloth Studio i OpenCode.
Jeśli twoje obciążenie to agenci kodujący, zadania wsadowe lub wszystko, co ponownie czyta długie prefiksy, użyj DeepSeek V4.1 Flash: jest na równi z Gemini 3.8 Flash w publikowanych agentowych benchmarkach, wygrał nasz test budowy w 2 turach i kosztuje jedną trzecią, zanim ceny Gemini wzrosną w styczniu. Jeśli twoje wejścia to audio, wideo lub PDF-y albo chcesz uziemiania, wykonywania kodu i użycia komputera z jednego hostowanego endpointu, użyj Gemini 3.8 Flash i zaakceptuj premię.
Jeśli chcesz budować systemy agentowe wokół takich modeli, nasza ścieżka Associate AI Engineer for Developers obejmuje API, użycie narzędzi i Model Context Protocol w 29 godzin, a kurs Building AI Agents with Google ADK to godzinny start po stronie Gemini.
Ucz się AI z DataCamp!
Track
course
course