
Lernpfad
KI-Agent-Grundlagen
6 Std.
Google hat am 2. September 2026 Gemini 3.8 Flash veröffentlicht, den dritten Flash-Release innerhalb von sechs Wochen. Acht Tage später konterte DeepSeek mit DeepSeek V4.1 Flash, einem MIT-lizensierten Mixture-of-Experts-Modell mit 552B Parametern, das beim Input 8B und beim Output 16B aktive Parameter nutzt.
Beide Anbieter positionieren ihr Modell als Arbeitstier für Coding-Agents und erzielen in den wichtigsten Benchmarks ähnliche Werte. Damit ist die Entscheidung schwieriger als das übliche Offen-gegen-Geschlossen-Narrativ vermuten lässt, denn das günstigere Modell ist in den gemeinsamen Benchmarks nicht das schwächere.
In diesem Artikel vergleiche ich DeepSeek V4.1 Flash und Gemini 3.8 Flash hinsichtlich Benchmarks, Preisen, Offenheit, Multimodalität und in einem praxisnahen Build-Test, den ich auf beiden Modellen durchgeführt habe.
Ausführlichere Einzelbetrachtungen findest du in unserem DeepSeek V4.1 Flash Guide und unserem Gemini 3.8 Flash und 3.8 Flash Cyber Guide.
DeepSeek V4.1 Flash ist ein Open-Weight, MIT-lizensiertes Mixture-of-Experts-Modell, das DeepSeek am 10. September 2026 veröffentlicht hat – das kleinste Mitglied einer neuen Architektur-Familie.
Laut dem V4.1 Technical Report benötigt sein KV-Cache 890 Byte pro Token – etwa ein Viertel von DeepSeek V4 Flash – und genau dort entsteht der Großteil der Kostenvorteile.
Die komplette Analyse findest du in unserem DeepSeek V4.1 Flash Guide, und für ein lokales Setup der Vorgängergeneration unser Tutorial zum Betrieb von DeepSeek V4 Flash mit Unsloth Studio und OpenCode.
Gemini 3.8 Flash ist Googles leistungsfähigstes Modell der Flash-Stufe, veröffentlicht am 2. September 2026 – drei Wochen nach Gemini 3.7 Flash und darauf aufbauend.
Das prägende Designmerkmal: Es „arbeitet härter“. Bei komplexen Aufgaben führt es zusätzliche Reasoning-Schritte aus und ruft Tools iterativ auf; Google sagt, dass bei höherem Effort-Level mehr Tokens anfallen können.
Unser Gemini 3.8 Flash Guide deckt den Launch und die Variante Cyber mit eingeschränktem Zugang ab, und unser Gemini 3.8 Flash API Tutorial führt durch die Interactions API, Thinking-Levels und Function Calling in Python.
Über die sechs Dimensionen unten hinweg gewinnt DeepSeek V4.1 Flash bei Preis und Offenheit und liegt beim Coding gleichauf, während Gemini 3.8 Flash bei Eingabetypen, Tooling und veröffentlichten Wissensarbeits-Ergebnissen punktet.
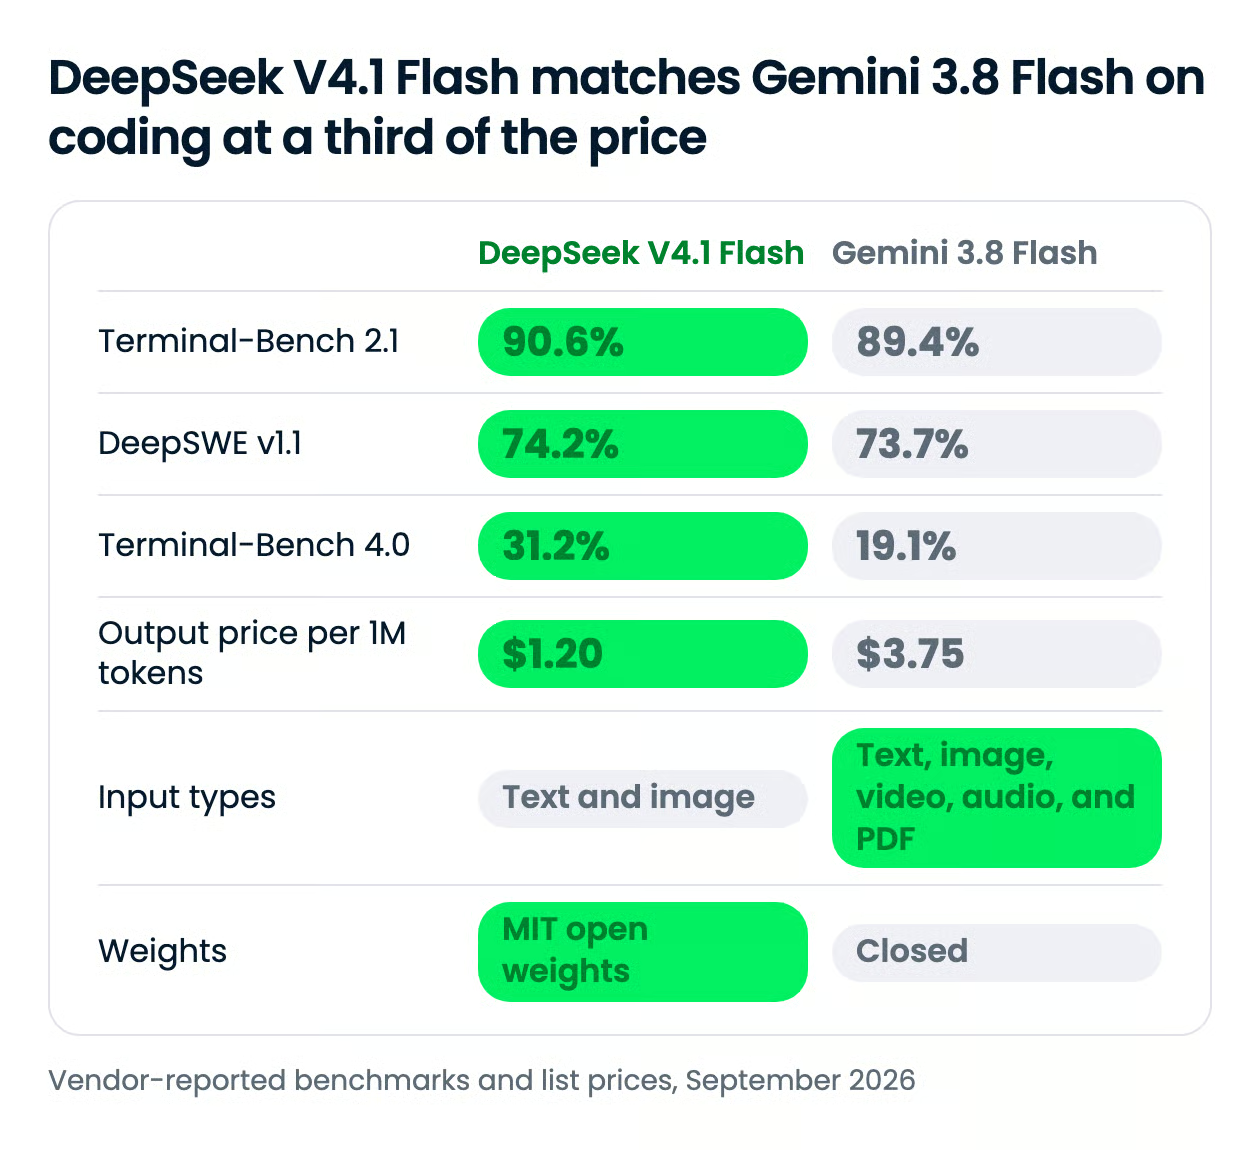
| Feature | DeepSeek V4.1 Flash | Gemini 3.8 Flash |
|---|---|---|
| Release | 10. September 2026 | 2. September 2026 |
| Gewichte und Lizenz | Open, MIT | Geschlossen, gehostet |
| Architektur | 552B MoE, 8B aktiv beim Prefill, 16B beim Decode | Nicht offengelegt; basiert auf Gemini 3.7 Flash |
| Kontext / max. Output | 1 Mio. Tokens / 384K | 1 Mio. Tokens / 64K |
| Input-Typen | Text, Bild | Text, Bild, Video, Audio, PDF |
| Terminal-Bench 2.1 | 90,6% | 89,4% |
| DeepSWE v1.1 | 74,2% | 73,7% |
| Reasoning-Effort-Einstellungen | low, high, max in der API (intern Integer 1–100) |
low, medium, high |
| API-Preis, Input / Output pro 1 Mio. | $0,30 / $1,20 (Peak) | $0,75 / $3,75 (bis Ende 2026; danach 2x) |
DeepSeek V4.1 Flash führt auf allen drei agentischen Benchmarks, die in beiden Tabellen stehen, auch wenn zwei Abstände so klein sind, dass man von einem Unentschieden sprechen kann.
Der wirklich relevante Abstand ist Terminal-Bench 4.0, die schwerere General-Agent-Suite: 31,2% für DeepSeek gegenüber 19,1% für Gemini. Beide Anbieter räumen ein, dass diese Suite Schwächen offenlegt; DeepSeek sagt, bei wissenschaftsnahen Agent-Aufgaben bleibe ein Abstand zu Riesenmodellen, und Googles eigene Tabelle listet Claude Opus 5 bei 51,8%.
| Benchmark | DeepSeek V4.1 Flash | Gemini 3.8 Flash | Hinweise |
|---|---|---|---|
| Terminal-Bench 2.1 | 90,6% | 89,4% | Beide von den Anbietern gemessen; beide Tabellen setzen Claude Opus 5 bei 89,1% |
| DeepSWE v1.1 | 74,2% | 73,7% | Beide von den Anbietern gemessen; beide Tabellen setzen Claude Opus 5 bei 74,0% |
| Terminal-Bench 4.0 | 31,2% | 19,1% | Schwierigste gemeinsame Suite; Opus 5 bei 51,8% in beiden Tabellen |
Zwei Vorbehalte:
Für terminallastige Coding-Agents kannst du beide als ebenbürtig ansehen und Preis sowie Deployment entscheiden lassen; bei den härtesten Agent-Aufgaben ist DeepSeeks publizierter Vorsprung der einzige klare Unterschied.
Beim Preis gibt es keinen Wettbewerb, daher ist interessant, wie stark sich die Lücke je nach Lastprofil verändert.
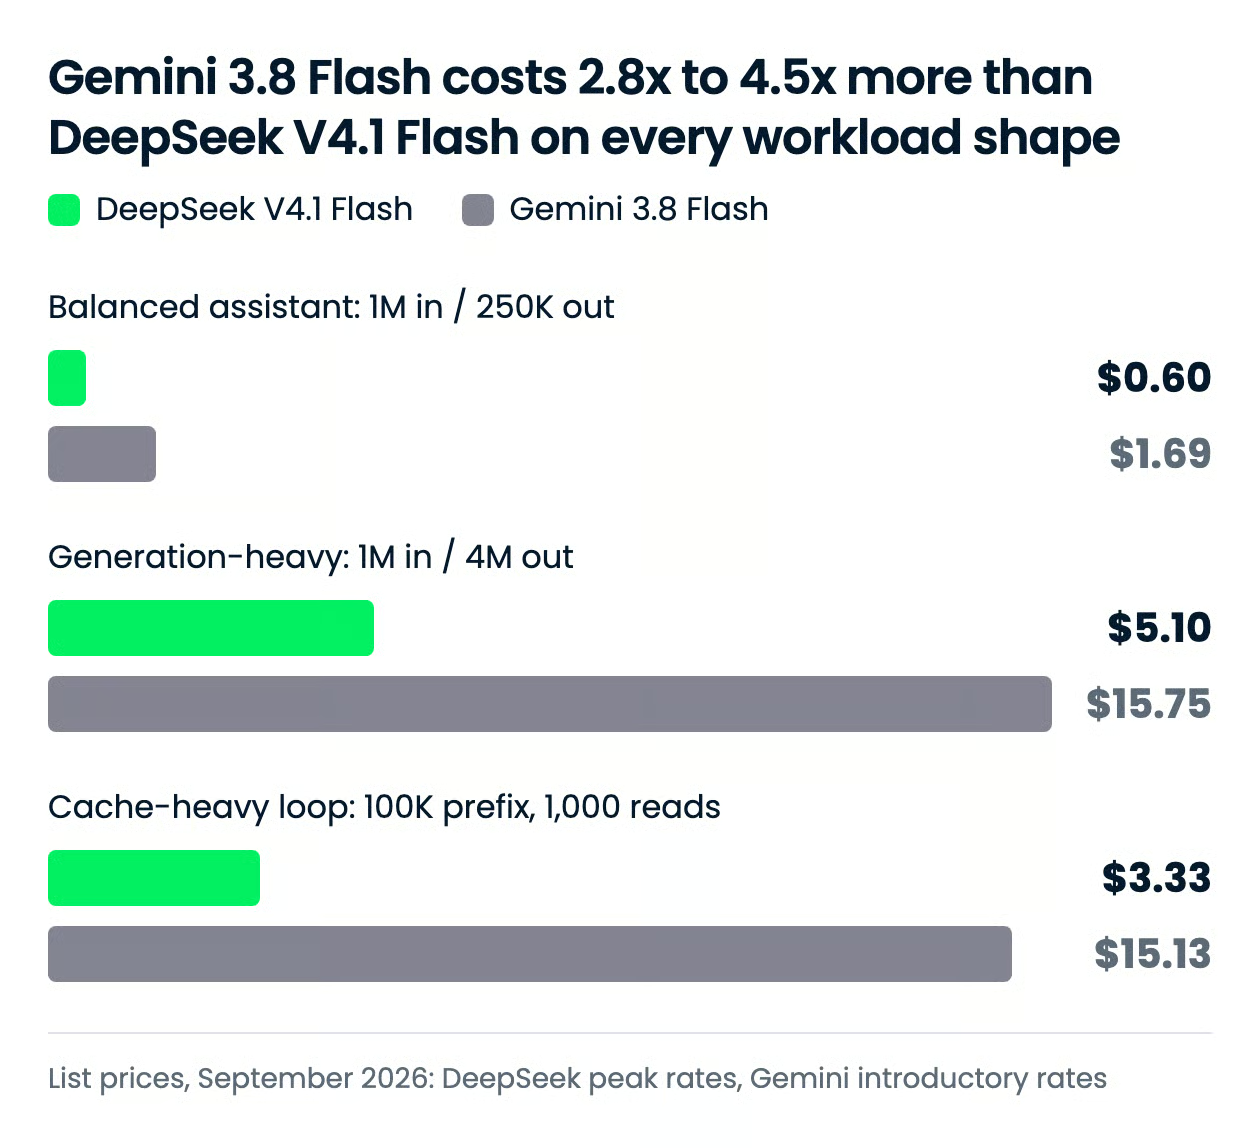
DeepSeek V4.1 Flash ist in jeder Zeile günstiger, und die Lücke wird größer, je stärker dein Workload auf Output-Tokens oder gecachte Präfixe setzt. Der Multiplikator ist nicht einheitlich – das ist der springende Punkt: 2,5x beim Input, 3,1x beim Output und 12,5x bei Cache-Reads.
| Rate | DeepSeek V4.1 Flash (Peak) | Gemini 3.8 Flash (bis 31. Dez 2026) |
|---|---|---|
| Input, pro 1 Mio. Tokens | $0,30 | $0,75 |
| Output, pro 1 Mio. Tokens | $1,20 | $3,75 |
| Gecachter Input-Read, pro 1 Mio. Tokens | $0,006 | $0,075 plus $0,50 pro 1 Mio. Tokens pro Stunde Storage |
| Rabattpfad | Off-Peak: 50% Rabatt auf alle Raten außerhalb 01:00–04:00 und 06:00–10:00 UTC an Werktagen | Batch oder Flex: 50% Rabatt ($0,375 / $1,875) |
| Reasoning-Tokens abgerechnet als | Output | Output |
| Ab 1. Januar 2027 | Keine Änderung angekündigt | $1,50 / $7,50; Cached Read $0,15 |
Der Unterschied sieht aus wie ein Output-Aufschlag. Geminis Output-Rate ist 3,1x DeepSeeks Rate, während die Input-Rate 2,5x beträgt. Damit zahlen generation- und thinking-lastige Workloads am meisten, und beide rechnen Reasoning-Tokens zum Output-Tarif ab.
| Workload | DeepSeek V4.1 Flash | Gemini 3.8 Flash | Unterschied |
|---|---|---|---|
| Ausgewogener Assistent: 1 Mio. in / 250K out | $0,60 | $1,69 | $1,09, Gemini 181% teurer |
| Generation-lastig: 1 Mio. in / 4 Mio. out | $5,10 | $15,75 | $10,65, Gemini 209% teurer |
| Cache-lastige Schleife: 100K-Präfix einmal geschrieben, 1.000 gecachte Reads, plus 5K fresh in / 1K out pro Request | $3,33 | $15,13 | $11,80, Gemini 354% teurer |
Die Formel lautet: (Volumen ÷ 1 Mio.) × Rate, summiert über Input und Output, zu DeepSeeks Peak-Raten und Geminis Einführungspreisen. In der Cache-Zeile nutzen wir die Cached-Read-Rate der Anbieter für die 1.000 Reads und unterstellen, dass Geminis Cache 1 Stunde gehalten wird (plus $0,05 Storage).
Die Cache-Zeile ist der Aufhänger: DeepSeeks Cached-Read-Rate von $0,006 macht ein Präfix mit 100K Tokens fast kostenlos beim erneuten Lesen, während Gemini $7,50 für dieselben 100 Mio. gecachten Tokens verlangt.
Planst du DeepSeek in die Off-Peak-Zeiten, halbiert sich jede Zeile; wartest du bis Januar, verdoppelt sich jede Gemini-Zeile – der ausgewogene Assistent wird dann $3,38 gegenüber $0,60.
DeepSeek V4.1 Flash ist das einzige der beiden Modelle, das du herunterladen kannst, und seine Architektur erklärt den Preisvorteil. Der Tech-Report beschreibt einen 20-Layer Causal Encoder vor einem 20-Layer Decoder, Compressed Sparse Attention 2 mit FP4-KV-Caching und einen KV-Cache von 890 Byte pro Token (zuvor 3.514 Byte bei V4 Flash).
Das Serving der MIT-lizensierten Gewichte ist noch früh: vLLM und SGLang unterstützen es in Nightly- bzw. Preview-Builds, Transformers noch nicht.
Wenn du Data Residency, On-Prem-Inferenz oder Fine-Tuning brauchst, ist DeepSeek hier die einzige Option. Wenn du Null-Infrastruktur willst, ist Geminis GA-Endpoint der einfachere Weg.
Gemini 3.8 Flash akzeptiert Text, Bilder, Video, Audio und PDF, während DeepSeek V4.1 Flash Text und Bilder nimmt. Beide bieten ein Kontextfenster mit 1 Mio. Tokens, aber DeepSeek erlaubt bis zu 384K Output-Tokens gegenüber 64K bei Gemini – wichtig für lange Code-Generierung und komplette Dokumentumschreibungen.
Geminis Modellseite listet zudem gehostete Tools, für die DeepSeek kein Pendant hat: Codeausführung, Google Search- und Maps-Grounding, Dateisuche, URL-Kontext und Computersteuerung (Preview). DeepSeeks API-Seite bietet JSON-Output, Tool Calls, eine Responses API, einen Anthropic-kompatiblen Endpoint sowie Prefix- und Fill-in-the-Middle-Completion.
Wenn deine Inputs Audio oder Video enthalten oder du Grounding ohne eigenes Retrieval brauchst, nimm Gemini; wenn du lange Outputs und Drop-in-Kompatibilität zu bestehendem OpenAI- oder Anthropic-Client-Code willst, ist es DeepSeek.
Benchmarks von zwei Anbietern haben Grenzen, daher habe ich einen Build-Task auf beiden mit identischem Prompt und identischen Tools ausgeführt.
Ich habe beide gebeten, eine zustandsbehaftete Single-File-Web-App für die Probenplanung eines Community-Orchesters zu bauen. Zwei explizit geforderte Features: Erkennung von Intervall-Überlappungen und Persistenz. Beide liegen nahe 90% auf Terminal-Bench 2.1, aber DeepSeeks 31,2% gegenüber Geminis 19,1% auf Terminal-Bench 4.0 deuten auf einen Abstand bei schwierigeren agentischen Aufgaben hin – dieser Task ist ein kompakter Check dafür.
Beide liefen in OpenCode mit identischer, fixierter Tool-Oberfläche: Dateien lesen und bearbeiten, kein Shell, kein Netzwerk. Beide liefen auf high Reasoning-Effort, je ein Versuch, keine Retries, und der Prompt wurde Byte-für-Byte in eine frische Session gegeben.
Eine Asymmetrie: high ist Geminis höchste Effort-Stufe, während es bei DeepSeek 75 auf einer 1-bis-100-Skala entspricht, deren Maximum den publizierten Benchmark-Scores zugrunde liegt.
Das war der Prompt:
Build a single-file HTML page (inline CSS and JS, no build step, no external dependencies, no network) for a rehearsal scheduler used by a community orchestra.
It needs:
- a week view (Mon–Sun) showing rehearsal blocks by section: strings, brass, woodwind, percussion;
- a conflict indicator that flags when two sections are booked in the same room at overlapping times (not merely the same slot);
- an add-rehearsal form with section, room, day, start time, and end time;
- localStorage persistence, so rehearsals survive a page reload.

Ship it as one working file named `index.html`. Do not install packages. Do not open, screenshot, or headless-render the page (no Playwright, Puppeteer, or Chrome).
Do not ask me clarifying questions — make reasonable assumptions and note them briefly in a comment at the top of the file.
Ich habe beide auf Lauf- und Funktionsfähigkeit (fail/pass) und anhand dreier Rubriken mit 1 bis 5 Punkten bewertet:
DeepSeek war in 2 Zügen fertig mit einem Tool-Call: Es schrieb eine 13-KB-index.html und meldete Abschluss. Die Seite hat ein dunkles Zweispalten-Layout: links das Formular zum Hinzufügen, rechts ein Montag-bis-Sonntag-Grid, darunter ein Konflikt-Check-Panel. Im Header-Kommentar ist die Überlappungsregel erläutert – strikte Überlappung, Back-to-Back ausgenommen – und der Test bestätigte, dass nur das überlappende Paar geflaggt wird.
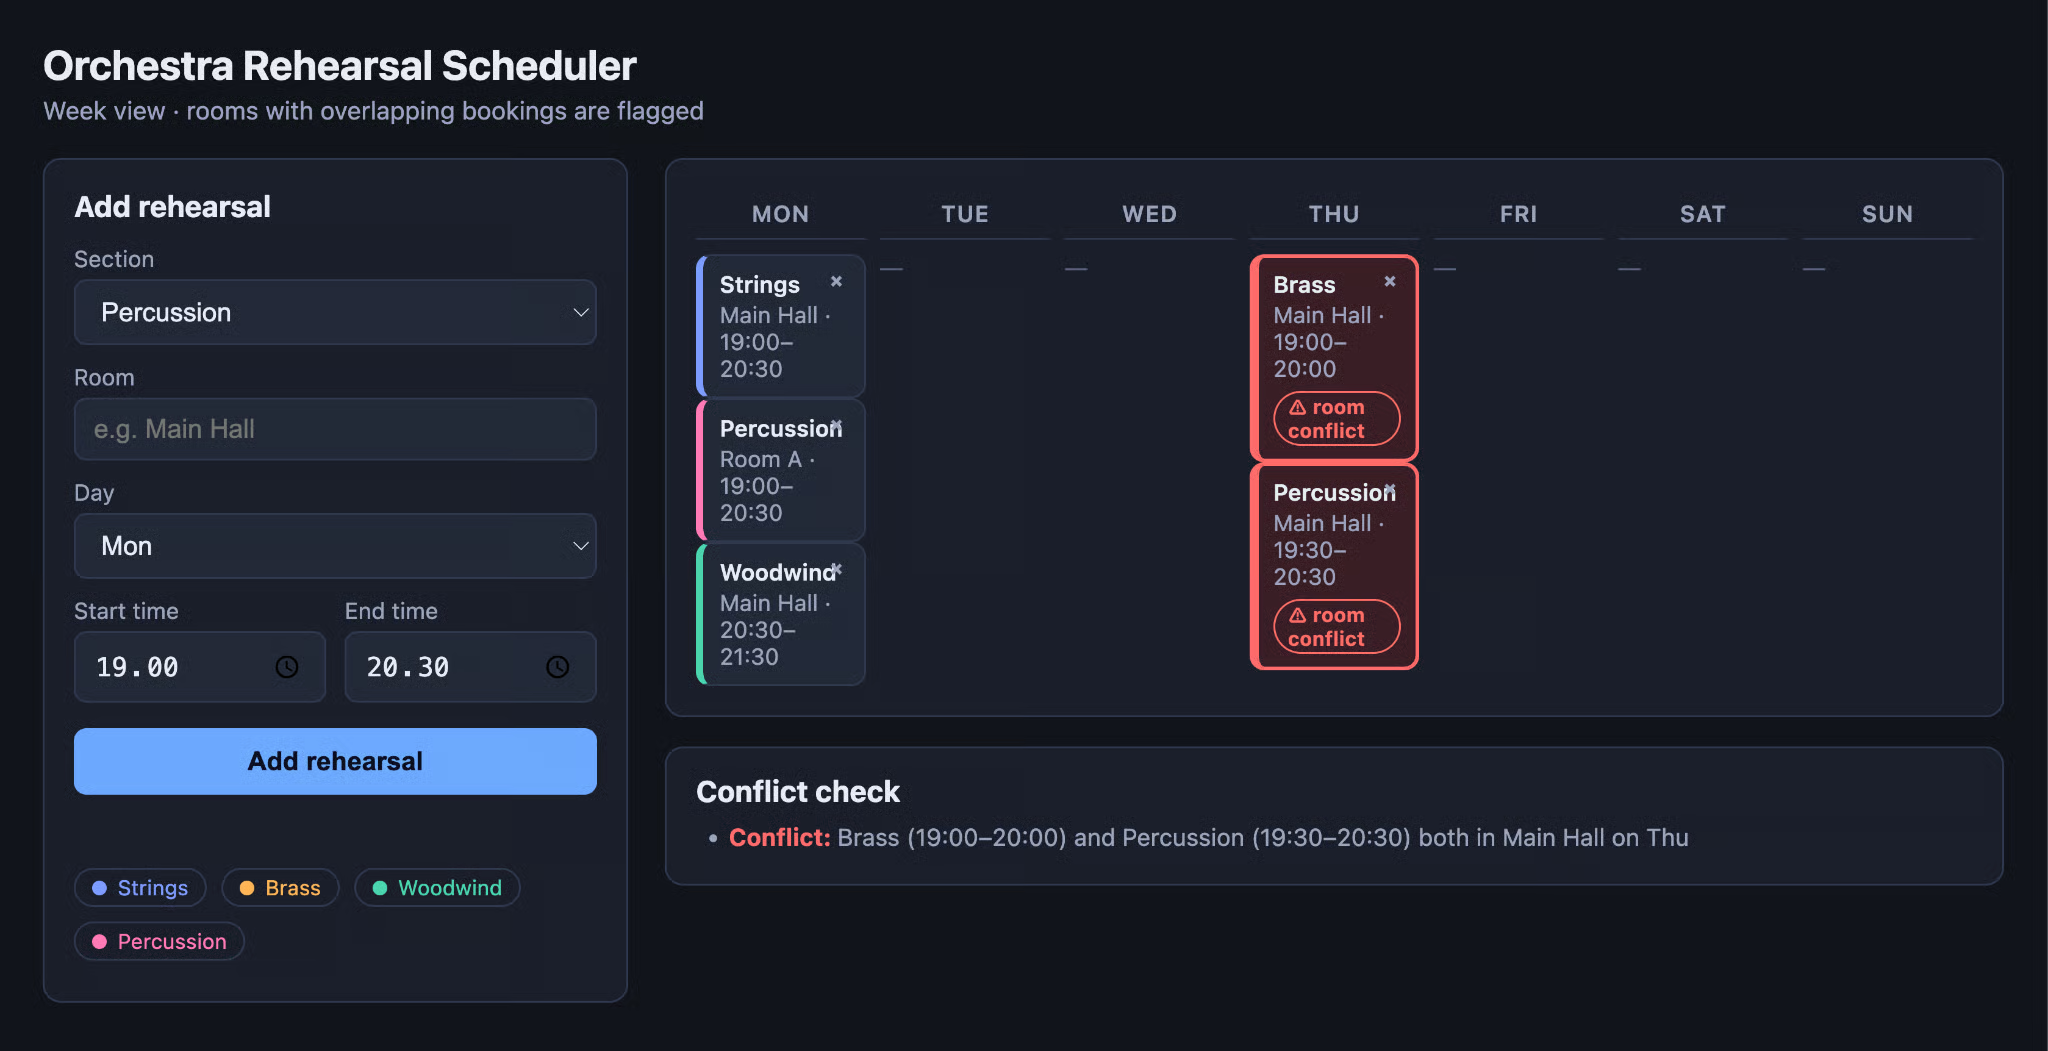
Alles Geforderte ist vorhanden und funktioniert, das Layout ist auf einen Blick erfassbar, und das einzige Extra – Einträge löschen – hilft. Bearbeiten ist nicht möglich, war aber nicht gefordert. Das sind saubere 5 in allen drei Rubriken.
Gemini brauchte 4 Züge und 3 Tool-Calls (glob, read, write) für eine 76-KB-index.html (fast 6x DeepSeek) und war deutlich langsamer. Das Ergebnis wirkt polierter: ein gebrandeter Header mit Live-Zähler für Überlappungen, eine vorbefüllte Beispielwoche mit absichtlicher Doppelbelegung am Mittwoch, damit der Indikator sofort anspringt, Filter für Sektion und Raum, ein „nur Konflikte“-Toggle, Spalten- und Zeitachsen-Ansicht, Bearbeiten und Löschen, ein Repertoire-Notizfeld und eine Live-Warnvorschau beim Tippen einer neuen Buchung.
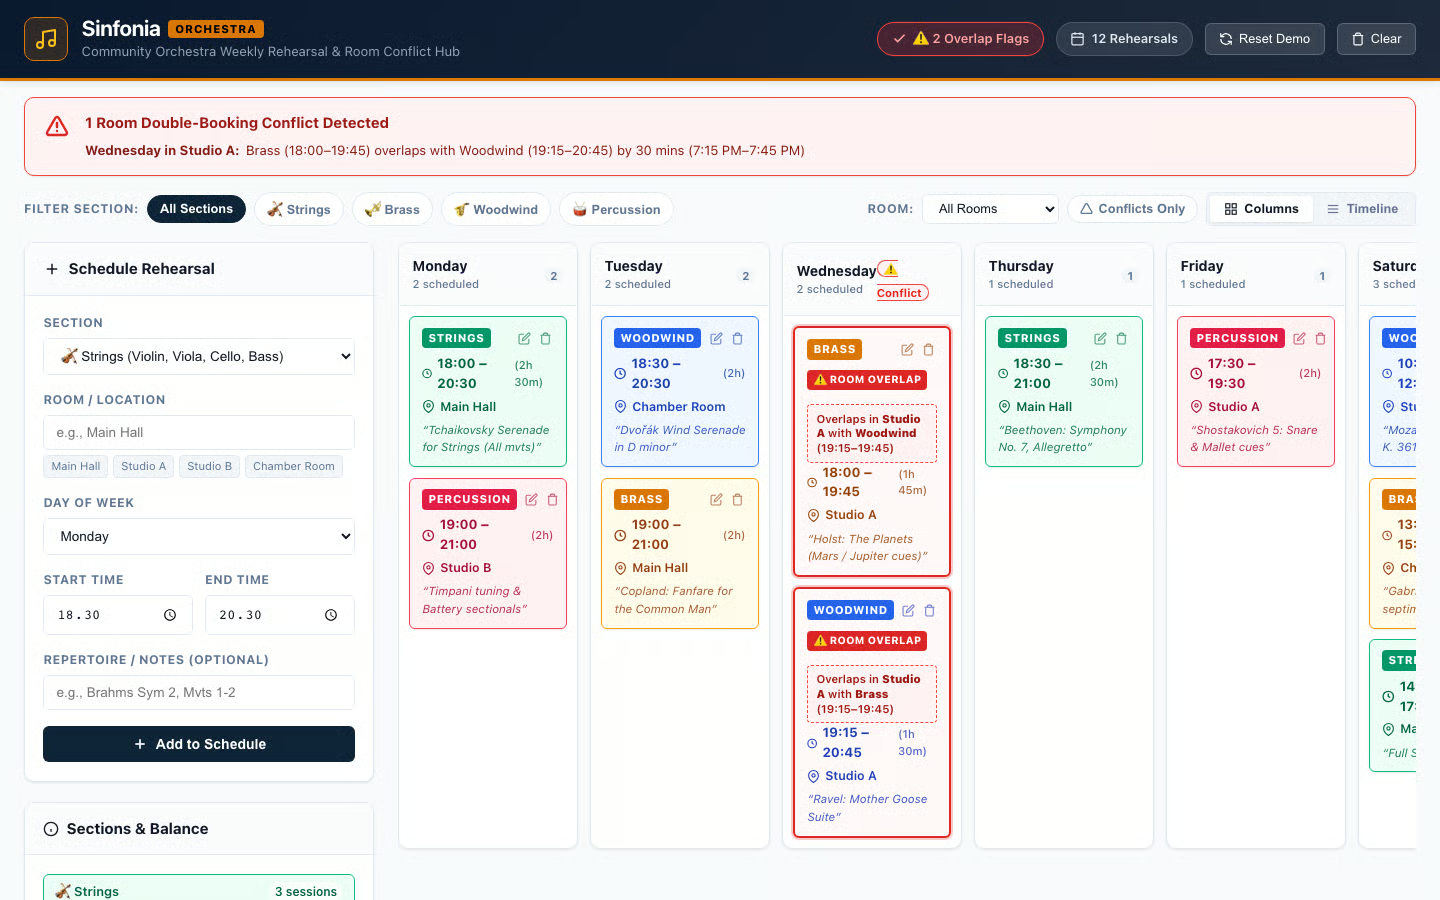
Die Konfliktlogik ist korrekt, der Test flaggte nur das überlappende Paar. Die Extras sind das Problem: Ein „Sections and Balance“-Panel mit Sektionszählungen zwingt die Formularspalte zum Scrollen (widerspricht dem Prompt) und sitzt gestalterisch schräg darunter, und die Vielzahl an Controls erschwert den Wochenüberblick gegenüber DeepSeek. Daher ziehe ich je einen Punkt bei Spec-Erfüllung und Layout ab, auch wenn das Gesamtergebnis stark ist.
| Messgröße | DeepSeek V4.1 Flash | Gemini 3.8 Flash |
|---|---|---|
| Züge | 2 | 4 |
| Tool-Calls | 1 | 3 |
| Lauffähigkeit | pass | pass |
| Spec-Erfüllung | 5 | 4 |
| Konfliktlogik | 5 | 5 |
| Usability und Layout | 5 | 4 |
| Rubrik-Score (Mittel der drei Achsen) | 5,0 | 4,3 |
DeepSeek V4.1 Flash gewinnt diesen Test. Beide haben das Schwierige – die Intervallüberlappung – korrekt umgesetzt, der Unterschied lag im Urteilsvermögen: DeepSeek baute genau das Geforderte in einem Write, Gemini baute ein kleines Produkt – und ein ungefragtes Feature schadete dem Layout, auf dem bewertet wurde. Geminis Version würde ich einer Orchesterleitung zeigen; DeepSeeks Version würde ich mir von einer Kollegin wünschen.
Das ist ein einzelner Lauf einer Aufgabe bei einem Effort-Level – ohne Aussage zu Tokenverbrauch oder Kosten – und es prüft nur zustandsbehaftete UI plus Überlappungslogik, nicht langfristige Repository-Arbeit.
Keines der Modelle ist die Standardwahl für alle – hier die Entscheidung nach Workload.
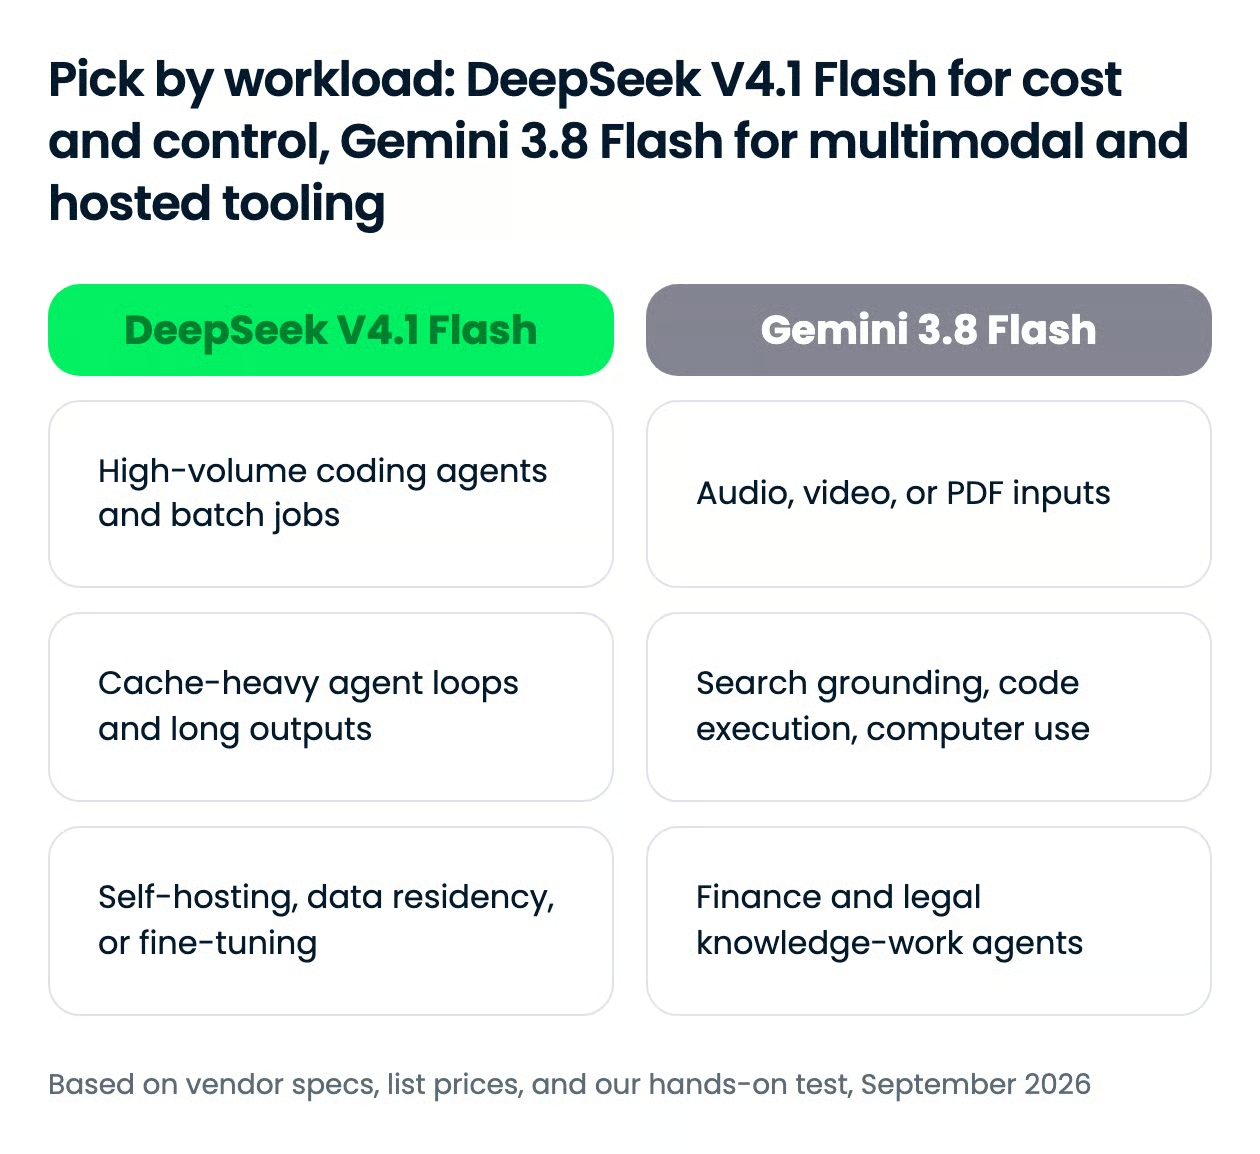
Der Knackpunkt sind Inputs, Infrastruktur und Budget: Beim agentischen Coding sind beide auf Augenhöhe, daher gewinnt DeepSeek, wenn Kosten oder Kontrolle zählen, und Gemini, wenn deine Daten oder dein Stack etwas sind, das DeepSeek nicht verarbeiten oder für dich hosten kann.
Wo du die Modelle nutzen kannst, unterscheidet sich stärker als das, was sie können – prüfe die Matrix vor den Benchmarks.
| Surface | DeepSeek V4.1 Flash | Gemini 3.8 Flash |
|---|---|---|
| Consumer-App | DeepSeek App und chat.deepseek.com | Gemini App (Google AI Pro und Ultra), AI Mode in Search, Gemini in Sheets |
| First-Party-API | Ja, DeepSeek API (OpenAI- und Anthropic-Request-Formate) | Ja, Gemini API über Google AI Studio (GA) |
| Cloud-Plattformen | Kein First-Party-Cloud-Listing; via Databricks u. a. oder selbst gehostete MIT-Gewichte | Gemini Enterprise auf Google Cloud |
| Coding-Agents | DeepSeek Harness; OpenCode, WorkBuddy und CodeBuddy (offizielle Partner) | Google Antigravity (Default-Modell), Android Studio, Stitch; Cursor, OpenCode |
| Drittanbieter-Router | OpenRouter | OpenRouter |
| API-Model-ID | deepseek-flash |
gemini-3.8-flash |
Der größte Verfügbarkeitsunterschied: DeepSeek ist downloadbar, Gemini nicht – während Gemini die Consumer-App und eine gemanagte Enterprise-Plattform mitbringt. Die IDs, die du einsetzt, sind deepseek-flash und gemini-3.8-flash; der Legacy-Name deepseek-v4-flash löst weiterhin auf, wird aber von V4.1 Flash bedient.
Die SDKs unterscheiden sich, es ist also kein 1:1-Tausch. DeepSeeks Endpoint ist OpenAI-kompatibel, d. h. der Standard-Client openai funktioniert mit geänderter Base-URL, während Gemini 3.8 Flash die google-genai Interactions API mit einem thinking_level anstelle klassischer Sampling-Parameter nutzt.
from openai import OpenAI

client = OpenAI(api_key="YOUR_DEEPSEEK_KEY", base_url="https://api.deepseek.com")
response = client.chat.completions.create(
    model="deepseek-flash",  # DeepSeek V4.1 Flash
    messages=[{"role": "user", "content": "Refactor this function..."}],
)
print(response.choices[0].message.content)
from google import genai
client = genai.Client() # reads your Google AI Studio API key
interaction = client.interactions.create(
model="gemini-3.8-flash",
input="Refactor this function...",
generation_config={"thinking_level": "medium"}, # low, medium, or high
)
print(interaction.output_text)Für das komplette Setup, PDF-Extraktion und Function Calling auf Gemini folge unserem Gemini 3.8 Flash API Tutorial; für DeepSeeks Thinking Mode und ein lokales Deployment der Vorgängergeneration sieh dir unser DeepSeek V4 API Tutorial und den Guide zum Betrieb von DeepSeek V4 Flash mit Unsloth Studio und OpenCode an.
Wenn dein Workload aus Coding-Agents, Batch-Jobs oder allem besteht, was lange Präfixe erneut liest, nutze DeepSeek V4.1 Flash: Es liegt bei den veröffentlichten agentischen Benchmarks auf Augenhöhe mit Gemini 3.8 Flash, gewann unseren Build-Test in 2 Zügen und kostet vor Geminis Preiserhöhung im Januar nur ein Drittel. Wenn deine Inputs Audio, Video oder PDFs sind oder du Grounding, Codeausführung und Computersteuerung aus einem gehosteten Endpoint willst, nutze Gemini 3.8 Flash und akzeptiere den Aufpreis.
Wenn du Agent-Systeme um solche Modelle bauen willst, deckt unser Lernpfad Associate AI Engineer for Developers APIs, Tool Use und das Model Context Protocol in 29 Stunden ab, und unser Kurs Building AI Agents with Google ADK ist ein einstündiger Einstieg auf der Gemini-Seite.
Lerne KI mit DataCamp!
Lernpfad
Kurs
Kurs
Blog
Nisha Arya Ahmed
15 Min.
Blog
Hesam Sheikh Hassani
15 Min.
Blog
Zoumana Keita
15 Min.
Blog
Nathaniel Taylor-Leach
Blog
Tutorial
Matt Crabtree
5 Min.


