
programa
Fundamentos de agentes de IA
6 h
Google lanzó Gemini 3.8 Flash el 2 de septiembre de 2026, su tercera versión Flash en seis semanas. Ocho días después, DeepSeek respondió con DeepSeek V4.1 Flash, un modelo mixture-of-experts con licencia MIT de 552B que activa 8B parámetros en la entrada y 16B en la salida.
Ambos proveedores presentan su modelo como caballo de batalla para agentes de código y logran puntuaciones similares en los benchmarks más importantes. Esto complica la elección más allá del típico marco abierto vs cerrado, porque el modelo más barato no es el más débil en las pruebas que comparten.
En este artículo, comparo DeepSeek V4.1 Flash y Gemini 3.8 Flash en benchmarks, precios, apertura, multimodalidad y en una prueba práctica de construcción que ejecuté en ambos.
Si quieres un análisis más a fondo de cada modelo por separado, consulta nuestra guía de DeepSeek V4.1 Flash y nuestra guía de Gemini 3.8 Flash y 3.8 Flash Cyber.
DeepSeek V4.1 Flash es un modelo de pesos abiertos con licencia MIT, de tipo mixture-of-experts, publicado por DeepSeek el 10 de septiembre de 2026, y el miembro más pequeño de una nueva familia de arquitectura.
Según el informe técnico de V4.1, su caché KV necesita 890 bytes por token, aproximadamente una cuarta parte de lo que requería DeepSeek V4 Flash, de donde proviene la mayor parte del ahorro de costes.
Para un desglose completo, lee nuestra guía de DeepSeek V4.1 Flash y, para una instalación local de la generación anterior, nuestro tutorial sobre cómo ejecutar DeepSeek V4 Flash con Unsloth Studio y OpenCode.
Gemini 3.8 Flash es el modelo más capaz de la gama Flash de Google, lanzado el 2 de septiembre de 2026, tres semanas después de Gemini 3.7 Flash y construido sobre él.
Su rasgo de diseño distintivo es que "trabaja más": en tareas complejas, ejecuta pasos de razonamiento adicionales y llama a herramientas de forma iterativa, y Google indica que puede consumir más tokens a mayores niveles de esfuerzo.
Nuestra guía de Gemini 3.8 Flash cubre el lanzamiento y la variante Cyber de acceso limitado, y nuestro tutorial de la API de Gemini 3.8 Flash repasa la Interactions API, los niveles de pensamiento y las llamadas a funciones en Python.
En las seis dimensiones siguientes, DeepSeek V4.1 Flash gana en precio y apertura y empata en programación, mientras que Gemini 3.8 Flash gana en tipos de entrada, herramientas y resultados publicados en trabajo del conocimiento.
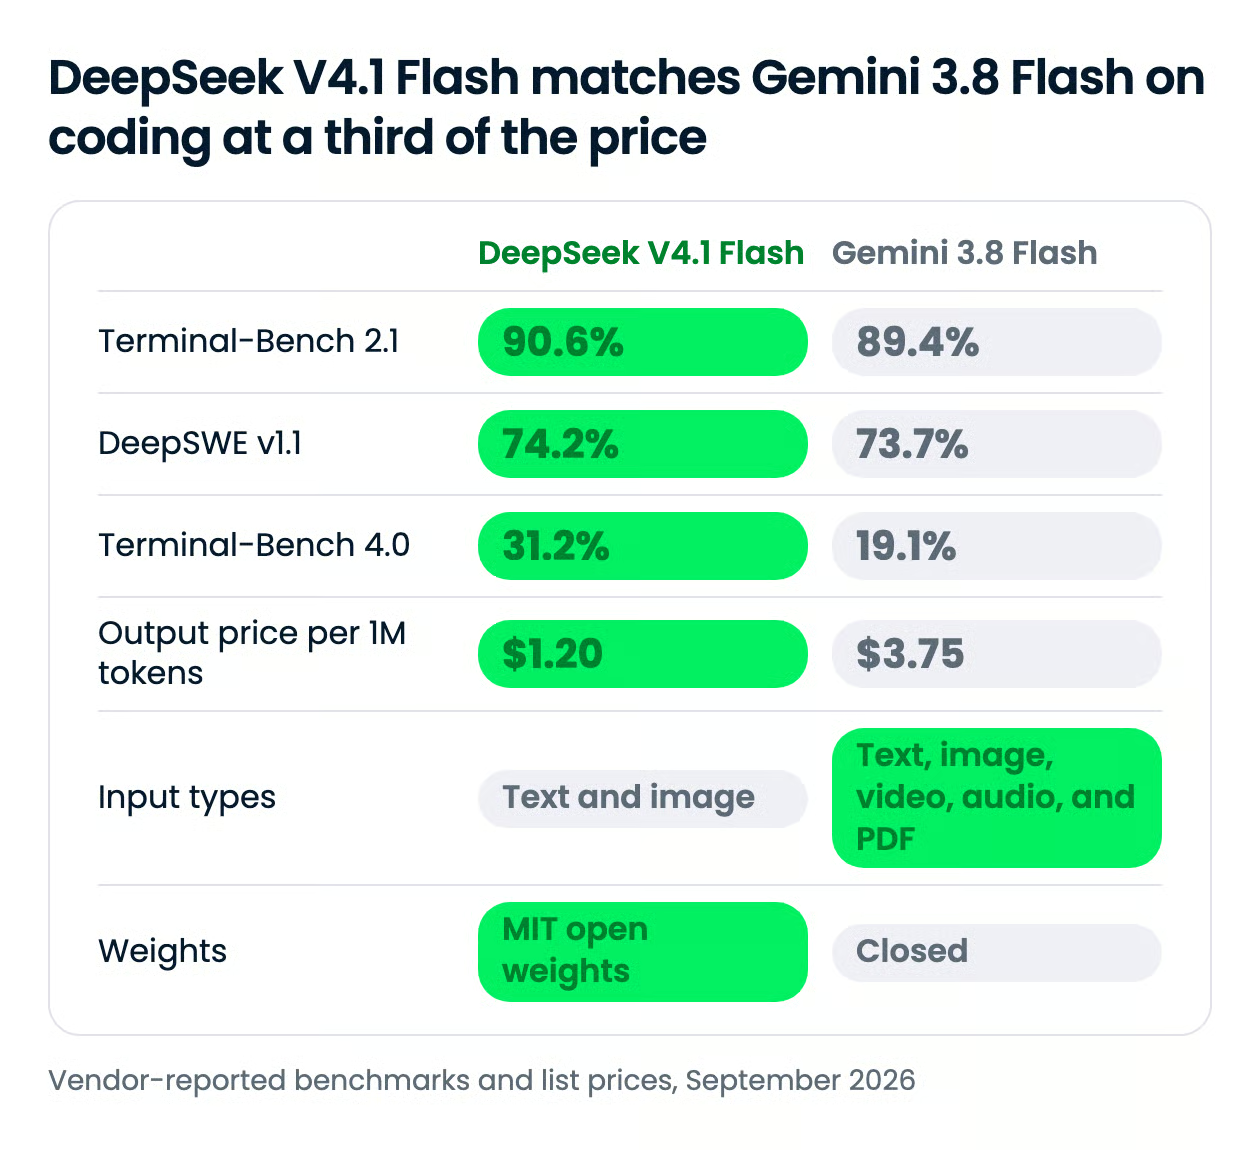
| Característica | DeepSeek V4.1 Flash | Gemini 3.8 Flash |
|---|---|---|
| Lanzamiento | 10 de septiembre de 2026 | 2 de septiembre de 2026 |
| Pesos y licencia | Abiertos, MIT | Cerrado, alojado |
| Arquitectura | 552B MoE, 8B activos en prefill, 16B en decodificación | No divulgada; basada en Gemini 3.7 Flash |
| Contexto / salida máx. | 1M tokens / 384K | 1M tokens / 64K |
| Tipos de entrada | Texto, imagen | Texto, imagen, vídeo, audio, PDF |
| Terminal-Bench 2.1 | 90,6% | 89,4% |
| DeepSWE v1.1 | 74,2% | 73,7% |
| Ajustes de esfuerzo de razonamiento | low, high, max en la API (entero 1-100 por debajo) |
low, medium, high |
| Precio API, entrada / salida por 1M | $0,30 / $1,20 (horas punta) | $0,75 / $3,75 (hasta 2026; después 2x) |
DeepSeek V4.1 Flash lidera en los tres benchmarks de agentes que aparecen en las tablas de ambos proveedores, aunque dos diferencias son lo bastante pequeñas como para considerarlas un empate.
La brecha que realmente importa es Terminal-Bench 4.0, la batería más dura de agente generalista: 31,2% para DeepSeek frente a 19,1% para Gemini. Ambos reconocen que esta suite los pone a prueba; DeepSeek admite que persiste una brecha frente a modelos gigantes en tareas científicas con agentes, y la propia tabla de Google sitúa a Claude Opus 5 en 51,8%.
| Benchmark | DeepSeek V4.1 Flash | Gemini 3.8 Flash | Notas |
|---|---|---|---|
| Terminal-Bench 2.1 | 90,6% | 89,4% | Ambos ejecutados por los proveedores; ambas tablas sitúan a Claude Opus 5 en 89,1% |
| DeepSWE v1.1 | 74,2% | 73,7% | Ambos ejecutados por los proveedores; ambas tablas sitúan a Claude Opus 5 en 74,0% |
| Terminal-Bench 4.0 | 31,2% | 19,1% | Suite compartida más difícil; Opus 5 en 51,8% en ambas tablas |
Dos matices:
Para agentes de programación centrados en terminal, trátalos como equivalentes y deja que decidan el precio y el despliegue; en las tareas de agente más duras, la ventaja publicada de DeepSeek es la única diferencia clara.
El precio es la única dimensión sin discusión, así que la pregunta interesante es cuánto cambia la brecha según el perfil de tu carga.
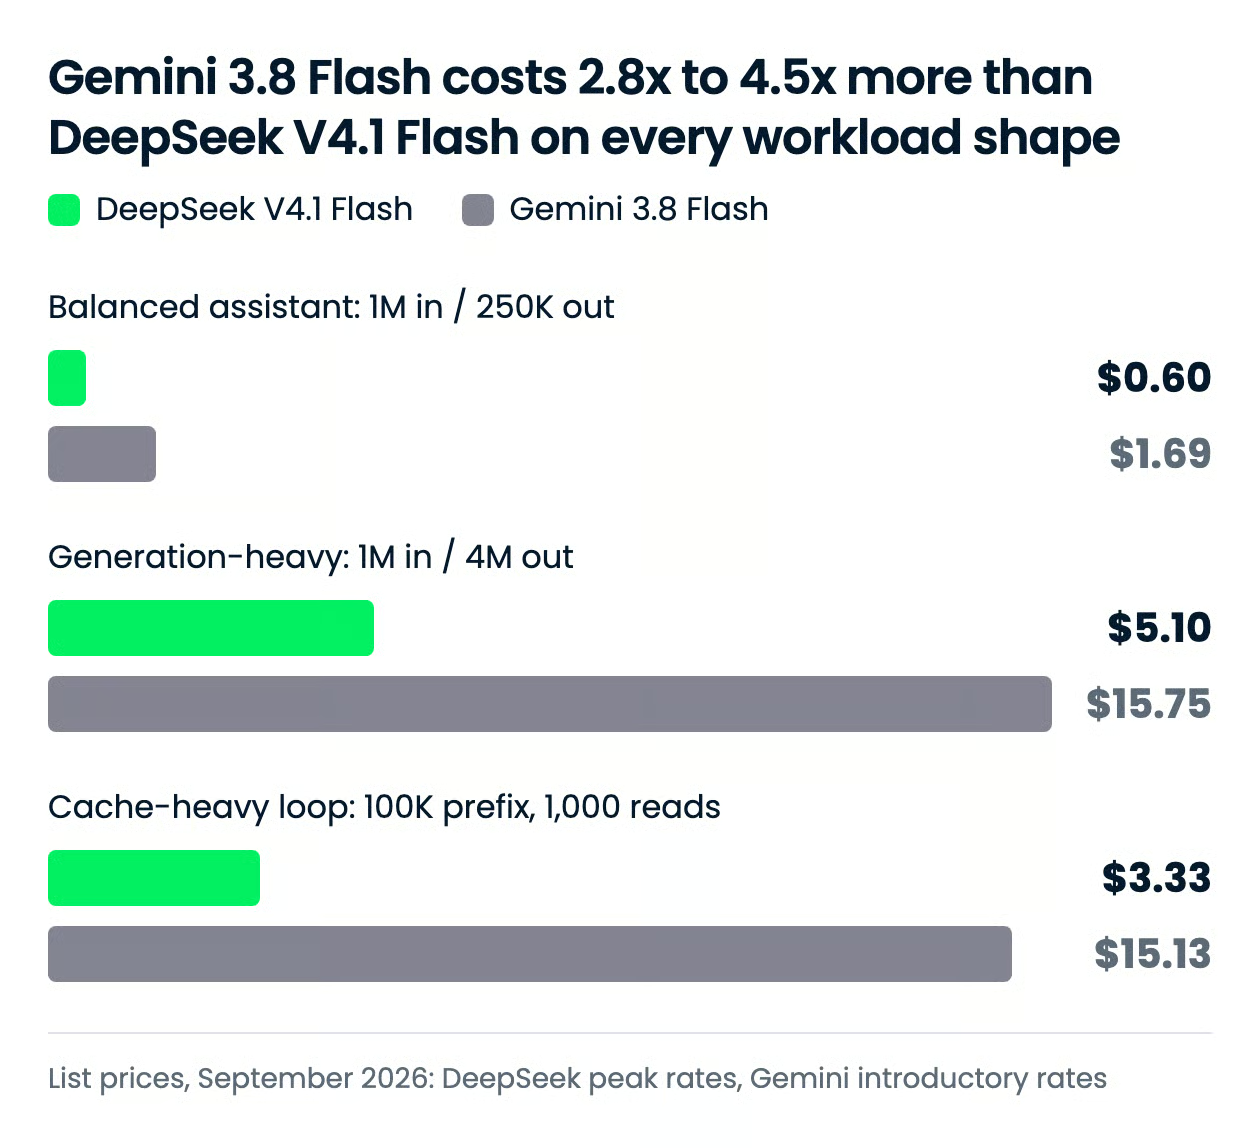
DeepSeek V4.1 Flash es más barato en todas las líneas, y la brecha se amplía cuanto más depende tu carga de tokens de salida o de prefijos en caché. El múltiplo no es uniforme, y ahí está la clave: 2,5x en entrada, 3,1x en salida y 12,5x en lecturas en caché.
| Tarifa | DeepSeek V4.1 Flash (horas punta) | Gemini 3.8 Flash (hasta 31 dic 2026) |
|---|---|---|
| Entrada, por 1M tokens | $0,30 | $0,75 |
| Salida, por 1M tokens | $1,20 | $3,75 |
| Lectura de entrada en caché, por 1M tokens | $0,006 | $0,075, más $0,50 por 1M tokens por hora de almacenamiento |
| Ruta con descuento | Fuera de punta: 50% de descuento en todas las tarifas fuera de 01:00-04:00 y 06:00-10:00 UTC en días laborables | Batch o Flex: 50% de descuento ($0,375 / $1,875) |
| Tokens de razonamiento facturados como | Salida | Salida |
| Desde el 1 de enero de 2027 | Sin cambios anunciados | $1,50 / $7,50; lectura en caché $0,15 |
La diferencia tiene forma de prima en la salida. La tarifa de salida de Gemini es 3,1x la de DeepSeek, mientras que la de entrada es 2,5x, así que el trabajo con mucha generación y razonamiento paga más, y ambos facturan los tokens de razonamiento a la tarifa de salida.
| Carga | DeepSeek V4.1 Flash | Gemini 3.8 Flash | Diferencia |
|---|---|---|---|
| Asistente equilibrado: 1M in / 250K out | $0,60 | $1,69 | $1,09, Gemini un 181% más |
| Mucha generación: 1M in / 4M out | $5,10 | $15,75 | $10,65, Gemini un 209% más |
| Bucle con mucha caché: prefijo de 100K escrito una vez, 1.000 lecturas en caché, más 5K nuevos in / 1K out por petición | $3,33 | $15,13 | $11,80, Gemini un 354% más |
La fórmula es (volumen ÷ 1M) × tarifa, sumado entre entrada y salida, con las tarifas punta de DeepSeek y las introductorias de Gemini. La fila con mucha caché usa la tarifa de lectura en caché de cada proveedor para las 1.000 lecturas y asume que la caché de Gemini se mantiene 1 hora, lo que añade $0,05 de almacenamiento.
La fila con mucha caché es la titular, porque la tarifa de $0,006 por 1M tokens en lectura en caché de DeepSeek hace que un prefijo de 100K tokens sea casi gratis de releer, mientras que Gemini cobra $7,50 por esos mismos 100M tokens en caché.
Si programas DeepSeek fuera de horas punta, cada fila se reduce a la mitad; si esperas a enero, cada fila de Gemini se duplica, así que el asistente equilibrado pasa a $3,38 frente a $0,60.
DeepSeek V4.1 Flash es el único de los dos que puedes descargar, y su arquitectura explica por qué es barato. El informe técnico describe un codificador causal de 20 capas que alimenta a un decodificador de 20 capas, Compressed Sparse Attention 2 con caché KV en FP4, y una caché KV de 890 bytes por token, frente a 3.514 bytes en V4 Flash.
Servir esos pesos con licencia MIT aún está verde: vLLM y SGLang los soportan en builds nocturnas y de vista previa, y Transformers todavía no los soporta.
Si necesitas residencia de datos, inferencia on-prem o ajuste fino, DeepSeek es el único candidato aquí. Si quieres cero infraestructura, el endpoint alojado GA de Gemini es el camino más sencillo.
Gemini 3.8 Flash acepta texto, imágenes, vídeo, audio y PDF, mientras que DeepSeek V4.1 Flash acepta texto e imágenes. Ambos ofrecen una ventana de contexto de 1M de tokens, pero DeepSeek permite hasta 384K tokens de salida, frente a los 64K de Gemini, algo clave para generar código largo y reescrituras de documentos completos.
La página del modelo de Gemini también lista herramientas alojadas para las que DeepSeek no tiene equivalente: ejecución de código, grounding con Google Search y Maps, búsqueda de archivos, contexto por URL y control del ordenador en vista previa. En el lado de la API de DeepSeek hay salida JSON, llamadas a herramientas, una Responses API, un endpoint con formato Anthropic y completado por prefijo y fill-in-the-middle.
Si tus entradas incluyen audio o vídeo, o quieres grounding sin construir un sistema de recuperación, la elección es Gemini; si quieres salidas largas y compatibilidad inmediata con clientes existentes de OpenAI o Anthropic, es DeepSeek.
Los benchmarks de dos proveedores distintos llegan hasta cierto punto, así que ejecuté una tarea de construcción en ambos modelos con el mismo prompt y las mismas herramientas.
Pedí a ambos que construyeran una aplicación web de una sola página y con estado para un planificador de ensayos de una orquesta comunitaria. Dos funciones solicitadas explícitamente fueron la detección de conflictos por solapamiento de intervalos y la persistencia. Ambos modelos rondan el 90% en Terminal-Bench 2.1, pero el 31,2% de DeepSeek frente al 19,1% de Gemini en Terminal-Bench 4.0 sugiere una brecha en trabajos de agente más difíciles, y esta tarea es una forma compacta de buscarla.
Ambos modelos se ejecutaron dentro de OpenCode con la misma superficie de herramientas fijada: solo lectura y edición de archivos, sin shell y sin red. Ambos se ejecutaron con esfuerzo de razonamiento high, un intento cada uno, sin reintentos, y el prompt se entregó byte a byte en una sesión nueva.
Una asimetría a tener en cuenta: high es el nivel de esfuerzo más alto de Gemini, mientras que en DeepSeek equivale a 75 en una escala de 1 a 100, cuyo máximo coincide con el usado en sus puntuaciones publicadas de benchmarks.
Este fue el prompt:
Build a single-file HTML page (inline CSS and JS, no build step, no external dependencies, no network) for a rehearsal scheduler used by a community orchestra.
It needs:
- a week view (Mon–Sun) showing rehearsal blocks by section: strings, brass, woodwind, percussion;
- a conflict indicator that flags when two sections are booked in the same room at overlapping times (not merely the same slot);
- an add-rehearsal form with section, room, day, start time, and end time;
- localStorage persistence, so rehearsals survive a page reload.

Ship it as one working file named `index.html`. Do not install packages. Do not open, screenshot, or headless-render the page (no Playwright, Puppeteer, or Chrome).
Do not ask me clarifying questions — make reasonable assumptions and note them briefly in a comment at the top of the file.
Evalué ambos por capacidad de ejecución (falla/pasa) y en las siguientes tres rúbricas, con puntuaciones de 1 a 5:
DeepSeek terminó en 2 turnos con una única llamada a herramienta: escribió un index.html de 13 KB y dio por finalizado. La página es un diseño oscuro de dos paneles: un formulario para añadir ensayos a la izquierda, una cuadrícula de lunes a domingo a la derecha, con un panel de comprobación de conflictos debajo. Su comentario de cabecera explica la regla de solape: solape estricto con reservas consecutivas exentas, y la prueba confirmó que solo marca el par que se solapa.
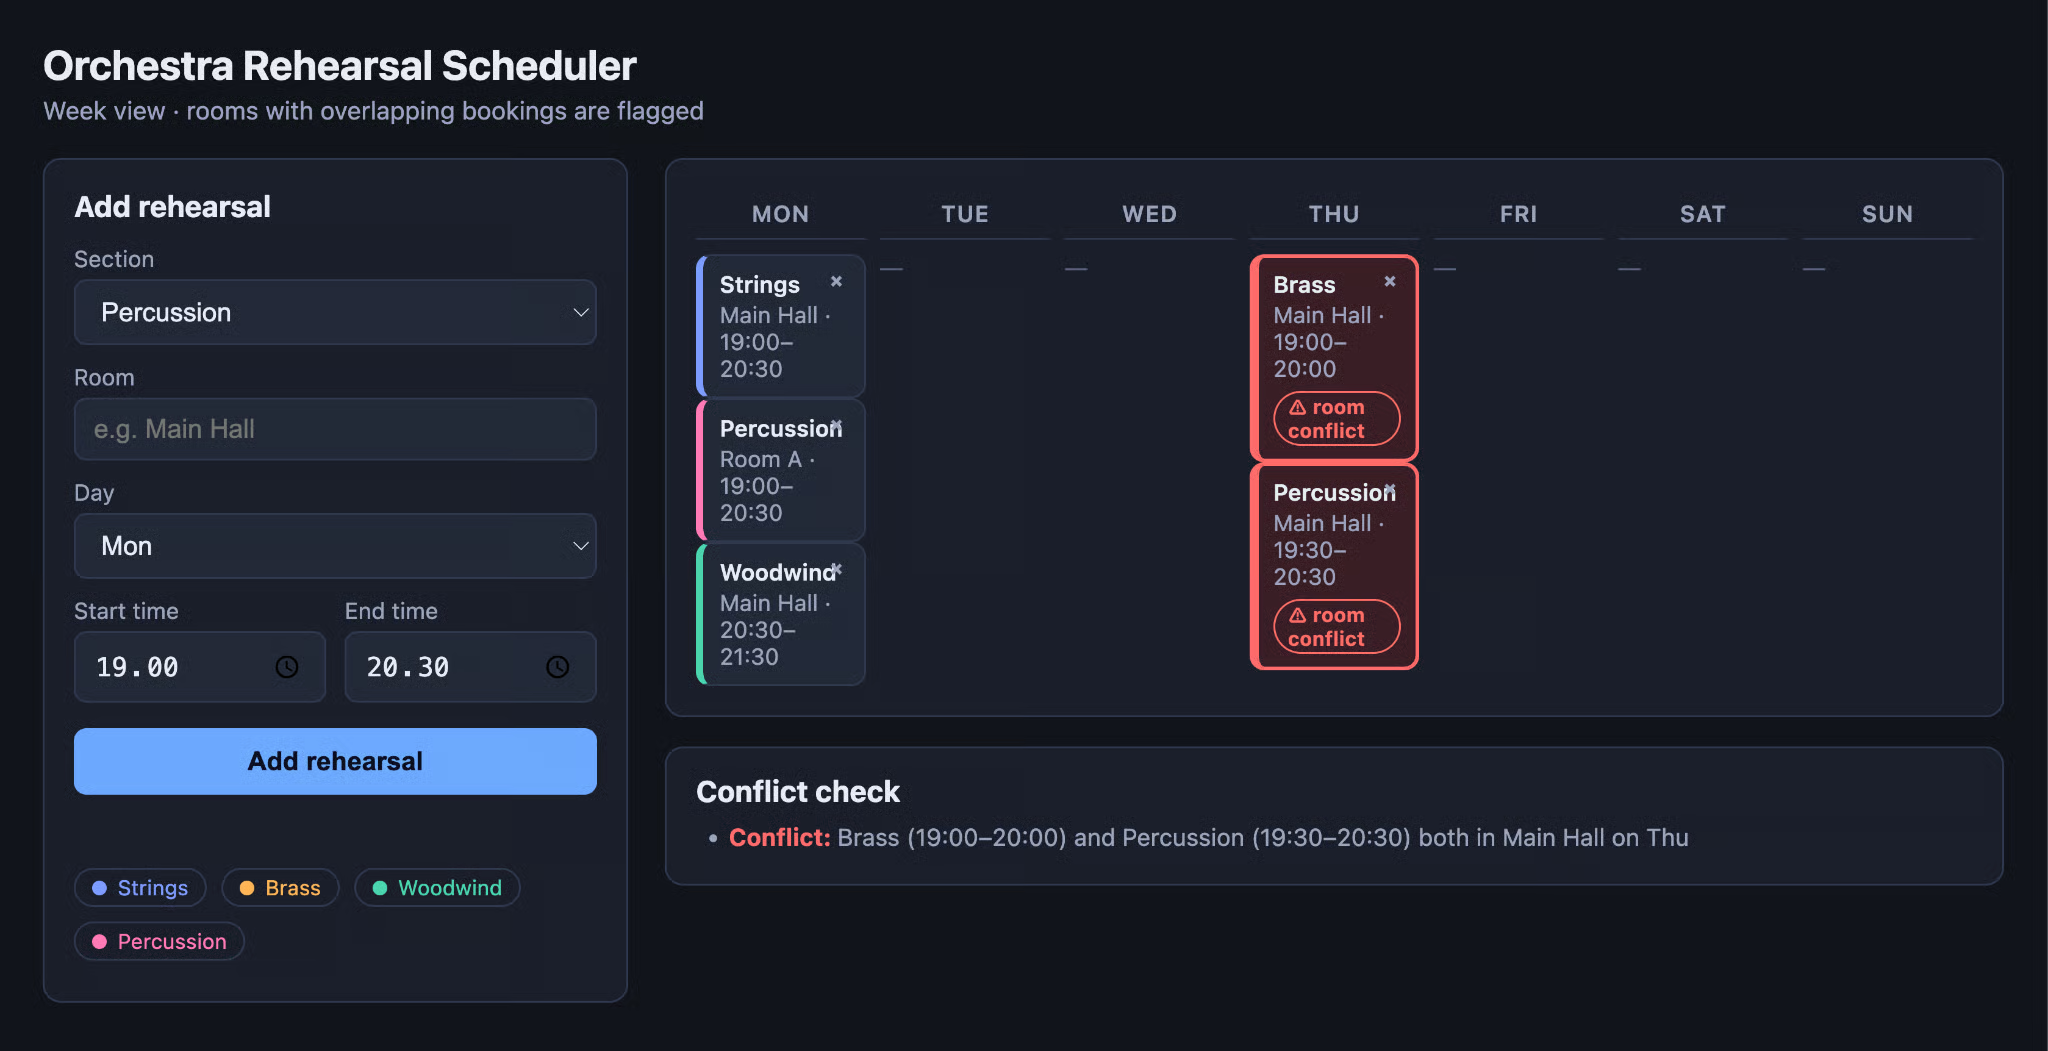
Todo lo solicitado está presente y funciona, el diseño se entiende de un vistazo y su único extra no pedido, borrar entradas, ayuda. No permite editar una entrada, que tampoco se pidió. Es un 5 limpio en las tres rúbricas.
Gemini necesitó 4 turnos y 3 llamadas a herramientas (un glob, una lectura y una escritura) para entregar un index.html de 76 KB (casi 6 veces el archivo de DeepSeek), y fue mucho más lento. El resultado se ve más pulido: cabecera con marca y contador en vivo de solapes, una semana de ejemplo precargada con una doble reserva intencional el miércoles para que el indicador de conflicto aparezca de inmediato, filtros por sección y sala, un conmutador de solo conflictos, vistas de columna y de cronograma, edición y borrado de entradas, un campo de notas de repertorio y un aviso en vivo mientras escribes una nueva reserva.
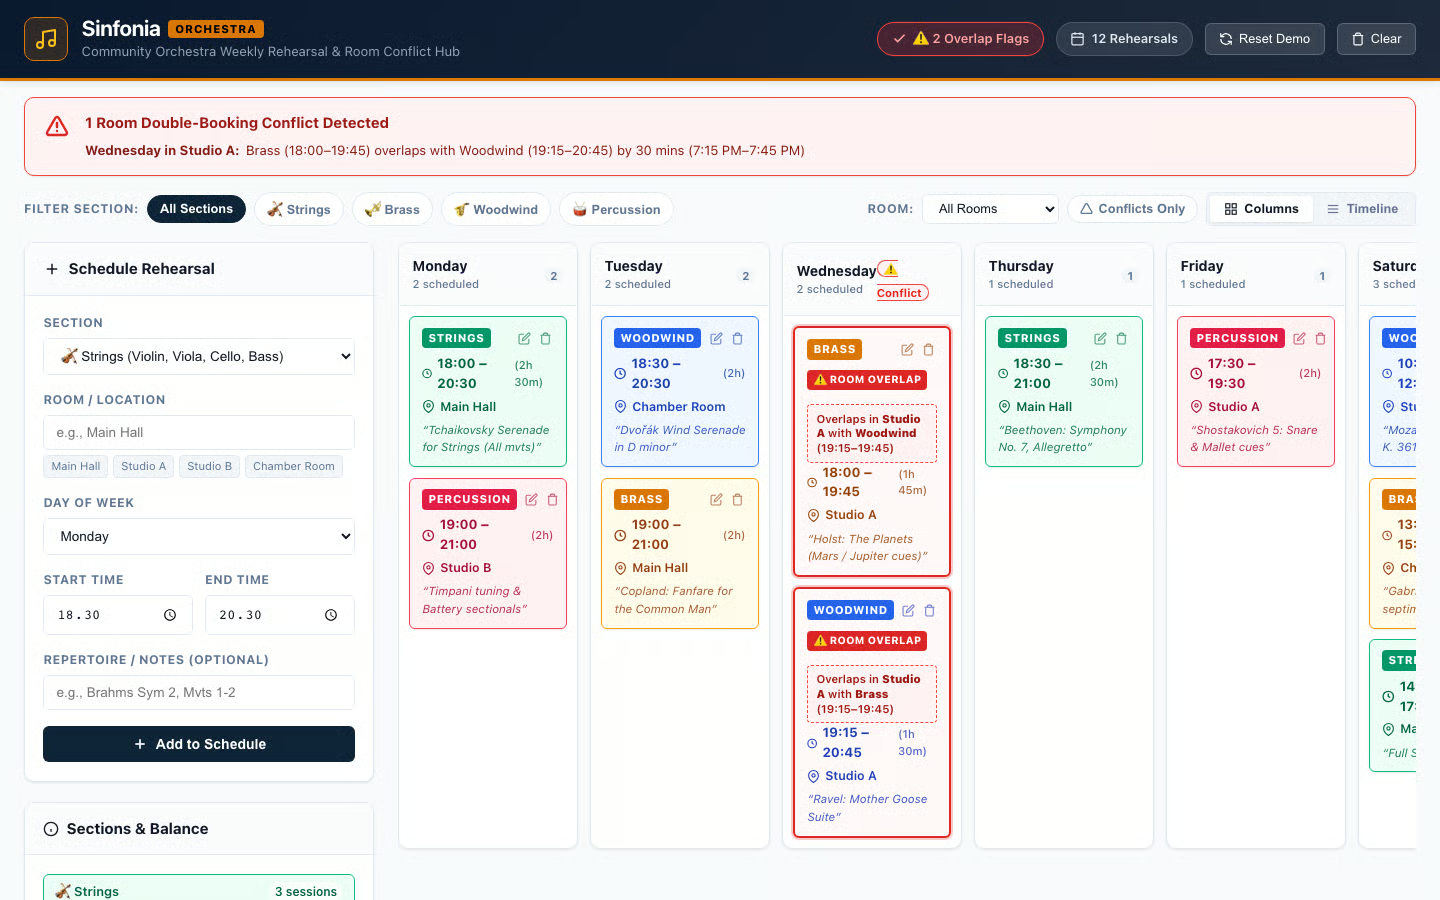
La lógica de conflictos es correcta y la prueba solo marcó el par que se solapa. El problema son los extras: un panel Sections and Balance con recuentos por sección obligó a que la columna del formulario hiciera scroll (algo en contra del prompt) y queda desubicado respecto al resto, y la cantidad de controles dificulta leer la semana frente a la versión de DeepSeek. Por eso tengo que restar un punto en adherencia a especificaciones y en diseño, aunque el resultado general es muy bueno.
| Medida | DeepSeek V4.1 Flash | Gemini 3.8 Flash |
|---|---|---|
| Turnos | 2 | 4 |
| Llamadas a herramientas | 1 | 3 |
| Capacidad de ejecución | pasa | pasa |
| Adherencia a especificaciones | 5 | 4 |
| Lógica de conflictos | 5 | 5 |
| Usabilidad y diseño | 5 | 4 |
| Puntuación de rúbrica (media de tres ejes) | 5,0 | 4,3 |
DeepSeek V4.1 Flash gana esta prueba. Ambos resolvieron la parte difícil, la lógica de solape de intervalos, así que la diferencia fue de criterio: DeepSeek construyó lo pedido en una sola escritura, mientras Gemini construyó un pequeño producto, y una función no solicitada perjudicó el diseño sobre el que se evaluaba. La versión de Gemini es la que enseñaría a un gerente de orquesta; la de DeepSeek es la que preferiría que me entregara un colega.
Es una sola ejecución de una tarea a un nivel de esfuerzo, así que no dice nada de uso de tokens o coste, y solo explora UI con estado más lógica de solapes, no trabajo de largo recorrido en repositorios.
Ningún modelo es la opción por defecto para todo el mundo, así que aquí tienes la decisión por tipo de carga.
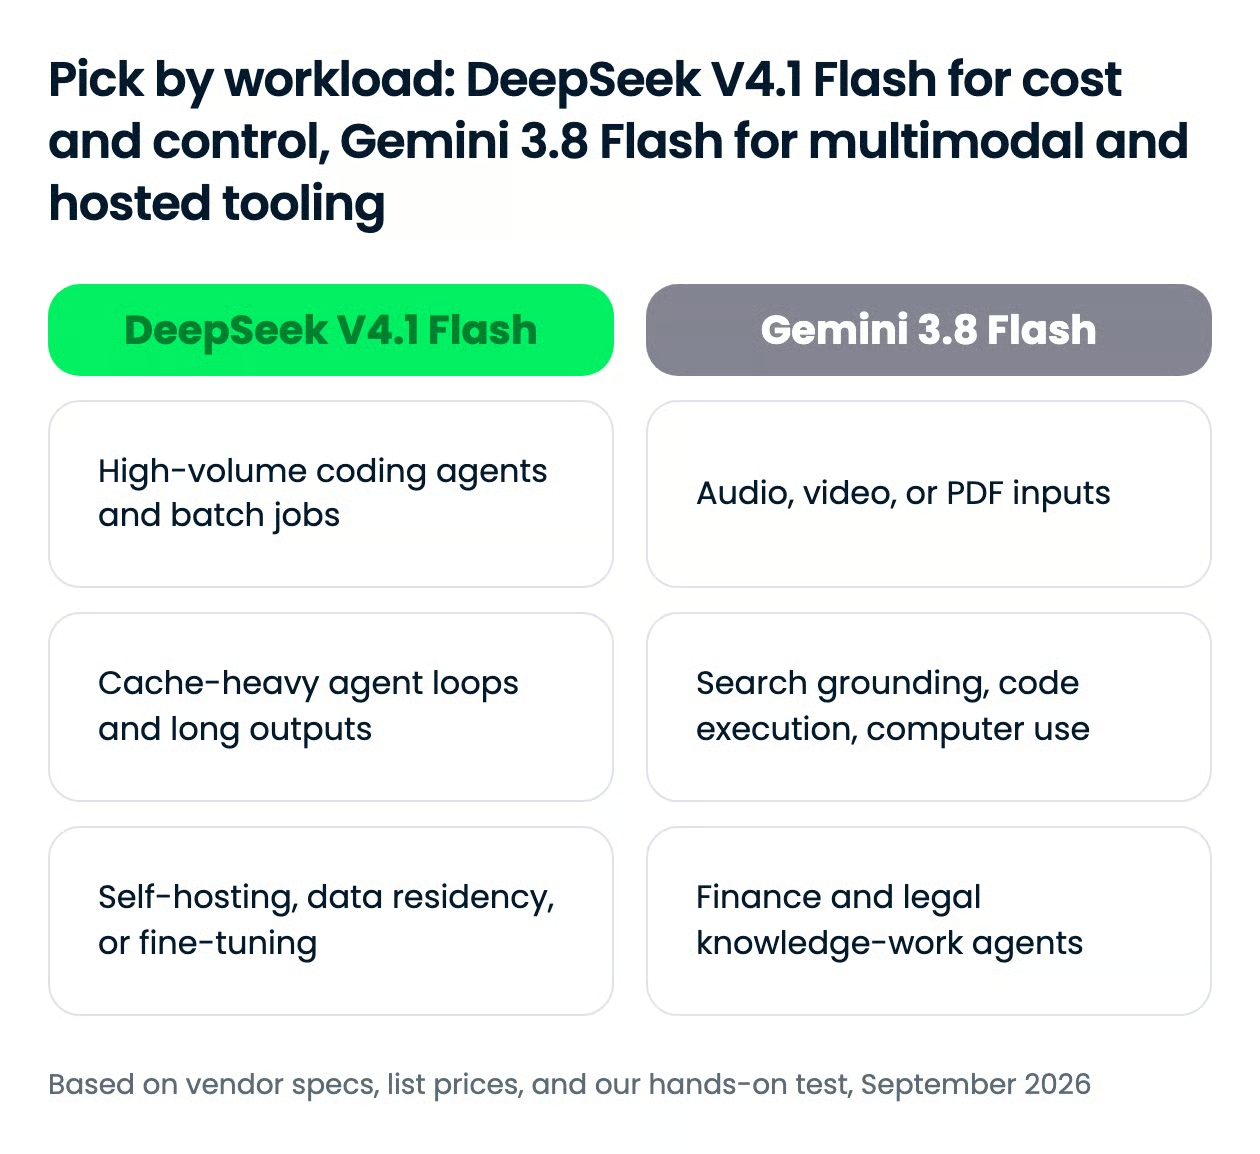
El cruce está en entradas, infraestructura y presupuesto: están igualados en programación con agentes, así que DeepSeek gana siempre que el coste o el control decidan, y Gemini gana cuando tus datos o tu stack son algo que DeepSeek no puede ingerir o alojar por ti.
Dónde puedes usar cada modelo difiere más que lo que pueden hacer, así que revisa la matriz antes de los benchmarks.
| Superficie | DeepSeek V4.1 Flash | Gemini 3.8 Flash |
|---|---|---|
| App para consumidor | DeepSeek app y chat.deepseek.com | App de Gemini (Google AI Pro y Ultra), modo IA en Search, Gemini en Sheets |
| API de primer nivel | Sí, DeepSeek API (formatos de solicitud tipo OpenAI y Anthropic) | Sí, Gemini API vía Google AI Studio (GA) |
| Plataformas cloud | Sin listado propio en cloud; servido por Databricks y otros, o autoalojar los pesos MIT | Gemini Enterprise en Google Cloud |
| Agentes de código | DeepSeek Harness; OpenCode, WorkBuddy y CodeBuddy (socios oficiales) | Google Antigravity (modelo por defecto), Android Studio, Stitch; Cursor, OpenCode |
| Routers de terceros | OpenRouter | OpenRouter |
| ID de modelo en API | deepseek-flash |
gemini-3.8-flash |
La mayor diferencia de disponibilidad es que DeepSeek se puede descargar y Gemini no, mientras que Gemini es el que cuenta con una app para consumidores y una plataforma empresarial gestionada. Los IDs que debes usar son deepseek-flash y gemini-3.8-flash; el nombre heredado deepseek-v4-flash sigue resolviendo pero ya sirve V4.1 Flash.
Los dos SDK difieren, así que no es un simple cambio de cadena. El endpoint de DeepSeek es compatible con OpenAI, lo que significa que el cliente estándar openai funciona con un cambio de base URL, mientras que Gemini 3.8 Flash usa la Interactions API de google-genai con un ajuste thinking_level en lugar de parámetros de muestreo.
from openai import OpenAI

client = OpenAI(api_key="YOUR_DEEPSEEK_KEY", base_url="https://api.deepseek.com")
response = client.chat.completions.create(
    model="deepseek-flash",  # DeepSeek V4.1 Flash
    messages=[{"role": "user", "content": "Refactor this function..."}],
)
print(response.choices[0].message.content)
from google import genai
client = genai.Client() # reads your Google AI Studio API key
interaction = client.interactions.create(
model="gemini-3.8-flash",
input="Refactor this function...",
generation_config={"thinking_level": "medium"}, # low, medium, or high
)
print(interaction.output_text)Para la configuración completa, extracción de PDF y llamadas a funciones en Gemini, sigue nuestro tutorial de la API de Gemini 3.8 Flash; para el modo de pensamiento de DeepSeek y un despliegue local de la generación anterior, consulta nuestro tutorial de la API de DeepSeek V4 y nuestra guía para ejecutar DeepSeek V4 Flash con Unsloth Studio y OpenCode.
Si tu carga son agentes de código, trabajos por lotes o cualquier cosa que relea prefijos largos, utiliza DeepSeek V4.1 Flash: está a la par con Gemini 3.8 Flash en los benchmarks de agentes publicados, ganó nuestra prueba de construcción en 2 turnos y cuesta un tercio antes de la subida de precio de Gemini en enero. Si tus entradas son audio, vídeo o PDFs, o quieres grounding, ejecución de código y control del ordenador desde un único endpoint alojado, usa Gemini 3.8 Flash y asume la prima.
Si quieres construir sistemas de agentes alrededor de modelos como estos, nuestro itinerario Associate AI Engineer for Developers cubre APIs, uso de herramientas y el Model Context Protocol en 29 horas, y nuestro curso Building AI Agents with Google ADK es una introducción de 1 hora en el lado de Gemini.
¡Aprende IA con DataCamp!
programa
Curso
Curso