Tracks
AI智能体基础知识
6小时
Google 于 2026 年 9 月 2 日发布了 Gemini 3.8 Flash,这是其六周内第三次更新 Flash 级别模型。八天后,DeepSeek 推出 DeepSeek V4.1 Flash,一款采用 MIT 许可、552B 专家混合(MoE)模型,输入阶段激活 80 亿参数,输出阶段激活 160 亿参数。
两家厂商都将其模型定位为编码智能体的“主力机型”,并在关键基准上取得相近成绩。这让选择更具难度,不再是常见的开源对闭源的简单叙事,因为更便宜的那款并未在两者共有的基准上表现更弱。
本文将从基准测试、价格、开放性、多模态能力,以及我在两者上进行的一次实操构建测试,全面比较 DeepSeek V4.1 Flash 与 Gemini 3.8 Flash。
如需分别了解各模型的更深入内容,请参阅我们的 DeepSeek V4.1 Flash 指南 和 Gemini 3.8 Flash 与 3.8 Flash Cyber 指南。
DeepSeek V4.1 Flash 是 DeepSeek 于 2026 年 9 月 10 日发布的开源权重、MIT 许可的专家混合模型,是一套新架构家族中最小的成员。
根据其 V4.1 技术报告,其 KV 缓存每个 token 需要 890 字节,约为 DeepSeek V4 Flash 的四分之一,这也是其大幅节省成本的主要来源。
完整解析请阅读我们的 DeepSeek V4.1 Flash 指南;上一代本地部署教程见 使用 Unsloth Studio 与 OpenCode 运行 DeepSeek V4 Flash。
Gemini 3.8 Flash 是 Google 在 2026 年 9 月 2 日发布的最强 Flash 级模型,基于 Gemini 3.7 Flash 打造,于其发布后三周推出。
其核心设计取向是“更努力”:面对复杂任务,会执行额外的推理步骤并迭代调用工具;Google 表示在更高“努力等级”下可能消耗更多 token。
我们的 Gemini 3.8 Flash 指南 涵盖了发布详情及限量访问的 Cyber 变体;Gemini 3.8 Flash API 教程 则讲解了 Interactions API、思考等级以及 Python 中的函数调用。
从下述六个维度看,DeepSeek V4.1 Flash 在价格与开放性上取胜,并在编码方面打成平手;Gemini 3.8 Flash 则在输入类型、工具链与公开的知识型任务结果上占优。
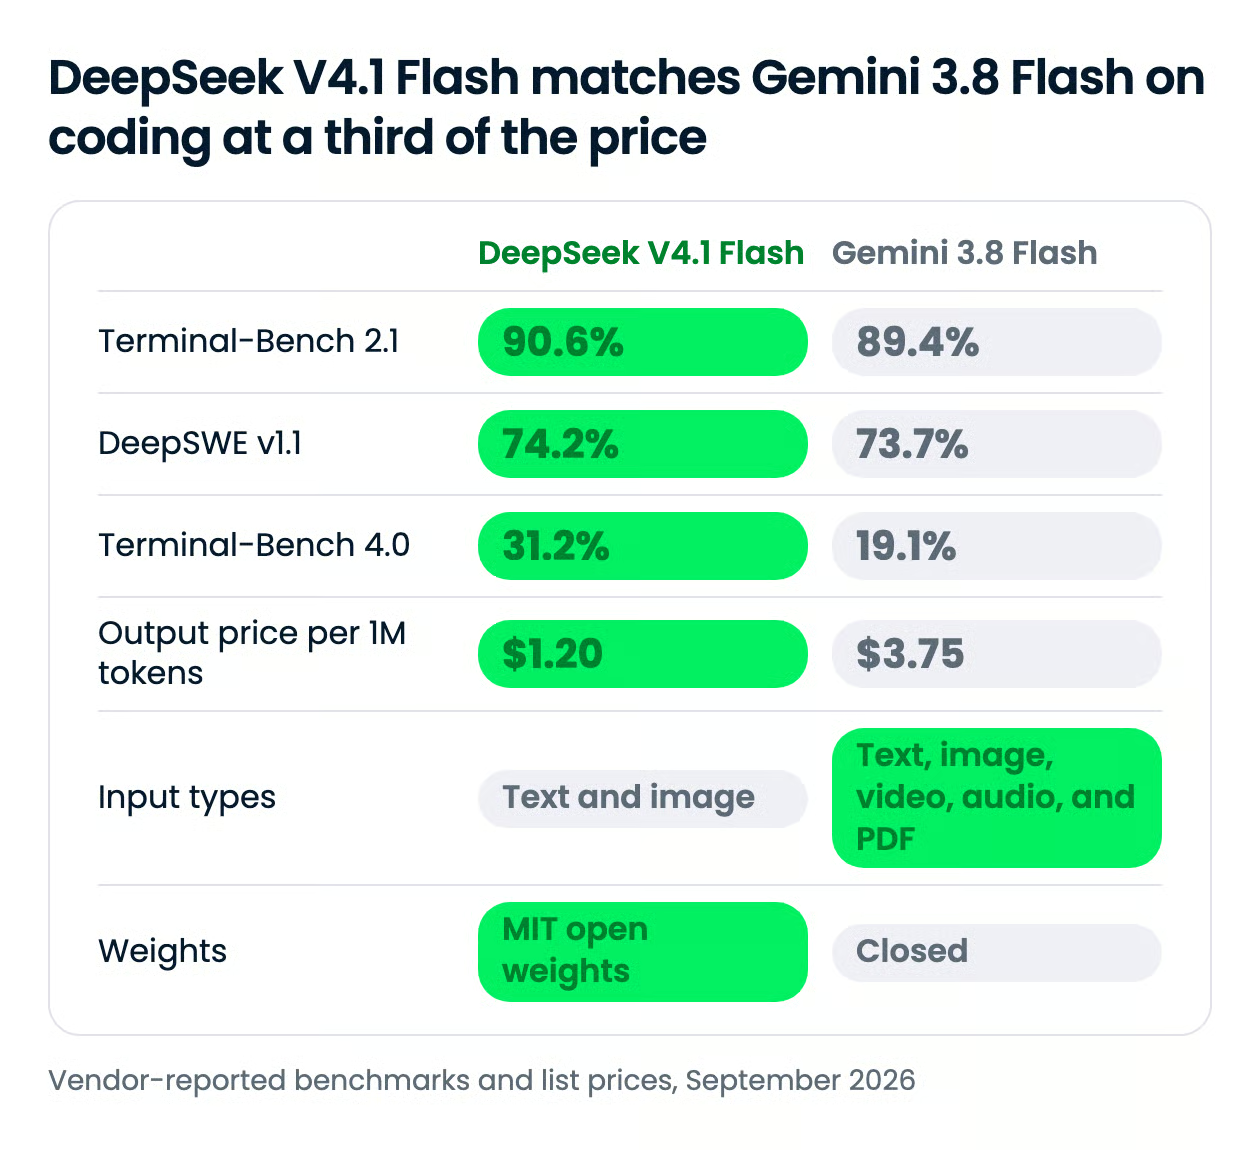
| 特性 | DeepSeek V4.1 Flash | Gemini 3.8 Flash |
|---|---|---|
| 发布日期 | 2026 年 9 月 10 日 | 2026 年 9 月 2 日 |
| 权重与许可 | 开源,MIT | 闭源,托管 |
| 架构 | 552B MoE,预填充激活 8B,解码激活 16B | 未披露;基于 Gemini 3.7 Flash |
| 上下文/最大输出 | 100 万 tokens / 38.4 万 | 100 万 tokens / 6.4 万 |
| 输入类型 | 文本、图像 | 文本、图像、视频、音频、PDF |
| Terminal-Bench 2.1 | 90.6% | 89.4% |
| DeepSWE v1.1 | 74.2% | 73.7% |
| 推理努力等级 | low、high、max(API 上层,底层为 1-100 的整数) |
low、medium、high |
| API 价格,输入/输出(每 100 万) | $0.30 / $1.20(高峰) | $0.75 / $3.75(至 2026 年底;之后翻倍) |
在两家表格同时出现的三项智能体基准上,DeepSeek V4.1 Flash 均领先,尽管其中两项差距小到可视为持平。
真正拉开差距的是更难的一般智能体套件 Terminal-Bench 4.0:DeepSeek 为 31.2%,Gemini 为 19.1%。两家都承认该套件暴露短板;DeepSeek 表示在科学类智能体任务上与巨型模型仍有差距,而 Google 自己的表格显示 Claude Opus 5 为 51.8%。
| 基准 | DeepSeek V4.1 Flash | Gemini 3.8 Flash | 备注 |
|---|---|---|---|
| Terminal-Bench 2.1 | 90.6% | 89.4% | 均为厂商自测;两表均显示 Claude Opus 5 为 89.1% |
| DeepSWE v1.1 | 74.2% | 73.7% | 均为厂商自测;两表均显示 Claude Opus 5 为 74.0% |
| Terminal-Bench 4.0 | 31.2% | 19.1% | 最难的共同套件;两表均显示 Opus 5 为 51.8% |
两点注意:
对于以终端为主的编码智能体,两者可视为并驾齐驱,让价格与部署方式来决定;在最难的智能体任务上,DeepSeek 的已公布优势是唯一上榜的差异。
价格这一维度没有悬念,更有价值的问题是:差距会随您的工作负载形态发生多大变化。
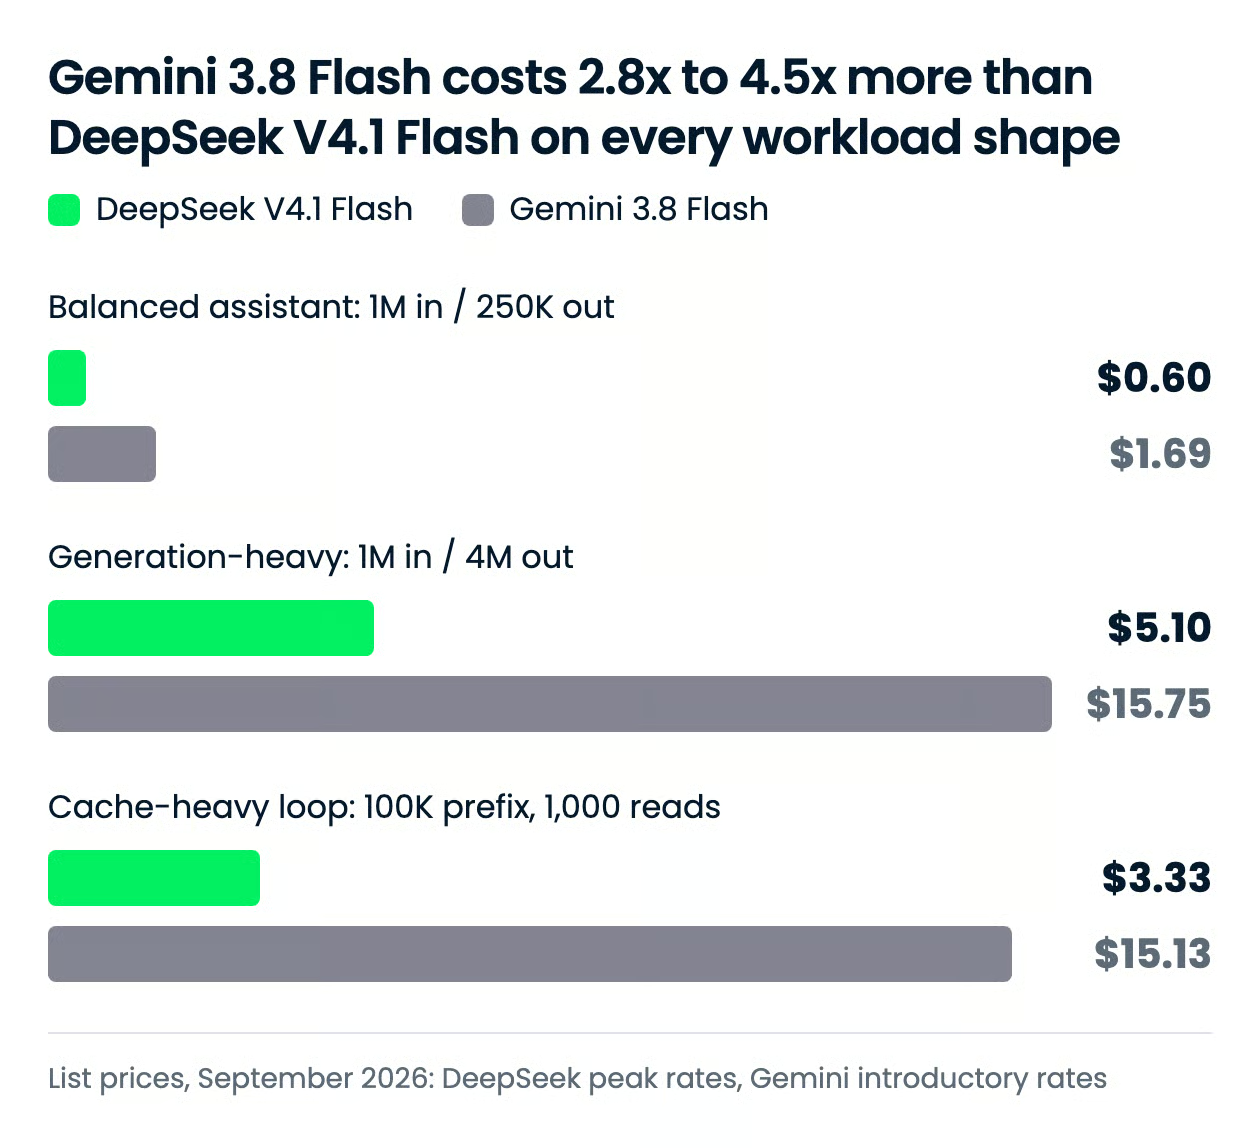
DeepSeek V4.1 Flash 在每一行都更便宜,且工作负载越依赖输出 token 或缓存前缀,差距越大。倍数并不均一:输入为 2.5 倍,输出为 3.1 倍,缓存读取为 12.5 倍。
| 费率 | DeepSeek V4.1 Flash(高峰) | Gemini 3.8 Flash(至 2026-12-31) |
|---|---|---|
| 输入,每 100 万 tokens | $0.30 | $0.75 |
| 输出,每 100 万 tokens | $1.20 | $3.75 |
| 缓存输入读取,每 100 万 tokens | $0.006 | $0.075,另加每小时每 100 万 tokens $0.50 的存储费 |
| 折扣通道 | 非高峰:除工作日 UTC 01:00-04:00 与 06:00-10:00 外全部半价 | Batch 或 Flex:五折($0.375 / $1.875) |
| 推理 tokens 计费为 | 输出 | 输出 |
| 自 2027 年 1 月 1 日起 | 未宣布变更 | $1.50 / $7.50;缓存读取 $0.15 |
差异主要体现在“输出溢价”上。Gemini 的输出费率是 DeepSeek 的 3.1 倍,而输入是 2.5 倍,因此生成密集与思考密集的任务付费更高,且两家均按输出费率计费推理 tokens。
| 工作负载 | DeepSeek V4.1 Flash | Gemini 3.8 Flash | 差额 |
|---|---|---|---|
| 均衡助理:100 万入 / 25 万出 | $0.60 | $1.69 | $1.09,Gemini 高 181% |
| 生成密集:100 万入 / 400 万出 | $5.10 | $15.75 | $10.65,Gemini 高 209% |
| 重缓存循环:10 万前缀写入一次,读取缓存 1,000 次,且每次另有 5K 新入 / 1K 新出 | $3.33 | $15.13 | $11.80,Gemini 高 354% |
计算公式为(体量 ÷ 100 万)× 费率,对输入与输出分别求和,DeepSeek 按高峰价、Gemini 按优惠期价。重缓存一行对 1,000 次读取使用各自的缓存读取费率,并假设 Gemini 缓存保存 1 小时,增加 $0.05 存储费。
重缓存这一行最具看点,因为 DeepSeek $0.006 的缓存读取价让 10 万 token 的前缀几乎免费重读,而 Gemini 对同样的 1 亿缓存 tokens 收取 $7.50。
将 DeepSeek 安排在非高峰时段,上述每一行费用减半;等到明年 1 月,Gemini 的每一行费用翻倍,均衡助理就变成 $3.38 对 $0.60。
两者之中,只有 DeepSeek V4.1 Flash 可下载,其架构也是其低价的原因。技术报告描述为 20 层因果编码器接 20 层解码器,采用 Compressed Sparse Attention 2、FP4 KV 缓存,KV 缓存从 V4 Flash 的每 token 3,514 字节降至 890 字节。
不过,这些 MIT 许可权重 的服务化仍处早期:vLLM 与 SGLang 还在 nightly 与预览版本中支持,Transformers 尚未支持。
如果您需要数据属地、在本地机房推理或微调,只有 DeepSeek 可选;如果您想零基础设施使用,Gemini 的 GA 托管端点更简单。
Gemini 3.8 Flash 接受文本、图像、视频、音频与 PDF,而 DeepSeek V4.1 Flash 接受文本与图像。两者均提供 100 万 token 的上下文窗口,但 DeepSeek 允许最高 38.4 万输出 tokens,Gemini 为 6.4 万,这对长代码生成与整文改写意义重大。
Gemini 的 模型页面 还列出了 DeepSeek 尚无等价物的托管工具:代码执行、Google 搜索与地图校准、文件搜索、URL 上下文,以及预览中的计算机使用。DeepSeek 的 API 侧则提供 JSON 输出、工具调用、Responses API、Anthropic 格式端点,以及前缀与中间填充式补全。
如果您的输入包含音频或视频,或希望无需自建检索就能获得校准,选 Gemini;如果您需要长输出,并希望与现有 OpenAI 或 Anthropic 客户端代码即插即用,则选 DeepSeek。
来自两家厂商的基准仅能说明一部分,因此我在两者上用相同提示与相同工具,跑了一次构建任务。
我要求两者构建一个社区乐团排练日程的有状态单文件 Web 应用。我们明确要求的两项功能是区间重叠冲突检测与持久化。两者在 Terminal-Bench 2.1 上都接近 90%,但 DeepSeek 在 Terminal-Bench 4.0 上为 31.2%,Gemini 为 19.1%,暗示在更难的智能体工作上存在差距,此任务是个紧凑的检验方式。
两者均在 OpenCode 中运行,工具面板完全一致且固定:仅允许读写文件,无 shell、无网络。两者均以 high 推理努力等级运行,各一次机会、无重试,提示逐字节发送至全新会话。
需要注意一个不对称:high 是 Gemini 的最高努力等级,而在 DeepSeek 上对应 1 到 100 标尺中的 75,其最高值才与其公布基准分数时使用的相同。
提示如下:
Build a single-file HTML page (inline CSS and JS, no build step, no external dependencies, no network) for a rehearsal scheduler used by a community orchestra.
It needs:
- a week view (Mon–Sun) showing rehearsal blocks by section: strings, brass, woodwind, percussion;
- a conflict indicator that flags when two sections are booked in the same room at overlapping times (not merely the same slot);
- an add-rehearsal form with section, room, day, start time, and end time;
- localStorage persistence, so rehearsals survive a page reload.

Ship it as one working file named `index.html`. Do not install packages. Do not open, screenshot, or headless-render the page (no Playwright, Puppeteer, or Chrome).
Do not ask me clarifying questions — make reasonable assumptions and note them briefly in a comment at the top of the file.
我从可运行性(失败/通过)以及以下三项量表进行评分,每项 1 到 5 分:
DeepSeek 用 2 个回合、1 次工具调用完成:写出一个 13 KB 的 index.html 并宣告结束。页面为深色的双栏布局,左侧为添加排练表单,右侧为周一至周日网格,下方为冲突检查面板。其头部注释清楚写明重叠规则:仅严格重叠算冲突、背靠背不算;探测确认仅标记了重叠的那一对。
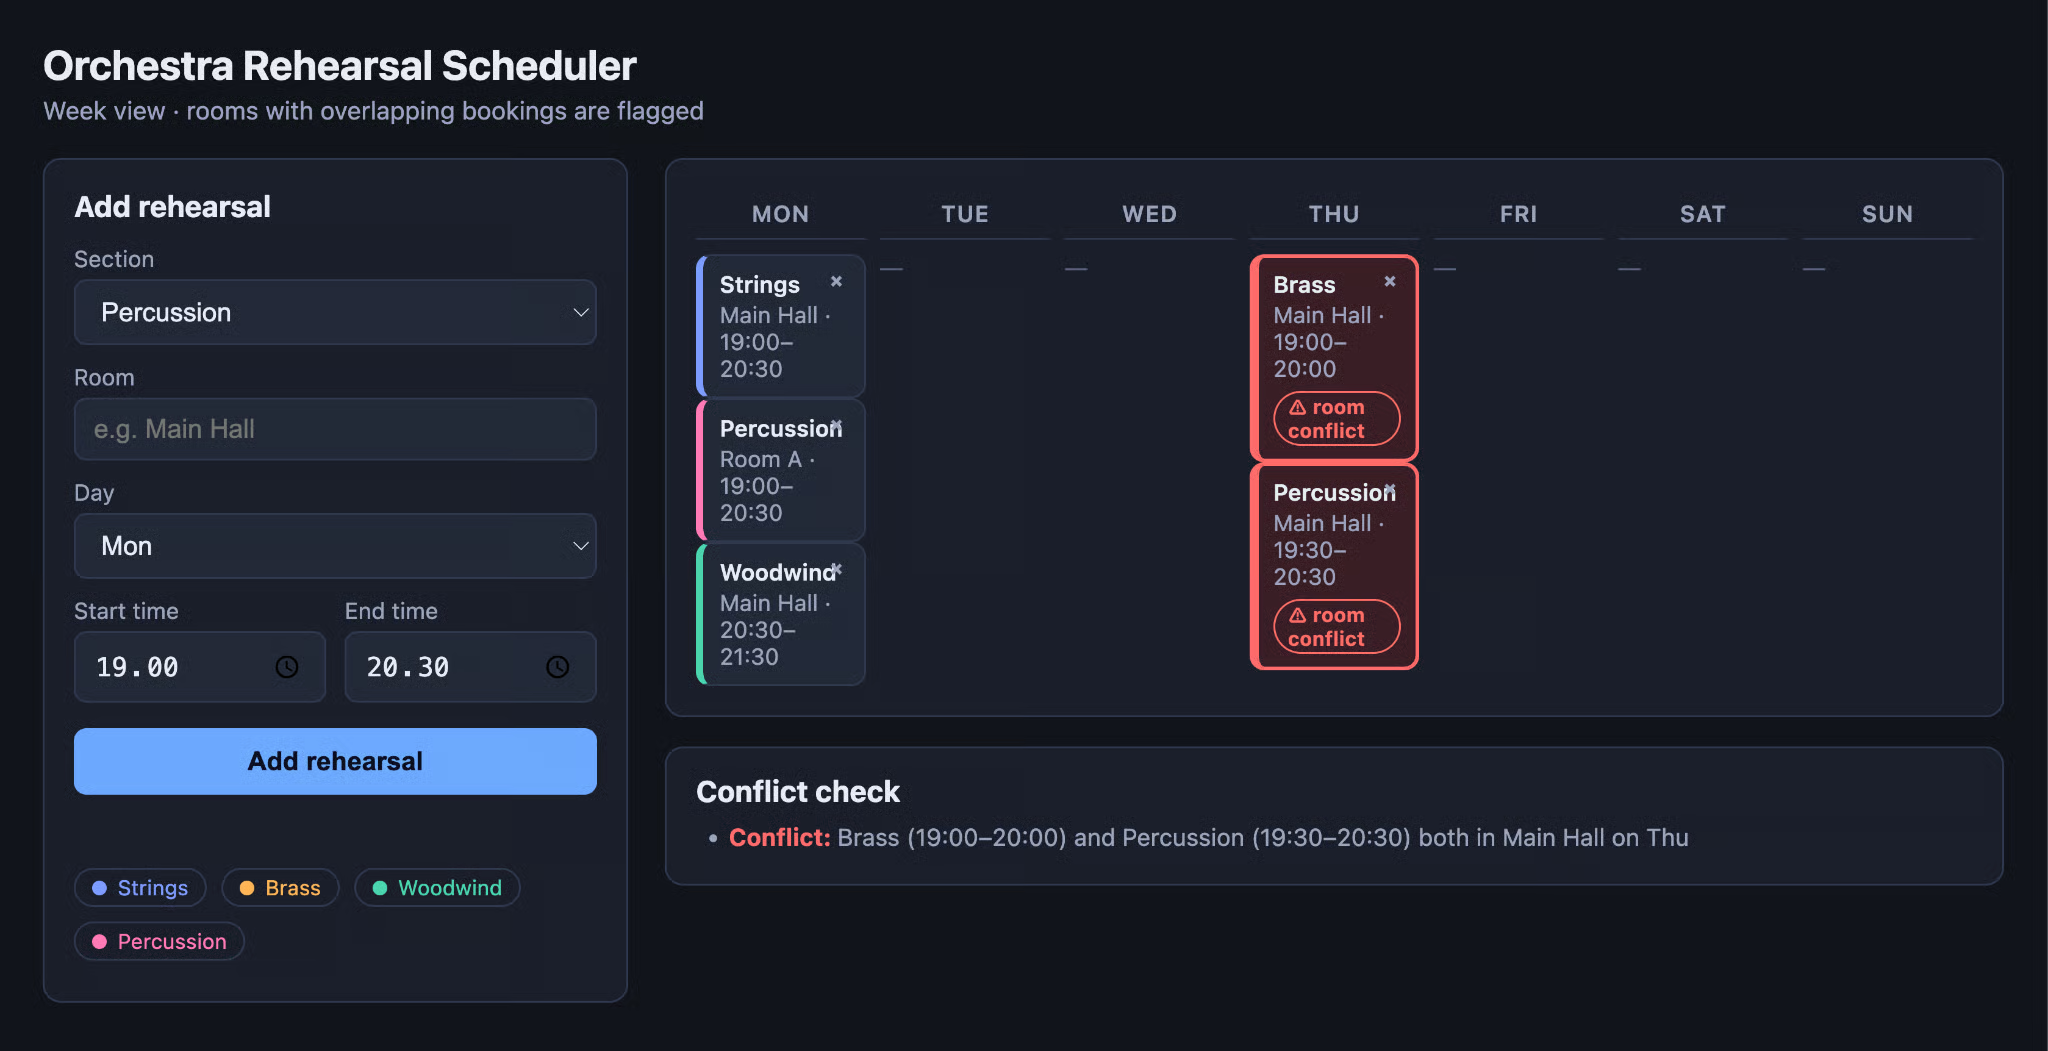
所要求的内容一应俱全且运作正常,布局一目了然;其唯一的“额外”——删除条目——也有帮助。不支持编辑条目,但提示也未要求。三项量表均为满分 5 分。
Gemini 用了 4 个回合与 3 次工具调用(glob、读取、然后写入),最终交付一个 76 KB 的 index.html(几乎是 DeepSeek 文件的 6 倍),速度也慢得多。成品观感更精致:带品牌的页眉与实时冲突计数器、预置一周示例(周三故意双订以便立即显示冲突)、分部与房间筛选、仅看冲突开关、列视图与时间轴视图、编辑与删除条目、曲目备注字段,以及新建预订时的实时警告预览。
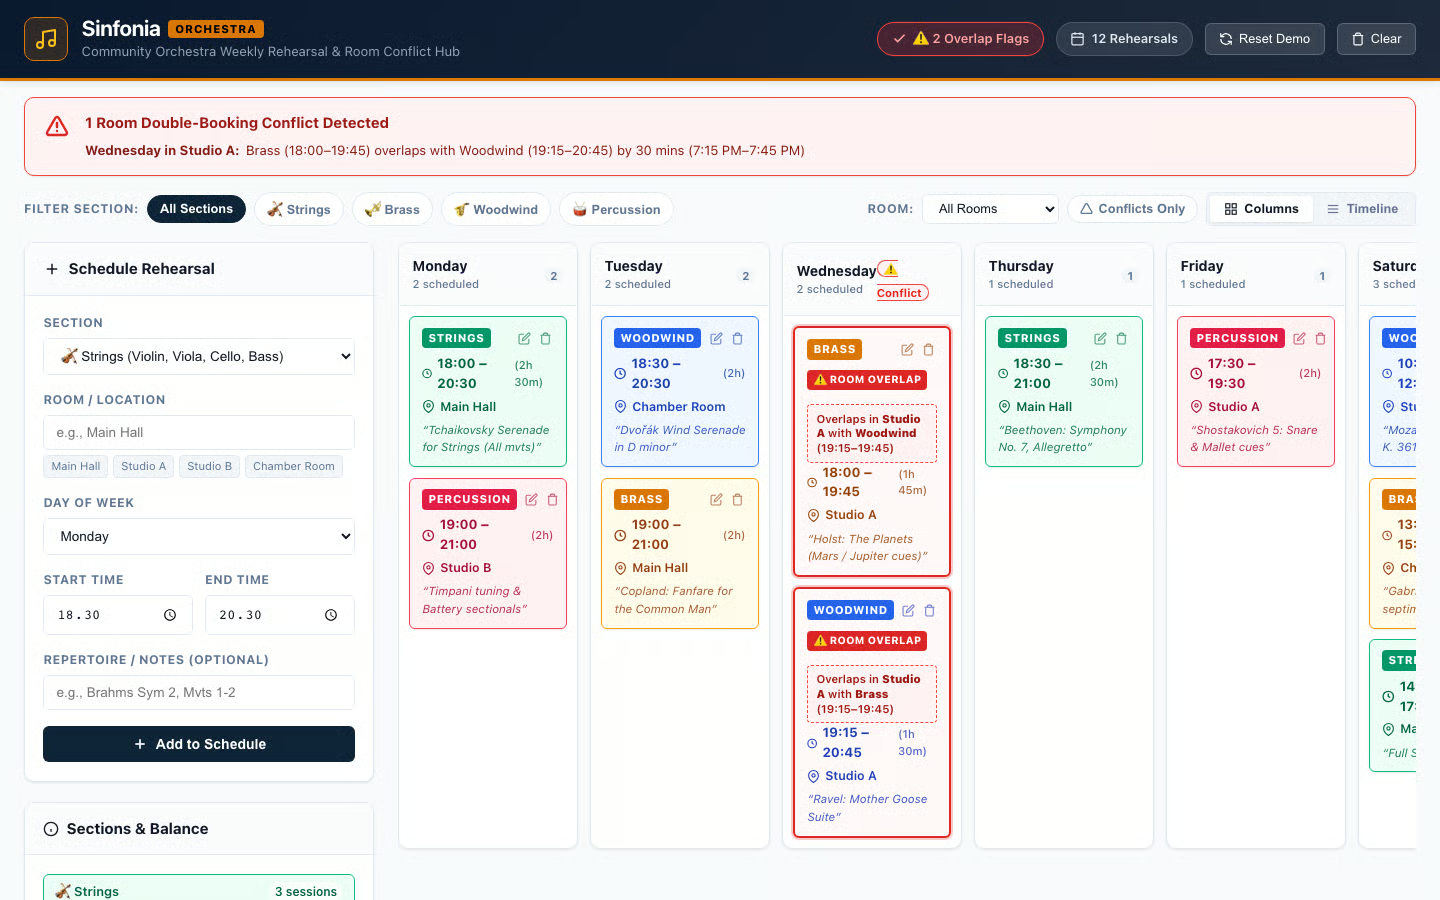
冲突逻辑正确,探测仅标记重叠的一对。问题在于“加料”:带每个分部场次计数的“分部与平衡”面板迫使表单列出现滚动(与提示相悖),且在整体布局下显得突兀;同时控件数量过多,使得周视图不如 DeepSeek 的清爽易读。因此我在规格符合度与布局各扣 1 分,不过总体质量仍然很高。
| 指标 | DeepSeek V4.1 Flash | Gemini 3.8 Flash |
|---|---|---|
| 回合数 | 2 | 4 |
| 工具调用 | 1 | 3 |
| 可运行性 | 通过 | 通过 |
| 规格符合度 | 5 | 4 |
| 冲突逻辑 | 5 | 5 |
| 可用性与布局 | 5 | 4 |
| 量表分(3 轴均值) | 5.0 | 4.3 |
本次测试由 DeepSeek V4.1 Flash 取胜。两者都搞定了难点(区间重叠逻辑),差异归于取舍:DeepSeek 一次写就按需构建;Gemini 做成了一个“小产品”,而某个未请求的功能影响了评分所依据的布局。若要向乐团经理演示,我会选 Gemini 的版本;若要同事交付给我继续迭代,我更愿意拿到 DeepSeek 的版本。
这只是一次、在一个努力等级下的单项任务测试,未涵盖 token 使用或成本,也仅检验了有状态 UI 与重叠逻辑,不涉及长周期的代码库工作。
两者都不是对所有人的“默认之选”,因此按工作负载给出建议。
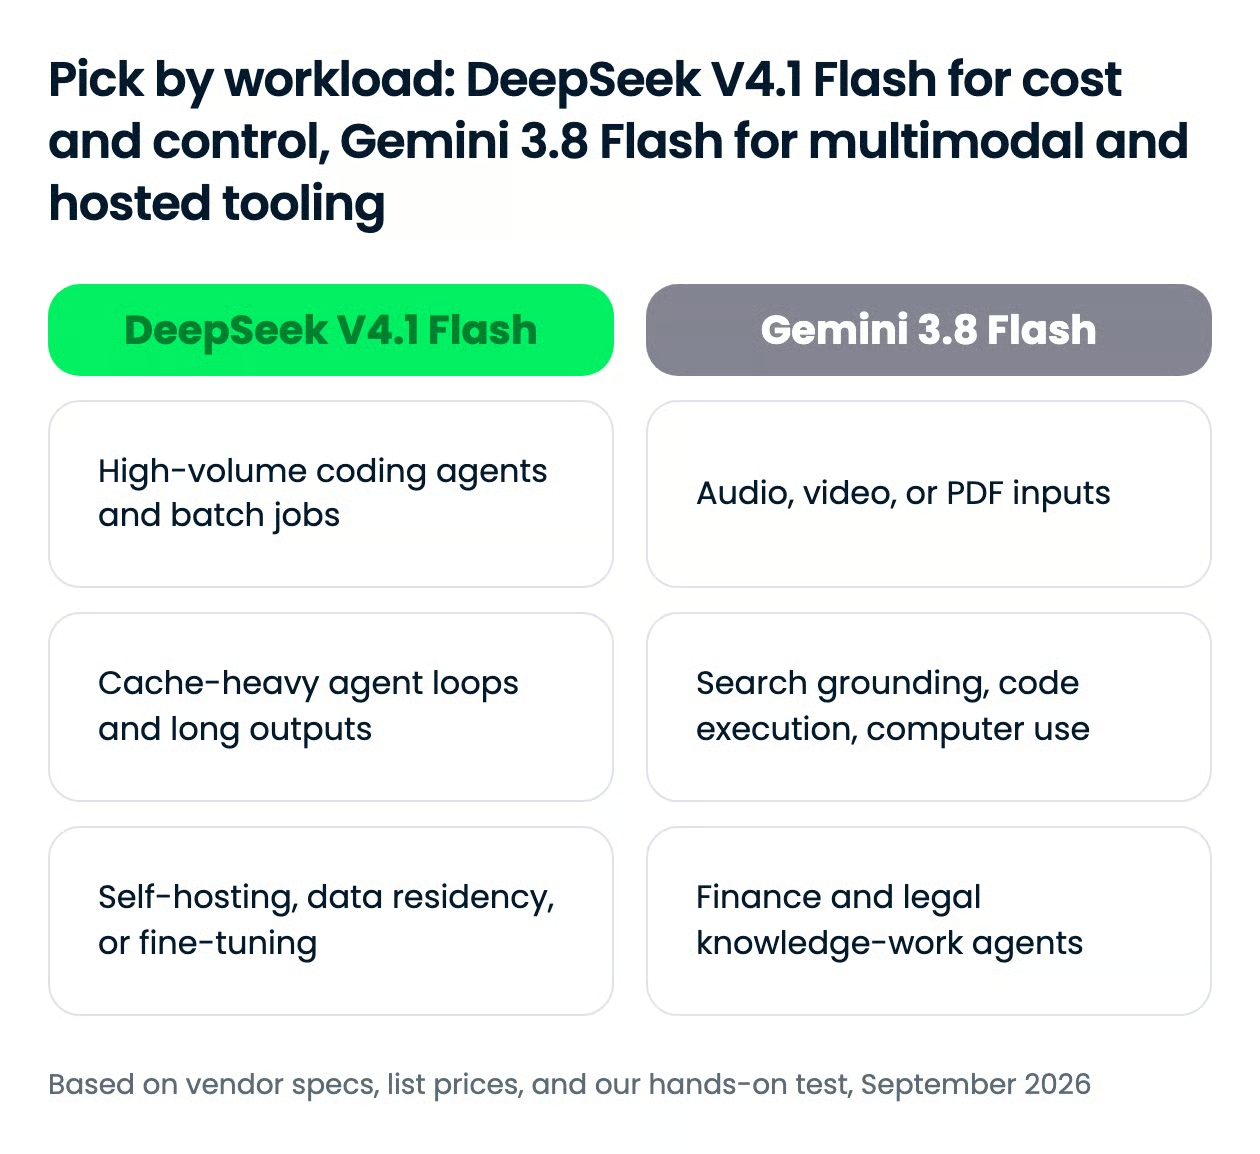
分叉点在输入、基础设施与预算:两者在编码智能体上势均力敌,因此当成本或可控性决定胜负时,DeepSeek 取胜;当您的数据或技术栈是 DeepSeek 无法摄入或托管的,Gemini 取胜。
能在哪些界面触达两款模型的差异,远大于它们功能的差异,因此在看基准前请先看此矩阵。
| 使用界面 | DeepSeek V4.1 Flash | Gemini 3.8 Flash |
|---|---|---|
| 消费者应用 | DeepSeek 应用与 chat.deepseek.com | Gemini 应用(Google AI Pro 与 Ultra)、搜索中的 AI 模式、Gemini for Sheets |
| 第一方 API | 有,DeepSeek API(兼容 OpenAI 与 Anthropic 请求格式) | 有,经由 Google AI Studio 的 Gemini API(GA) |
| 云平台 | 无第一方云上架;可由 Databricks 等提供,或自托管 MIT 权重 | Google Cloud 上的 Gemini Enterprise |
| 编码智能体 | DeepSeek Harness;OpenCode、WorkBuddy 与 CodeBuddy(官方合作) | Google Antigravity(默认模型)、Android Studio、Stitch;Cursor、OpenCode |
| 第三方路由器 | OpenRouter | OpenRouter |
| API 模型 ID | deepseek-flash |
gemini-3.8-flash |
最大的可用性差异是 DeepSeek 可下载而 Gemini 不可,而 Gemini 拥有消费者应用与托管的企业平台。您需要填写的 ID 分别是 deepseek-flash 与 gemini-3.8-flash;旧名 deepseek-v4-flash 仍可解析,但已由 V4.1 Flash 提供服务。
两者 SDK 不同,因此并非“一行替换”。DeepSeek 的端点兼容 OpenAI,这意味着更改 base URL 后可直接使用标准的 openai 客户端;Gemini 3.8 Flash 则使用 google-genai 的 Interactions API,并以 thinking_level 代替采样参数。
from openai import OpenAI

client = OpenAI(api_key="YOUR_DEEPSEEK_KEY", base_url="https://api.deepseek.com")
response = client.chat.completions.create(
    model="deepseek-flash",  # DeepSeek V4.1 Flash
    messages=[{"role": "user", "content": "Refactor this function..."}],
)
print(response.choices[0].message.content)
from google import genai
client = genai.Client() # reads your Google AI Studio API key
interaction = client.interactions.create(
model="gemini-3.8-flash",
input="Refactor this function...",
generation_config={"thinking_level": "medium"}, # low, medium, or high
)
print(interaction.output_text)完整的安装配置、PDF 提取与 Gemini 上的函数调用,请参阅我们的 Gemini 3.8 Flash API 教程;关于 DeepSeek 的思考模式与上一代的本地部署,请参阅我们的 DeepSeek V4 API 教程 以及 使用 Unsloth Studio 与 OpenCode 运行 DeepSeek V4 Flash 指南。
如果您的工作负载是编码智能体、批处理,或任何需要多次重读长前缀的任务,请选 DeepSeek V4.1 Flash:它在已公布的智能体基准上与 Gemini 3.8 Flash 持平,在我们的构建测试中以 2 个回合取胜,且在 Gemini 明年涨价前其成本仅为后者的三分之一。若您的输入是音频、视频或 PDF,或您希望从一个托管端点获得校准、代码执行与计算机使用,请选 Gemini 3.8 Flash,并接受其溢价。
如果您希望围绕此类模型搭建智能体系统,我们的 面向开发者的 AI 工程师(入门) 路线用 29 小时覆盖 API、工具使用与模型上下文协议(MCP);我们的 使用 Google ADK 构建 AI 智能体 课程可在 Gemini 侧以 1 小时上手。
在 DataCamp 学习 AI!
Tracks
Courses
Courses