
Programma
Nozioni di base sugli agenti AI
6 h
Google ha rilasciato Gemini 3.8 Flash il 2 settembre 2026, il suo terzo rilascio Flash in sei settimane. Otto giorni dopo, DeepSeek ha risposto con DeepSeek V4.1 Flash, un modello mixture-of-experts da 552B con licenza MIT che attiva 8B parametri in input e 16B in output.
Entrambi i vendor definiscono il proprio modello un cavallo di battaglia per agenti di coding e ottengono punteggi simili nei benchmark più importanti. Questo rende la scelta più difficile rispetto al solito schema aperto vs chiuso, perché il modello più economico non è quello più debole nei benchmark in comune.
In questo articolo, confronterò DeepSeek V4.1 Flash e Gemini 3.8 Flash su benchmark, prezzi, apertura, multimodalità e con un test pratico di build che ho eseguito su entrambi.
Per approfondimenti su ciascun modello, vedi la nostra guida a DeepSeek V4.1 Flash e la nostra guida a Gemini 3.8 Flash e 3.8 Flash Cyber.
DeepSeek V4.1 Flash è un modello open-weight, con licenza MIT, di tipo mixture-of-experts rilasciato da DeepSeek il 10 settembre 2026, e il membro più piccolo di una nuova famiglia architetturale.
Secondo il rapporto tecnico V4.1, la sua cache KV richiede 890 byte per token, circa un quarto di quanto necessario a DeepSeek V4 Flash, che è da dove proviene gran parte del risparmio sui costi.
Per tutti i dettagli, leggi la nostra guida a DeepSeek V4.1 Flash e, per un setup locale della generazione precedente, il nostro tutorial su eseguire DeepSeek V4 Flash con Unsloth Studio e OpenCode.
Gemini 3.8 Flash è il modello di fascia Flash più capace di Google, rilasciato il 2 settembre 2026, tre settimane dopo Gemini 3.7 Flash e basato su quest’ultimo.
La sua scelta progettuale distintiva è che “lavora di più”: su task complessi esegue passaggi di ragionamento aggiuntivi e chiama strumenti in modo iterativo, e Google afferma che potrebbe consumare più token a livelli di sforzo più alti.
La nostra guida a Gemini 3.8 Flash copre il lancio e la variante Cyber a accesso limitato, e il nostro tutorial sull’API di Gemini 3.8 Flash illustra l’Interactions API, i livelli di “thinking” e le function call in Python.
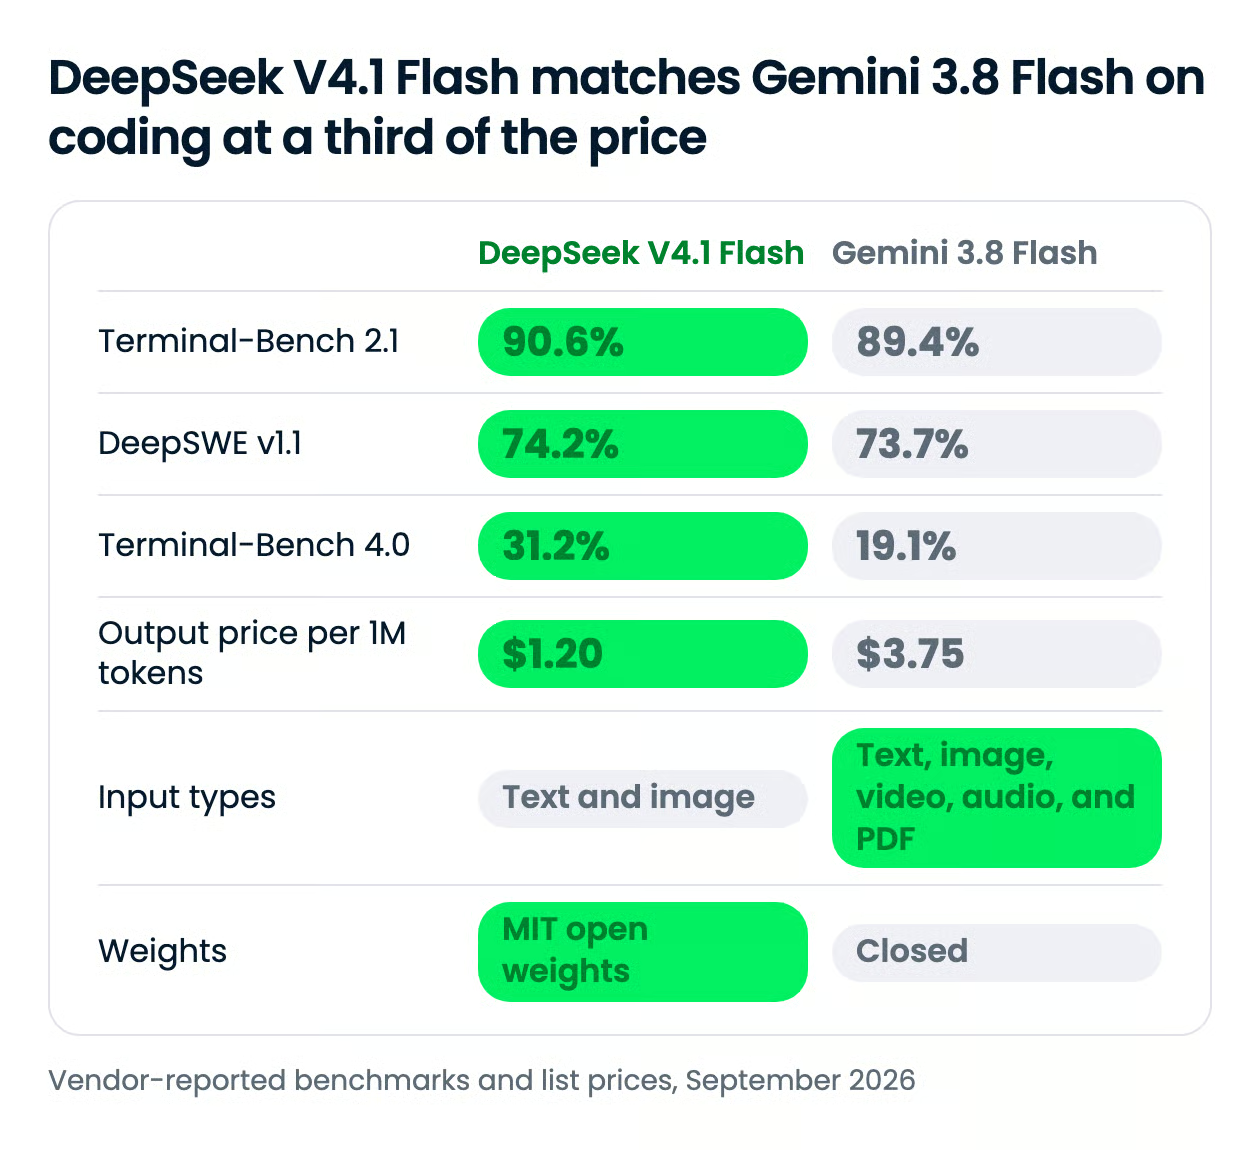
Sulle sei dimensioni qui sotto, DeepSeek V4.1 Flash vince su prezzo e apertura e pareggia sul coding, mentre Gemini 3.8 Flash vince su tipi di input, tooling e risultati pubblicati per lavori di conoscenza.
| Caratteristica | DeepSeek V4.1 Flash | Gemini 3.8 Flash |
|---|---|---|
| Rilascio | 10 settembre 2026 | 2 settembre 2026 |
| Pesi e licenza | Open, MIT | Chiuso, hosted |
| Architettura | 552B MoE, 8B attivi in prefill, 16B in decode | Non divulgata; basata su Gemini 3.7 Flash |
| Contesto / output max | 1M token / 384K | 1M token / 64K |
| Tipi di input | Testo, immagine | Testo, immagine, video, audio, PDF |
| Terminal-Bench 2.1 | 90,6% | 89,4% |
| DeepSWE v1.1 | 74,2% | 73,7% |
| Impostazioni sforzo di ragionamento | low, high, max sull’API (intero 1-100 sottostante) |
low, medium, high |
| Prezzo API, input / output per 1M | $0,30 / $1,20 (peak) | $0,75 / $3,75 (fino al 2026; poi 2x) |
DeepSeek V4.1 Flash è in testa in tutti e tre i benchmark agentici presenti nelle tabelle di entrambi i vendor, anche se due scarti sono abbastanza piccoli da poterli considerare un pareggio.
Il divario che conta davvero è Terminal-Bench 4.0, la suite general-agent più impegnativa: 31,2% per DeepSeek contro 19,1% per Gemini. Entrambi ammettono che questa suite li mette in difficoltà; DeepSeek afferma che resta un gap con i modelli giganti su task agentici a orientamento scientifico, e la tabella di Google colloca Claude Opus 5 al 51,8%.
| Benchmark | DeepSeek V4.1 Flash | Gemini 3.8 Flash | Note |
|---|---|---|---|
| Terminal-Bench 2.1 | 90,6% | 89,4% | Entrambi eseguiti dal vendor; entrambe le tabelle indicano Claude Opus 5 all’89,1% |
| DeepSWE v1.1 | 74,2% | 73,7% | Entrambi eseguiti dal vendor; entrambe le tabelle indicano Claude Opus 5 al 74,0% |
| Terminal-Bench 4.0 | 31,2% | 19,1% | Suite condivisa più difficile; Opus 5 al 51,8% in entrambe le tabelle |
Due avvertenze:
Per agenti di coding a forte uso di terminale, considera i due alla pari e lascia che prezzo e deployment decidano; sui task agentici più difficili, il vantaggio pubblicato di DeepSeek è l’unico in campo.
Il prezzo è l’unica dimensione senza contesa, quindi la domanda interessante è quanto cambia il divario in base alla forma del tuo carico.
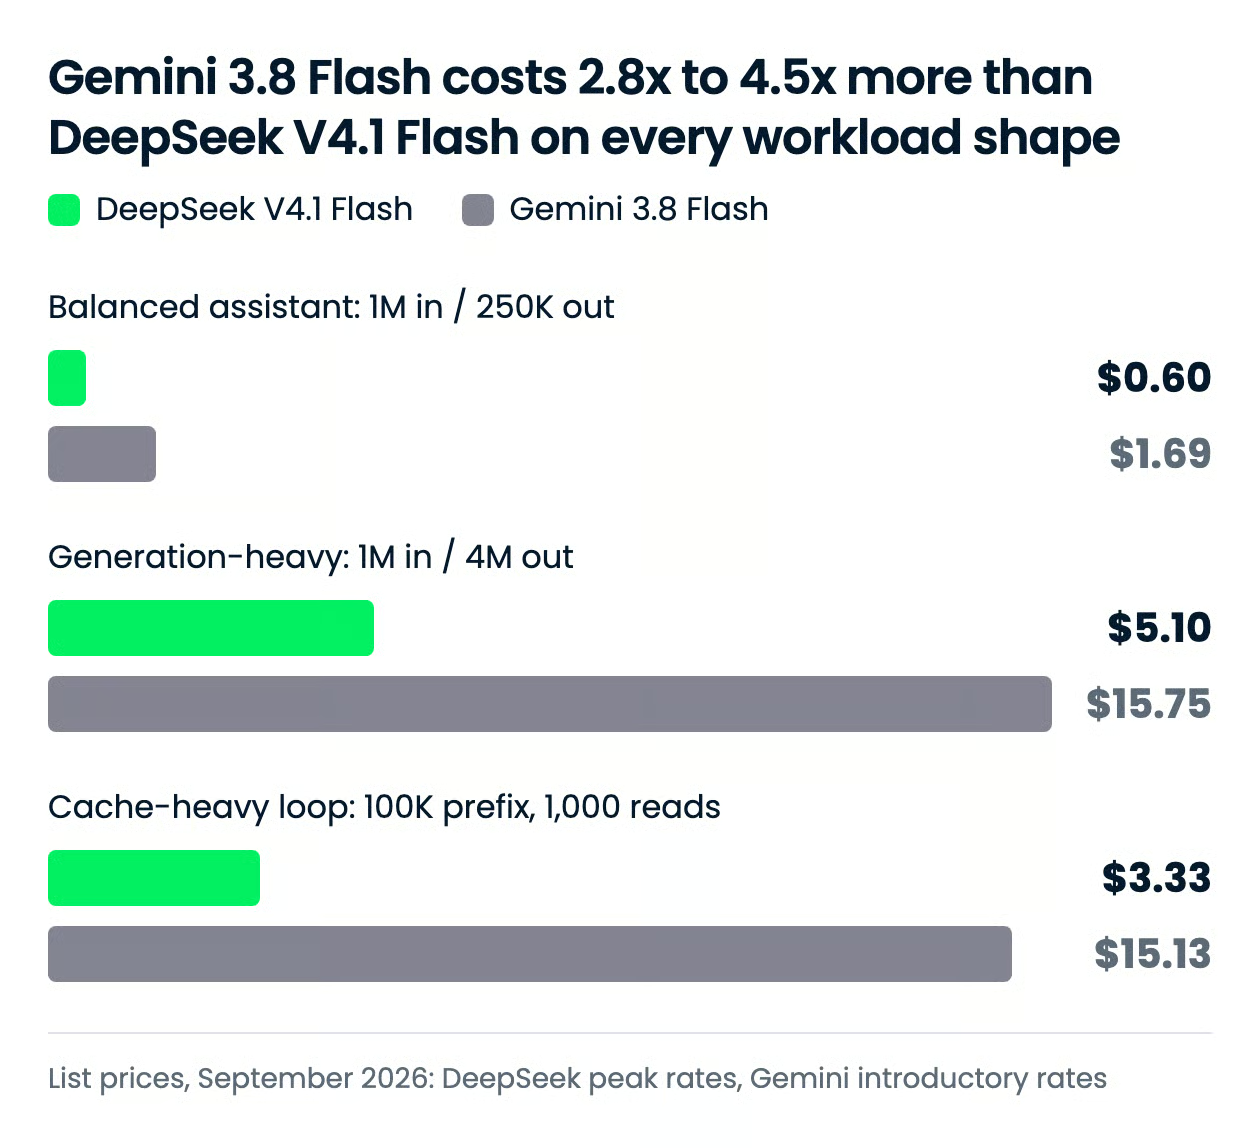
DeepSeek V4.1 Flash è più economico su ogni voce, e il divario aumenta quanto più il carico si basa su token di output o su prefissi in cache. Il multiplo non è uniforme, ed è questa la scoperta: 2,5x in input, 3,1x in output e 12,5x sulle letture da cache.
| Tariffa | DeepSeek V4.1 Flash (peak) | Gemini 3.8 Flash (fino al 31 dic 2026) |
|---|---|---|
| Input, per 1M token | $0,30 | $0,75 |
| Output, per 1M token | $1,20 | $3,75 |
| Lettura input in cache, per 1M token | $0,006 | $0,075, più $0,50 per 1M token per ora di storage |
| Percorso sconti | Off-peak: -50% su tutte le tariffe fuori 01:00-04:00 e 06:00-10:00 UTC nei giorni feriali | Batch o Flex: -50% ($0,375 / $1,875) |
| Token di ragionamento fatturati come | Output | Output |
| Dal 1° gennaio 2027 | Nessun cambiamento annunciato | $1,50 / $7,50; lettura cache $0,15 |
La differenza ha la forma di un premio sull’output. La tariffa di output di Gemini è 3,1x quella di DeepSeek mentre la tariffa di input è 2,5x, quindi il lavoro pesante in generazione e “thinking” paga di più, e entrambi fatturano i token di ragionamento come output.
| Carico | DeepSeek V4.1 Flash | Gemini 3.8 Flash | Differenza |
|---|---|---|---|
| Assistente bilanciato: 1M in / 250K out | $0,60 | $1,69 | $1,09, Gemini +181% |
| Generazione pesante: 1M in / 4M out | $5,10 | $15,75 | $10,65, Gemini +209% |
| Loop con cache pesante: prefisso 100K scritto una volta, 1.000 letture cache, più 5K nuovi in / 1K out per richiesta | $3,33 | $15,13 | $11,80, Gemini +354% |
La formula è (volume ÷ 1M) × tariffa, sommata tra input e output, alle tariffe peak di DeepSeek e introduttive di Gemini. La riga cache-centrica usa la tariffa di lettura cache di ciascun vendor per le 1.000 letture e assume che la cache di Gemini sia mantenuta per 1 ora, aggiungendo $0,05 di storage.
La riga cache-centrica è il titolo, perché la tariffa di $0,006 di DeepSeek rende quasi gratuita la ri-lettura di un prefisso da 100K token, mentre Gemini addebita $7,50 per gli stessi 100M token in cache.
Pianifica DeepSeek in off-peak e ogni riga si dimezza; aspetta gennaio e ogni riga di Gemini raddoppia, quindi l’assistente bilanciato diventa $3,38 contro $0,60.
DeepSeek V4.1 Flash è l’unico dei due che puoi scaricare, e la sua architettura è il motivo per cui costa poco. Il rapporto tecnico descrive un encoder causale a 20 layer che alimenta un decoder a 20 layer, Compressed Sparse Attention 2 con caching KV in FP4, e una cache KV di 890 byte per token, in calo dai 3.514 byte di V4 Flash.
Il serving di questi pesi con licenza MIT è però ancora agli inizi, con vLLM e SGLang supportati in build nightly e preview, e senza supporto Transformers.
Se ti serve residenza dei dati, inferenza on-prem o fine-tuning, DeepSeek è l’unico candidato qui. Se vuoi zero infrastruttura, l’endpoint GA hosted di Gemini è la via più semplice.
Gemini 3.8 Flash accetta testo, immagini, video, audio e PDF, mentre DeepSeek V4.1 Flash accetta testo e immagini. Entrambi offrono una finestra di contesto da 1M token, ma DeepSeek consente fino a 384K token di output, contro i 64K di Gemini, il che conta per generazione di codice lunga e riscritture di documenti completi.
La pagina del modello di Gemini elenca anche strumenti hosted a cui DeepSeek non ha equivalenti: esecuzione di codice, grounding su Google Search e Maps, ricerca file, contesto da URL e uso del computer in preview. Dal lato API, DeepSeek offre output JSON, tool call, una Responses API, un endpoint in formato Anthropic e completion con prefisso e fill-in-the-middle.
Se i tuoi input includono audio o video, o vuoi grounding senza costruire il retrieval, la scelta è Gemini; se vuoi output lunghi e compatibilità drop-in con client OpenAI o Anthropic esistenti, è DeepSeek.
I benchmark di due vendor diversi arrivano fino a un certo punto, quindi ho eseguito un task di build su entrambi i modelli con prompt e tooling identici.
Ho chiesto a entrambi di costruire una web app stateless in un singolo file per uno scheduler di prove di un’orchestra comunitaria. Due funzionalità richieste esplicitamente: rilevamento dei conflitti per sovrapposizione di intervalli e persistenza. Entrambi i modelli sono vicini al 90% su Terminal-Bench 2.1, ma il 31,2% di DeepSeek contro il 19,1% di Gemini su Terminal-Bench 4.0 suggerisce un divario nel lavoro agentico più difficile, e questo task è un modo compatto per cercarlo.
Entrambi i modelli sono stati eseguiti in OpenCode con una superficie di strumenti identica e bloccata: sola lettura e modifica file, niente shell e niente rete. Entrambi a sforzo di ragionamento high, un tentativo ciascuno, senza retry, e il prompt è stato inviato byte-per-byte a una sessione nuova.
Un’asimmetria da tenere a mente: high è il livello massimo di sforzo per Gemini, mentre su DeepSeek mappa a 75 su una scala da 1 a 100, il cui massimo corrisponde a quello usato per i punteggi di benchmark pubblicati.
Questo era il prompt:
Build a single-file HTML page (inline CSS and JS, no build step, no external dependencies, no network) for a rehearsal scheduler used by a community orchestra.
It needs:
- a week view (Mon–Sun) showing rehearsal blocks by section: strings, brass, woodwind, percussion;
- a conflict indicator that flags when two sections are booked in the same room at overlapping times (not merely the same slot);
- an add-rehearsal form with section, room, day, start time, and end time;
- localStorage persistence, so rehearsals survive a page reload.

Ship it as one working file named `index.html`. Do not install packages. Do not open, screenshot, or headless-render the page (no Playwright, Puppeteer, or Chrome).
Do not ask me clarifying questions — make reasonable assumptions and note them briefly in a comment at the top of the file.
Ho valutato entrambi sulla possibilità di esecuzione (fail/pass) e sulle tre rubriche seguenti, con punteggi da 1 a 5:
DeepSeek ha terminato in 2 turni con una sola chiamata strumento: ha scritto un index.html da 13 KB e dichiarato completato. La pagina è un layout scuro a due pannelli, un form per aggiungere prove a sinistra, una griglia lun-dom a destra, con un pannello di controllo conflitti sotto. Il commento in header esplicita la regola di sovrapposizione, sovrapposizione stretta con esclusione delle prenotazioni back-to-back, e la verifica ha confermato che segnala solo la coppia sovrapposta.
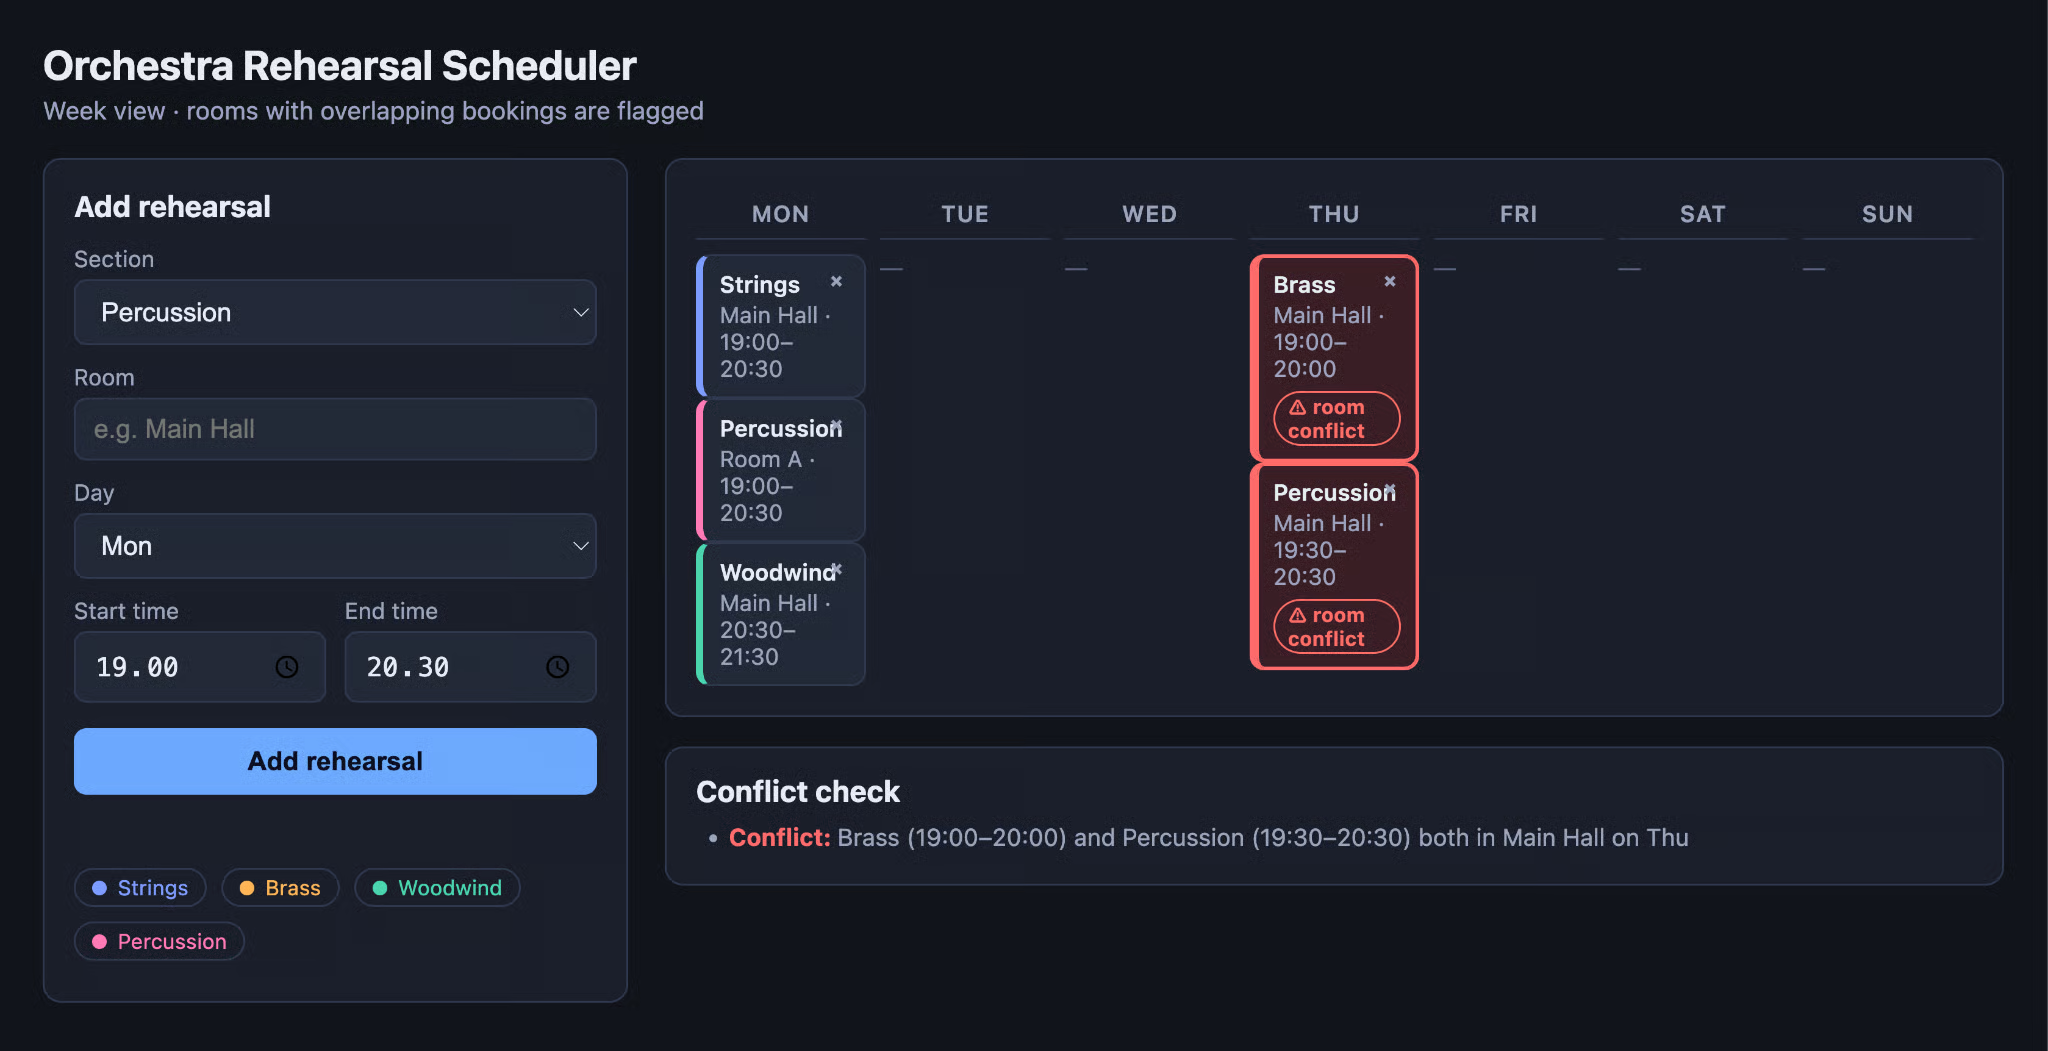
Tutto ciò che è stato richiesto è presente e funziona, il layout è leggibile a colpo d’occhio, e l’unico extra non richiesto, l’eliminazione delle voci, aiuta. Non consente di modificare una voce, che il prompt non chiedeva. È un 5 pulito su tutte e tre le rubriche.
Gemini ha impiegato 4 turni e 3 chiamate strumento (un glob, una read, poi una write) per consegnare un index.html da 76 KB (quasi 6x il file di DeepSeek), ed è stato molto più lento. Il risultato appare più rifinito: un header brandizzato con un contatore live dei flag di sovrapposizione, una settimana di esempio pre-caricata con un doppio booking intenzionale il mercoledì così l’indicatore si vede subito, filtri per sezione e stanza, un toggle solo conflitti, viste a colonna e timeline, modifica ed eliminazione delle voci, un campo note sul repertorio e un avviso live durante la compilazione di una nuova prenotazione.
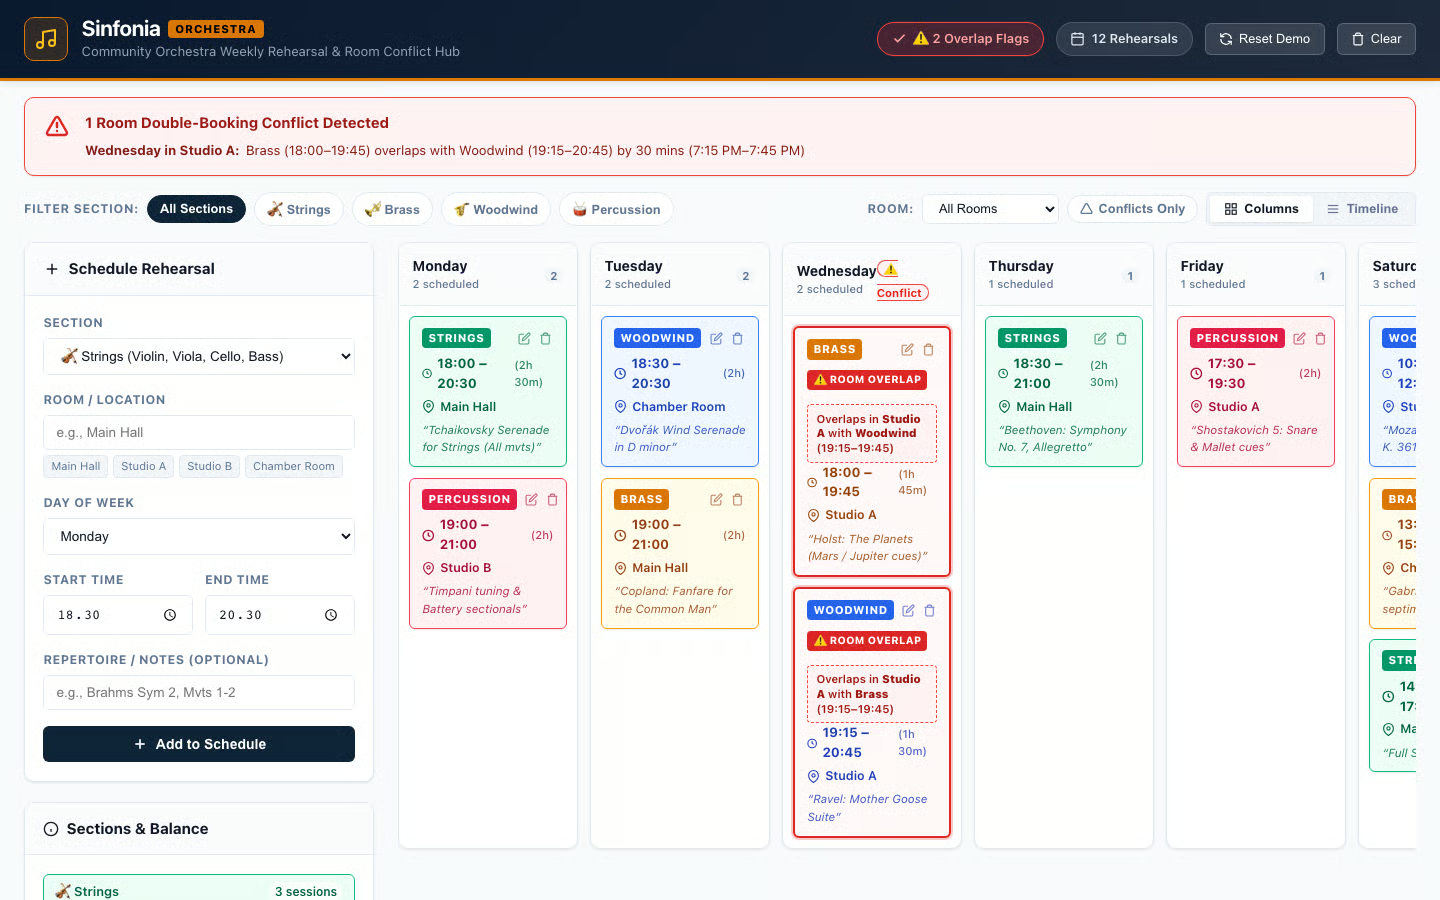
La logica dei conflitti è corretta, e la verifica ha segnalato solo la coppia sovrapposta. Gli extra sono il problema: un pannello Sections and Balance con conteggi per sezione ha costretto a far scorrere la colonna del form (in contrasto con il prompt) e si colloca in modo goffo sotto il resto, e l’elevato numero di controlli rende la settimana meno leggibile rispetto a DeepSeek. Per questo devo togliere un punto ciascuno per aderenza alla specifica e layout, sebbene il risultato complessivo sia molto buono.
| Misura | DeepSeek V4.1 Flash | Gemini 3.8 Flash |
|---|---|---|
| Turni | 2 | 4 |
| Chiamate strumento | 1 | 3 |
| Eseguibilità | pass | pass |
| Aderenza alla specifica | 5 | 4 |
| Logica dei conflitti | 5 | 5 |
| Usabilità e layout | 5 | 4 |
| Punteggio rubric (media dei tre assi) | 5,0 | 4,3 |
DeepSeek V4.1 Flash vince questo test. Entrambi hanno azzeccato la parte difficile, la logica di sovrapposizione degli intervalli, quindi la differenza è stata di giudizio: DeepSeek ha costruito ciò che era richiesto in una singola scrittura, mentre Gemini ha costruito un piccolo prodotto, e una funzione non richiesta ha danneggiato il layout su cui era valutato. La versione di Gemini è quella che mostrerei a un manager d’orchestra; quella di DeepSeek è quella che preferirei ricevere da un collega.
Questa è un’unica esecuzione di un unico task a un solo livello di sforzo, quindi non dice nulla su uso di token o costi, e sonda solo UI stateful più logica di sovrapposizione, non lavoro su repository a lungo orizzonte.
Nessuno dei due è la scelta predefinita per tutti, quindi ecco la decisione per carico di lavoro.
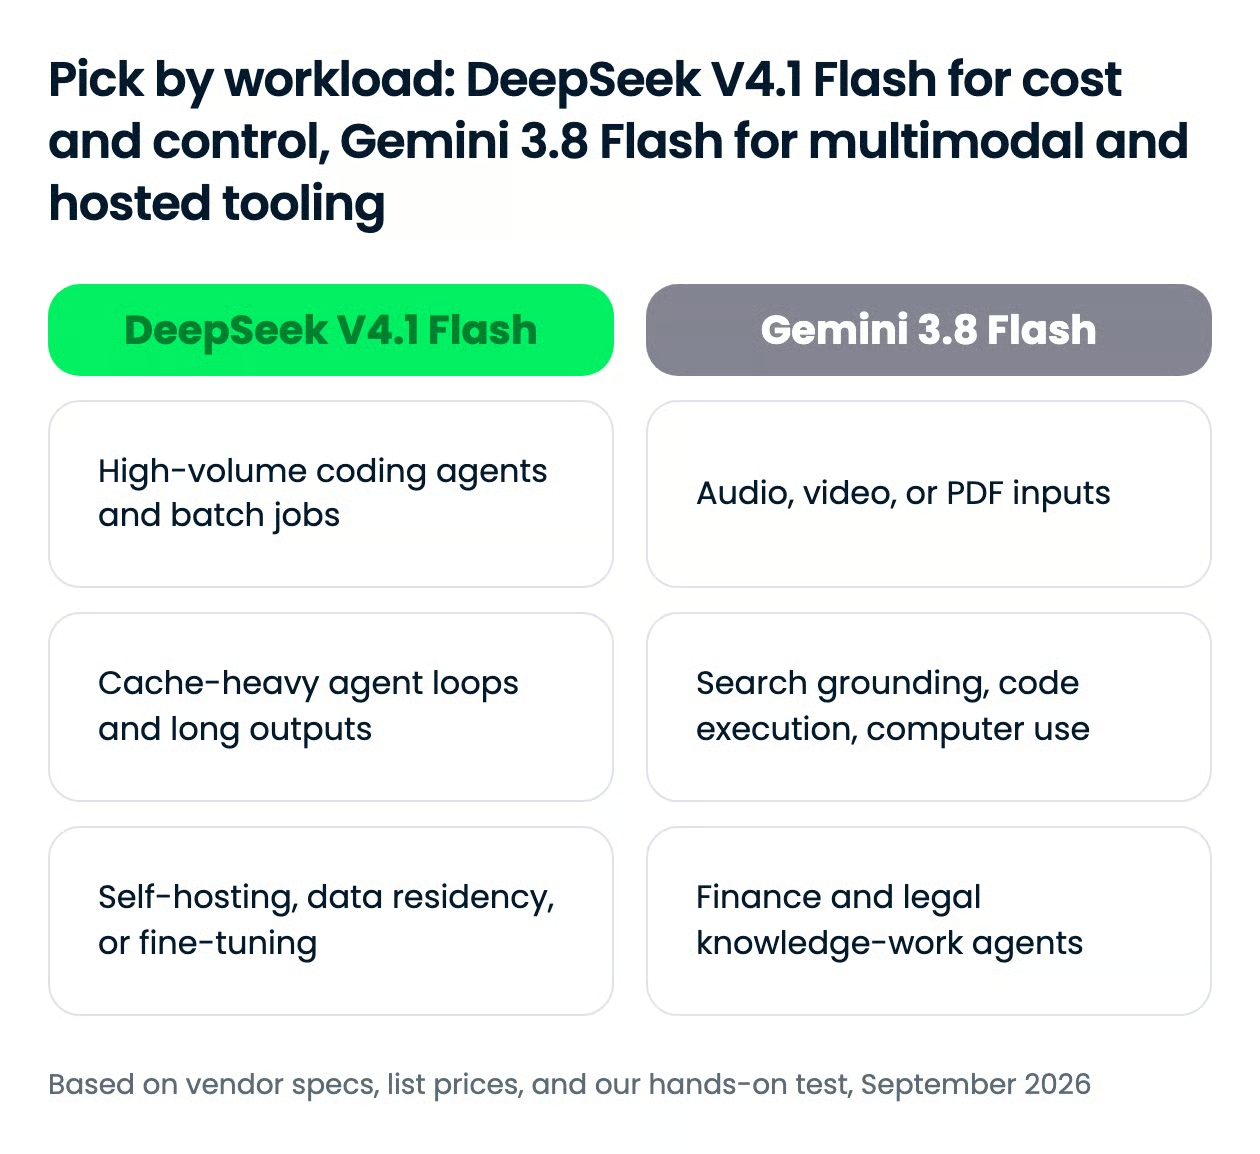
Il bivio sono input, infrastruttura e budget: i due sono alla pari sul coding agentico, quindi DeepSeek vince quando decidono costo o controllo, e Gemini vince quando i tuoi dati o il tuo stack sono qualcosa che DeepSeek non può ingerire o ospitare per te.
Dove puoi raggiungere ciascun modello differisce più di ciò che può fare, quindi controlla la matrice prima dei benchmark.
| Superficie | DeepSeek V4.1 Flash | Gemini 3.8 Flash |
|---|---|---|
| App consumer | App DeepSeek e chat.deepseek.com | App Gemini (Google AI Pro e Ultra), AI Mode in Search, Gemini in Sheets |
| API first-party | Sì, DeepSeek API (formati richieste OpenAI e Anthropic) | Sì, Gemini API via Google AI Studio (GA) |
| Piattaforme cloud | Nessuna listing cloud first-party; servito da Databricks e altri, o self-host dei pesi MIT | Gemini Enterprise su Google Cloud |
| Agenti di coding | DeepSeek Harness; OpenCode, WorkBuddy e CodeBuddy (partner ufficiali) | Google Antigravity (modello predefinito), Android Studio, Stitch; Cursor, OpenCode |
| Router di terze parti | OpenRouter | OpenRouter |
| ID modello API | deepseek-flash |
gemini-3.8-flash |
La differenza di disponibilità maggiore è che DeepSeek è scaricabile e Gemini no, mentre Gemini è quello con un’app consumer e una piattaforma enterprise gestita. Gli ID da digitare sono deepseek-flash e gemini-3.8-flash; il nome legacy deepseek-v4-flash risolve ancora ma è servito da V4.1 Flash.
I due SDK differiscono, quindi non è una sostituzione di una stringa. L’endpoint di DeepSeek è compatibile con OpenAI, il che significa che il client standard openai funziona con un cambio della base URL, mentre Gemini 3.8 Flash usa l’Interactions API di google-genai con un’impostazione thinking_level al posto dei parametri di campionamento.
from openai import OpenAI

client = OpenAI(api_key="YOUR_DEEPSEEK_KEY", base_url="https://api.deepseek.com")
response = client.chat.completions.create(
    model="deepseek-flash",  # DeepSeek V4.1 Flash
    messages=[{"role": "user", "content": "Refactor this function..."}],
)
print(response.choices[0].message.content)
from google import genai
client = genai.Client() # reads your Google AI Studio API key
interaction = client.interactions.create(
model="gemini-3.8-flash",
input="Refactor this function...",
generation_config={"thinking_level": "medium"}, # low, medium, or high
)
print(interaction.output_text)Per il setup completo, l’estrazione PDF e le function call su Gemini, segui il nostro tutorial sull’API di Gemini 3.8 Flash; per la modalità “thinking” di DeepSeek e un deployment locale della generazione precedente, vedi il nostro tutorial sull’API di DeepSeek V4 e la nostra guida a eseguire DeepSeek V4 Flash con Unsloth Studio e OpenCode.
Se il tuo carico è fatto di agenti di coding, job batch o qualsiasi cosa che ri-legge prefissi lunghi, usa DeepSeek V4.1 Flash: è alla pari con Gemini 3.8 Flash sui benchmark agentici pubblicati, ha vinto il nostro test di build in 2 turni e costa un terzo prima dell’aumento di prezzo di gennaio per Gemini. Se i tuoi input sono audio, video o PDF, o vuoi grounding, esecuzione di codice e uso del computer da un unico endpoint hosted, usa Gemini 3.8 Flash e accetta il premium.
Se vuoi costruire sistemi di agenti intorno a modelli come questi, il nostro percorso Associate AI Engineer for Developers copre API, uso di strumenti e Model Context Protocol in 29 ore, e il nostro corso Building AI Agents with Google ADK è un avvio di 1 ora sul lato Gemini.
Impara l’AI con DataCamp!
Programma
Corso
Corso