course
Praca z DeepSeek w Pythonie
3 godz.
1.3K
DeepSeek udostępnia V4.1 Flash przez API pod identyfikatorem modelu deepseek-flash. Przyjmuje obrazy, obsługuje tryby z rozumowaniem i bez rozumowania, ma okno kontekstu 1M tokenów i może zwrócić do 384K tokenów przez Chat Completions i Responses API.
Nasz przegląd DeepSeek V4.1 Flash omawia premierę, architekturę i benchmarki.
DeepSeek opisuje V4.1 Flash jako szkielet MoE z 552 mld parametrów, podczas gdy Hugging Face podaje 763 mld parametrów dla opublikowanego checkpointu. Różnica to głównie 196 mld parametrów w pamięci warunkowej Engram, plus enkoder i projektor wizyjny — komponenty dostarczane w checkpointcie, ale spoza szkieletu MoE.
Jego konstrukcja Causal Encoder-Decoder ponownie wykorzystuje zbuforowane stany enkodera, z 8 mld aktywnych parametrów na token w przetwarzaniu wejścia i 16 mld podczas generowania wyjścia.
V4.1 Flash to pierwszy model w nowej rodzinie architektur V4.1 z natywnie wbudowanym rozumieniem obrazu. Wektory wizualne i tekstowe są trenowane wspólnie od początku pre-treningu, zamiast być dodawane później jak w eksperymentalnym V4-Flash-Vision-Exp.
Responses API powstało przed V4.1 Flash; DeepSeek dodał natywne wsparcie podczas wcześniejszego wdrożenia V4. Wycofane nazwy modeli deepseek-v4-flash i deepseek-v4-flash-vision-exp teraz kierują do V4.1 Flash.
Cennik DeepSeek zależy od godzin szczytu, a stawki poza szczytem są ustawione na 50% stawek szczytowych. Gdy uruchamiałem agenta, zbuforowane wejście kosztowało 0,003 USD za milion tokenów poza szczytem i 0,006 USD w szczycie, niezbuforowane wejście 0,15 USD poza szczytem i 0,30 USD w szczycie, a wyjście 0,60 USD poza szczytem i 1,20 USD w szczycie, zgodnie ze stroną cen DeepSeek.
Godziny szczytu to 01:00–04:00 i 06:00–10:00 UTC od poniedziałku do piątku, z wyłączeniem chińskich świąt publicznych. Każda inna godzina jest poza szczytem, a chińskie święta publiczne są w całości poza szczytem.
Nimbus Analytics Launch Metrics to pulpit Flask dla łącznej liczby odwiedzających, zapisów, współczynnika konwersji, przychodu i dziennych zapisów. Rozmieściłem trzy błędy w trzech plikach i nie powiedziałem agentowi, jakie są. Kod i zepsuty pulpit znajdziesz w tym repozytorium GitHub.
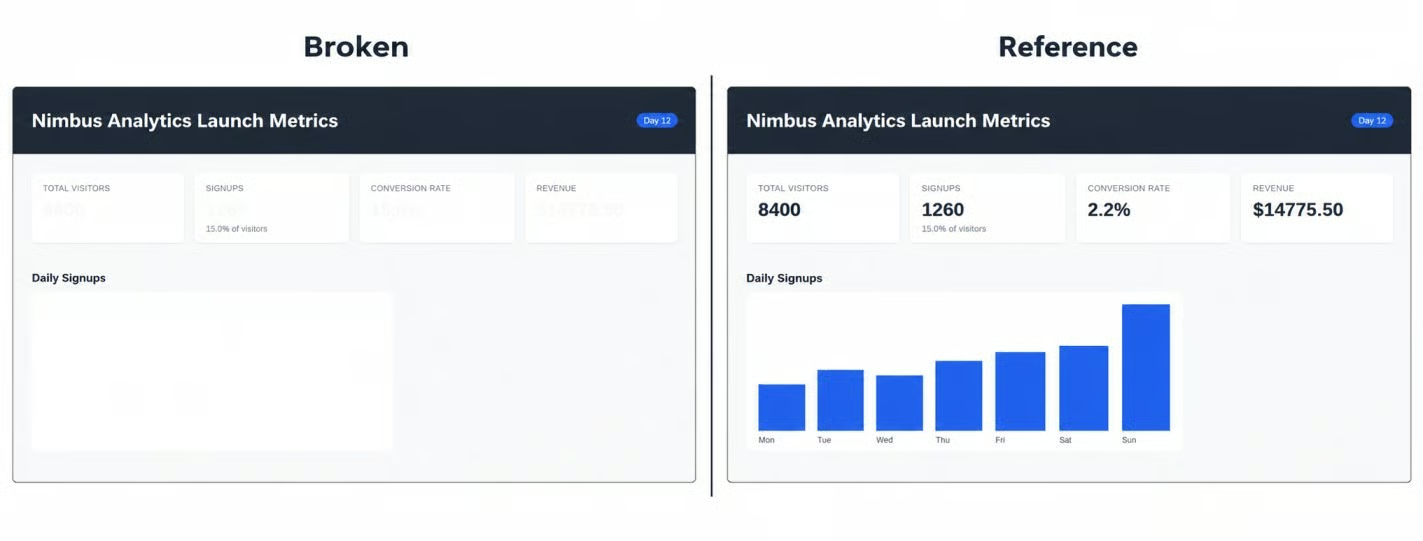
Zepsuty pulpit obok projektu referencyjnego. Obraz: autor.
Te trzy błędy wymagają różnych dowodów. Jeden widać na zrzucie ekranu, jeden wpływa na zachowanie przeglądarki, a jeden oblewa pytest. Agent nie dostaje listy błędów.
Zanim przekażę to agentowi, definiuję, co znaczy „naprawione”: zestaw testów pytest musi przejść, a świeży zrzut ekranu ma wizualnie odpowiadać obrazowi referencyjnemu. Sama opinia modelu nie wystarcza, więc runner sprawdza oba rodzaje dowodów.
Pętla przeplata żądanie do modelu z lokalnym wykonaniem narzędzi. V4.1 Flash zwraca rozumowanie, wiadomość lub wywołania narzędzi; Python uruchamia żądane narzędzia i dodaje wyniki do historii. Pętla zatrzymuje się, gdy model odpowie bez kolejnego wywołania narzędzia lub osiągnie limit czternastu tur.
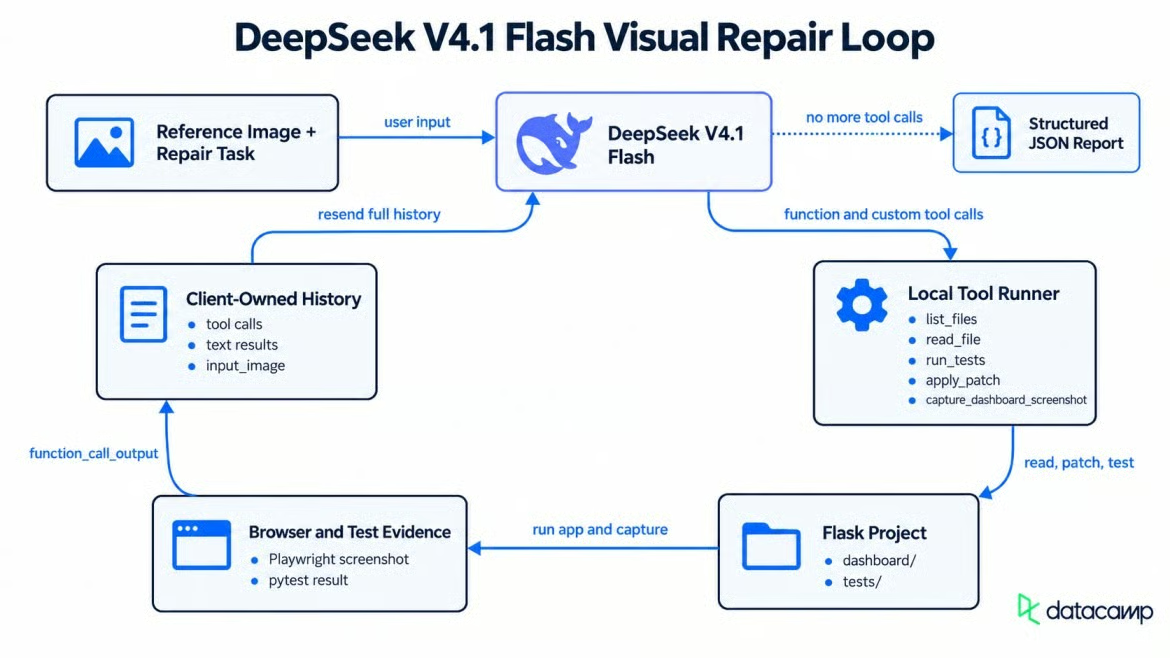
Pętla naprawcza łącząca model, narzędzia i przeglądarkę. Obraz: autor.
Potrzebujesz Pythona 3.10 lub nowszego oraz klucza API DeepSeek ze środkami. API DeepSeek podąża za formatem żądań OpenAI, więc w projekcie używamy pakietu openai dla Pythona z base_url ustawionym na DeepSeek.
Utwórz środowisko wirtualne i zainstaluj wymagane pakiety.
python3 -m venv .venv
source .venv/bin/activate
pip install openai flask playwright pytest python-dotenv requests streamlit
playwright install chromium
Testowałem to z openai 3.14.1, flask 3.1.3 i playwright 1.63.0. Zapisz klucz w pliku .env w katalogu głównym projektu jako DEEPSEEK_API_KEY=sk-... i wczytaj go przez python-dotenv. Jeśli twój klucz już działa z Responses API, pomiń następny blok kodu; w przeciwnym razie żądanie sprawdzi klucz i bazowy URL.
from openai import OpenAI
import os
from dotenv import load_dotenv

load_dotenv()
client = OpenAI(api_key=os.environ["DEEPSEEK_API_KEY"], base_url="https://api.deepseek.com")

response = client.responses.create(model="deepseek-flash", input="Say hi in five words.")
print(response.output_text)
Jeśli to wydrukuje krótkie powitanie, klucz i bazowy URL działają.
Pierwszy wkład agenta zawiera zrzut ekranu referencyjny, krótkie zadanie i live URL. To jedyny obraz wysyłany w wiadomości użytkownika. Wszystkie późniejsze zrzuty pochodzą z narzędzia.
Runner wysyła obraz referencyjny jako URL danych base64 przy każdym żądaniu. DeepSeek zaleca Files API, gdy obraz jest ponownie używany. file_id pozwala uniknąć wysyłania tych samych danych obrazu za każdym razem.
Na dołączonym obrazie zapytałem, co model sprawdziłby najpierw, ale nie było żadnych narzędzi. Pozwoliło mi to obejrzeć plan zanim mógł cokolwiek edytować. Odpowiedź proponowała listę plików projektu, prześledzenie zmiennych CSS i wykonanie zrzutu ekranu; użyłem reasoning: {"effort": "high"}, domyślnego poziomu rozumowania DeepSeek.
Agent dostaje cztery narzędzia funkcji i jedno niestandardowe.
list_files i read_file przeglądają projekt, ograniczone do dashboard/ i tests/.
run_tests uruchamia pytest.
capture_dashboard_screenshot uruchamia bezgłownego Chromium przez Playwright.
Niestandardowym narzędziem jest apply_patch, zadeklarowane jako {"type": "custom", "name": "apply_patch"} i akceptowane „dla kompatybilności z Codex”. Każda inna nazwa narzędzia custom zwraca błąd 400, natomiast wbudowane typy jak wyszukiwanie w sieci i obsługa komputera są po cichu ignorowane.
Argumenty funkcji przychodzą jako tekst JSON i są sprawdzane zanim Python je uruchomi. apply_patch przychodzi jako wejście narzędzia custom, więc kod obsługuje je osobno i weryfikuje patch przed zapisem plików. Błędy narzędzi są zwracane do modelu zamiast zatrzymywać pętlę.
Gdy capture_dashboard_screenshot działa, jego wynik nie jest zapisywany na dysku. Python zwraca go jako część input_image wewnątrz function_call_output. DeepSeek odczytuje wtedy zrzut jako obraz, a nie opis tekstowy.
history.append({
    "type": "function_call_output",
    "call_id": item.call_id,
    "output": [{"type": "input_image", "image_url": f"data:image/png;base64,{png_b64}"}],
})
Agent może załatać CSS, zrobić kolejny zrzut i sprawdzić, czy liczby są czytelne.
Historia żyje na liście w Pythonie, ponieważ API nie obsługuje previous_response_id ani konwersacji po stronie serwera. Tryb rozumowania wymaga też każdego elementu rozumowania z wcześniejszych tur narzędzi.
Ważne: jeśli wynik narzędzia zostanie wstawiony między dwa wywołania z tej samej tury, następne żądanie zwróci błąd 400. Dołącz każdy element z response.output w kolejności, potem uruchom narzędzia i dołącz ich wyniki.
Runner ogranicza agenta do czternastu tur oraz katalogów dashboard/ i tests/ . Nie daje dostępu do shell’a, sprawdza argumenty narzędzi i używa pytest do weryfikacji.
Czy DeepSeek V4.1 Flash wspiera ustrukturyzowane wyjście?
Tak, przez Responses API DeepSeek V4.1 Flash akceptuje JSON Schema poprzez text.format. Chat Completions response_format obsługuje tryb JSON, ale bez schematów. Po zatrzymaniu pętli końcowe żądanie zapisuje błędy, poprawki, wyniki testów, wyniki zrzutów i metodę weryfikacji.
Projekt zawiera też aplikację Streamlit w app_streamlit.py. Ten sam agent działa jako generator z stream=True, więc strona pokazuje tekst rozumowania i wywołania narzędzi na bieżąco. Panel boczny zmienia poziom wysiłku rozumowania i szczegółowość obrazu.
Interfejs Streamlit strumieniuje przebieg agenta. Wideo: autor.
Po jednej łatce wyglądało na to, że wszystko skończone, ale żywa strona nie zgadzała się z tym.
Agent wykorzystał pierwsze dwie tury na obejrzenie, zanim czegokolwiek dotknął: w turze pierwszej wypisał pliki i zrobił bazowy zrzut, w turze drugiej przeczytał app.py, index.html, style.css i plik testu.
W turze trzeciej uruchomił pytest, potem w czwartej zastosował jedną łatkę, która poprawiła formułę konwersji, zmieniła kolor metryki i dopasowała wyszukiwanie w JavaScript do ID canvasa.
-    conversion_rate = data["conversions"] / data["signups"] * 100
+    conversion_rate = data["conversions"] / data["total_visitors"] * 100
Uruchomienie testów w turze piątej pokazało pięć zaliczonych. Tu przebieg przestał być schludny. Każdy nowy zrzut nadal pokazywał 15% współczynnik konwersji i pusty wykres.
Agent potwierdził, że pliki na dysku zawierają poprawki, ponowił zrzut i zbadał, czy serwer ładuje zmienione pliki Pythona i szablony. Dwa tymczasowe testy świeżości też nie pojawiły się na żywej stronie.
Do czternastej tury pętla dobiła do budżetu i wskazała przyczynę: run_tests sprawdza kod na dysku, podczas gdy zrzut dotyczy działającego procesu ze starym stanem. Flask został uruchomiony z debug=False, więc przeładowywacz nie wczytał zmienionego modułu Pythona, a auto-reload szablonów nie był włączony.
Zmiana w CSS była widoczna, podczas gdy wartość pochodząca z Pythona i wykres oparty na szablonie pozostawały nieświeże. Pytest importował app.py z dysku, więc zielone testy nie gwarantowały świeżej strony.
Po restarcie Flaska pulpit dopasował się do obrazu referencyjnego. Brakującym elementem było narzędzie restart_server, a nie kolejna łatka kodu.
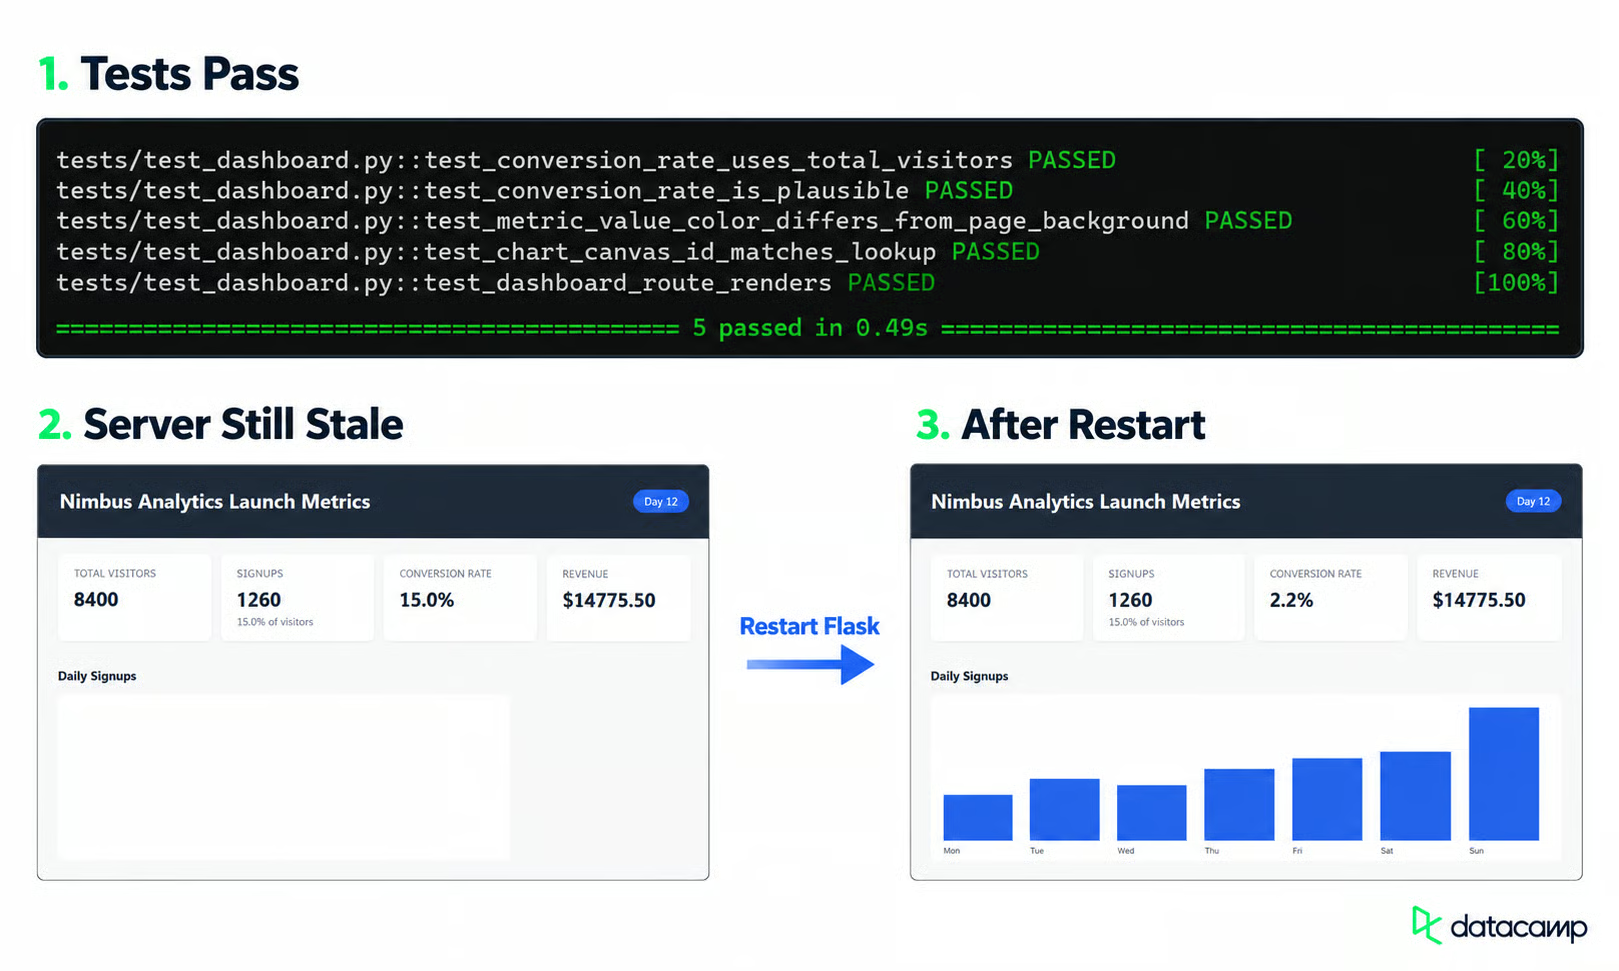
Restart ujawnia zmiany po łatce na pulpicie. Obraz: autor.
Tak, agent naprawił pulpit na dysku. Zmienił tylko trzy wadliwe pliki, a pytest przeszedł z czterech porażek do pięciu zaliczonych testów. Po restarcie Flaska żywa strona pokazała każdą poprawkę.
Ponieważ agent ponownie wysyła swoją historię, późniejsze żądania powtarzają dużą część wejścia z wcześniejszych tur. DeepSeek sprawdza ten powtórzony prefiks względem automatycznego cache. Cache działa na zasadzie „best effort”, więc te wartości dotyczą tylko tego przebiegu.
Przez czternaście tur naprawczych i końcowe żądanie raportu JSON, API raportowało 156 724 tokeny wejścia, w tym 137 088 z cache, co daje 87% trafień. Wyjście to 11 497 tokenów, w tym 9 362 tokeny rozumowania. Przebieg był poza szczytem, więc wszystkie piętnaście żądań kosztowało około 0,0103 USD.
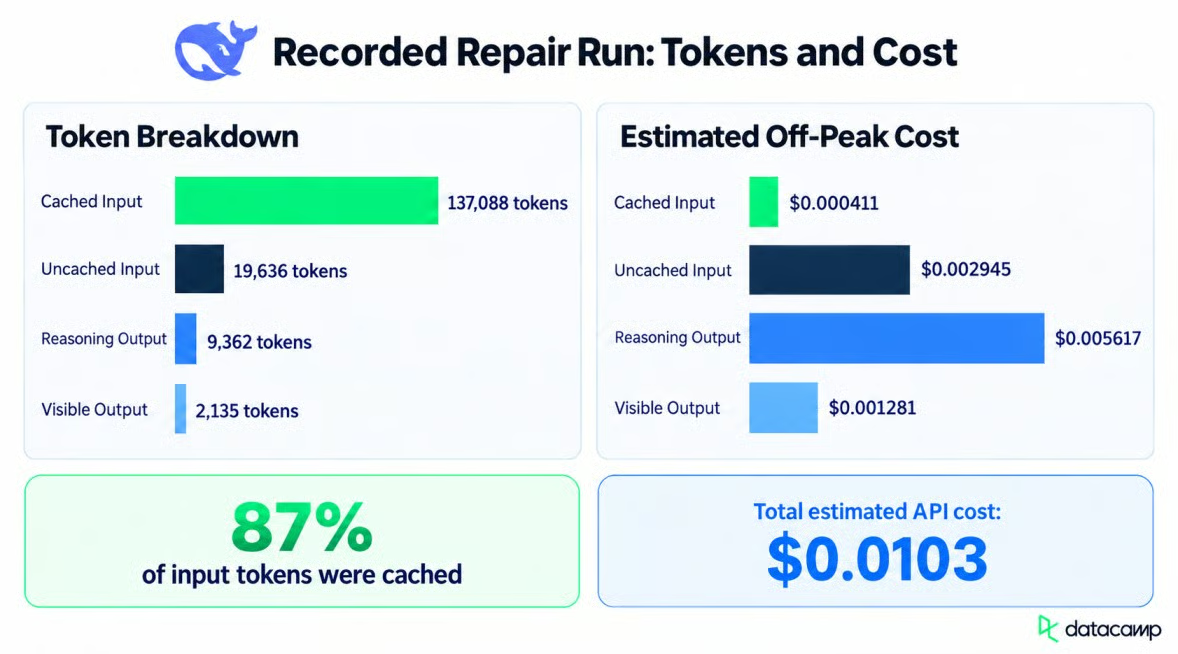
Wyjście z rozumowania to największa kategoria kosztów. Obraz: autor.
Większa baza kodu, więcej zrzutów lub mniej trafień cache zmieni zarówno liczbę tokenów, jak i koszt.
Trzy ograniczenia API mają znaczenie, zanim ten runner wyjdzie poza demo.
Odpowiedzi w tle nie są wspierane, więc długie tury blokują do zakończenia.
parallel_tool_calls i max_tool_calls są ignorowane; równoległe wywołania narzędzi pozostają włączone.
Automatyczne ucinanie nie jest wspierane, więc żądania przekraczające limit kontekstu zwracają błąd 400.
Zanim użyjesz tego wzorca w usłudze produkcyjnej, umieść kontrolę w kodzie aplikacji zamiast w instrukcjach dla modelu.
Użyj apply_patch, gdy pojedyncza zmiana musi zaktualizować wiele plików — tak jak tutaj. Uruchom testy po łatce, ponieważ jedno błędne wywołanie może uszkodzić kilka plików.
Użyj read_file i write_file gdy każda edycja wymaga osobnej kontroli lub akceptacji. Zajmuje to więcej tur, ale zła edycja dotyczy jednego pliku naraz.
Pętla wizualnej naprawy usunęła wszystkie trzy błędy jedną łatką, ale przebieg nie był czystym sukcesem. Pytest przeszedł, podczas gdy Flask nadal serwował stary Python i wynik szablonu, więc agent nie mógł potwierdzić finalnej strony, dopóki nie zrestartowałem serwera.
Dodałbym narzędzie restart_server oraz porównanie pikseli przed testowaniem większej aplikacji. Zachowałbym granice plików i limit tur, a pytest i porównanie zrzutów traktował jako osobne sprawdzenia. Zdanie jednego nigdy nie powinno zastępować drugiego.
Ucz się AI z DataCamp!
course
course
Track