course
Arbeta med DeepSeek i Python
3 timmar
1.3K
DeepSeek tillhandahåller V4.1 Flash via API:et under modell-ID:t deepseek-flash. Den tar emot bildinmatning, stöder thinking- och non-thinking-lägen, har ett kontextfönster på 1M token och kan returnera upp till 384K token via Chat Completions och Responses API.
Vår översikt av DeepSeek V4.1 Flash täcker lansering, arkitektur och benchmarks.
DeepSeek beskriver V4.1 Flash som en 552B-parameters MoE-ryggrad, medan Hugging Face rapporterar 763B parametrar för den publicerade checkpointen. Skillnaden är till största delen det 196B-parameters Engram-villkorsminnet, plus visionskodaren och projektorn, alla komponenter som levereras i checkpointen men ligger utanför MoE-ryggraden.
Dess Causal Encoder-Decoder-design återanvänder cachelagrade encoder-tillstånd, med 8B aktiva parametrar per token under indatahantering och 16B under utdata.
V4.1 Flash är den första modellen i den nya V4.1-arkitekturfamiljen, med inbyggd bildförståelse. Visuella och textuella inbäddningar tränas gemensamt från början av förträningen, istället för att läggas till i efterhand som i den experimentella V4-Flash-Vision-Exp.
Responses API föregår V4.1 Flash; DeepSeek lade till inbyggt stöd under den tidigare V4-utrullningen. De utfasade modellnamnen deepseek-v4-flash och deepseek-v4-flash-vision-exp dirigeras nu till V4.1 Flash.
DeepSeeks prissättning baseras på högtrafiktimmar, med lågtrafikpriser satta till 50% av högtrafik. När jag körde agenten kostade cachelagrade indata $0,003 per miljon token under lågtrafik och $0,006 under högtrafik, icke-cachelagrade indata kostade $0,15 under lågtrafik och $0,30 under högtrafik, och utdata kostade $0,60 under lågtrafik och $1,20 under högtrafik, per DeepSeeks prissida.
Högtrafiktimmar är 01:00–04:00 och 06:00–10:00 UTC, måndag till fredag, exklusive kinesiska helgdagar. Alla andra timmar är lågtrafik, och kinesiska helgdagar är helt lågtrafik.
Nimbus Analytics Launch Metrics är en Flask-instrumentpanel för totala besökare, registreringar, konverteringsgrad, intäkter och dagliga registreringar. Jag placerade tre buggar över tre filer och berättade inte för agenten vad de var. Koden och den trasiga instrumentpanelen finns i detta GitHub-repo.
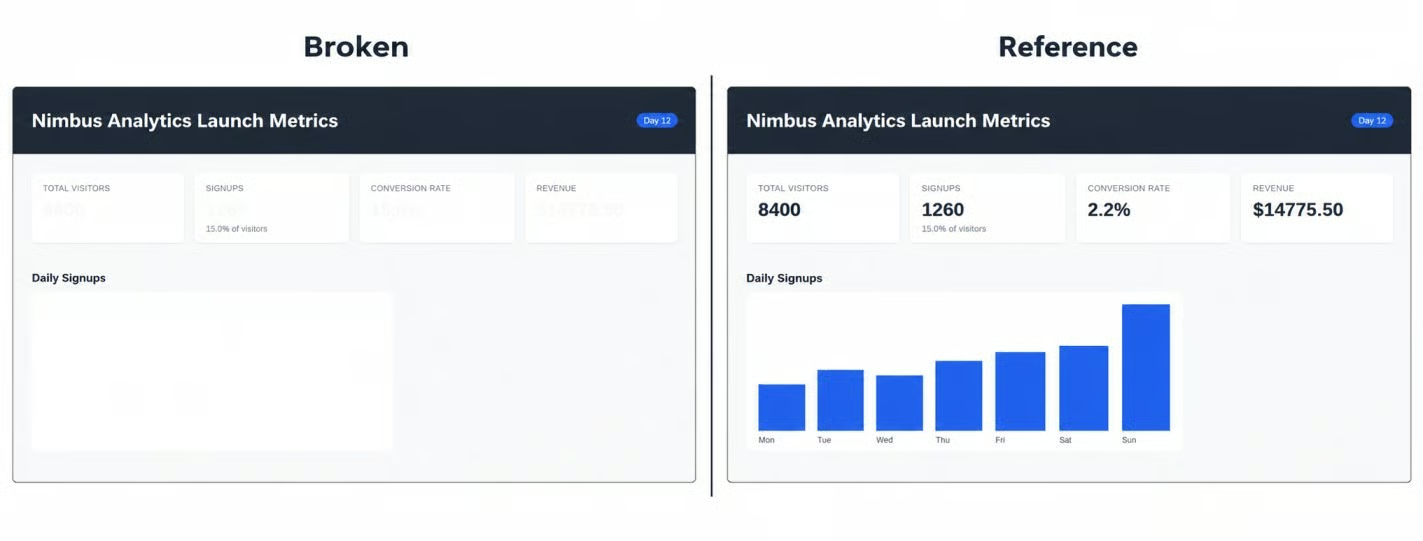
Trasig instrumentpanel bredvid referensdesignen. Bild av författaren.
De tre buggarna kräver olika bevis. En syns i skärmdumpen, en påverkar webbläsarbeteende och en fallerar i pytest. Agenten får ingen bugglista.
Innan jag lämnar över detta till agenten definierar jag vad ”fixad” betyder: pytest-sviten måste passera, och en färsk skärmdump måste visuellt matcha en referensbild. Modellens egen uppfattning räcker inte, så köraren kontrollerar båda bevisformerna.
Loopen växlar mellan en modellförfrågan och lokal verktygskörning. V4.1 Flash returnerar resonemang, ett meddelande eller verktygsanrop; Python kör de begärda verktygen och lägger till resultaten i historiken. Loopen stoppar när modellen svarar utan ytterligare verktygsanrop eller når gränsen på fjorton vändor.
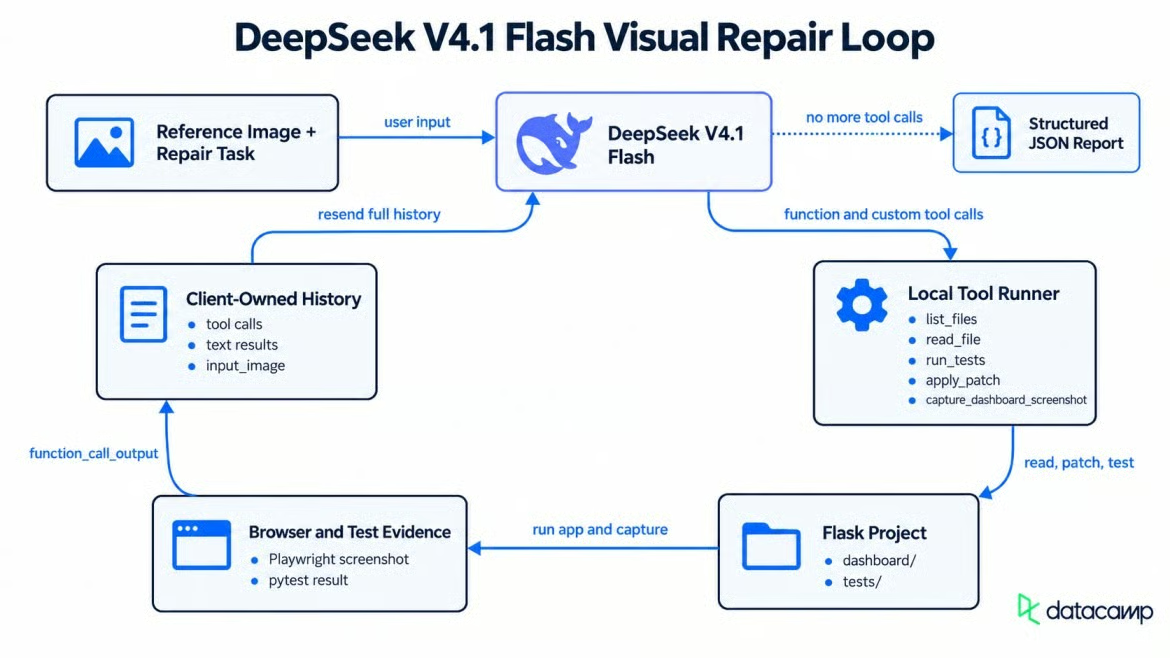
Reparationsloop som kopplar modell, verktyg och webbläsare. Bild av författaren.
Du behöver Python 3.10 eller nyare och en DeepSeek-API-nyckel med saldo. DeepSeeks API följer OpenAI:s förfrågningsformat, så detta projekt använder openai Python-paketet med base_url satt till DeepSeek.
Skapa en virtuell miljö och installera det projektet behöver.
python3 -m venv .venv
source .venv/bin/activate
pip install openai flask playwright pytest python-dotenv requests streamlit
playwright install chromium
Jag testade detta med openai 3.14.1, flask 3.1.3 och playwright 1.63.0. Spara nyckeln i en .env-fil i projektroten som DEEPSEEK_API_KEY=sk-... och ladda den med python-dotenv. Om din nyckel redan fungerar med Responses API kan du hoppa över nästa kodblock; annars kontrollerar förfrågan nyckeln och bas-URL:en.
from openai import OpenAI
import os
from dotenv import load_dotenv

load_dotenv()
client = OpenAI(api_key=os.environ["DEEPSEEK_API_KEY"], base_url="https://api.deepseek.com")

response = client.responses.create(model="deepseek-flash", input="Say hi in five words.")
print(response.output_text)
Om det skriver ut en kort hälsning fungerar nyckeln och bas-URL:en.
Agentens första inmatning innehåller en referensskärmdump, en kort uppgift och den direkta URL:en. Detta är den enda bilden som skickas i ett användarmeddelande. Alla senare skärmdumpar kommer från ett verktyg.
Köraren skickar referensbilden som en base64-data-URL med varje förfrågan. DeepSeek rekommenderar Files API när en bild återanvänds. Ett file_id undviker att samma bilddata skickas varje gång.
I den bifogade bilden frågade jag vad modellen skulle kontrollera först, men det fanns inga verktyg. Detta lät mig granska dess plan innan den kunde redigera något. Svaret föreslog att lista projektfiler, spåra CSS-variabler och ta en skärmdump; jag använde reasoning: {"effort": "high"}, DeepSeeks standardnivå för thinking.
Agenten får fyra funktionsverktyg och ett anpassat verktyg.
list_files och read_file inspekterar projektet, båda begränsade till dashboard/ och tests/.
run_tests kör pytest.
capture_dashboard_screenshot startar headless Chromium via Playwright.
Det anpassade verktyget är apply_patch, deklarerat som {"type": "custom", "name": "apply_patch"} och accepterat ”för Codex-kompatibilitet.” Alla andra anpassade verktygsnamn returnerar ett 400-fel, medan inbyggda typer som webbsökning och datoranvändning ignoreras tyst.
Funktionsargument anländer som JSON-text och kontrolleras innan Python kör dem. apply_patch anländer som indata till ett anpassat verktyg, så koden hanterar det separat och kontrollerar patchen innan filer skrivs. Verktygsfel returneras till modellen istället för att stoppa loopen.
När capture_dashboard_screenshot körs sparas inte resultatet på disk. Python returnerar det som en input_image-del inuti function_call_output. DeepSeek läser sedan skärmdumpen som en bild istället för en textbeskrivning.
history.append({
    "type": "function_call_output",
    "call_id": item.call_id,
    "output": [{"type": "input_image", "image_url": f"data:image/png;base64,{png_b64}"}],
})
Agenten kan patcha CSS:en, ta en ny skärmdump och kontrollera om siffrorna är läsbara.
Historiken finns i en Python-lista eftersom API:et inte stöder previous_response_id eller serversideskonversationer. Thinking-läget kräver också varje resonemangspost från tidigare verktygsvändor.
Viktigt: Om verktygsutdata infogas mellan två anrop från samma vända returnerar nästa förfrågan ett 400-fel. Lägg till varje post från response.output i ordning, kör sedan verktygen och lägg till deras resultat.
Köraren begränsar agenten till fjorton vändor och katalogerna dashboard/ och tests/. Den ger ingen shell-åtkomst, kontrollerar verktygsargument och använder pytest för verifiering.
Ja, via Responses API accepterar DeepSeek V4.1 Flash ett JSON Schema genom text.format. Chat Completions response_format stöder JSON-läge men inte scheman. När loopen stannar registrerar den sista förfrågan buggar, fixar, testresultat, skärmdumpsresultat och verifieringsmetod.
Projektet inkluderar också en Streamlit-app i app_streamlit.py. Samma agent körs som en generator med stream=True, så sidan visar resonemangstext och verktygsanrop allteftersom de anländer. Sidopanelen ändrar resonemangsansträngning och bilddetalj.
Streamlit-gränssnittet strömmar agentkörningen. Video av författaren.
Körningen såg färdig ut efter en patch, men den live-sidan höll inte med.
Agenten använde sina två första vändor för att titta innan den rörde något: vända ett listade filerna och tog en baslinjeskärmdump, vända två läste app.py, index.html, style.css och testfilen.
Vända tre körde pytest, och vända fyra applicerade en patch som korrigerade konverteringsformeln, ändrade metrikkulören och matchade JavaScript-uppslagningen mot canvas-ID:t.
-    conversion_rate = data["conversions"] / data["signups"] * 100
+    conversion_rate = data["conversions"] / data["total_visitors"] * 100
Att köra testerna på vända fem visade att alla fem passerade. Det var här körningen slutade vara prydlig. Varje ny skärmdump visade fortfarande 15% konverteringsgrad och ett tomt diagram.
Agenten bekräftade att filerna på disk innehöll fixarna, försökte skärmdumpen igen och undersökte om servern laddade de ändrade Python- och mallfilerna. Två tillfälliga färskhetskontroller dök inte heller upp på live-sidan.
Vid fjorton vändor hade loopen nått sin budget och identifierat orsaken: run_tests kontrollerar kod på disk, medan skärmdumpen kontrollerar en körande process med inaktuellt tillstånd. Flask startades med debug=False, så ingen omstartare laddade den ändrade Python-modulen, och automatisk mall-omladdning var inte aktiverad.
CSS-ändringen syntes medan det Python-härledda värdet och mallstödda diagrammet förblev inaktuella. Pytest importerade app.py från disk, så gröna tester garanterade inte en färsk sida.
Efter att jag startade om Flask matchade instrumentpanelen referensbilden. Den saknade biten var ett restart_server-verktyg, inte ytterligare en kodpatch.
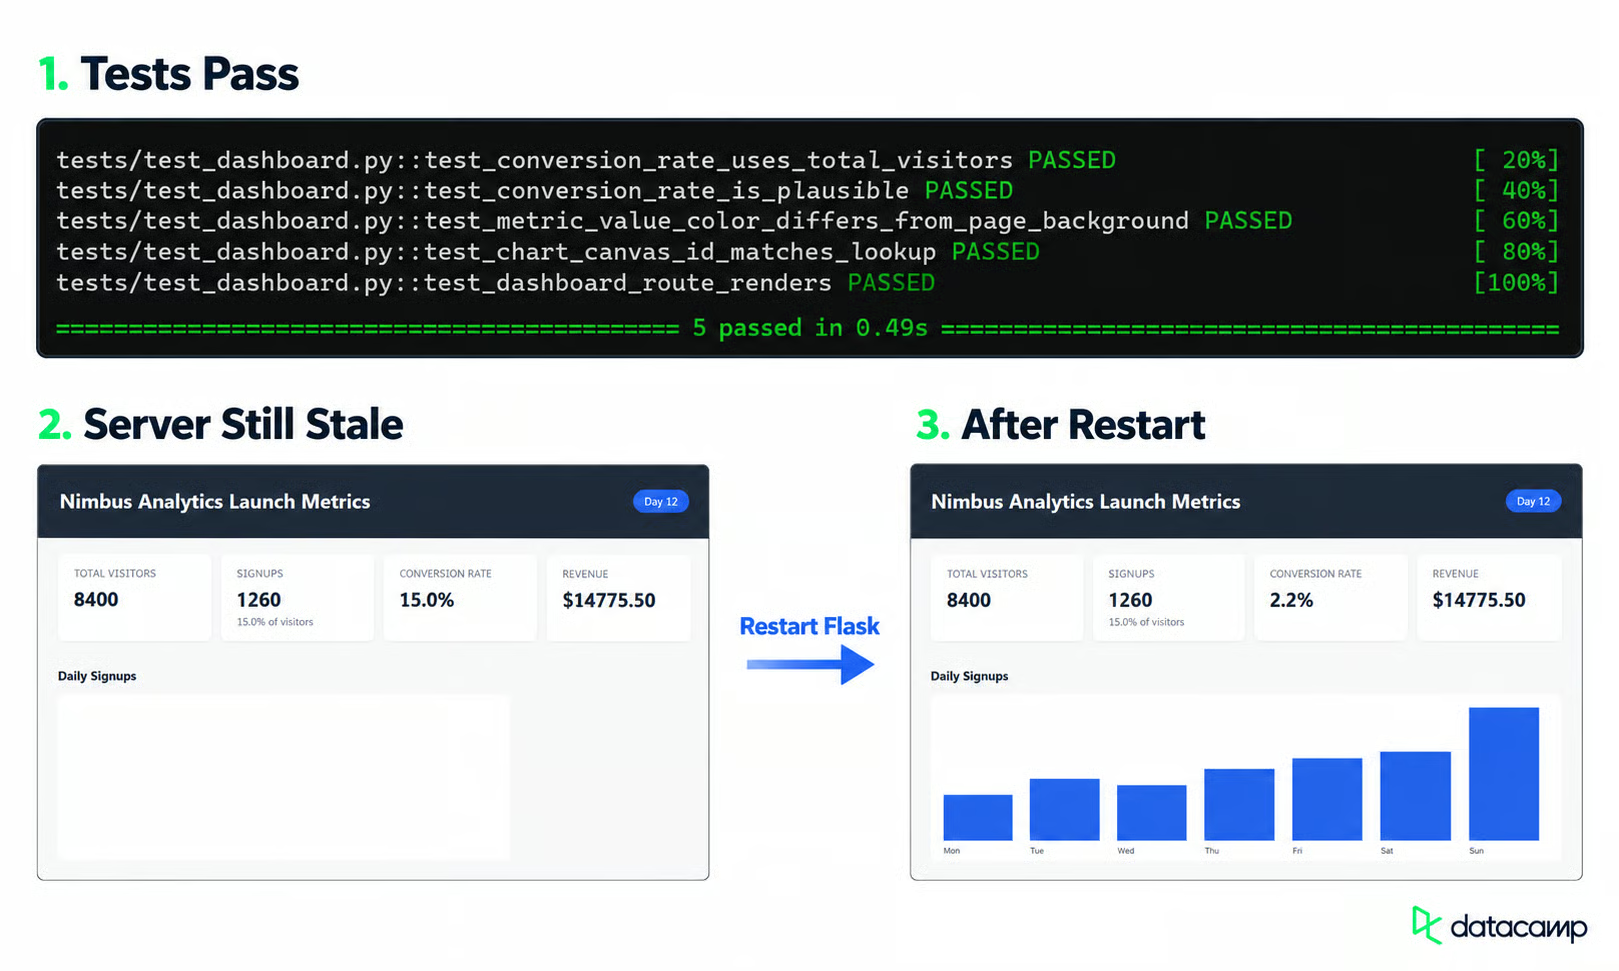
Omstart gör patchade instrumentpanelsändringar synliga. Bild av författaren.
Ja, agenten fixade instrumentpanelen på disk. Den ändrade bara de tre felaktiga filerna, och pytest gick från fyra fel till fem godkända tester. Live-sidan visade alla fixar efter att Flask startats om.
Eftersom agenten skickar om sin historik upprepar senare förfrågningar mycket av indata från tidigare vändor. DeepSeek kontrollerar detta upprepade prefix mot sin automatiska cache. Cachen fungerar enligt bästa förmåga, så dessa siffror gäller bara denna körning.
Över fjorton reparationsvändor och den slutliga JSON-rapportförfrågan rapporterade API:et 156 724 indatatoken, varav 137 088 cachelagrade token, en träffgrad på 87%. Utdata uppgick till 11 497 token, inklusive 9 362 resonemangstoken. Körningen skedde under lågtrafik, så alla femton förfrågningar kostade ungefär $0,0103.
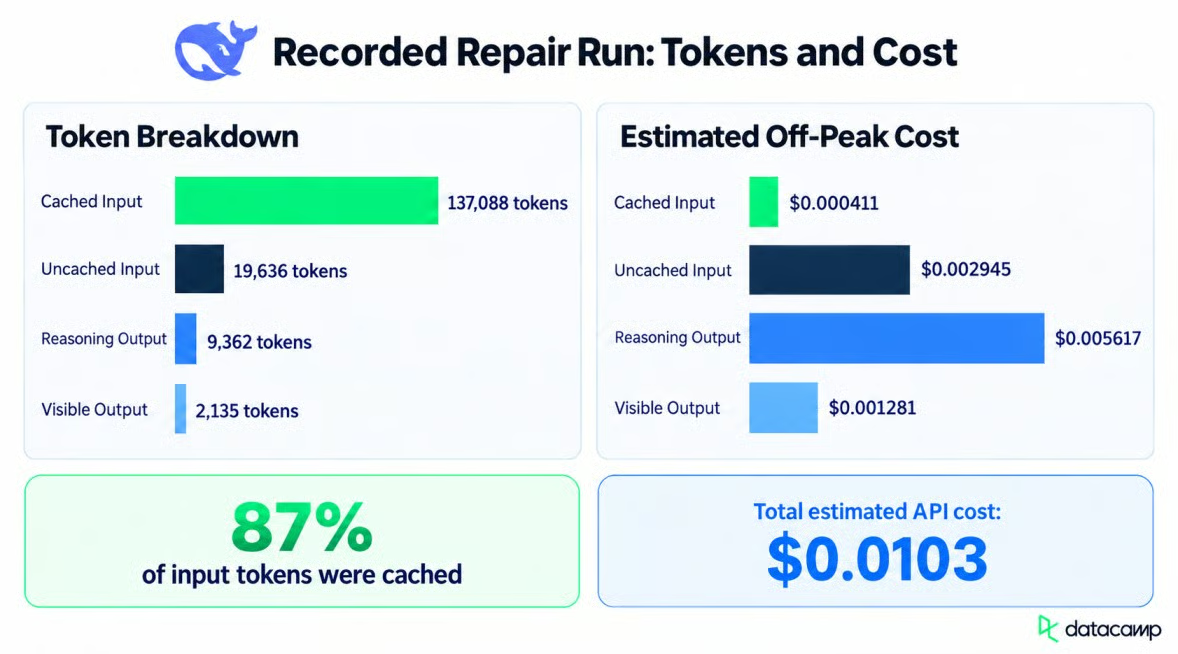
Resonemangsutdata är den största kostnadskategorin. Bild av författaren.
En större kodbas, fler skärmdumpar eller färre cacheträffar skulle ändra både antal token och kostnad.
Tre API-begränsningar är viktiga innan denna körning växer bortom demon.
Bakgrundssvar stöds inte, så långa vändor blockerar tills de är klara.
parallel_tool_calls och max_tool_calls ignoreras; parallella verktygsanrop förblir aktiverade.
Automatisk trunkering stöds inte, så förfrågningar som överskrider kontextgränsen returnerar ett 400-fel.
Innan du använder detta mönster i en live-tjänst, placera kontrollerna i applikationskoden snarare än i modellinstruktionerna.
Använd apply_patch när en enda ändring måste uppdatera flera filer, som här. Kör tester efter patchen, eftersom ett enda dåligt anrop kan skada flera filer.
Använd read_file och write_file när varje redigering behöver en separat kontroll eller godkännande. De tar fler vändor, men en dålig ändring påverkar en fil i taget.
Den visuella reparationsloopen fixade alla tre buggar i en patch, men körningen var inte en ren framgång. Pytest passerade medan Flask fortfarande serverade gammal Python- och mallutdata, så agenten kunde inte bekräfta den slutliga sidan förrän jag startade om servern.
Jag skulle lägga till ett restart_server -verktyg och en pixeljämförelse innan jag testar en större app. Jag skulle behålla filgränsen och vändogränsen och sedan behandla pytest och skärmdumpsjämförelsen som separata kontroller. Att klara den ena ska aldrig ersätta att klara den andra.
Lär dig AI med DataCamp!
course
course
track