Что такое Grok 4.6?
Grok 4.6 — это проприетарная модель рассуждений SpaceXAI. API и Cursor не раскрывают одинаковый лимит контекста, и повышенная ставка для длинного контекста включается задолго до предела API. Таблица сопоставляет эти ограничения с типами ввода, инструментами и датой отсечки знаний.
|
Характеристика |
Grok 4.6 |
|
500 000 токенов (API); 256 000 токенов в Cursor | |
|
Ввод / вывод |
Текст и изображения на вход; текст на выход |
|
Усилия на рассуждение |
Low, medium, high (по умолчанию), xhigh |
|
Дата отсечки знаний |
1 февраля 2026 года |
|
Инструменты |
Вызов функций, веб-поиск, X-поиск, выполнение кода, поиск по коллекциям (RAG), удалённый MCP |
|
Стандартные цены |
$2 / миллион входных токенов, $0.50 — кэшированные, $6 / миллион выходных |
|
Цены для длинного контекста |
$4 / $1 / $12 при достижении подсказкой 200 000 токенов, применяется ко всему запросу |
SpaceXAI по-прежнему не публикует число параметров ни для одной модели. Указанная в некоторых отчётах цифра 1,5 триллиона не исходила от SpaceXAI, поэтому это не подтверждённая спецификация.
Что нового в Grok 4.6?
По словам SpaceXAI, это не новая модель, обученная с нуля. Вместо этого Grok 4.5 прошёл дополнительное обучение с повышенным вниманием к задачам ИИ-агентов. Заявленные изменения касаются более длительных прогонов агентов, визуальных сборок и пост-обучения.
Более длительные агентные задачи
SpaceXAI утверждает, что Grok 4.6 лучше держит линию при длительных задачах из нескольких шагов, таких как исследования, работа с кодовой базой и создание приложения. По сообщениям, модель чаще проверяет свою работу вместо попытки сделать всё за один проход.
Это соответствует более широкой смене подходов к тестированию моделей. Хороший первый ответ значит меньше, если модель забывает ранние решения после нескольких вызовов инструментов. Внутренние тесты GitHub также показали, что Grok 4.6 продолжал рассуждать и использовать инструменты в более длинных задачах.
В API есть функции, связанные с этим заявлением. Grok 4.6 умеет стримить сводки рассуждений, чего Grok 4.5 не раскрывает, а xAI рекомендует сжатие контекста с постоянным prompt_cache_key для длинных агентных циклов. Сжатие сводит более раннюю историю к одному элементу, но всё же использует токены, и запрос должен уместиться в окно контекста до запуска сжатия.
Визуальная и интерактивная веб-разработка
SpaceXAI и Cursor сообщают о более удачных первых попытках в визуальных проектах. В одном внешнем тесте Grok 4.6 воссоздал старую продуктовую страницу iPod Mini как 3D‑сайт с рабочим цветоведом и скролл-анимацией. Демонстрация сработала, но один тест не доказывает общий тезис.
Как проводилось пост-обучение Grok 4.6
Если вас интересуют только бенчмарки и цены, пропустите этот подраздел. Здесь объясняется версия SpaceXAI о том, откуда взялся прирост.
SpaceXAI провела больше обучения, чем для Grok 4.5. Использовались сгенерированные ИИ примеры рассуждений и инженерные примеры, слабые примеры удалялись модельными проверками, а затем применялось обучение с подкреплением для кодирования, офисных задач, веб-разработки, настройки ядра и проектирования компьютеров. По словам SpaceXAI, Grok 4.5 также создавал новые обучающие примеры при разных настройках рассуждений и по разным темам. Компания относит прирост к большему объёму обучения и более строгому отбору данных, а не к новой архитектуре.
Внешние команды не могут проверить эти детали, и SpaceXAI не поделилась достаточной информацией для повторения обучения. Это версия компании о произошедших изменениях, а не результат, подтверждённый извне.
Бенчмарки Grok 4.6: официальные и независимые результаты
Таблица запуска SpaceXAI показывает, где выросли баллы, но баллы конкурентов — это «лучшие из саморепортных или общедоступных результатов». Одна команда не прогоняла все модели в одинаковых условиях. Ниже включён уровень усилий, так как он влияет на итог.
|
Бенчмарк |
Grok 4.6 (high) |
Grok 4.5 (high) |
GPT-5.6 Sol (max) |
Claude Fable 5 (max) |
|---|---|---|---|---|
|
AA Intelligence Index |
61 |
56 |
61 |
62 |
|
GDPVal-AA v2 (Elo) |
1 753 |
1 526 |
1 728 |
1 741 |
|
DeepSWE 1.1 |
65,9% |
54,0% |
73,0% |
70,0% |
|
Terminal-Bench 3.0 |
26,0% |
15,7% |
34,6% |
34,1% |
|
APEX-Agents |
57,5% |
47,1% |
56,7% |
59,2% |
|
CursorBench v3.2 |
69,9% |
66,7% |
67,2% |
70,5% |
Grok 4.6 улучшает результаты по сравнению с Grok 4.5 во всей таблице. Наибольшие разрывы с Sol видны в DeepSWE и Terminal-Bench, тогда как Fable лидирует в 3 строках. Даже таблица самой SpaceXAI не указывает на одного победителя.
Независимые результаты бенчмарков
Artificial Analysis запустила свой Intelligence Index для шести моделей в этом сравнении. Её результаты близки к цифрам SpaceXAI, но не идентичны.
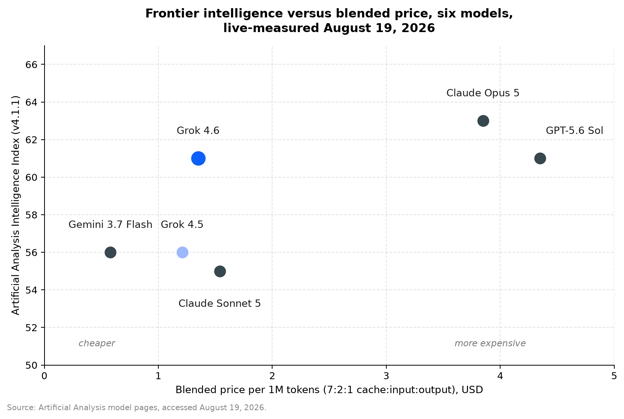
Grok 4.6 против пяти передовых конкурентов. Изображение автора.
Диаграмма показывает равенство Grok с Sol по интеллекта, но значительно ниже по смешанной цене. Artificial Analysis рассчитывает цену при соотношении 7:2:1 для кэшированного ввода, некэшированного ввода и вывода. Стоимость завершённой индексной задачи демонстрирует ту же разницу: $0,84 для Grok, $1,23 для Sol и $2,34 для Opus 5.
Время до первого токена ответа увеличилось с 14,62 секунды у Grok 4.5 до 40,44 секунды, а стоимость задачи выросла с $0,36 до $0,84. Grok 4.6 использовал примерно на 20% больше выходных токенов на тех же тестах, поэтому неизменная прайсовая цена не означает неизменную стоимость задачи. Стоимость завершённой задачи даёт более точную картину, чем одни прайс-карточки API, поскольку учитывает дополнительное рассуждение, необходимое для выполнения работы.
В сравнении с GPT-5.6 Sol и Claude Sonnet 5 Grok 4.6 отправляет первый токен ответа раньше. Sol на максимальных усилиях тратит 213,52 секунды, а Sonnet 5 — 184,48, против 40,44 у Grok. Grok выглядит медленным только рядом с моделями с низкой задержкой, такими как Gemini 3.7 Flash.
Насколько надёжны эти сравнения бенчмарков?
Они полезны для выявления относительных сильных сторон, но не для надёжного кросс-модельного рейтинга. Уровень усилий меняет баллы и время ответа: GPT-5.6 Sol набрал 57 на high и 61 на max. Названия бенчмарков также могут относиться к разным версиям, поэтому Terminal-Bench 3.0 у xAI и Terminal-Bench 2.1 у Artificial Analysis не сопоставимы.
Что изменилось по сравнению с Grok 4.5?
Для пользователей Grok 4.5 вопрос не в том, «лучше» ли 4.6 в абстракции. Важно, компенсирует ли более высокий балл иную задержку и профиль использования токенов. Таблица сводит изменения к одной базе сравнения.
|
Метрика |
Grok 4.5 (high) |
Grok 4.6 (high) |
|
AA Intelligence Index |
56 |
61 |
|
Стоимость индексной задачи |
$0,36 |
$0,84 |
|
Время до первого токена ответа |
14,62 с |
40,44 с |
|
Цена кэшированного ввода |
$0,30 / М |
$0,50 / М |
|
Выходные токены, использованные для прогона индекса |
60 М |
72 М |
|
Базовая цена ввода / вывода |
$2 / $6 |
$2 / $6 (без изменений) |
Однако «та же цена» описывает только базовую прайсовую ставку. Ещё одно важное изменение для существующих пользователей Grok 4.5: кэшированный ввод вырос на 67% — с $0,30 до $0,50 за миллион токенов. Эта более высокая ставка кэша увеличивает разрыв между прайс-картой и стоимостью завершённой задачи.
Grok 4.6 против конкурентов
Разобрав сравнение с предшественником, посмотрим, как Grok 4.6 соотносится с другими передовыми моделями от OpenAI и Anthropic.
Grok 4.6 vs GPT-5.6 Sol
Ничья в индексе скрывает явный раскол. Sol обходит Grok на 7,1 пункта в DeepSWE и на 8,6 пункта в Terminal-Bench, что делает терминалозависимое кодирование его сильнейшим кейсом. Grok выше по остальным трём строкам задач.
Собственные тесты OpenAI расширяют этот терминальный результат на веб-браузинг и работу за компьютером. Это остаются доказательства, отобранные вендором, а не контролируемое сравнение, но они указывают в том же направлении: сильнейший кейс Sol — работа, зависящая от терминала, браузера или повторяющихся вызовов инструментов.
Coгласно OpenAI, представлен режим Ultrafast для Sol, который, как заявлено, работает до 14 раз быстрее. Цена не опубликована, поэтому в сравнении стоимости он не учитывается.
Grok 4.6 стартует с $2 за вход и $6 за выход на миллион токенов. Стандартная ставка Sol — $5 за вход и $30 за выход, то есть в пять раз дороже по выходу, чем у Grok. Выше 272 000 токенов Sol удваивает цену за вход и повышает выход до $45.
Это не делает каждую задачу Grok в пять раз дешевле. Использование токенов рассуждений, доля попаданий в кэш и число ходов всё равно меняют итоговый счёт. Преимущество Grok по цене наиболее очевидно, когда расход токенов предсказуем. Для терминалозависимой работы более высокие баллы Sol в бенчмарках могут значить больше, чем разрыв в прайсовых ценах.
Grok 4.6 vs. Claude Sonnet 5
Sonnet 5 и Grok 4.6 оба стартуют с $2 за миллион входных токенов, что упрощает сравнение цен. Sonnet 5 имеет окно контекста в 1 миллион токенов по умолчанию, вдвое больше, чем 500 000 у Grok, без повышенной ставки за длинные подсказки. Выход стоит $10 за миллион против $6 у Grok.
За два дня до запуска Grok 4.6 Anthropic сделала цены $2/$10 постоянными и отказалась от планируемого повышения до $3/$15. Это важно при сравнении со старой ценовой таблицей, в том числе нашей.
По индексу Artificial Analysis Sonnet 5 набирает 55 на максимальных усилиях, на шесть пунктов ниже Grok 4.6. Для тестов он использовал 300 миллионов выходных токенов против 72 миллионов у Grok, что даёт стоимость задачи $1,72. Его токенизатор порождает примерно на 30% больше токенов, чем Sonnet 4.6, для одного и того же текста. Это усложняет сравнение цен между этими двумя версиями Sonnet. И Sonnet 5 — не топовая модель Anthropic.
Grok 4.6 vs Claude Opus 5 и Fable 5
Opus 5 при $5 за вход и $25 за выход возглавляет индекс с 63. Fable 5 при $10 за вход и $50 за выход набирает 62. Балл Fable в индексе тоже нуждается в ремарке. Artificial Analysis зафиксировала защитные откаты на некоторых более сложных подсказках, так что балл отражает модель в том виде, как её могут использовать люди, а не неограниченную версию, которую Anthropic не предлагает.
В бенчмарке AA-Briefcase от Artificial Analysis для длинных агентных задач Grok 4.6 завершал за ~53 хода и использовал 0,5 млрд входных токенов. Opus 5 требовалось ~103 хода и 2 млрд токенов. Это не доказывает, что Grok сильнее в целом. Это показывает, что Grok использовал меньше шагов и входных токенов на этом наборе тестов, тогда как Claude лидировал в других тестах выше.
Цены на Grok 4.6
Порог подсказки в 200 000 токенов — то, за чем я бы следил: он переводит каждый токен в запросе в более высокий тариф. Таблица также включает приоритет и плату за инструменты.
|
Позиция |
Ставка |
|
Входные токены, при подсказке до 200K |
$2,00 / миллион |
|
Кэшированный ввод, при подсказке до 200K |
$0,50 / миллион |
|
Выходные токены, при подсказке до 200K |
$6,00 / миллион |
|
Ввод / кэш / вывод (при подсказке свыше 200K) |
$4,00 / $1,00 / $12,00 |
|
Быстрая или приоритетная обработка |
2× стандартной ставки |
|
Веб-поиск, X-поиск, выполнение кода |
$5 за 1 000 вызовов |
Плата за инструменты взимается отдельно от платы за токены. Запрос, который ищет в Интернете, а затем запускает код, может понести обе инструментальные комиссии до тарификации итогового текста. Отдельного имени модели grok-4.6-fast нет. В прямом API есть опция приоритета, биллинг по 2× при подтверждении приоритета в ответе. В Cursor отображается отдельный вариант «Grok 4.6 (Fast)» по той же ставке 2×.
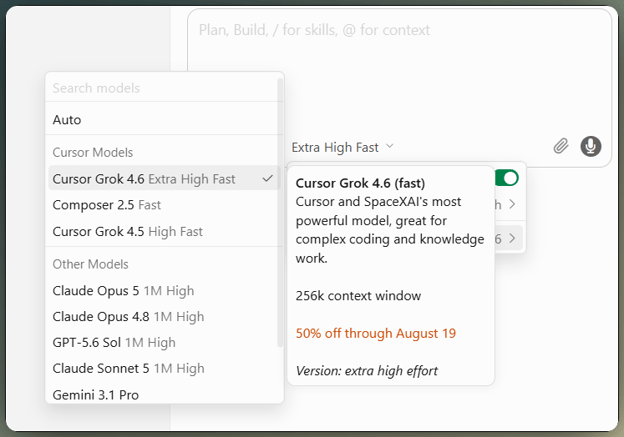
Grok 4.6 Fast, выбранный в Cursor. Изображение автора.
Как получить доступ к Grok 4.6?
Grok 4.6 доступен напрямую у провайдера через:
- API SpaceXAI
- Cursor
- Grok Build
- Сторонние шлюзы (OpenRouter, Vercel, Cloudflare, Google Cloud Vertex AI)
- Другие инструменты для кодинга (GitHub Copilot, VS Code, JetBrains, Xcode и Eclipse)
Развёртывание охватывает планы Pro, Pro+, Max, Business и Enterprise. Администраторам Business и Enterprise нужно включить модель, так как по умолчанию она выключена. Grok 4.6 не поддерживается в Batch API SpaceXAI, поэтому льготного пакетного тарифа нет.
Один корпоративный нюанс находится вне рамок доступности модели. Ответы по умолчанию состояние-сохраняющие, и SpaceXAI заявляет, что история хранится 30 дней. В рамках Zero Data Retention команды не могут использовать сохранённые цепочки ответов или отложенные завершения; xAI указывает на зашифрованный повтор рассуждений и WebSocket Responses. Каждый ответ содержит заголовок, показывающий, был ли активен ZDR.
Неделя запуска Grok 4.6: модели, Copilot и Cursor
Что мне запомнилось на той неделе — насколько быстро запуски моделей и партнёрские соглашения по дистрибуции сгруппировались вокруг Grok 4.6.
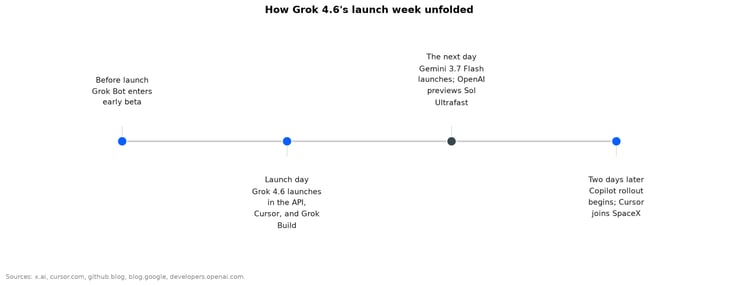
Неделя запуска Grok 4.6 — не только бенчмарки. Изображение автора.
Grok Bot задал тон перед запуском модели. Ранний бета-агент в облаке предлагался в составе SuperGrok Heavy за $300 в месяц или Cursor Ultra за $200 в месяц, а не продавался отдельно, увязывая доступ с премиальными планами. Grok 4.6 затем перенёс тот же агентный фокус в API, Cursor и Grok Build.
Запуск Gemini 3.7 Flash от Google и превью Ultrafast для GPT-5.6 Sol от OpenAI сделали неделю ещё насыщеннее. Параллельно развёртывание Copilot и присоединение Cursor к SpaceX расширили дистрибуцию Grok. Cursor связал процесс с партнёрством со SpaceXAI ранее в том году и объяснил шаг доступом к GPU SpaceX, а не баллами моделей. В их публикации говорится, что это поможет строить модели по более низкой стоимости.
Мой взгляд на ту неделю: SpaceXAI хочет, чтобы Grok был внутри тех инструментов, которыми люди уже пользуются. Grok 4.5 был совместно обучен с Cursor, а Grok 4.6 почти сразу появился в Copilot. Это делает партнёрскую дистрибуцию частью релиза, а не довеском.
Когда стоит использовать Grok 4.6?
Grok 4.6 подходит для работы, где цена API и длинные агентные задачи важнее задержки первого токена. Он хуже подходит там, где более высокие терминальные баллы Sol или большее окно контекста Sonnet 5 лучше соответствуют задаче.
Grok 4.6 уместен, когда:
- Цена API — ключевое ограничение. Он дешевле Sol, Opus 5 и Fable 5 по прайсу и по стоимости задачи
- Работа идёт как длинные, многошаговые агентные задачи, где окупается эффективность по ходам (меньше ходов и входных токенов, чем у Opus 5 на AA-Briefcase)
- Задача — интеллектуальный труд или юридические рассуждения, где он лидирует в таблице бенчмарков
- Задержка первого токена не критична. Медленный старт теряется на длинном прогоне, но бросается в глаза в интерактивном чате
Могут быть более удачные альтернативы, когда:
- Работа — терминалозависимое кодирование → GPT-5.6 Sol (выше баллы в DeepSWE и Terminal-Bench)
- Задаче нужен большой контекст → Claude Sonnet 5 (контекст 1M, без надбавки за длинные подсказки)
- Нужна минимальная задержка для интерактива → Gemini 3.7 Flash
- Вы покупаете исключительно «верхний предел интеллекта» → Opus 5 (63) или Fable 5 (62) лидируют в индексе
Итоги по Grok 4.6
Grok 4.6 приземляется в неловкой «середине». Он прибавляет пять пунктов индекса и остаётся ниже Sol и Opus 5 по заявленным ценам, но стартует медленнее и стоит дороже за измерённую задачу, чем Grok 4.5. Формула «та же цена, модель лучше» упускает половину релиза.
Чего мне всё ещё не хватает, — это многочасового прогона, где кодовая база, инструменты и инструкции постоянно меняются. Cursor и GitHub Copilot теперь дают такую среду. Если там низкими останутся доли исправлений и сбоев, у заявления про обучение агентов будет подтверждение вне фиксированного теста; если нет — прибавка в пять пунктов останется просто прибавкой.
Для читателей, интегрирующихся с API xAI, наш туториал по Grok 4 API охватывает Python‑клиент и порядок запроса.
Grok 4.6: часто задаваемые вопросы
Заменяет ли Grok 4.6 Grok 4.5?
Официально — нет. SpaceXAI не объявляла дату вывода Grok 4.5, и он всё ещё указан и в API, и в Cursor. Принудительного перехода на 4.6 пока нет.
Могу ли я развернуть Grok 4.6 у себя?
Нет. Как отмечалось выше, открытых весов и опубликованного числа параметров нет, так что нечего скачать и запустить на своём железе. Любой способ доступа, включая прямой API, проходит через инфраструктуру SpaceXAI или партнёра-реселлера.
Как GitHub Copilot тарифицирует Grok 4.6?
Copilot конвертирует использование Grok 4.6 в GitHub AI Credits по прайсовой цене провайдера, где один цент равен одному кредиту. Обычные автодополнения кода и предложения следующего редактирования не тарифицируются в AI Credits. Использование модели в чате или агентных задачах следует правилам расходования Copilot.
Доступен ли Grok 4.6 в ЕС?
Да, но обработка — в США. Пользователи из ЕС могут получить доступ к Grok 4.6 (общая база Grok 4.5 прошла соответствие AI Act ЕС и открылась для пользователей ЕС в июле, а 4.6 доступен в Cursor по всему ЕС), однако резидентности данных в ЕС нет. На странице модели xAI указаны только us-east-1 и us-west-2, значит запросы выполняются в США. Уточняйте по каждому каналу (консоль API, Cursor, шлюзы) перед тем как на это рассчитывать.
Работает ли Grok 4.6 с резидентностью данных США в Cursor?
Grok 4.6 уже доступен в Cursor (у него есть своя страница модели), но резидентность данных только в США — это функция Enterprise, которая охватывает поддерживаемые модели с рядом исключений. Поэтому перед тем как на неё полагаться, убедитесь, что 4.6 есть в актуальном списке поддерживаемых моделей Cursor.
Большинство читателей по‑прежнему знают лабораторию, стоящую за Grok, как xAI. SpaceXAI выпустила Grok 4.6 12 августа 2026 года, чуть более чем через месяц после Grok 4.5, с упором на программирование, визуальную веб-разработку и агентные задачи с длительным выполнением.
Данные запуска не дают однозначного рейтинга. Grok лидирует в части выбранных SpaceXAI тестов, тогда как GPT-5.6 Sol и Claude Fable 5 лидируют в других. Artificial Analysis ставит Grok рядом с Sol при более низкой смешанной цене, но обновление также начинает отвечать позже и стоит дороже за измерённую задачу, чем Grok 4.5.
В этой статье мы прослеживаем этот обмен через спецификации модели, цены, доступ и прямые сравнения с Sol и Claude. Наш обзор Grok 4.5 был сосредоточен на низком расходе токенов. Здесь вопрос в том, меняется ли итоговый счёт при учёте кэшированного ввода, токенов рассуждений и дополнительного вывода.
Коротко: Grok 4.6
Мой краткий вывод: прибавка в пять пунктов сама по себе значит меньше, чем следует из страницы запуска. На выбор модели больше влияют ценовое поведение и тип задач.
На уровне усилий
highGrok 4.6 набирает 61 по индексу Artificial Analysis Intelligence, что численно равно Sol наmaxи на два пункта ниже Opus 5 наmax.Базовые ставки ввода и вывода остаются $2 и $6 за миллион токенов, но кэшированный ввод, задержка первого токена и стоимость измерённой задачи выросли по сравнению с Grok 4.5.
В AA-Briefcase Grok использовал меньше ходов и входных токенов, чем Opus 5; Sol лидирует в терминальных тестах, а Sonnet 5 предлагает вдвое больший контекст без надбавки за длинные подсказки.
В сравнениях ниже заявления провайдеров отделены от результатов Artificial Analysis. Это важно, поскольку положение модели может меняться в зависимости от уровня усилий и настроек теста.