Anthropic เปิดตัว Claude Fable 5.2 เมื่อต้นเดือนพฤศจิกายนในฐานะแฟลกชิปรุ่นใหม่ เมื่อวันที่ 17 พฤศจิกายน 2026 OpenAI ตอบด้วย GPT-6.2 Astra รุ่นแนวหน้าตัวใหม่ และชาร์ตเปิดตัวยังวาง Fable 5.2 เทียบกับ Astra บนเบนช์มาร์กส่วนใหญ่
ปัจจุบันทั้งสองรุ่นตั้งราคาต่อโทเคนเท่ากันพอดี บนกระดาษจึงเป็นการวัดศักยภาพล้วน ๆ แต่ในทางปฏิบัติ บิลสะท้อนอีกเรื่องหนึ่ง และการทดสอบแบบลงมือทำของเราก็เช่นกัน
เพื่ออัปเดตความเคลื่อนไหวด้าน AI และข้อมูล แนะนำให้สมัครจดหมายข่าวรายสัปดาห์ของเรา The Median.
สรุปสั้น ๆ
- ไม่มีรุ่นไหนชนะขาด: GPT-6.2 Astra เด่นงานมืออาชีพและงานวิเคราะห์ ส่วน Claude Fable 5.2 เด่นเอเจนต์เขียนโค้ด
- ราคาต่อโทเคนเท่ากัน แต่ Astra ใช้โทเคนน้อยกว่ามาก จึงถูกกว่ามากต่อภารกิจ
- ในวิดีโอทดสอบแบบปิดตา คะแนนคุณภาพสูสีมาก แต่ Fable พูดซ้ำข้อมูลที่ล้าสมัยในทุกวิดีโอ
- เลือก Fable สำหรับเอเจนต์เขียนโค้ด การใช้คอมพิวเตอร์ และการดีพลอยบน Bedrock, Vertex AI หรือ Azure
- เลือก Astra สำหรับเอกสาร งานกฎหมายและการเงิน และงานปริมาณมาก
GPT-6.2 Astra คืออะไร?
GPT-6.2 Astra คือรุ่นแนวหน้าของ OpenAI เปิดตัวในเดือนพฤศจิกายน 2026 เป็นระดับสูงสุดของตระกูล GPT-6.2 เหนือ GPT-6.2 Sol
จุดขายคือผลลัพธ์ระดับมืออาชีพที่ต้นทุนต่อภารกิจต่ำลง: สไลด์ เวิร์กบุ๊ก และเอกสารที่ตามเทมเพลตของผู้ใช้ พร้อมการใช้คอมพิวเตอร์ในเครื่องมือ CAD และซิมูเลชัน
โพสต์เปิดตัวของ OpenAI ครอบคลุมรายละเอียด และ บทเรียน API ของ GPT-6 Astra ของเราแสดงวิธีพัฒนาด้วยเจเนอเรชันก่อนหน้า
Claude Fable 5.2 คืออะไร?
Claude Fable 5.2 คือรุ่นแฟลกชิปของ Anthropic เปิดตัวในเดือนพฤศจิกายน 2026 ควบคู่กับ Claude Mythos 5.2 ซึ่งเป็นเวอร์ชันสำหรับองค์กรที่ผ่านการตรวจสอบด้านความปลอดภัยไซเบอร์และชีวเวช
Anthropic วางตำแหน่งสำหรับงานเทคนิคระยะยาว: เอเจนต์เขียนโค้ด การใช้คอมพิวเตอร์ และงานวิจัย พร้อมโหมดเร็วทางเลือกที่สร้างโทเคนได้เร็วขึ้นถึง 2.5 เท่า
คู่มือ Fable 5.2 ของเราครอบคลุมการเปิดตัว และ บทเรียน API ของ Fable 5.2 พาเดินสร้างเอเจนต์ทดสอบสมมติฐาน
GPT-6.2 Astra vs Claude Fable 5.2: เปรียบเทียบตัวต่อตัว
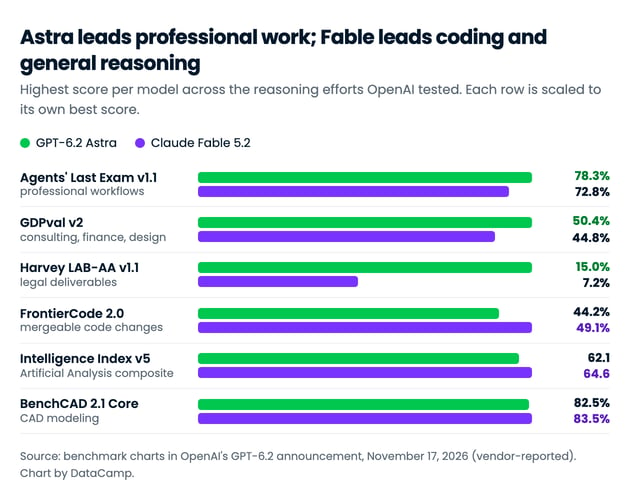
ภาพรวมศักยภาพเป็นการแบ่งแต้ม และช่องว่างเบนช์มาร์กส่วนใหญ่ต่างกันไม่กี่คะแนน ช่องว่างด้านต้นทุนไม่ใช่แบบนั้น: ราคาต่อโทเคนเท่ากัน แต่ Fable ต้องใช้โทเคนมากกว่ามากเพื่อจบภารกิจเดียวกัน
| คุณสมบัติ | GPT-6.2 Astra | Claude Fable 5.2 |
|---|
| ผู้พัฒนา | OpenAI | Anthropic |
| ราคาโทเคน | เท่ากับ Fable | เท่ากับ Astra อินพุตแคชถูกกว่า |
| ต้นทุนต่อภารกิจ | ต่ำกว่ามาก | มากกว่า Astra 2.1x ถึง 20.8x ตามชาร์ตของ OpenAI |
| งานมืออาชีพ | นำ (Agents' Last Exam, GDPval v2, Harvey LAB-AA) | ตามหลัง |
| เอเจนต์เขียนโค้ด | ตามหลัง | นำ (FrontierCode 2.0) |
| วิทยาศาสตร์ CAD และเหตุผล | นำเบนช์มาร์กสายวิทย์ | นำ Intelligence Index |
| การใช้คอมพิวเตอร์ | ไม่มีคะแนนเทียบเคียงที่เผยแพร่ | ทำคะแนนสูงในเบนช์มาร์กของ Anthropic เอง |
| การทดสอบภาคปฏิบัติของเรา | แม่นยำที่สุด ถูกกว่ามาก | สม่ำเสมอที่สุด มีข้อมูลล้าสมัยหนึ่งจุด |
ราคา: สิ่งที่จ่ายจริง
ราคาเป็นความต่างที่ใหญ่ที่สุด แม้ว่าอัตราโทเคนแทบจะเหมือนกัน ความต่างอยู่ที่จำนวนโทเคนที่แต่ละรุ่นใช้ต่อภารกิจ
อัตราโทเคนเคียงข้างกัน
| อัตรา | GPT-6.2 Astra | Claude Fable 5.2 |
|---|
| อินพุต ต่อ 1M โทเคน | $8.00 | $8.00 |
| เอาต์พุต ต่อ 1M โทเคน | $40.00 | $40.00 |
| อ่านอินพุตแคช ต่อ 1M โทเคน | $0.40 | $0.20 |
| เขียนแคช ต่อ 1M โทเคน | $10.00 | $10.00 |
| โหมดเร็ว อินพุต / เอาต์พุต ต่อ 1M โทเคน | $16.00 / $80.00 | $16.00 / $80.00 |
อัตราที่ต่างกันมีเพียงอินพุตแคช โดย Fable ถูกกว่า Astra ครึ่งหนึ่ง ซึ่งช่วยเอเจนต์ที่ต้องอ่านบริบทยาวคงที่ซ้ำ ๆ นอกจากนี้ OpenAI ยังคิดอัตราอินพุตของ Astra เป็นสองเท่าสำหรับคำขอเกิน 272K โทเคน ส่วนประกาศของ Anthropic ไม่ระบุการคิดเพิ่มแบบนี้สำหรับ Fable
ต้นทุนงานจริงเป็นเท่าไร
คำนวณที่อัตรามาตรฐานเป็น (ปริมาณ ÷ 1M) × อัตรา รวมอินพุตและเอาต์พุต:
| เวิร์กโหลด | GPT-6.2 Astra | Claude Fable 5.2 | ส่วนต่าง |
|---|
| ผู้ช่วยสมดุล: อินพุต 1M / เอาต์พุต 250K ต่อเดือน | $18.00 | $18.00 | $0 (0%) |
| ลูปหนักแคช: พรีฟิกซ์ 100K เขียนครั้งเดียว อ่านแคช 1,000 ครั้ง บวกอินพุตสด 5K / เอาต์พุต 1K ต่อคำขอ | $121.00 | $101.00 | Fable ถูกกว่า $20 (17%) |
เมื่อจำนวนโทเคนเท่ากัน Fable จะไม่แพงกว่าเลย และกรณีแคชหนักคือจุดที่ถูกกว่าอย่างชัดเจน ข้อแม้คือสมมติฐานเรื่องจำนวนโทเคนเท่ากัน
ทำไมภารกิจเดียวกันถึงมีต้นทุนต่างกัน
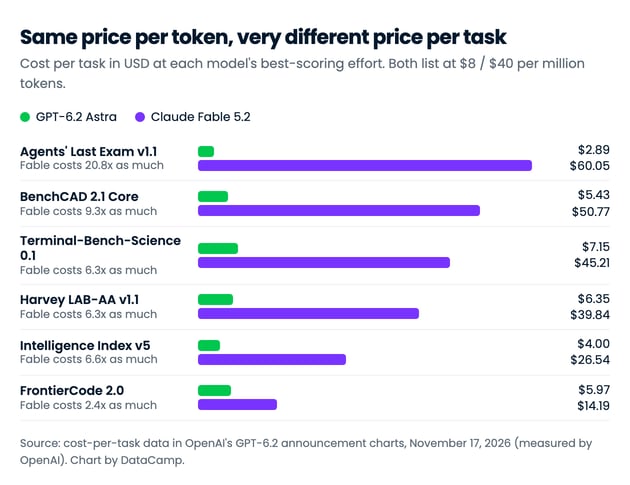
ชาร์ตเปิดตัวของ OpenAI รวมต้นทุนต่อภารกิจสำหรับทั้งสองรุ่น และ Fable แพงกว่าทุกกรณี ตั้งแต่ 2.1x บน Vals Science Index ไปจนถึง 20.8x บน Agents' Last Exam ($60.05 เทียบกับ Astra $2.89) ตัวเลขเหล่านี้เป็นการวัดคู่แข่งโดย OpenAI เอง ส่วนใหญ่ที่ระดับความพยายามสูงสุดของแต่ละรุ่น จึงควรมองเป็นทิศทางมากกว่าตัวเลขเสนอราคา
สาเหตุคือความยาวเอาต์พุต: ที่อัตราเท่ากัน รุ่นที่เขียนโทเคนมากกว่าหลายเท่า รวมโทเคนเหตุผลที่นับเป็นเอาต์พุต ย่อมมีต้นทุนหลายเท่าตามไปด้วย การทดสอบของเราเองด้านล่างก็ชี้ไปทางเดียวกัน
งานมืออาชีพและเวิร์กโฟลว์แบบเอเจนต์
GPT-6.2 Astra นำชัดเจนที่นี่: บน Harvey LAB-AA ซึ่งให้เครดิตเฉพาะงานกฎหมายที่ตรงตามทุกข้อกำหนด ได้ 15.0% เทียบกับ Fable 7.2%
| เบนช์มาร์ก | GPT-6.2 Astra | Claude Fable 5.2 | หมายเหตุ |
|---|
| Agents' Last Exam v1.1 | 78.3% | 72.8% | ชาร์ต OpenAI; Fable ใช้ความพยายามสูงสุด |
| GDPval v2 | 50.4% | 44.8% | เบนช์มาร์กภายในของ OpenAI |
| Harvey LAB-AA v1.1 | 15.0% | 7.2% | ชาร์ต OpenAI |
| AutomationBench 1.0.6 | 52.4% | 51.4% | ทั้งสองค่ายรายงาน Fable ที่ 51.4% |
| Remote Labor Index | ไม่เผยแพร่ | 41.3% | ตารางของ Anthropic เทียบ GPT-6 Astra |
Astra เหมาะกว่าสำหรับเอกสารพร้อมส่งลูกค้าและการวิเคราะห์ แม้ AutomationBench จะเสมอ และผล Remote Labor Index ของ Anthropic ยังไม่มีคู่เทียบ GPT-6.2
เอเจนต์เขียนโค้ด
Fable 5.2 เขียนโค้ดได้แข็งแรงกว่าบนเบนช์มาร์กที่ทั้งสองค่ายรายงานร่วมกัน: 49.1% บน FrontierCode 2.0 ซึ่งให้คะแนนว่าการเปลี่ยนโค้ดผ่านมาตรฐานของผู้ดูแลเพื่อรวมโค้ดหรือไม่ เทียบกับ Astra 44.2%
| เบนช์มาร์ก | GPT-6.2 Astra | Claude Fable 5.2 | หมายเหตุ |
|---|
| FrontierCode 2.0 | 44.2% | 49.1% | ทั้งสองค่ายเห็นพ้องกับคะแนนของ Fable |
| FrontierSWE v2 | ไม่เผยแพร่ | 69.9% | ตารางของ Anthropic |
| SecureSWE | 65.7% | ไม่เผยแพร่ | เบนช์มาร์กภายในของ OpenAI |
ชาร์ต FrontierCode ของ OpenAI เองแสดงการแลกเปลี่ยน: Fable ทำคะแนนสูงกว่า แต่ต้นทุนต่อภารกิจสูงกว่ามาก
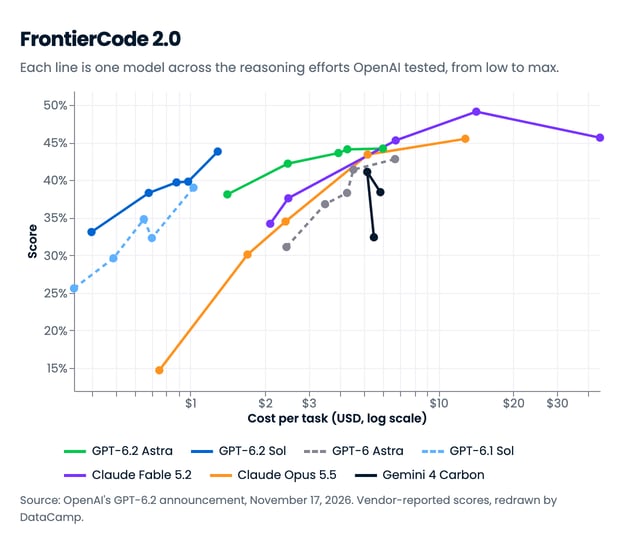
สำหรับเอเจนต์เขียนโค้ดที่ให้ความสำคัญคุณภาพมากกว่าต้นทุน Fable คือตัวเลือก
วิทยาศาสตร์ CAD และเหตุผลทั่วไป
มิตินี้แบ่งกัน: GPT-6.2 Astra นำเบนช์มาร์กสายวิทยาศาสตร์ ส่วน Fable 5.2 นำคอมโพสิตเหตุผลกว้าง และเสมอบน CAD
| เบนช์มาร์ก | GPT-6.2 Astra | Claude Fable 5.2 | หมายเหตุ |
|---|
| Terminal-Bench-Science 0.1 | 77.1% | 73.3% | Fable ผ่านฮาร์เนสของ Artificial Analysis; Anthropic รายงาน 74.6% ใน Claude Code |
| Vals Science Index v1 | 68.4% | 63.7% | ชาร์ต OpenAI |
| Artificial Analysis Intelligence Index v5.0.1 | 62.1 | 64.6 | คะแนนดัชนี |
| BenchCAD 2.1 Core | 82.5% | 83.5% | ถือว่าเสมอ |
| Humanity's Last Exam (with tools) | ไม่เผยแพร่ | 74.2% | ตารางของ Anthropic |
สำหรับการวิเคราะห์เชิงวิทยาศาสตร์ Astra มีภาษีได้เปรียบ; สำหรับเหตุผลทั่วไป Fable มีภาษี โดยทิ้งห่างคอมโพสิตไม่ถึง 3 คะแนน
การใช้คอมพิวเตอร์ งาน 3D และโรโบติกส์
Anthropic รายงานผลด้านการใช้คอมพิวเตอร์และโรโบติกส์ที่แข็งแกร่งสำหรับ Fable 5.2 รวมถึง 89.3% บน OSWorld 2.1 แต่ OpenAI ไม่ได้เผยแพร่คะแนน GPT-6.2 Astra ที่เทียบเคียง จึงยังไม่มีตัวต่อตัว ตัวเลขร่วมเพียงรายการเดียวเข้าทาง Astra: บน AA-3D ของ Artificial Analysis ที่ผู้ตัดสินมนุษย์โหวตระหว่างสองงานสร้าง 3D แบบปิดชื่อ Astra อยู่อันดับหนึ่งที่ Elo 1,318 เทียบกับ Fable 1,271
หากเวิร์กโหลดคือเอเจนต์ที่ใช้งานซอฟต์แวร์เดสก์ท็อป วันนี้ Fable มีหลักฐานสนับสนุนที่แข็งกว่า
ผลการทำงานของ GPT-6.2 Astra และ Claude Fable 5.2
เบนช์มาร์กจากสองค่ายคู่แข่งไปได้ไกลระดับหนึ่ง จึงให้ทั้งสองรุ่นทำงานโค้ดเชิงสร้างสรรค์ชุดเดียวกัน ด้วยพรอมต์และเครื่องมือเหมือนกันทุกประการ
ภารกิจ: เขียนสคริปต์สำหรับ Manim ไลบรารีแอนิเมชัน Python ที่มีชื่อเสียง เพื่อเรนเดอร์วิดีโออธิบายข้อสันนิษฐาน Collatz ความยาว 60 วินาทีสำหรับนักเรียนมัธยม กฎฟังดูเรียบง่าย (หารสองถ้าเป็นเลขคู่ คูณสามแล้วบวกหนึ่งถ้าเป็นเลขคี่) และยังไม่มีใครพิสูจน์ได้ว่าทุกจำนวนตั้งต้นจบที่ 1
ส่วนยากคือรุ่นไม่เห็นวิดีโอของตนเอง ไม่สามารถรันสคริปต์ได้ จึงต้องเรนเดอร์ผ่านในครั้งแรก ดูดี และถูกต้อง โดยไม่มีพรีวิวสักเฟรม วิดีโออธิบายยังชวนให้ใส่ของเสริมที่ดูน่าประทับใจ และทุกข้อความบนจอต้องจริง
ทั้งสองรุ่นรันใน OpenCode ด้วยชุดเครื่องมือที่ตรึงไว้ (อ่าน ค้นหา และแก้ไขไฟล์เท่านั้น) ที่ระดับความพยายามด้านเหตุผลสูงเท่ากัน ในเซสชันใหม่ทุกครั้ง เพราะบรีฟเชิงสร้างสรรค์อาศัยดวง จึงรันรุ่นละ 3 ครั้งและเรนเดอร์วิดีโอทั้ง 6
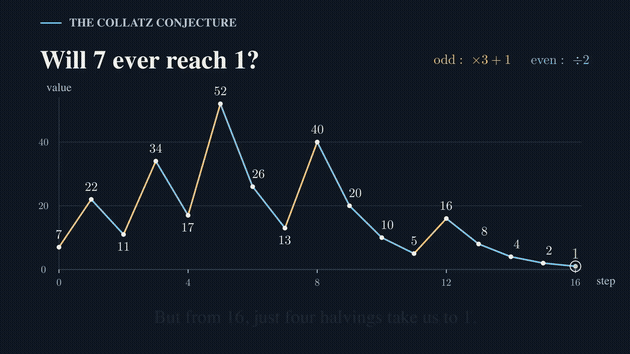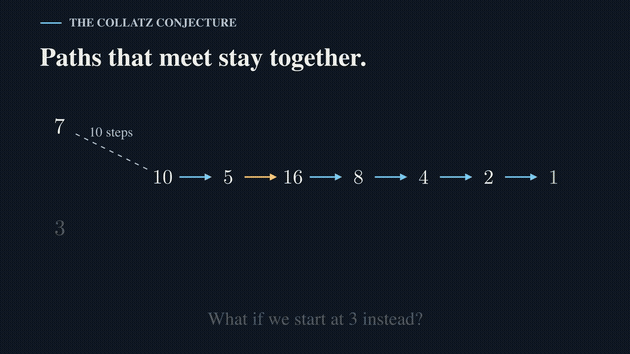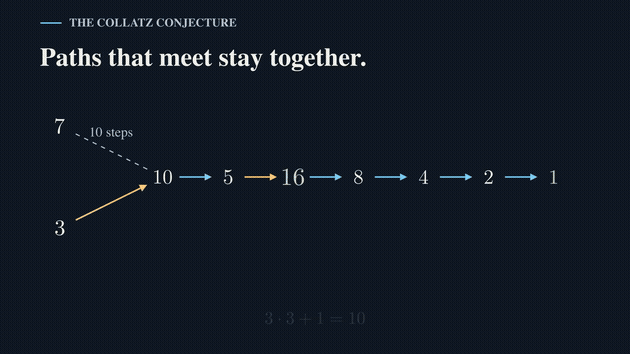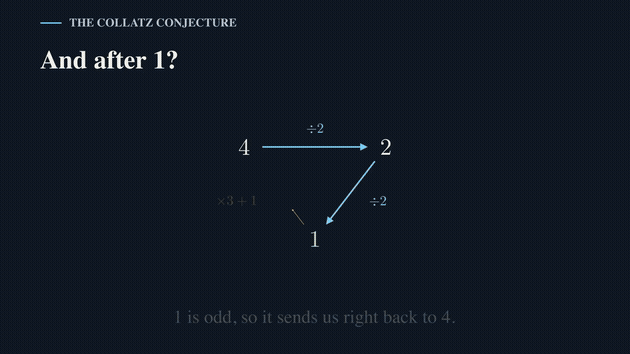
จากนั้นให้คะแนนวิดีโอแบบปิดตา สุ่มและติดป้าย A ถึง F ตาม 4 คำถาม: เนื้อหาบนจอถูกต้องทั้งหมดหรือไม่ นักเรียนจะเข้าใจแนวคิดไหม น่าดูหรือไม่ และดูจบหรือยัง นี่คือตอนหนึ่งจากวิดีโอที่ดีที่สุดของ GPT-6.2 Astra:
ข้อค้นพบหลัก:
- สคริปต์ทั้ง 6 เรนเดอร์ผ่านตั้งแต่ครั้งแรก ทุกวิดีโออยู่ในกรอบเป้าหมาย 60 วินาทีคลาดไม่เกิน 3 วินาที โดยไม่มีข้อผิดพลาดและไม่ต้องแก้
- ด้านคุณภาพ สูสีมาก คร่อมทั้ง 4 คำถาม สองรุ่นทำค่าเฉลี่ยต่างกันไม่ถึง 0.1 คะแนน Fable เป็นผู้สร้างภาพยนตร์ที่เสถียรกว่า: วิดีโอทั้ง 3 เดินพล็อตเนี๊ยบคล้ายกัน จบด้วยสองหนทางที่ข้อสันนิษฐานอาจล้ม และปิดด้วย "ไม่มีใครรู้"
- Astra ทำทั้งวิดีโอที่ดีที่สุดและอ่อนที่สุด งานที่ดีที่สุดอธิบายเลข 7 แทน 6 หรือ 27 แล้วชี้ว่าเส้นทางจากเลขต่างกันมาบรรจบและเดินร่วมกัน ซึ่งลึกกว่าวิดีโออื่น ส่วนที่อ่อนที่สุดเรียบไป พร้อมสมการที่สลับตำแหน่งชั่วครู่ทุกทรานซิชัน
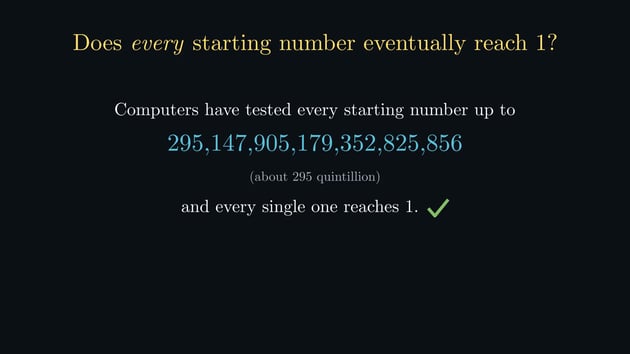
- ความถูกต้องแยกคะแนนกัน วิดีโอทั้ง 3 ของ Fable อ้างว่าคอมพิวเตอร์ได้ทดสอบทุกจำนวนตั้งต้นถึง 2^68 ซึ่งเป็นสถิติปี 2020; แต่มาตั้งแต่ปี 2025 คือ 2^71 วิดีโอของ Astra ไม่มีข้ออ้างที่เกินหลักฐาน
นี่คือข้ออ้างในวิดีโอของ Fable ซึ่งจริงตามนั้น แต่เสนอหมุดหมายเมื่อ 5 ปีก่อนราวกับเป็นสถานะปัจจุบัน ในทั้ง 3 ครั้ง:
และนี่คือแอนิเมชันการไต่ทางยาวของ 27 ของ Fable ซึ่งอธิบายว่าทำไมวิดีโอจึงทำคะแนนเชิงช่างฝีมือได้ดี:
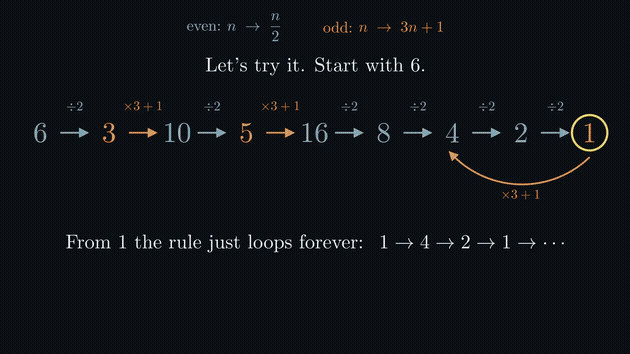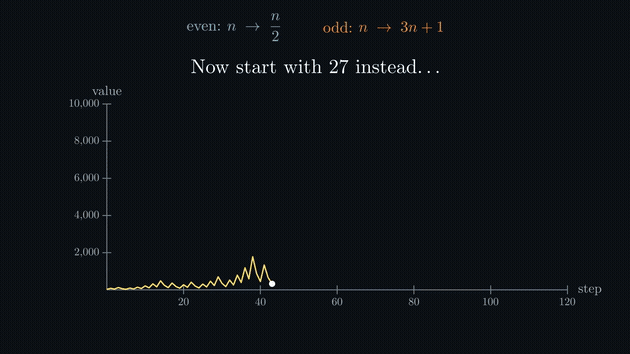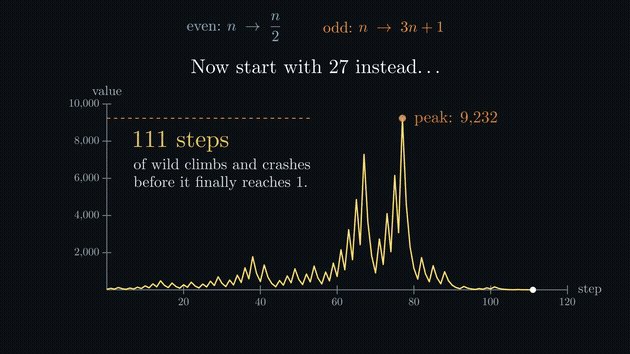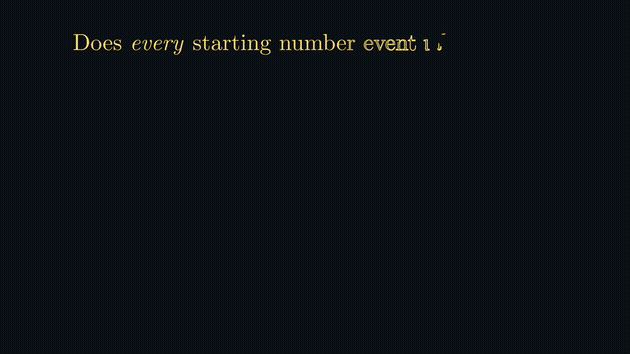
ช่องว่างต้นทุนใหญ่ Fable มีต้นทุนสคริปต์ละ $3.84 ถึง $4.35 และ Astra $0.40 ถึง $0.84 เพราะ Fable เขียนโทเคนเอาต์พุตมากกว่า 4 ถึง 10 เท่า และช้ากว่ามาก
| ตัวชี้วัด | GPT-6.2 Astra | Claude Fable 5.2 |
|---|
| ต้นทุนต่อการรัน (USD) | $0.84, $0.61, $0.40 | $4.35, $3.84, $4.19 |
| โทเคนเอาต์พุต (รวมเหตุผล) | 17,551, 10,828, 8,124 | 84,822, 74,457, 81,316 |
| ความถูกต้อง ต่อครั้ง | 5, 5, 5 | 4, 4, 4 |
| คะแนนรูบริก (ค่าเฉลี่ย 4 แกน) ต่อครั้ง | 4.8, 4.8, 3.8 | 4.2, 4.8, 4.5 |
แล้วรุ่นไหนชนะ? ด้านคุณภาพไม่มีใคร ส่วน Astra ชนะทุกอย่างรอบ ๆ นั้น: มาตรฐานวิดีโอเท่ากัน ไม่มีข้อมูลเท็จบนจอ แต่ราคาประมาณหนึ่งในหก Fable มีความสม่ำเสมอจริง แต่นิสัยย้ำข้อมูลเก่าด้วยความมั่นใจนั้นก็จริงเช่นกัน
ควรเลือก GPT-6.2 Astra หรือ Claude Fable 5.2 เมื่อไร
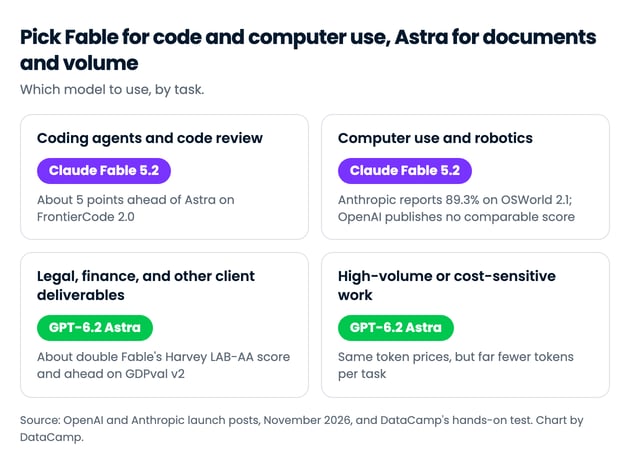
เมื่อราคาต่อโทเคนเท่ากัน การตัดสินใจจึงอยู่ที่สองคำถาม: งานเอื้อกับจุดเด่นด้านการเขียนโค้ดและการใช้คอมพิวเตอร์ของ Fable หรือไม่ และรับภาระโทเคนต่อภารกิจที่มากกว่าหลายเท่าไหวหรือไม่
เลือก GPT-6.2 Astra ถ้า...
- ผลิตเอกสารพร้อมส่งลูกค้า ร่างกฎหมาย หรือการวิเคราะห์การเงิน ซึ่ง Astra นำเบนช์มาร์กงานมืออาชีพ
- รันงานปริมาณสูง ซึ่งการใช้โทเคนน้อยกว่าของ Astra ช่วยลดบิลได้แม้อัตราเท่ากัน
- ต้องการการวิเคราะห์เชิงวิทยาศาสตร์ในเทอร์มินัลหรือโน้ตบุ๊ก ซึ่ง Astra นำทั้งสองเบนช์มาร์กสายวิทย์
- ให้ความสำคัญความถูกต้องในงานสร้างสรรค์หรืออธิบายแบบเปิด ตามที่เราทดสอบ
เลือก Claude Fable 5.2 ถ้า...
- รันเอเจนต์เขียนโค้ดบนรีโปจริง ซึ่ง Fable นำ FrontierCode 2.0 ราว 5 คะแนน
- เอเจนต์ใช้งานซอฟต์แวร์เดสก์ท็อป: Anthropic รายงาน 89.3% บน OSWorld 2.1 สำหรับ Fable และ OpenAI ยังไม่เผยแพร่คะแนนเทียบเคียงของ Astra
- ดีพลอยผ่าน AWS Bedrock, Google Vertex AI หรือ Azure AI Foundry ซึ่งทั้งหมดมี Fable เอกสารของ Azure ไม่ระบุ Astra และเราไม่ยืนยันได้บนอีกสองแพลตฟอร์ม
- เอเจนต์อ่านบริบทยาวคงที่ซ้ำ ๆ ซึ่งอินพุตแคชของ Fable มีราคาครึ่งหนึ่ง
เริ่มต้นใช้ GPT-6.2 Astra และ Claude Fable 5.2 อย่างไร
| ช่องทาง | GPT-6.2 Astra | Claude Fable 5.2 |
|---|
| แอปสำหรับผู้ใช้ทั่วไป | ChatGPT Work และ Codex (Plus, Pro, Enterprise, Edu) | แอป Claude (เปิดให้ผู้ใช้ทุกคน) |
| API ของผู้พัฒนาหลัก | OpenAI API | Claude Platform |
| แพลตฟอร์มคลาวด์ | ไม่ปรากฏในเอกสาร Azure AI Foundry ณ วันที่ 17 พฤศจิกายน 2026 | AWS Bedrock, Google Vertex AI, Azure AI Foundry |
| เอเจนต์เขียนโค้ด | Codex; ไม่ปรากฏในเอกสาร Cursor หรือ GitHub Copilot ณ เวลาที่เขียน | GitHub Copilot; ไม่ปรากฏในเอกสาร Cursor ณ เวลาที่เขียน |
| ตัวกลางเชื่อมต่อบุคคลที่สาม | OpenRouter | OpenRouter |
| รหัสรุ่นใน API | gpt-6.2-astra | claude-fable-5-2 |
ความต่างใหญ่คือการเข้าถึงผ่านคลาวด์: Fable อยู่ครบทั้งสามคลาวด์หลัก ขณะที่ Astra เข้าถึงผ่าน API และผลิตภัณฑ์ของ OpenAI เอง บน OpenRouter สลับกันได้ด้วยการเปลี่ยนสตริงเดียว:
from openai import OpenAI
client = OpenAI(base_url="https://openrouter.ai/api/v1")
response = client.chat.completions.create(
model="openai/gpt-6.2-astra",
messages=[{"role": "user", "content": "Review this pull request..."}],
)
print(response.choices[0].message.content)ขับเคลื่อนโดย
สำหรับการตั้งค่าเต็มรูปแบบ ดู บทเรียน API ของ Fable 5.2 และ บทเรียน API ของ GPT-6 Astra ของเรา
ข้อคิดส่งท้าย
ด้านศักยภาพ GPT-6.2 Astra และ Claude Fable 5.2 ผลัดกันชนะ: Astra สำหรับงานมืออาชีพและงานวิเคราะห์ Fable สำหรับการเขียนโค้ดและการใช้คอมพิวเตอร์
ด้านต้นทุน Astra ชนะเกือบทุกที่ เพราะราคาต่อโทเคนที่เหมือนกันซ่อน "ความอยากโทเคน" ที่ต่างกันมาก
หากอยากเรียนรู้เพิ่มเติมเกี่ยวกับการพัฒนาด้วยรุ่นของ Anthropic แนะนำคอร์ส Introduction to Claude Models ของเรา ส่วนฝั่ง OpenAI ลอง Working with the OpenAI API
Anthropic เปิดตัว Claude Fable 5.2 เมื่อต้นเดือนพฤศจิกายนในฐานะแฟลกชิปรุ่นใหม่ เมื่อวันที่ 17 พฤศจิกายน 2026 OpenAI ตอบด้วย GPT-6.2 Astra รุ่นแนวหน้าตัวใหม่ และชาร์ตเปิดตัวยังวาง Fable 5.2 เทียบกับ Astra บนเบนช์มาร์กส่วนใหญ่
ปัจจุบันทั้งสองรุ่นตั้งราคาต่อโทเคนเท่ากันพอดี บนกระดาษจึงเป็นการวัดศักยภาพล้วน ๆ แต่ในทางปฏิบัติ บิลสะท้อนอีกเรื่องหนึ่ง และการทดสอบแบบลงมือทำของเราก็เช่นกัน
เพื่ออัปเดตความเคลื่อนไหวด้าน AI และข้อมูล แนะนำให้สมัครจดหมายข่าวรายสัปดาห์ของเรา The Median.
สรุปสั้น ๆ
GPT-6.2 Astra คืออะไร?
GPT-6.2 Astra คือรุ่นแนวหน้าของ OpenAI เปิดตัวในเดือนพฤศจิกายน 2026 เป็นระดับสูงสุดของตระกูล GPT-6.2 เหนือ GPT-6.2 Sol
จุดขายคือผลลัพธ์ระดับมืออาชีพที่ต้นทุนต่อภารกิจต่ำลง: สไลด์ เวิร์กบุ๊ก และเอกสารที่ตามเทมเพลตของผู้ใช้ พร้อมการใช้คอมพิวเตอร์ในเครื่องมือ CAD และซิมูเลชัน
โพสต์เปิดตัวของ OpenAI ครอบคลุมรายละเอียด และ บทเรียน API ของ GPT-6 Astra ของเราแสดงวิธีพัฒนาด้วยเจเนอเรชันก่อนหน้า
Claude Fable 5.2 คืออะไร?
Claude Fable 5.2 คือรุ่นแฟลกชิปของ Anthropic เปิดตัวในเดือนพฤศจิกายน 2026 ควบคู่กับ Claude Mythos 5.2 ซึ่งเป็นเวอร์ชันสำหรับองค์กรที่ผ่านการตรวจสอบด้านความปลอดภัยไซเบอร์และชีวเวช
Anthropic วางตำแหน่งสำหรับงานเทคนิคระยะยาว: เอเจนต์เขียนโค้ด การใช้คอมพิวเตอร์ และงานวิจัย พร้อมโหมดเร็วทางเลือกที่สร้างโทเคนได้เร็วขึ้นถึง 2.5 เท่า
คู่มือ Fable 5.2 ของเราครอบคลุมการเปิดตัว และ บทเรียน API ของ Fable 5.2 พาเดินสร้างเอเจนต์ทดสอบสมมติฐาน
GPT-6.2 Astra vs Claude Fable 5.2: เปรียบเทียบตัวต่อตัว
ภาพรวมศักยภาพเป็นการแบ่งแต้ม และช่องว่างเบนช์มาร์กส่วนใหญ่ต่างกันไม่กี่คะแนน ช่องว่างด้านต้นทุนไม่ใช่แบบนั้น: ราคาต่อโทเคนเท่ากัน แต่ Fable ต้องใช้โทเคนมากกว่ามากเพื่อจบภารกิจเดียวกัน
ราคา: สิ่งที่จ่ายจริง
ราคาเป็นความต่างที่ใหญ่ที่สุด แม้ว่าอัตราโทเคนแทบจะเหมือนกัน ความต่างอยู่ที่จำนวนโทเคนที่แต่ละรุ่นใช้ต่อภารกิจ
อัตราโทเคนเคียงข้างกัน
อัตราที่ต่างกันมีเพียงอินพุตแคช โดย Fable ถูกกว่า Astra ครึ่งหนึ่ง ซึ่งช่วยเอเจนต์ที่ต้องอ่านบริบทยาวคงที่ซ้ำ ๆ นอกจากนี้ OpenAI ยังคิดอัตราอินพุตของ Astra เป็นสองเท่าสำหรับคำขอเกิน 272K โทเคน ส่วนประกาศของ Anthropic ไม่ระบุการคิดเพิ่มแบบนี้สำหรับ Fable
ต้นทุนงานจริงเป็นเท่าไร
คำนวณที่อัตรามาตรฐานเป็น (ปริมาณ ÷ 1M) × อัตรา รวมอินพุตและเอาต์พุต:
เมื่อจำนวนโทเคนเท่ากัน Fable จะไม่แพงกว่าเลย และกรณีแคชหนักคือจุดที่ถูกกว่าอย่างชัดเจน ข้อแม้คือสมมติฐานเรื่องจำนวนโทเคนเท่ากัน
ทำไมภารกิจเดียวกันถึงมีต้นทุนต่างกัน
ชาร์ตเปิดตัวของ OpenAI รวมต้นทุนต่อภารกิจสำหรับทั้งสองรุ่น และ Fable แพงกว่าทุกกรณี ตั้งแต่ 2.1x บน Vals Science Index ไปจนถึง 20.8x บน Agents' Last Exam ($60.05 เทียบกับ Astra $2.89) ตัวเลขเหล่านี้เป็นการวัดคู่แข่งโดย OpenAI เอง ส่วนใหญ่ที่ระดับความพยายามสูงสุดของแต่ละรุ่น จึงควรมองเป็นทิศทางมากกว่าตัวเลขเสนอราคา
สาเหตุคือความยาวเอาต์พุต: ที่อัตราเท่ากัน รุ่นที่เขียนโทเคนมากกว่าหลายเท่า รวมโทเคนเหตุผลที่นับเป็นเอาต์พุต ย่อมมีต้นทุนหลายเท่าตามไปด้วย การทดสอบของเราเองด้านล่างก็ชี้ไปทางเดียวกัน
งานมืออาชีพและเวิร์กโฟลว์แบบเอเจนต์
GPT-6.2 Astra นำชัดเจนที่นี่: บน Harvey LAB-AA ซึ่งให้เครดิตเฉพาะงานกฎหมายที่ตรงตามทุกข้อกำหนด ได้ 15.0% เทียบกับ Fable 7.2%
Astra เหมาะกว่าสำหรับเอกสารพร้อมส่งลูกค้าและการวิเคราะห์ แม้ AutomationBench จะเสมอ และผล Remote Labor Index ของ Anthropic ยังไม่มีคู่เทียบ GPT-6.2
เอเจนต์เขียนโค้ด
Fable 5.2 เขียนโค้ดได้แข็งแรงกว่าบนเบนช์มาร์กที่ทั้งสองค่ายรายงานร่วมกัน: 49.1% บน FrontierCode 2.0 ซึ่งให้คะแนนว่าการเปลี่ยนโค้ดผ่านมาตรฐานของผู้ดูแลเพื่อรวมโค้ดหรือไม่ เทียบกับ Astra 44.2%
ชาร์ต FrontierCode ของ OpenAI เองแสดงการแลกเปลี่ยน: Fable ทำคะแนนสูงกว่า แต่ต้นทุนต่อภารกิจสูงกว่ามาก
สำหรับเอเจนต์เขียนโค้ดที่ให้ความสำคัญคุณภาพมากกว่าต้นทุน Fable คือตัวเลือก
วิทยาศาสตร์ CAD และเหตุผลทั่วไป
มิตินี้แบ่งกัน: GPT-6.2 Astra นำเบนช์มาร์กสายวิทยาศาสตร์ ส่วน Fable 5.2 นำคอมโพสิตเหตุผลกว้าง และเสมอบน CAD
สำหรับการวิเคราะห์เชิงวิทยาศาสตร์ Astra มีภาษีได้เปรียบ; สำหรับเหตุผลทั่วไป Fable มีภาษี โดยทิ้งห่างคอมโพสิตไม่ถึง 3 คะแนน
การใช้คอมพิวเตอร์ งาน 3D และโรโบติกส์
Anthropic รายงานผลด้านการใช้คอมพิวเตอร์และโรโบติกส์ที่แข็งแกร่งสำหรับ Fable 5.2 รวมถึง 89.3% บน OSWorld 2.1 แต่ OpenAI ไม่ได้เผยแพร่คะแนน GPT-6.2 Astra ที่เทียบเคียง จึงยังไม่มีตัวต่อตัว ตัวเลขร่วมเพียงรายการเดียวเข้าทาง Astra: บน AA-3D ของ Artificial Analysis ที่ผู้ตัดสินมนุษย์โหวตระหว่างสองงานสร้าง 3D แบบปิดชื่อ Astra อยู่อันดับหนึ่งที่ Elo 1,318 เทียบกับ Fable 1,271
หากเวิร์กโหลดคือเอเจนต์ที่ใช้งานซอฟต์แวร์เดสก์ท็อป วันนี้ Fable มีหลักฐานสนับสนุนที่แข็งกว่า
ผลการทำงานของ GPT-6.2 Astra และ Claude Fable 5.2
เบนช์มาร์กจากสองค่ายคู่แข่งไปได้ไกลระดับหนึ่ง จึงให้ทั้งสองรุ่นทำงานโค้ดเชิงสร้างสรรค์ชุดเดียวกัน ด้วยพรอมต์และเครื่องมือเหมือนกันทุกประการ
ภารกิจ: เขียนสคริปต์สำหรับ Manim ไลบรารีแอนิเมชัน Python ที่มีชื่อเสียง เพื่อเรนเดอร์วิดีโออธิบายข้อสันนิษฐาน Collatz ความยาว 60 วินาทีสำหรับนักเรียนมัธยม กฎฟังดูเรียบง่าย (หารสองถ้าเป็นเลขคู่ คูณสามแล้วบวกหนึ่งถ้าเป็นเลขคี่) และยังไม่มีใครพิสูจน์ได้ว่าทุกจำนวนตั้งต้นจบที่ 1
ส่วนยากคือรุ่นไม่เห็นวิดีโอของตนเอง ไม่สามารถรันสคริปต์ได้ จึงต้องเรนเดอร์ผ่านในครั้งแรก ดูดี และถูกต้อง โดยไม่มีพรีวิวสักเฟรม วิดีโออธิบายยังชวนให้ใส่ของเสริมที่ดูน่าประทับใจ และทุกข้อความบนจอต้องจริง
ทั้งสองรุ่นรันใน OpenCode ด้วยชุดเครื่องมือที่ตรึงไว้ (อ่าน ค้นหา และแก้ไขไฟล์เท่านั้น) ที่ระดับความพยายามด้านเหตุผลสูงเท่ากัน ในเซสชันใหม่ทุกครั้ง เพราะบรีฟเชิงสร้างสรรค์อาศัยดวง จึงรันรุ่นละ 3 ครั้งและเรนเดอร์วิดีโอทั้ง 6
จากนั้นให้คะแนนวิดีโอแบบปิดตา สุ่มและติดป้าย A ถึง F ตาม 4 คำถาม: เนื้อหาบนจอถูกต้องทั้งหมดหรือไม่ นักเรียนจะเข้าใจแนวคิดไหม น่าดูหรือไม่ และดูจบหรือยัง นี่คือตอนหนึ่งจากวิดีโอที่ดีที่สุดของ GPT-6.2 Astra:
ข้อค้นพบหลัก:
นี่คือข้ออ้างในวิดีโอของ Fable ซึ่งจริงตามนั้น แต่เสนอหมุดหมายเมื่อ 5 ปีก่อนราวกับเป็นสถานะปัจจุบัน ในทั้ง 3 ครั้ง:
และนี่คือแอนิเมชันการไต่ทางยาวของ 27 ของ Fable ซึ่งอธิบายว่าทำไมวิดีโอจึงทำคะแนนเชิงช่างฝีมือได้ดี:
ช่องว่างต้นทุนใหญ่ Fable มีต้นทุนสคริปต์ละ $3.84 ถึง $4.35 และ Astra $0.40 ถึง $0.84 เพราะ Fable เขียนโทเคนเอาต์พุตมากกว่า 4 ถึง 10 เท่า และช้ากว่ามาก
แล้วรุ่นไหนชนะ? ด้านคุณภาพไม่มีใคร ส่วน Astra ชนะทุกอย่างรอบ ๆ นั้น: มาตรฐานวิดีโอเท่ากัน ไม่มีข้อมูลเท็จบนจอ แต่ราคาประมาณหนึ่งในหก Fable มีความสม่ำเสมอจริง แต่นิสัยย้ำข้อมูลเก่าด้วยความมั่นใจนั้นก็จริงเช่นกัน
ควรเลือก GPT-6.2 Astra หรือ Claude Fable 5.2 เมื่อไร
เมื่อราคาต่อโทเคนเท่ากัน การตัดสินใจจึงอยู่ที่สองคำถาม: งานเอื้อกับจุดเด่นด้านการเขียนโค้ดและการใช้คอมพิวเตอร์ของ Fable หรือไม่ และรับภาระโทเคนต่อภารกิจที่มากกว่าหลายเท่าไหวหรือไม่
เลือก GPT-6.2 Astra ถ้า...
เลือก Claude Fable 5.2 ถ้า...
เริ่มต้นใช้ GPT-6.2 Astra และ Claude Fable 5.2 อย่างไร
gpt-6.2-astraclaude-fable-5-2ความต่างใหญ่คือการเข้าถึงผ่านคลาวด์: Fable อยู่ครบทั้งสามคลาวด์หลัก ขณะที่ Astra เข้าถึงผ่าน API และผลิตภัณฑ์ของ OpenAI เอง บน OpenRouter สลับกันได้ด้วยการเปลี่ยนสตริงเดียว:
สำหรับการตั้งค่าเต็มรูปแบบ ดู บทเรียน API ของ Fable 5.2 และ บทเรียน API ของ GPT-6 Astra ของเรา
ข้อคิดส่งท้าย
ด้านศักยภาพ GPT-6.2 Astra และ Claude Fable 5.2 ผลัดกันชนะ: Astra สำหรับงานมืออาชีพและงานวิเคราะห์ Fable สำหรับการเขียนโค้ดและการใช้คอมพิวเตอร์
ด้านต้นทุน Astra ชนะเกือบทุกที่ เพราะราคาต่อโทเคนที่เหมือนกันซ่อน "ความอยากโทเคน" ที่ต่างกันมาก
หากอยากเรียนรู้เพิ่มเติมเกี่ยวกับการพัฒนาด้วยรุ่นของ Anthropic แนะนำคอร์ส Introduction to Claude Models ของเรา ส่วนฝั่ง OpenAI ลอง Working with the OpenAI API