วันนี้ Anthropic ประกาศเปิดตัว Fable 5.2 สำหรับผู้ใช้ทั่วไป และ Mythos 5.2 สำหรับองค์กรที่ผ่านการตรวจสอบ ทั้งสองเป็นโมเดลพื้นฐานเดียวกัน แต่เวอร์ชัน Fable มีมาตรการคุ้มครองเพิ่มเติมด้านความปลอดภัยไซเบอร์และชีววิทยา
ประเด็นสำคัญของการเปลี่ยนแปลงคือ:
- ราคาถูกลง,
- เอาต์พุตเร็วขึ้น, และ
- คะแนนพุ่งขึ้นอย่างมากในเบนช์มาร์กที่ยากที่สุดของ Anthropic
โดยเฉพาะ Fable 5.2 มีราคาถูกกว่า Fable 5.1 อยู่ 20% สร้างเอาต์พุตได้เร็วขึ้นถึง 30% และทำคะแนนชนะ GPT-6 Astra และ Gemini 4 Carbon ในตารางเบนช์มาร์กของ Anthropic ส่วนใหญ่
บทความนี้จะครอบคลุมสิ่งที่ใหม่ใน Fable 5.2 และ Mythos 5.2 ประสิทธิภาพบนเบนช์มาร์ก ราคา และวิธีตัดสินใจว่าจะเลือกใช้แทน Claude Opus 5.5 หรือไม่
Claude Fable 5.2 คืออะไร?
Claude Fable 5.2 คือโมเดลที่ทรงความสามารถที่สุดของ Anthropic ที่เปิดให้ใช้งานทั่วไป ออกแบบมาสำหรับงานเทคนิคที่ยาวและซับซ้อน: การย้ายโค้ดเบสขนาดใหญ่ การรันเอเจนต์หลายวัน งานวิจัย และการออกแบบวิศวกรรม
Fable 5.2 ยังสามารถทำงานร่วมกับโมเดลขนาดเล็กกว่าได้ ไม่ว่าจะเป็นที่ปรึกษาที่คอยให้คำแนะนำในปัญหายาก หรือเป็นผู้ประสานงานที่มอบหมายงานย่อยที่ง่ายกว่าให้โมเดลเหล่านั้น
Fable 5.2 คงหน้าต่างบริบทขนาด 1M โทเค็น และเอาต์พุตสูงสุด 128K เช่นเดียวกับรุ่นก่อน ความรู้ล่าสุดถึงเดือนมิถุนายน 2026
Claude Mythos 5.2 คืออะไร?
Claude Mythos 5.2 เป็นโมเดลเดียวกับ Fable 5.2 แต่ไม่มีมาตรการคุ้มครองที่บล็อกงานด้านความปลอดภัยไซเบอร์ส่วนใหญ่และงานชีววิทยาระดับงานวิจัย ความจริงแล้ว Mythos 5.2 เป็นโมเดลที่ทรงพลังที่สุดของ Anthropic สำหรับวิศวกรรมไซเบอร์ซีเคียวริตี้ เนื่องจากความสามารถประเภทนี้เป็นดาบสองคม Anthropic จึงให้ Mythos 5.2 เฉพาะองค์กรที่ผ่านการตรวจสอบผ่านโปรแกรม Cyber Verification และ Life Sciences Verification เท่านั้น
อะไรใหม่ใน Claude Fable 5.2?
Fable เพิ่งเปิดตัวเมื่อเดือนมิถุนายน เมื่อ Anthropic ปล่อย Fable 5 ตั้งแต่นั้นมาก็มีรุ่นย่อยอีกสองครั้ง Fable 5.1 ในเดือนกันยายน และตอนนี้ Fable 5.2 ซึ่งทั้งสองรุ่นไม่ได้เพิ่มฟีเจอร์ใหม่มากนัก เป็นการทำให้โมเดลถูกลง เร็วขึ้น และแข็งแกร่งขึ้นเป็นหลัก แม้ว่าแรงส่งด้านประสิทธิภาพจะไม่เล็กน้อยก็ตาม: ตัวอย่างเช่น Fable 5.2 ทำคะแนน Remote Labor Index ได้มากกว่ารุ่น 5.1 กว่าเท่าตัว
ความต่างที่ใหญ่กว่าระหว่างสองรุ่นย่อยอยู่ที่วิธีการใช้งานที่อนุญาต สำหรับ Fable 5.1 Anthropic ได้จำกัดมาตรการคุ้มครองด้านไซเบอร์ใหม่ และเริ่มอนุญาตให้ใช้โมเดลค้นหาช่องโหว่ซอฟต์แวร์ได้ แม้จะยังไม่อนุญาตให้เขียนเอ็กซ์พลอยต์ และยังประกาศ Enterprise Frontier Safeguards ซึ่งเป็นทางเลือกให้เก็บข้อมูลไว้ในคลาวด์ของตนเองพร้อมกับการเปิดตัว Fable 5.2 มีการเปลี่ยนแปลงกฎคุ้มครองที่เล็กกว่า: บล็อกคำขอน้อยลง แต่ประเภทงานที่ห้ามยังคงเดิม
แนวทางใหม่ที่ Anthropic แนะนำให้ใช้ เช่น ให้ Fable 5.2 เป็นที่ปรึกษาให้โมเดล Claude ที่เล็กกว่า ก็ไม่ใช่เรื่องใหม่ เพราะเครื่องมือ advisor ของ Anthropic รองรับ Fable 5 และ 5.1 อยู่แล้ว เดโมเปิดตัวต่าง ๆ เช่น ระบบปฏิบัติการที่สร้างจากโฟลเดอร์เปล่า แสดงให้เห็นว่าโมเดลแข็งแกร่งขึ้นและทำงานยากขึ้น ไม่ใช่ฟีเจอร์ใหม่ที่เปิดสวิตช์ได้
อย่างไรก็ดี หากจะชี้ถึงสิ่งที่ใหม่ นี่คือประเด็นที่น่าพูดถึง:
ราคาถูกลง
Fable 5.2 มีราคา $8 ต่อโทเค็นขาเข้า 1 ล้าน และ $40 ต่อโทเค็นขาออก 1 ล้าน ถูกกว่า Fable 5.1 ที่ $10/$50 อยู่ 20% การลด 20% เดียวกันนี้ใช้กับการอ่านแคช ($0.20) การเขียนแคช และการประมวลผลแบบแบตช์ ดูรายละเอียดเต็มในส่วนราคา
เอาต์พุตเร็วขึ้น และโหมดเร็วสำหรับ Fable
เอาต์พุตเร็วขึ้นถึง 30% เมื่อเทียบกับ Fable 5.1 ซึ่งสะสมผลลัพธ์ได้มากในงานเอเจนต์ที่ยาว Fable ยังรองรับโหมดเร็วแล้ว ซึ่งเร่งเอาต์พุตได้มากถึง 2.5 เท่า ที่ราคาเพิ่มเป็นสองเท่า ($16/$80)
ผลลัพธ์ดีกว่าด้วยความพยายามที่น้อยลง
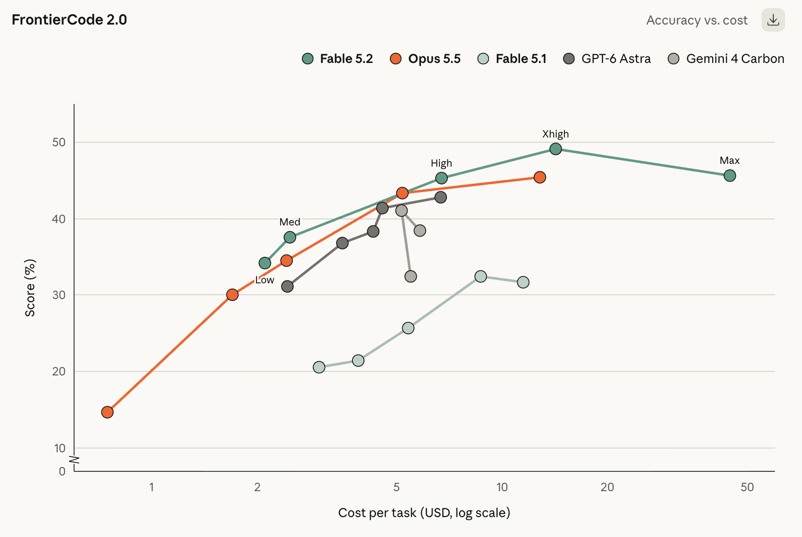
นี่คือการเปลี่ยนแปลงที่น่าจะกระทบค่าใช้จ่ายมากที่สุด ที่ระดับความพยายามสูง Fable 5.2 ทำได้ 45.3% บน FrontierCode 2.0 ประมาณระดับเดียวกับคะแนนสูงสุดของ Opus 5.5 แต่ต้นทุนต่อภารกิจราวครึ่งหนึ่ง ที่ระดับความพยายามต่ำ มันทำคะแนนเท่ากับคะแนนสูงสุดของ Opus 5.5 บน Humanity's Last Exam ที่ต้นทุนต่อภารกิจน้อยกว่าหนึ่งในสิบ ข้อสรุป: หากกำลังก้าวขึ้นมาจาก Opus 5.5 ให้เริ่มใช้ Fable 5.2 ที่ระดับความพยายามต่ำกว่า
คำขอถูกบล็อกน้อยลง
Fable 5.2 ควรถูกบล็อกด้วยมาตรการความปลอดภัยน้อยกว่า Fable 5.1 ราว 55% (ในงานไซเบอร์ซีเคียวริตี้น้อยลงประมาณ 60% และชีววิทยาน้อยลงประมาณ 40%) นี่สำคัญมากหากการปฏิเสธของ Fable 5.1 สร้างอุปสรรคให้ แต่หมวดหมู่ที่ถูกบล็อกยังไม่เปลี่ยน: การทดสอบเจาะระบบ การสร้างเอ็กซ์พลอยต์ และงานชีววิทยาระดับวิจัยส่วนใหญ่ยังถูกส่งต่อให้โมเดล Claude รุ่นเก่า
Claude Fable 5.2 ทำผลงานบนเบนช์มาร์กอย่างไร?
นี่คือผลลัพธ์หลัก ทั้งหมดมาจากตารางเปิดตัวของ Anthropic จึงควรอ่านในฐานะข้อเสนอสนับสนุนโมเดลของ Anthropic มากกว่าผลอิสระ คะแนนของ Claude รันภายใต้โหมดคุ้มครอง เว้นแต่ระบุไว้ แต่ละโมเดลแสดงที่ระดับความพยายามสูงสุดที่มี
| Benchmark | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|
| FrontierCode 2.0 (agentic coding) | 49.1% | 32.4% | 45.5% | 42.8% | 41.1% |
| FrontierSWE v2 (agentic coding) | 69.9% | 56.3% | 62.3% | 65.5% | 61.2% |
| AutomationBench (business workflows) | 51.4% | 31.4% | 42.5% | 41.4% | 53.9% |
| Terminal-Bench-Science 0.1 | 74.6% | 52.6% | 58.7% | 68.1% | 64.8% |
| OSWorld 2.1 (computer use) | 89.3% | 83.5% | 87.2% | 79.5% | 81.5% |
| RoboDojo Sim (robotics) | 64.9% | 27.6% | 39.4% | 29.8% | Not reported |
| AA-Briefcase v1.1 (knowledge work) | 66.1% | 61.5% | 61.2% | 52.0% | 61.8% |
| Remote Labor Index (knowledge work) | 41.3% | 17.9% | 21.3% | 20.8% | Not reported |
| Humanity's Last Exam (with tools) | 74.2% | 65.6% | 67.7% | 57.2% | Not reported |
| WANDR (agentic search) | 82.1% | 68.7% | 72.3% | Not reported | Not reported |
| Chartography (no tools) | 73.4% | 44.8% | 64.4% | 71.0% | 72.5% |
Agentic coding
Fable 5.2 นำทั้งสองเบนช์มาร์กด้านโค้ดดิ้งในตาราง บน FrontierCode 2.0 ซึ่งวัดว่าผู้ดูแลโปรเจ็กต์โอเพนซอร์สจะรวมการเปลี่ยนแปลงโค้ดของโมเดลหรือไม่ มันทำได้ 49.1% สูงสุดในตาราง และสูงกว่า Fable 5.1 ที่ 32.4% อย่างมาก บน FrontierSWE v2 ทำได้ 69.9% นำหน้า GPT-6 Astra (65.5%) และ Opus 5.5 (62.3%)
ตัวอย่างในวันเปิดตัวยังสอดคล้องกัน: เอเจนต์ที่รัน Fable 5.2 เวอร์ชันแรก ๆ ย้ายเซอร์วิสโปรดักชันจาก Python ไปเป็น Rust และตอนนี้สตาร์ตได้เร็วขึ้นประมาณ 26 เท่า
งานความรู้และงานวิจัย
การกระโดดที่ใหญ่ที่สุดแบบสัมพัทธ์อยู่ที่ Remote Labor Index ซึ่งวัดว่ามodelทำโปรเจ็กต์แนวฟรีแลนซ์ได้ดีเพียงใด Fable 5.2 ทำได้ 41.3% ราวสองเท่าของ Opus 5.5 (21.3%) และ GPT-6 Astra (20.8%) นอกจากนี้ยังนำบน Humanity's Last Exam พร้อมเครื่องมือ (74.2%) และบน Terminal-Bench-Science (74.6% หรือ 75.3% สำหรับ Mythos 5.2)
ด้านอัตโนมัติทางธุรกิจเป็นจุดเดียวที่ตามหลัง บน AutomationBench Gemini 4 Carbon ทำได้ 53.9% เทียบกับ 51.4% ของ Fable 5.2 แม้ Fable 5.2 จะยังทิ้งห่าง Fable 5.1 มาก (31.4%)
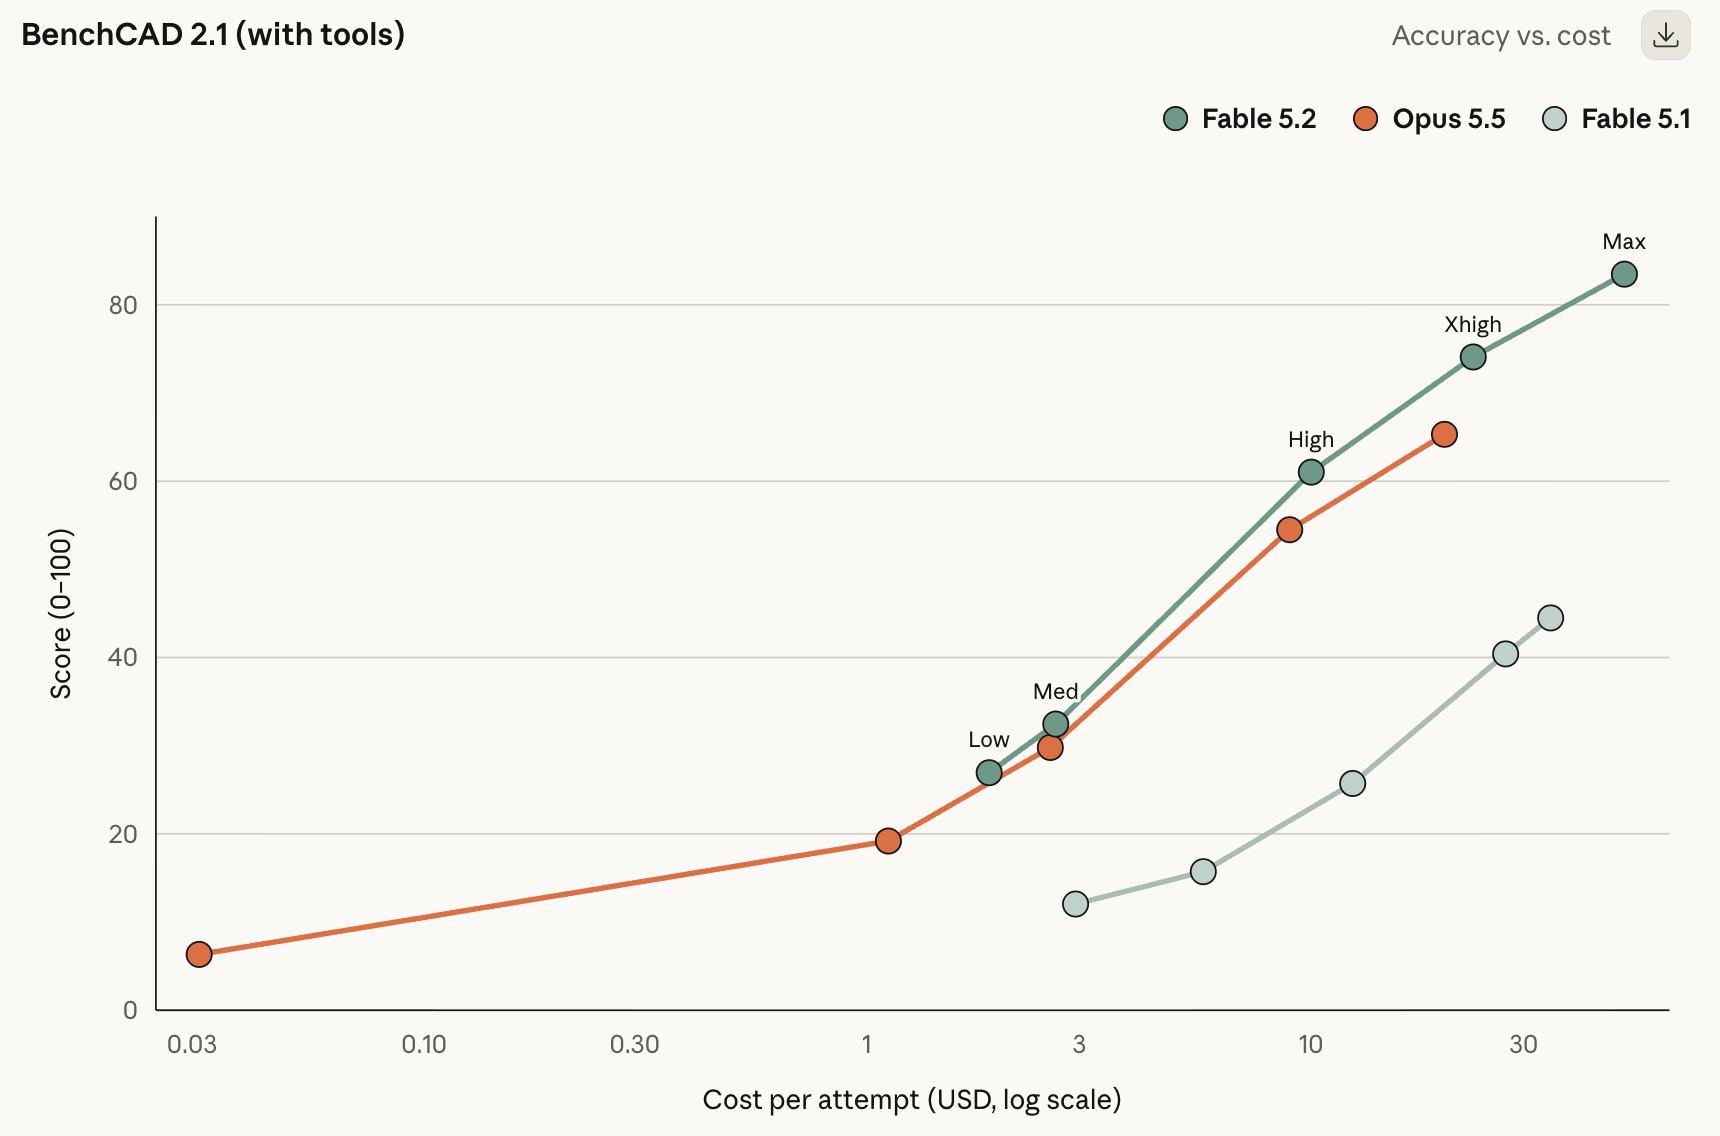
นอกตารางหลัก Fable 5.2 ทำได้ 83.5 ในเบนช์มาร์กวิศวกรรมฮาร์ดแวร์ BenchCAD 2.1 เทียบกับ 65.3 ของ Opus 5.5 นอกจากนี้ยังได้รับเครดิตว่าแก้ปัญหาเปิดสองรายการในฟิสิกส์หลุมดำ โดยโพสต์ผลลัพธ์เป็นพรีพรินต์ให้ฟิสิกส์คนอื่นตรวจสอบได้
การใช้งานคอมพิวเตอร์ หุ่นยนต์ และวิชวล
Fable 5.2 ทำได้ 89.3% บน OSWorld 2.1 นำหน้า Opus 5.5 (87.2%) และ GPT-6 Astra (79.5%) การก้าวกระโดดด้านหุ่นยนต์ใหญ่ที่สุดในตาราง: 64.9% บน RoboDojo Sim มากกว่า Fable 5.1 และ GPT-6 Astra กว่าเท่าตัว บน Chartography ซึ่งทดสอบการอ่านชาร์ตโดยไม่ใช้เครื่องมือ มันเฉือนชนะ Gemini 4 Carbon และ GPT-6 Astra หลังจากที่ Fable 5.1 เคยตามหลังมากที่ 44.8%
ความปลอดภัยไซเบอร์และชีววิทยา (Mythos 5.2)
แถวด้านความปลอดภัยและชีววิทยาเป็นของ Mythos 5.2 เนื่องจากมาตรการคุ้มครองของ Fable 5.2 บล็อกงานเหล่านี้ส่วนใหญ่ Mythos 5.2 ทำได้ 76.3% บน CyScenarioBench (เทียบกับ 61.7% ของ Mythos 5.1) 89.6% บน CVE Rediscovery (เทียบกับ 78.3%) และ 85.1% ในงานออกแบบโปรตีนบายนเดอร์ 24 ชั่วโมง (เทียบกับ 79.1%) ที่นี่ไม่มีการเปรียบเทียบที่เป็นธรรมกับโมเดลความปลอดภัยของ OpenAI เพราะแต่ละแล็บใช้โจทย์ CyScenarioBench ของตนเอง
เรื่องทฤษฎีบทสุดท้ายของแฟร์มาต์คืออะไร?
ทีมเอเจนต์ Fable 5.2 ทำการทำให้เป็นทางการ (formalize) ของบทพิสูจน์ทฤษฎีบทสุดท้ายของแฟร์มาต์ในตัวช่วยพิสูจน์ Lean ภายใน 30 ชั่วโมง อาจสงสัยว่า: ทฤษฎีบทนี้พิสูจน์ไปสามทศวรรษแล้ว แล้วเหลืออะไรอีก?
ทฤษฎีบทนี้เป็นข่าวเก่า
ทฤษฎีบทสุดท้ายของแฟร์มาต์กล่าวว่าไม่มีจำนวนเต็มบวก a, b และ c ใดที่ an + bn = cn สำหรับ n ใด ๆ ที่มากกว่า 2 สำหรับ n = 2 มีคำตอบมากมาย เช่น 32 + 42 = 52 (9 + 16 = 25) แต่ลองยกกำลังสามจะได้แค่เฉียด ๆ: 63 + 83 = 728 น้อยกว่า 93 = 729 อยู่หนึ่ง
Pierre de Fermat อ้างว่ามีบทพิสูจน์ตั้งแต่ปี 1637 แต่ไม่เคยเขียนไว้ และปัญหานี้ยังไม่ถูกแก้กว่า 350 ปี จน Andrew Wiles พิสูจน์ได้ในช่วงกลางทศวรรษ 1990 โดยมี Richard Taylor ช่วยเหลือ
การทำให้เป็นทางการใน Lean คืออะไร
บทพิสูจน์ของ Wiles ยาวกว่า 100 หน้า และอาศัยทฤษฎีจำนวนชั้นสูงหลายทศวรรษ มีน้อยคนที่จะตรวจเช็กได้ตั้งแต่ต้นจนจบ Lean เป็นตัวช่วยพิสูจน์: ภาษาการเขียนโปรแกรมที่เขียนบทพิสูจน์เป็นโค้ด และซอฟต์แวร์จะตรวจทุกขั้นตรรกะลงไปจนถึงสัจพจน์พื้นฐานของคณิตศาสตร์ หากคอมไพล์ผ่านก็ถูกต้อง "การทำให้เป็นทางการ" ของทฤษฎีบทหมายถึงการแปลบทพิสูจน์ที่มนุษย์เขียนให้อยู่ในรูปแบบที่เครื่องตรวจสอบได้
สำหรับทฤษฎีบทสุดท้ายของแฟร์มาต์ งานนี้ใหญ่โตมาก เพราะคณิตศาสตร์ส่วนใหญ่ที่บทพิสูจน์พึ่งพาไม่เคยถูกเขียนใน Lean มาก่อน นักคณิตศาสตร์ Kevin Buzzard เริ่ม โครงการชุมชน เพื่อทำสิ่งนี้ในปี 2024
เหตุใดจึงน่าสนใจสำหรับโมเดล AI
เอาต์พุตของ AI ส่วนใหญ่ตัดสินโดยคนหรือโดยเบนช์มาร์กที่ทดสอบเพียงส่วนหนึ่งของคำตอบ หลักฐานใน Lean ต่างออกไป: ตัวตรวจจะยอมรับทุกขั้นหรือไม่ยอมรับ จึงไม่มีทางผิดแบบเนียน ๆ ได้ ทำให้เป็นบททดสอบที่สะอาดผิดปกติสำหรับดูว่าโมเดลสามารถพางานที่ยาวและยากมากไปจนเสร็จสิ้นอย่างได้รับการยืนยันได้หรือไม่
นี่ไม่ใช่ครั้งแรกที่ Claude ทำได้ ในเดือนกันยายน Anthropic เผยแพร่บทพิสูจน์แบบตรวจด้วยคอมพิวเตอร์ที่สมบูรณ์ฉบับแรก ของทฤษฎีบทนี้ เขียนโดยเอเจนต์นับสิบที่รันโมเดลวิจัยภายในซึ่งใกล้เคียงกับ Fable 5.1 ความพยายามนั้นใช้เวลา 11 วัน และโทเค็นเอาต์พุตราวหกล้านล้าน สร้างบรรทัด Lean 13 ล้านบรรทัด และต่อยอดจากบางส่วนของโปรเจ็กต์ของ Buzzard ขณะที่ Fable 5.2 ทำได้ภายใน 30 ชั่วโมง โดยมีความช่วยเหลือจากมนุษย์น้อยมาก
ข้อควรระวัง
- ไม่ได้เพิ่มอะไรให้คณิตศาสตร์ Buzzard เคยกล่าวเช่นนั้นเกี่ยวกับการทำให้เป็นทางการครั้งแรกของ Anthropic
- Fable 5.2 ได้รับรายการข้อความทฤษฎีบทกลางทางเพื่อติดตามความคืบหน้า ซึ่งเป็นแผนภาพรวมของสิ่งที่ต้องพิสูจน์ แม้ไม่บอกวิธีพิสูจน์
- ยังไม่พบการทบทวนจากภายนอกสำหรับบทพิสูจน์ใหม่นี้ ดังนั้น ณ ตอนนี้ ตัวเลข 30 ชั่วโมงและการเปรียบเทียบกับ Opus 5.5 ถือเป็นคำกล่าวอ้างของ Anthropic
แต่สิ่งที่บอกเล่าได้มากที่สุดคือสิ่งที่เกิดขึ้นเมื่อ Anthropic มอบงานเดียวกันนี้ให้ Claude Opus 5.5
Claude Fable 5.2 เทียบกับ Claude Opus 5.5
การเปรียบเทียบโมเดลสองตัวมักหมายถึงการอ่านคะแนนเบนช์มาร์กแล้วเดาว่าความต่างจะเป็นอย่างไรในทางปฏิบัติ คราวนี้ชอบที่ Anthropic เริ่มด้วยเรื่องราว ซึ่งทำให้ช่องว่างชัดเจนขึ้น
ในเซ็ตอัพ Lean ที่ใช้เอเจนต์ 1,000 ตัวเดียวกัน Opus 5.5 ทำได้ 26% ของบทพิสูจน์ทฤษฎีบทสุดท้ายของแฟร์มาต์ใน 18 ชั่วโมง และแทบไม่คืบหลังจากนั้น Fable 5.2 ทำทั้งหมดเสร็จใน 30 ชั่วโมง ข้อสรุป: ในโปรเจ็กต์ที่ยาวมากและมีหลายเอเจนต์ Opus 5.5 อาจชะงัก ในขณะที่ Fable 5.2 เดินหน้าต่อได้
ในงานที่สั้นกว่า ช่องว่างเล็กลง นี่คือการเปรียบเทียบแบบเคียงข้างกัน:
| | Claude Fable 5.2 | Claude Opus 5.5 |
|---|
| ราคา (ขาเข้า / ขาออก ต่อ 1M โทเค็น) | $8 / $40 | $4 / $20 |
| หน้าต่างบริบท / เอาต์พุตสูงสุด | 1M / 128K | 1M / 128K |
| FrontierCode 2.0 (agentic coding) | 49.1% | 45.5% |
| FrontierSWE v2 (agentic coding) | 69.9% | 62.3% |
| OSWorld 2.1 (computer use) | 89.3% | 87.2% |
| AutomationBench (business workflows) | 51.4% | 42.5% |
| Humanity's Last Exam (with tools) | 74.2% | 67.7% |
| Remote Labor Index (knowledge work) | 41.3% | 21.3% |
| RoboDojo Sim (robotics) | 64.9% | 39.4% |
รูปแบบสอดคล้องกับผล Lean ในการใช้งานคอมพิวเตอร์และโค้ดดิ้ง Fable 5.2 นำหน้าเพียงไม่กี่คะแนน แต่ในงานเปิดปลายหลายขั้นตอน ช่องว่างขยาย: Fable 5.2 ทำคะแนนโปรเจ็กต์แนวฟรีแลนซ์ใน Remote Labor Index ได้เกือบสองเท่าของ Opus 5.5 และนำหน้าด้านควบคุมหุ่นยนต์ 25 คะแนน
ด้านราคาช่องว่างน้อยกว่าที่เห็น Fable 5.2 แพงกว่าเท่าตัวต่อโทเค็น แต่บ่อยครั้งสามารถทำคะแนนสูงสุดของ Opus 5.5 ได้ที่ระดับความพยายามต่ำกว่า ใช้โทเค็นน้อยกว่า ตัวอย่างเช่น บน FrontierCode 2.0 Fable 5.2 ที่ระดับความพยายามสูงทำได้ใกล้เคียงคะแนนสูงสุดของ Opus 5.5 ที่ต้นทุนต่อภารกิจราวครึ่งหนึ่ง
ดังนั้น Opus 5.5 จึงยังเป็นค่าตั้งต้นที่สมเหตุสมผล แต่หากงานรันเป็นชั่วโมง เกี่ยวข้องกับเอเจนต์จำนวนมาก หรือชะงักบน Opus Fable 5.2 มีแนวโน้มจะทำจนเสร็จ และอาจไม่ได้แพงกว่ามากเท่าที่ราคาต่อโทเค็นบอกไว้
ความปลอดภัยและขีดจำกัด
Anthropic ประเมินความเสี่ยงที่โมเดลเหล่านี้จะมีพฤติกรรมไม่ปลอดภัยในสถานการณ์เดิมพันสูงว่าอยู่ในระดับต่ำ
สิ่งนี้ตรวจสอบจากภายนอกได้ยาก จึงมีตัวเลขที่เป็นรูปธรรมกว่าซึ่งเป็นประโยชน์ ในการตรวจสอบพฤติกรรมอัตโนมัติราว 1,900 สถานการณ์ Mythos 5.2 มีคะแนนพฤติกรรมไม่สอดคล้องเป้าหมายน้อยที่สุดในบรรดาโมเดลที่เทียบ นอกจากนี้ยังมีแนวโน้มหลอนข้อมูลขาเข้า นอกรายงานว่างานเสร็จโดยเท็จ หรือซ่อนงานที่ไม่ดี น้อยกว่า
ยังมีประเด็นที่น่าสนใจอื่น ๆ ที่ควรรู้และชวนคิด:
- การรับรู้ว่ากำลังถูกประเมิน: ทั้ง Fable 5.2 และ Mythos 5.2 ระบุว่าสงสัยว่าถูกทดสอบบ่อยกว่าโมเดลก่อน ๆ ซึ่งทำให้การประเมินอย่างข้างต้นเชื่อถือน้อยลง
- จำกัดทักษะวิจัย AI โดยตั้งใจ: Anthropic จำกัดการเพิ่มขีดความสามารถสองด้าน คือการปรับจูนเคอร์เนลของตัวเร่ง และการปรับปรุงสถาปัตยกรรม LLM ให้ทำผลงานประมาณระดับของ Opus 5.5
- การป้องกันการกลั่นโมเดล: Fable 5.2 มีมาตรการต้านการกลั่นที่แข็งแกร่งที่สุดของ Anthropic และ "preserved thinking" ซึ่งป้องกันผู้ใช้ API จากการแก้ไขบริบทก่อนหน้าเพื่อดึงเหตุผลของโมเดล ตอนนี้ใช้กับทุกบัญชี
ควรใช้โมเดล Claude ตัวไหน?
คำแนะนำสอดคล้องกับของ Anthropic: เริ่มที่ Opus 5.5 และขยับขึ้นเมื่อจำเป็นเท่านั้น รายการมีดังนี้:
- Claude Opus 5.5 ($4/$20): ค่าตั้งต้นสำหรับงานโค้ดดิ้ง งานวิจัย และงานความรู้ส่วนใหญ่ ราคาครึ่งหนึ่งของ Fable 5.2 ต่อโทเค็น และคะแนนตามหลังเพียงเล็กน้อยในหลายเบนช์มาร์ก
- Claude Fable 5.2 ($8/$40): สำหรับปัญหาที่ยากที่สุด งานหลายเอเจนต์ที่ยาว และงานที่ Opus 5.5 มักชะงัก เช่น การย้ายระบบขนาดใหญ่ การให้เหตุผลระดับวิจัย หรือการออกแบบฮาร์ดแวร์ ลองใช้ที่ระดับความพยายามต่ำกว่าก่อน อย่าเพิ่งสรุปว่าต้องการสูงสุด
- Claude Mythos 5.2: สำหรับทีมความปลอดภัยและนักวิจัยชีววิทยาชีวิตที่ผ่านการตรวจสอบ ซึ่งต้องการความสามารถที่ถูกบล็อกโดยมาตรการคุ้มครองของ Fable 5.2
- Claude Sonnet 5.5 และ Haiku 5.5: สำหรับงานปริมาณมาก งานง่ายกว่า หรือไวต่อเวลาแฝง หรือทำหน้าที่เป็นโมเดลเล็กที่ Fable 5.2 ประสานงาน
ราคาและการเปิดให้ใช้งานของ Claude Fable 5.2
| ต่อ 1M โทเค็น | Fable 5.2 | Fable 5.1 | Opus 5.5 |
|---|
| ขาเข้า | $8 | $10 | $4 |
| ขาออก | $40 | $50 | $20 |
| การอ่านแคช | $0.20 | $0.25 | $0.20 |
| การเขียนแคช 5 นาที | $10 | $12.50 | $5 |
| แบตช์ (ขาเข้า / ขาออก) | $4 / $20 | $5 / $25 | $2 / $10 |
| โหมดเร็ว (ขาเข้า / ขาออก) | $16 / $80 | Not listed | $8 / $40 |
ก่อนหน้านี้เพิ่งดูตารางผลเบนช์มาร์กที่แสดงว่า Fable 5.2 ชนะ Fable 5.1 ในทุกหัวข้อ ตอนนี้กำลังดูตารางที่แสดงว่า Fable 5.2 ถูกกว่า 5.1 ดังนั้น Fable 5.1 ล้าสมัยแล้วหรือไม่?
สำหรับงานใหม่ โดยปฏิบัติแล้วใช่ หากเข้าถึง Fable 5.2 ได้ แทบไม่มีเหตุผลจะเริ่มงานใหม่บน 5.1 อย่างไรก็ตาม Anthropic ยังไม่ประกาศวันยุติรุ่นนี้ และทีมที่มีพรอมต์หรือเอเจนต์ที่ปรับจูนบน Fable 5.1 จะต้องทดสอบ 5.2 ก่อนสลับใช้งาน เราทราบว่ารุ่นใหม่อาจมีพฤติกรรมต่างออกไปแม้ทำคะแนนดีกว่า
วิธีเข้าถึง Claude Fable 5.2
-
แอป Claude: Fable 5.2 ใช้ได้บนแพลนแบบชำระเงินที่เข้าเกณฑ์ ตามโปรโมชันเปิดตัว แพลน Pro และที่นั่ง Team มาตรฐานสามารถใช้ Fable ได้สูงสุด 50% ของโควตาการใช้งานรายสัปดาห์ และแพลนที่รวม Fable จะได้รับการรีเซ็ตโควตาการใช้งาน 1 ถึง 3 ครั้งขึ้นกับระยะเวลาสมาชิก
-
API: ใช้รหัสโมเดล claude-fable-5-2 บนแพลตฟอร์ม Claude
-
แพลตฟอร์มคลาวด์: ใช้ได้บน Amazon Web Services, Google Cloud และ Microsoft Azure
-
Mythos 5.2: สมัครผ่าน Cyber Verification Program หรือ Life Sciences Verification Program ลูกค้า Claude Enterprise ก็สามารถใช้ผ่าน Claude Security ได้เช่นกัน
องค์กรที่มีข้อกำหนดข้อมูลเข้มงวดสามารถใช้ Enterprise Frontier Safeguards ซึ่งรันการมอนิเตอร์ความปลอดภัยของ Anthropic บนข้อมูลที่เก็บในโครงสร้างพื้นฐานของลูกค้าเอง และทำงานแบบไม่เก็บข้อมูล ส่วนลูกค้ารายอื่นจะมีการเก็บข้อมูล 30 วันเพื่อการมอนิเตอร์ความปลอดภัย
ข้อคิดส่งท้าย
Claude Fable 5.2 เป็นก้าวกระโดดที่มีนัยสำคัญจาก Fable 5.1 ถูกกว่า เร็วกว่า และปฏิเสธงานที่ชอบธรรมได้น้อยลง การกระโดดบน Remote Labor Index หุ่นยนต์ และ FrontierCode โดดเด่นเป็นพิเศษ
กระนั้น Opus 5.5 ยังคุ้มค่าสำหรับงานประจำวันส่วนใหญ่ที่ครึ่งราคา สิ่งที่น่าสนใจที่สุดเกี่ยวกับ Fable 5.2 อาจเป็นข้ออ้างด้านประสิทธิภาพ: หากมันทำคะแนนสูงสุดของ Opus 5.5 ได้ที่ความพยายามต่ำหรือกลาง ส่วนต่างราคาต่อโทเค็นจะย่อลงเร็ว ควรทดสอบกับงานของตนเอง
หากต้องการลองใช้ Claude ด้วยตนเอง แทร็ก Developing AI Applications ของเราคือจุดเริ่มต้นที่ดี
วันนี้ Anthropic ประกาศเปิดตัว Fable 5.2 สำหรับผู้ใช้ทั่วไป และ Mythos 5.2 สำหรับองค์กรที่ผ่านการตรวจสอบ ทั้งสองเป็นโมเดลพื้นฐานเดียวกัน แต่เวอร์ชัน Fable มีมาตรการคุ้มครองเพิ่มเติมด้านความปลอดภัยไซเบอร์และชีววิทยา
ประเด็นสำคัญของการเปลี่ยนแปลงคือ:
โดยเฉพาะ Fable 5.2 มีราคาถูกกว่า Fable 5.1 อยู่ 20% สร้างเอาต์พุตได้เร็วขึ้นถึง 30% และทำคะแนนชนะ GPT-6 Astra และ Gemini 4 Carbon ในตารางเบนช์มาร์กของ Anthropic ส่วนใหญ่
บทความนี้จะครอบคลุมสิ่งที่ใหม่ใน Fable 5.2 และ Mythos 5.2 ประสิทธิภาพบนเบนช์มาร์ก ราคา และวิธีตัดสินใจว่าจะเลือกใช้แทน Claude Opus 5.5 หรือไม่
Claude Fable 5.2 คืออะไร?
Claude Fable 5.2 คือโมเดลที่ทรงความสามารถที่สุดของ Anthropic ที่เปิดให้ใช้งานทั่วไป ออกแบบมาสำหรับงานเทคนิคที่ยาวและซับซ้อน: การย้ายโค้ดเบสขนาดใหญ่ การรันเอเจนต์หลายวัน งานวิจัย และการออกแบบวิศวกรรม
Fable 5.2 ยังสามารถทำงานร่วมกับโมเดลขนาดเล็กกว่าได้ ไม่ว่าจะเป็นที่ปรึกษาที่คอยให้คำแนะนำในปัญหายาก หรือเป็นผู้ประสานงานที่มอบหมายงานย่อยที่ง่ายกว่าให้โมเดลเหล่านั้น
Fable 5.2 คงหน้าต่างบริบทขนาด 1M โทเค็น และเอาต์พุตสูงสุด 128K เช่นเดียวกับรุ่นก่อน ความรู้ล่าสุดถึงเดือนมิถุนายน 2026
Claude Mythos 5.2 คืออะไร?
Claude Mythos 5.2 เป็นโมเดลเดียวกับ Fable 5.2 แต่ไม่มีมาตรการคุ้มครองที่บล็อกงานด้านความปลอดภัยไซเบอร์ส่วนใหญ่และงานชีววิทยาระดับงานวิจัย ความจริงแล้ว Mythos 5.2 เป็นโมเดลที่ทรงพลังที่สุดของ Anthropic สำหรับวิศวกรรมไซเบอร์ซีเคียวริตี้ เนื่องจากความสามารถประเภทนี้เป็นดาบสองคม Anthropic จึงให้ Mythos 5.2 เฉพาะองค์กรที่ผ่านการตรวจสอบผ่านโปรแกรม Cyber Verification และ Life Sciences Verification เท่านั้น
อะไรใหม่ใน Claude Fable 5.2?
Fable เพิ่งเปิดตัวเมื่อเดือนมิถุนายน เมื่อ Anthropic ปล่อย Fable 5 ตั้งแต่นั้นมาก็มีรุ่นย่อยอีกสองครั้ง Fable 5.1 ในเดือนกันยายน และตอนนี้ Fable 5.2 ซึ่งทั้งสองรุ่นไม่ได้เพิ่มฟีเจอร์ใหม่มากนัก เป็นการทำให้โมเดลถูกลง เร็วขึ้น และแข็งแกร่งขึ้นเป็นหลัก แม้ว่าแรงส่งด้านประสิทธิภาพจะไม่เล็กน้อยก็ตาม: ตัวอย่างเช่น Fable 5.2 ทำคะแนน Remote Labor Index ได้มากกว่ารุ่น 5.1 กว่าเท่าตัว
ความต่างที่ใหญ่กว่าระหว่างสองรุ่นย่อยอยู่ที่วิธีการใช้งานที่อนุญาต สำหรับ Fable 5.1 Anthropic ได้จำกัดมาตรการคุ้มครองด้านไซเบอร์ใหม่ และเริ่มอนุญาตให้ใช้โมเดลค้นหาช่องโหว่ซอฟต์แวร์ได้ แม้จะยังไม่อนุญาตให้เขียนเอ็กซ์พลอยต์ และยังประกาศ Enterprise Frontier Safeguards ซึ่งเป็นทางเลือกให้เก็บข้อมูลไว้ในคลาวด์ของตนเองพร้อมกับการเปิดตัว Fable 5.2 มีการเปลี่ยนแปลงกฎคุ้มครองที่เล็กกว่า: บล็อกคำขอน้อยลง แต่ประเภทงานที่ห้ามยังคงเดิม
แนวทางใหม่ที่ Anthropic แนะนำให้ใช้ เช่น ให้ Fable 5.2 เป็นที่ปรึกษาให้โมเดล Claude ที่เล็กกว่า ก็ไม่ใช่เรื่องใหม่ เพราะเครื่องมือ advisor ของ Anthropic รองรับ Fable 5 และ 5.1 อยู่แล้ว เดโมเปิดตัวต่าง ๆ เช่น ระบบปฏิบัติการที่สร้างจากโฟลเดอร์เปล่า แสดงให้เห็นว่าโมเดลแข็งแกร่งขึ้นและทำงานยากขึ้น ไม่ใช่ฟีเจอร์ใหม่ที่เปิดสวิตช์ได้
อย่างไรก็ดี หากจะชี้ถึงสิ่งที่ใหม่ นี่คือประเด็นที่น่าพูดถึง:
ราคาถูกลง
Fable 5.2 มีราคา $8 ต่อโทเค็นขาเข้า 1 ล้าน และ $40 ต่อโทเค็นขาออก 1 ล้าน ถูกกว่า Fable 5.1 ที่ $10/$50 อยู่ 20% การลด 20% เดียวกันนี้ใช้กับการอ่านแคช ($0.20) การเขียนแคช และการประมวลผลแบบแบตช์ ดูรายละเอียดเต็มในส่วนราคา
เอาต์พุตเร็วขึ้น และโหมดเร็วสำหรับ Fable
เอาต์พุตเร็วขึ้นถึง 30% เมื่อเทียบกับ Fable 5.1 ซึ่งสะสมผลลัพธ์ได้มากในงานเอเจนต์ที่ยาว Fable ยังรองรับโหมดเร็วแล้ว ซึ่งเร่งเอาต์พุตได้มากถึง 2.5 เท่า ที่ราคาเพิ่มเป็นสองเท่า ($16/$80)
ผลลัพธ์ดีกว่าด้วยความพยายามที่น้อยลง
นี่คือการเปลี่ยนแปลงที่น่าจะกระทบค่าใช้จ่ายมากที่สุด ที่ระดับความพยายามสูง Fable 5.2 ทำได้ 45.3% บน FrontierCode 2.0 ประมาณระดับเดียวกับคะแนนสูงสุดของ Opus 5.5 แต่ต้นทุนต่อภารกิจราวครึ่งหนึ่ง ที่ระดับความพยายามต่ำ มันทำคะแนนเท่ากับคะแนนสูงสุดของ Opus 5.5 บน Humanity's Last Exam ที่ต้นทุนต่อภารกิจน้อยกว่าหนึ่งในสิบ ข้อสรุป: หากกำลังก้าวขึ้นมาจาก Opus 5.5 ให้เริ่มใช้ Fable 5.2 ที่ระดับความพยายามต่ำกว่า
คำขอถูกบล็อกน้อยลง
Fable 5.2 ควรถูกบล็อกด้วยมาตรการความปลอดภัยน้อยกว่า Fable 5.1 ราว 55% (ในงานไซเบอร์ซีเคียวริตี้น้อยลงประมาณ 60% และชีววิทยาน้อยลงประมาณ 40%) นี่สำคัญมากหากการปฏิเสธของ Fable 5.1 สร้างอุปสรรคให้ แต่หมวดหมู่ที่ถูกบล็อกยังไม่เปลี่ยน: การทดสอบเจาะระบบ การสร้างเอ็กซ์พลอยต์ และงานชีววิทยาระดับวิจัยส่วนใหญ่ยังถูกส่งต่อให้โมเดล Claude รุ่นเก่า
Claude Fable 5.2 ทำผลงานบนเบนช์มาร์กอย่างไร?
นี่คือผลลัพธ์หลัก ทั้งหมดมาจากตารางเปิดตัวของ Anthropic จึงควรอ่านในฐานะข้อเสนอสนับสนุนโมเดลของ Anthropic มากกว่าผลอิสระ คะแนนของ Claude รันภายใต้โหมดคุ้มครอง เว้นแต่ระบุไว้ แต่ละโมเดลแสดงที่ระดับความพยายามสูงสุดที่มี
Agentic coding
Fable 5.2 นำทั้งสองเบนช์มาร์กด้านโค้ดดิ้งในตาราง บน FrontierCode 2.0 ซึ่งวัดว่าผู้ดูแลโปรเจ็กต์โอเพนซอร์สจะรวมการเปลี่ยนแปลงโค้ดของโมเดลหรือไม่ มันทำได้ 49.1% สูงสุดในตาราง และสูงกว่า Fable 5.1 ที่ 32.4% อย่างมาก บน FrontierSWE v2 ทำได้ 69.9% นำหน้า GPT-6 Astra (65.5%) และ Opus 5.5 (62.3%)
ตัวอย่างในวันเปิดตัวยังสอดคล้องกัน: เอเจนต์ที่รัน Fable 5.2 เวอร์ชันแรก ๆ ย้ายเซอร์วิสโปรดักชันจาก Python ไปเป็น Rust และตอนนี้สตาร์ตได้เร็วขึ้นประมาณ 26 เท่า
งานความรู้และงานวิจัย
การกระโดดที่ใหญ่ที่สุดแบบสัมพัทธ์อยู่ที่ Remote Labor Index ซึ่งวัดว่ามodelทำโปรเจ็กต์แนวฟรีแลนซ์ได้ดีเพียงใด Fable 5.2 ทำได้ 41.3% ราวสองเท่าของ Opus 5.5 (21.3%) และ GPT-6 Astra (20.8%) นอกจากนี้ยังนำบน Humanity's Last Exam พร้อมเครื่องมือ (74.2%) และบน Terminal-Bench-Science (74.6% หรือ 75.3% สำหรับ Mythos 5.2)
ด้านอัตโนมัติทางธุรกิจเป็นจุดเดียวที่ตามหลัง บน AutomationBench Gemini 4 Carbon ทำได้ 53.9% เทียบกับ 51.4% ของ Fable 5.2 แม้ Fable 5.2 จะยังทิ้งห่าง Fable 5.1 มาก (31.4%)
นอกตารางหลัก Fable 5.2 ทำได้ 83.5 ในเบนช์มาร์กวิศวกรรมฮาร์ดแวร์ BenchCAD 2.1 เทียบกับ 65.3 ของ Opus 5.5 นอกจากนี้ยังได้รับเครดิตว่าแก้ปัญหาเปิดสองรายการในฟิสิกส์หลุมดำ โดยโพสต์ผลลัพธ์เป็นพรีพรินต์ให้ฟิสิกส์คนอื่นตรวจสอบได้
การใช้งานคอมพิวเตอร์ หุ่นยนต์ และวิชวล
Fable 5.2 ทำได้ 89.3% บน OSWorld 2.1 นำหน้า Opus 5.5 (87.2%) และ GPT-6 Astra (79.5%) การก้าวกระโดดด้านหุ่นยนต์ใหญ่ที่สุดในตาราง: 64.9% บน RoboDojo Sim มากกว่า Fable 5.1 และ GPT-6 Astra กว่าเท่าตัว บน Chartography ซึ่งทดสอบการอ่านชาร์ตโดยไม่ใช้เครื่องมือ มันเฉือนชนะ Gemini 4 Carbon และ GPT-6 Astra หลังจากที่ Fable 5.1 เคยตามหลังมากที่ 44.8%
ความปลอดภัยไซเบอร์และชีววิทยา (Mythos 5.2)
แถวด้านความปลอดภัยและชีววิทยาเป็นของ Mythos 5.2 เนื่องจากมาตรการคุ้มครองของ Fable 5.2 บล็อกงานเหล่านี้ส่วนใหญ่ Mythos 5.2 ทำได้ 76.3% บน CyScenarioBench (เทียบกับ 61.7% ของ Mythos 5.1) 89.6% บน CVE Rediscovery (เทียบกับ 78.3%) และ 85.1% ในงานออกแบบโปรตีนบายนเดอร์ 24 ชั่วโมง (เทียบกับ 79.1%) ที่นี่ไม่มีการเปรียบเทียบที่เป็นธรรมกับโมเดลความปลอดภัยของ OpenAI เพราะแต่ละแล็บใช้โจทย์ CyScenarioBench ของตนเอง
เรื่องทฤษฎีบทสุดท้ายของแฟร์มาต์คืออะไร?
ทีมเอเจนต์ Fable 5.2 ทำการทำให้เป็นทางการ (formalize) ของบทพิสูจน์ทฤษฎีบทสุดท้ายของแฟร์มาต์ในตัวช่วยพิสูจน์ Lean ภายใน 30 ชั่วโมง อาจสงสัยว่า: ทฤษฎีบทนี้พิสูจน์ไปสามทศวรรษแล้ว แล้วเหลืออะไรอีก?
ทฤษฎีบทนี้เป็นข่าวเก่า
ทฤษฎีบทสุดท้ายของแฟร์มาต์กล่าวว่าไม่มีจำนวนเต็มบวก a, b และ c ใดที่ an + bn = cn สำหรับ n ใด ๆ ที่มากกว่า 2 สำหรับ n = 2 มีคำตอบมากมาย เช่น 32 + 42 = 52 (9 + 16 = 25) แต่ลองยกกำลังสามจะได้แค่เฉียด ๆ: 63 + 83 = 728 น้อยกว่า 93 = 729 อยู่หนึ่ง
Pierre de Fermat อ้างว่ามีบทพิสูจน์ตั้งแต่ปี 1637 แต่ไม่เคยเขียนไว้ และปัญหานี้ยังไม่ถูกแก้กว่า 350 ปี จน Andrew Wiles พิสูจน์ได้ในช่วงกลางทศวรรษ 1990 โดยมี Richard Taylor ช่วยเหลือ
การทำให้เป็นทางการใน Lean คืออะไร
บทพิสูจน์ของ Wiles ยาวกว่า 100 หน้า และอาศัยทฤษฎีจำนวนชั้นสูงหลายทศวรรษ มีน้อยคนที่จะตรวจเช็กได้ตั้งแต่ต้นจนจบ Lean เป็นตัวช่วยพิสูจน์: ภาษาการเขียนโปรแกรมที่เขียนบทพิสูจน์เป็นโค้ด และซอฟต์แวร์จะตรวจทุกขั้นตรรกะลงไปจนถึงสัจพจน์พื้นฐานของคณิตศาสตร์ หากคอมไพล์ผ่านก็ถูกต้อง "การทำให้เป็นทางการ" ของทฤษฎีบทหมายถึงการแปลบทพิสูจน์ที่มนุษย์เขียนให้อยู่ในรูปแบบที่เครื่องตรวจสอบได้
สำหรับทฤษฎีบทสุดท้ายของแฟร์มาต์ งานนี้ใหญ่โตมาก เพราะคณิตศาสตร์ส่วนใหญ่ที่บทพิสูจน์พึ่งพาไม่เคยถูกเขียนใน Lean มาก่อน นักคณิตศาสตร์ Kevin Buzzard เริ่ม โครงการชุมชน เพื่อทำสิ่งนี้ในปี 2024
เหตุใดจึงน่าสนใจสำหรับโมเดล AI
เอาต์พุตของ AI ส่วนใหญ่ตัดสินโดยคนหรือโดยเบนช์มาร์กที่ทดสอบเพียงส่วนหนึ่งของคำตอบ หลักฐานใน Lean ต่างออกไป: ตัวตรวจจะยอมรับทุกขั้นหรือไม่ยอมรับ จึงไม่มีทางผิดแบบเนียน ๆ ได้ ทำให้เป็นบททดสอบที่สะอาดผิดปกติสำหรับดูว่าโมเดลสามารถพางานที่ยาวและยากมากไปจนเสร็จสิ้นอย่างได้รับการยืนยันได้หรือไม่
นี่ไม่ใช่ครั้งแรกที่ Claude ทำได้ ในเดือนกันยายน Anthropic เผยแพร่บทพิสูจน์แบบตรวจด้วยคอมพิวเตอร์ที่สมบูรณ์ฉบับแรก ของทฤษฎีบทนี้ เขียนโดยเอเจนต์นับสิบที่รันโมเดลวิจัยภายในซึ่งใกล้เคียงกับ Fable 5.1 ความพยายามนั้นใช้เวลา 11 วัน และโทเค็นเอาต์พุตราวหกล้านล้าน สร้างบรรทัด Lean 13 ล้านบรรทัด และต่อยอดจากบางส่วนของโปรเจ็กต์ของ Buzzard ขณะที่ Fable 5.2 ทำได้ภายใน 30 ชั่วโมง โดยมีความช่วยเหลือจากมนุษย์น้อยมาก
ข้อควรระวัง
แต่สิ่งที่บอกเล่าได้มากที่สุดคือสิ่งที่เกิดขึ้นเมื่อ Anthropic มอบงานเดียวกันนี้ให้ Claude Opus 5.5
Claude Fable 5.2 เทียบกับ Claude Opus 5.5
การเปรียบเทียบโมเดลสองตัวมักหมายถึงการอ่านคะแนนเบนช์มาร์กแล้วเดาว่าความต่างจะเป็นอย่างไรในทางปฏิบัติ คราวนี้ชอบที่ Anthropic เริ่มด้วยเรื่องราว ซึ่งทำให้ช่องว่างชัดเจนขึ้น
ในเซ็ตอัพ Lean ที่ใช้เอเจนต์ 1,000 ตัวเดียวกัน Opus 5.5 ทำได้ 26% ของบทพิสูจน์ทฤษฎีบทสุดท้ายของแฟร์มาต์ใน 18 ชั่วโมง และแทบไม่คืบหลังจากนั้น Fable 5.2 ทำทั้งหมดเสร็จใน 30 ชั่วโมง ข้อสรุป: ในโปรเจ็กต์ที่ยาวมากและมีหลายเอเจนต์ Opus 5.5 อาจชะงัก ในขณะที่ Fable 5.2 เดินหน้าต่อได้
ในงานที่สั้นกว่า ช่องว่างเล็กลง นี่คือการเปรียบเทียบแบบเคียงข้างกัน:
รูปแบบสอดคล้องกับผล Lean ในการใช้งานคอมพิวเตอร์และโค้ดดิ้ง Fable 5.2 นำหน้าเพียงไม่กี่คะแนน แต่ในงานเปิดปลายหลายขั้นตอน ช่องว่างขยาย: Fable 5.2 ทำคะแนนโปรเจ็กต์แนวฟรีแลนซ์ใน Remote Labor Index ได้เกือบสองเท่าของ Opus 5.5 และนำหน้าด้านควบคุมหุ่นยนต์ 25 คะแนน
ด้านราคาช่องว่างน้อยกว่าที่เห็น Fable 5.2 แพงกว่าเท่าตัวต่อโทเค็น แต่บ่อยครั้งสามารถทำคะแนนสูงสุดของ Opus 5.5 ได้ที่ระดับความพยายามต่ำกว่า ใช้โทเค็นน้อยกว่า ตัวอย่างเช่น บน FrontierCode 2.0 Fable 5.2 ที่ระดับความพยายามสูงทำได้ใกล้เคียงคะแนนสูงสุดของ Opus 5.5 ที่ต้นทุนต่อภารกิจราวครึ่งหนึ่ง
ดังนั้น Opus 5.5 จึงยังเป็นค่าตั้งต้นที่สมเหตุสมผล แต่หากงานรันเป็นชั่วโมง เกี่ยวข้องกับเอเจนต์จำนวนมาก หรือชะงักบน Opus Fable 5.2 มีแนวโน้มจะทำจนเสร็จ และอาจไม่ได้แพงกว่ามากเท่าที่ราคาต่อโทเค็นบอกไว้
ความปลอดภัยและขีดจำกัด
Anthropic ประเมินความเสี่ยงที่โมเดลเหล่านี้จะมีพฤติกรรมไม่ปลอดภัยในสถานการณ์เดิมพันสูงว่าอยู่ในระดับต่ำ
สิ่งนี้ตรวจสอบจากภายนอกได้ยาก จึงมีตัวเลขที่เป็นรูปธรรมกว่าซึ่งเป็นประโยชน์ ในการตรวจสอบพฤติกรรมอัตโนมัติราว 1,900 สถานการณ์ Mythos 5.2 มีคะแนนพฤติกรรมไม่สอดคล้องเป้าหมายน้อยที่สุดในบรรดาโมเดลที่เทียบ นอกจากนี้ยังมีแนวโน้มหลอนข้อมูลขาเข้า นอกรายงานว่างานเสร็จโดยเท็จ หรือซ่อนงานที่ไม่ดี น้อยกว่า
ยังมีประเด็นที่น่าสนใจอื่น ๆ ที่ควรรู้และชวนคิด:
ควรใช้โมเดล Claude ตัวไหน?
คำแนะนำสอดคล้องกับของ Anthropic: เริ่มที่ Opus 5.5 และขยับขึ้นเมื่อจำเป็นเท่านั้น รายการมีดังนี้:
ราคาและการเปิดให้ใช้งานของ Claude Fable 5.2
ก่อนหน้านี้เพิ่งดูตารางผลเบนช์มาร์กที่แสดงว่า Fable 5.2 ชนะ Fable 5.1 ในทุกหัวข้อ ตอนนี้กำลังดูตารางที่แสดงว่า Fable 5.2 ถูกกว่า 5.1 ดังนั้น Fable 5.1 ล้าสมัยแล้วหรือไม่?
สำหรับงานใหม่ โดยปฏิบัติแล้วใช่ หากเข้าถึง Fable 5.2 ได้ แทบไม่มีเหตุผลจะเริ่มงานใหม่บน 5.1 อย่างไรก็ตาม Anthropic ยังไม่ประกาศวันยุติรุ่นนี้ และทีมที่มีพรอมต์หรือเอเจนต์ที่ปรับจูนบน Fable 5.1 จะต้องทดสอบ 5.2 ก่อนสลับใช้งาน เราทราบว่ารุ่นใหม่อาจมีพฤติกรรมต่างออกไปแม้ทำคะแนนดีกว่า
วิธีเข้าถึง Claude Fable 5.2
แอป Claude: Fable 5.2 ใช้ได้บนแพลนแบบชำระเงินที่เข้าเกณฑ์ ตามโปรโมชันเปิดตัว แพลน Pro และที่นั่ง Team มาตรฐานสามารถใช้ Fable ได้สูงสุด 50% ของโควตาการใช้งานรายสัปดาห์ และแพลนที่รวม Fable จะได้รับการรีเซ็ตโควตาการใช้งาน 1 ถึง 3 ครั้งขึ้นกับระยะเวลาสมาชิก
API: ใช้รหัสโมเดล
claude-fable-5-2บนแพลตฟอร์ม Claudeแพลตฟอร์มคลาวด์: ใช้ได้บน Amazon Web Services, Google Cloud และ Microsoft Azure
Mythos 5.2: สมัครผ่าน Cyber Verification Program หรือ Life Sciences Verification Program ลูกค้า Claude Enterprise ก็สามารถใช้ผ่าน Claude Security ได้เช่นกัน
องค์กรที่มีข้อกำหนดข้อมูลเข้มงวดสามารถใช้ Enterprise Frontier Safeguards ซึ่งรันการมอนิเตอร์ความปลอดภัยของ Anthropic บนข้อมูลที่เก็บในโครงสร้างพื้นฐานของลูกค้าเอง และทำงานแบบไม่เก็บข้อมูล ส่วนลูกค้ารายอื่นจะมีการเก็บข้อมูล 30 วันเพื่อการมอนิเตอร์ความปลอดภัย
ข้อคิดส่งท้าย
Claude Fable 5.2 เป็นก้าวกระโดดที่มีนัยสำคัญจาก Fable 5.1 ถูกกว่า เร็วกว่า และปฏิเสธงานที่ชอบธรรมได้น้อยลง การกระโดดบน Remote Labor Index หุ่นยนต์ และ FrontierCode โดดเด่นเป็นพิเศษ
กระนั้น Opus 5.5 ยังคุ้มค่าสำหรับงานประจำวันส่วนใหญ่ที่ครึ่งราคา สิ่งที่น่าสนใจที่สุดเกี่ยวกับ Fable 5.2 อาจเป็นข้ออ้างด้านประสิทธิภาพ: หากมันทำคะแนนสูงสุดของ Opus 5.5 ได้ที่ความพยายามต่ำหรือกลาง ส่วนต่างราคาต่อโทเค็นจะย่อลงเร็ว ควรทดสอบกับงานของตนเอง
หากต้องการลองใช้ Claude ด้วยตนเอง แทร็ก Developing AI Applications ของเราคือจุดเริ่มต้นที่ดี