Anthropic は 11 月上旬に新たなフラッグシップとして Claude Fable 5.2 をリリースしました。2026 年 11 月 17 日、OpenAI はそれに応える形で新たなフロンティアモデル GPT-6.2 Astra を発表し、公開されたチャートでは多くのベンチマークで Fable 5.2 と Astra が並んでいます。
両モデルは現在、トークン単価がまったく同じに設定されています。紙の上では純粋な性能勝負ですが、実際の請求は別の物語を語り、私たちの実地テストも同様の結果になりました。
AI とデータ分野の最新情報を追うなら、週刊ニュースレター The Median の購読をおすすめします。
要点(TL;DR)
- 横綱相撲の勝者なし:GPT-6.2 Astra はプロフェッショナル業務と分析で優位、Claude Fable 5.2 はエージェント型のコーディングで優位。
- トークン単価は同じだが、Astra は消費トークンが大幅に少ないため、タスク当たりのコストはかなり安い。
- ブラインドの動画テストでは品質はほぼ互角。ただし Fable は全動画で古い事実を繰り返した。
- コーディングエージェント、コンピュータ操作、Bedrock・Vertex AI・Azure 展開には Fable を選ぶとよい。
- 文書、法務・財務業務、大量処理には Astra を選ぶとよい。
GPT-6.2 Astra とは?
GPT-6.2 Astra は OpenAI のフロンティアモデルで、2026 年 11 月に GPT-6.2 ファミリーの最上位(GPT-6.2 Sol の上位)としてリリースされました。
売りはタスク当たりコストを抑えたプロフェッショナルな出力です。テンプレートに沿うスライド、ワークブック、ドキュメントに加え、CAD やシミュレーションツールでのコンピュータ操作も掲げています。
OpenAI の発表記事で概要が説明されており、前世代を対象とした当社のGPT-6 Astra API チュートリアルでは構築方法を解説しています。
Claude Fable 5.2 とは?
Claude Fable 5.2 は Anthropic のフラッグシップモデルで、審査済みのサイバーセキュリティおよびバイオメディカル組織向けのバージョンである Claude Mythos 5.2 とともに 2026 年 11 月にリリースされました。
Anthropic は、長期の技術業務に向けたモデルとして位置づけています。エージェント型コーディング、コンピュータ操作、リサーチタスクに強く、トークンを最大 2.5 倍速で生成する高速モードも任意で用意されています。
当社のFable 5.2 ガイドで発表内容を整理し、Fable 5.2 API チュートリアルでは仮説検定エージェントの構築を実演しています。
GPT-6.2 Astra vs Claude Fable 5.2:主要比較
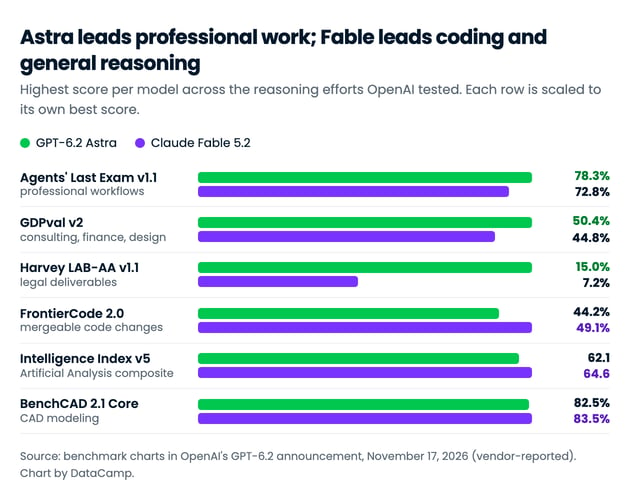
能力面は割れています。多くのベンチマーク差は数ポイント。対してコスト差は明確です。トークン単価は同じでも、同一タスクの完了に Fable はより多くのトークンを要します。
| 項目 | GPT-6.2 Astra | Claude Fable 5.2 |
|---|
| 開発元 | OpenAI | Anthropic |
| トークン単価 | Fable と同じ | Astra と同じ、キャッシュ済み入力はより安価 |
| タスク当たりコスト | 大幅に低い | OpenAI のチャートで Astra の 2.1~20.8 倍 |
| プロフェッショナル業務 | 優位(Agents' Last Exam、GDPval v2、Harvey LAB-AA) | 劣後 |
| エージェント型コーディング | 劣後 | 優位(FrontierCode 2.0) |
| 科学・CAD・推論 | 科学系ベンチマークで優位 | Intelligence Index で優位 |
| コンピュータ操作 | 同等スコアの公開なし | Anthropic 自社ベンチで高スコア |
| 当社の実地テスト | 最も正確、圧倒的に安価 | 最も一貫、ただし 1 件の古い事実 |
価格:実際に支払う金額
トークンレートはほぼ同一でも、最大の違いは価格です。差は各タスクで消費するトークン量にあります。
トークンレートの比較
| レート | GPT-6.2 Astra | Claude Fable 5.2 |
|---|
| 入力(100 万トークン当たり) | $8.00 | $8.00 |
| 出力(100 万トークン当たり) | $40.00 | $40.00 |
| キャッシュ済み入力の読み取り(100 万トークン当たり) | $0.40 | $0.20 |
| キャッシュ書き込み(100 万トークン当たり) | $10.00 | $10.00 |
| 高速モード(入力/出力、100 万トークン当たり) | $16.00 / $80.00 | $16.00 / $80.00 |
異なるのはキャッシュ済み入力のみで、Fable は Astra の半額です。これは長い固定コンテキストを繰り返し読むエージェントに有利です。OpenAI は 272K トークン超のリクエストで Astra の入力レートを倍にしていますが、Anthropic の発表には Fable の同種サーチャージは記載されていません。
実際のワークロードの費用
標準レートでの計算は、(ボリューム ÷ 100 万)× レートを入出力で合算:
| ワークロード | GPT-6.2 Astra | Claude Fable 5.2 | 差 |
|---|
| バランス型アシスタント:月間 100 万入力/25 万出力 | $18.00 | $18.00 | $0(0%) |
| キャッシュ多用のループ:10 万トークンの接頭辞を書き込み 1 回、キャッシュ読み取り 1,000 回、各リクエストで新規入力 5,000/出力 1,000 | $121.00 | $101.00 | Fable が $20 安い(17%) |
トークン数が等しければ Fable が高くなることはなく、キャッシュ多用の行は明確に安くなる唯一のケースです。ただし、ここでは「トークン数が等しい」という前提があります。
同じタスクで費用が違う理由
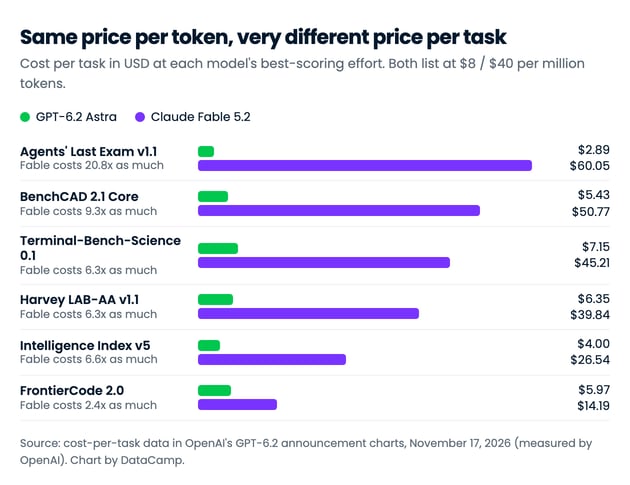
OpenAI の発表チャートには両モデルのタスク当たりコストが含まれており、Fable はすべてで高価です。Vals Science Index で 2.1 倍から、Agents' Last Exam では 20.8 倍(Astra の $2.89 に対して $60.05)まで。これは主に各モデルの最高の推論努力レベルでの比較による、OpenAI による競合測定値なので、目安として扱ってください。
原因は出力の長さです。同一レートでも、出力(推論トークンを含む)を数倍多く書くモデルは、コストも数倍になります。以下の当社テストでも同様の傾向が見られました。
プロフェッショナル業務とエージェント型ワークフロー
ここは GPT-6.2 Astra が明確にリード。すべての要件を満たした法務成果物のみが加点される Harvey LAB-AA では、Astra が 15.0% に対し Fable は 7.2% です。
| ベンチマーク | GPT-6.2 Astra | Claude Fable 5.2 | 注記 |
|---|
| Agents' Last Exam v1.1 | 78.3% | 72.8% | OpenAI のチャート;Fable は最大努力 |
| GDPval v2 | 50.4% | 44.8% | OpenAI 内部ベンチ |
| Harvey LAB-AA v1.1 | 15.0% | 7.2% | OpenAI のチャート |
| AutomationBench 1.0.6 | 52.4% | 51.4% | 両社とも Fable を 51.4% と報告 |
| Remote Labor Index | 未公開 | 41.3% | Anthropic の表(GPT-6 Astra と比較) |
クライアント向けドキュメントや分析では Astra が無難です。AutomationBench は互角で、Anthropic の Remote Labor Index の結果には GPT-6.2 の対抗値がまだありません。
エージェント型コーディング
両社が公表している唯一のベンチマークでは Fable 5.2 が強力です。FrontierCode 2.0 で 49.1%(メンテナのマージ基準を満たすかで評価)と、Astra の 44.2% を上回ります。
| ベンチマーク | GPT-6.2 Astra | Claude Fable 5.2 | 注記 |
|---|
| FrontierCode 2.0 | 44.2% | 49.1% | 両社で Fable のスコア一致 |
| FrontierSWE v2 | 未公開 | 69.9% | Anthropic の表 |
| SecureSWE | 65.7% | 未公開 | OpenAI 内部ベンチ |
OpenAI の FrontierCode チャートはトレードオフを示しています。Fable はより高いスコアに到達しますが、タスク当たりコストが大幅に高くなります。
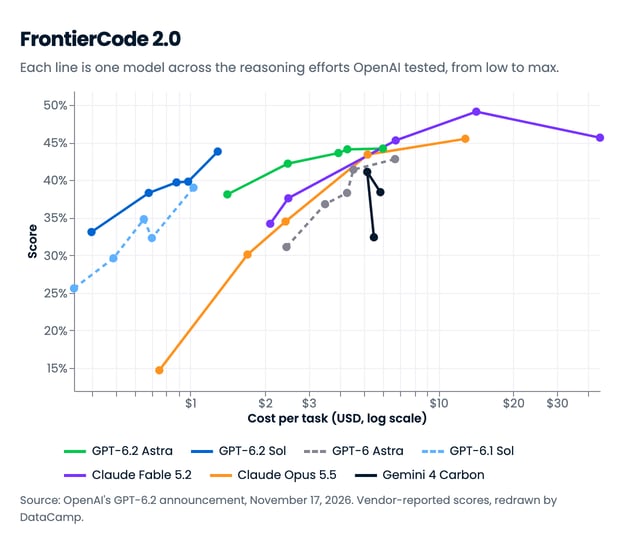
品質重視でコーディングエージェントを走らせるなら、Fable が有力です。
科学、CAD、汎用推論
ここは分かれます。GPT-6.2 Astra は科学系ベンチで優位、Fable 5.2 は広範な推論の複合指標で優位、CAD は引き分けです。
| ベンチマーク | GPT-6.2 Astra | Claude Fable 5.2 | 注記 |
|---|
| Terminal-Bench-Science 0.1 | 77.1% | 73.3% | Fable は Artificial Analysis のハーネス経由;Anthropic は Claude Code で 74.6% を報告 |
| Vals Science Index v1 | 68.4% | 63.7% | OpenAI のチャート |
| Artificial Analysis Intelligence Index v5.0.1 | 62.1 | 64.6 | 指数スコア |
| BenchCAD 2.1 Core | 82.5% | 83.5% | 実質的に同点 |
| Humanity's Last Exam(ツールあり) | 未公開 | 74.2% | Anthropic の表 |
科学分析には Astra に分があり、汎用推論は Fable に軍配。ただし複合では 3 ポイント未満の差です。
コンピュータ操作、3D、ロボティクス
Anthropic は Fable 5.2 のコンピュータ操作とロボティクスで強い結果(OSWorld 2.1 で 89.3% など)を報告していますが、OpenAI は GPT-6.2 Astra の同等スコアを公開していないため、正面比較はできません。共有されている唯一の数値は Astra に有利です。Artificial Analysis の AA-3D(ブラインドの 3D ビルドを人間が投票)では、Astra が Elo 1,318 で 1 位、Fable は 1,271 です。
デスクトップソフトを操作するエージェントが主なワークロードなら、現時点の裏付けは Fable のほうが強いと言えます。
GPT-6.2 Astra と Claude Fable 5.2 の実地検証
競合する 2 社のベンチマークだけでは不十分なので、両モデルに同じ創造的コーディング課題を、同一プロンプト・同一ツールで与えました。
課題は、Python の著名なアニメーションライブラリ Manim で、高校生向けにコラッツ予想を 60 秒で解説するスクリプトを作ること。ルール自体は単純(偶数は半分、奇数は 3 倍して 1 を足す)ですが、すべての初期値が 1 に至ることは誰も証明していません。
難しいのは、モデル自身は動画を見られない点です。スクリプトは一発でレンダリングが通り、見栄えがよく、内容が正確でなければなりません。解説動画は「もっともらしい装飾」を誘いますが、画面上の主張はすべて真である必要があります。
両モデルとも OpenCode 上で、固定のツール面(ファイルの読み取り・検索・編集のみ)を使い、同一の高い推論努力、各 1 セッションのクリーン環境で実行しました。創作ブリーフは偶然性が高いため、各モデルを 3 回ずつ走らせ、計 6 本をレンダリングしています。
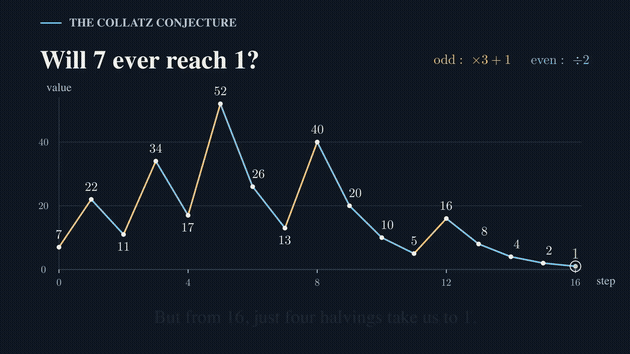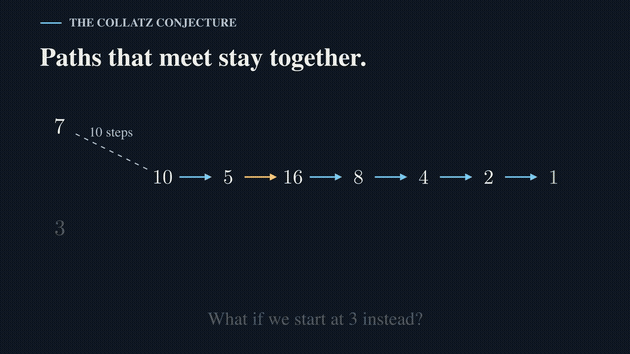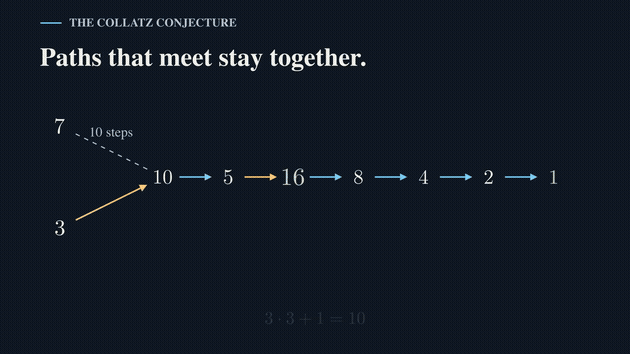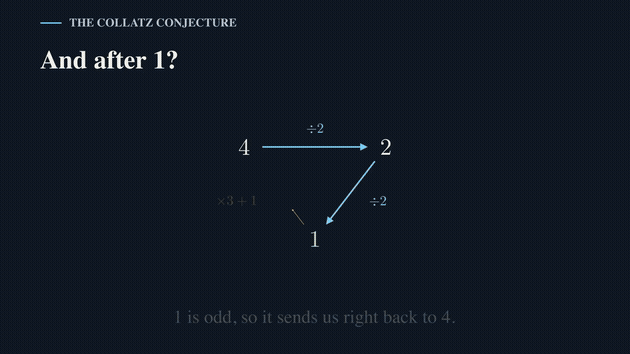
その後、動画を A~F にシャッフルしてブラインド評価し、4 つの観点で採点しました。画面上の内容がすべて真か、学習者が概念を学べるか、見ていて興味を引くか、仕上がりとして完成しているか。以下は GPT-6.2 Astra のベスト動画の一場面です。
主な結果は次のとおりです。
- 6 本すべてが一発レンダリング。すべての動画が 60 秒目標の ±3 秒に収まり、エラーや修正はありませんでした。
- 品質はほぼ互角。4 観点の平均では両モデルの差は 0.1 点程度。映像作りの一貫性は Fable が上で、3 本とも磨かれた構成を踏襲し、予想が破れる 2 つの可能性と「誰にもわからない」で締めています。
- Astra は最高作と最低作の両方を出した。最高作は 6 や 27 ではなく 7 を題材にし、異なる数から出発した経路が合流し、その後は同一の道をたどることを示すなど、他のどの動画より深いアイデアを提示。最低作は素っ気なく、遷移のたびに式が一瞬乱れます。
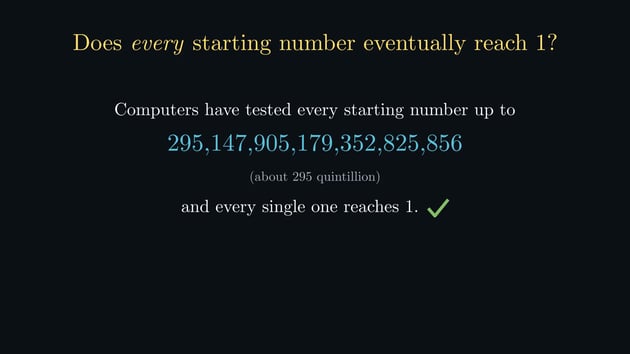
- 正確性が両者を分けた。Fable の 3 本すべての動画で「コンピュータは 2^68 までのすべての数を検証した」と主張。これは 2020 年時点の記録で、2025 年には 2^71 に更新されています。Astra の動画には裏付けのない主張はありませんでした。
以下が Fable の動画の主張です。事実としては間違いではないものの、5 年前の到達点を現状の最先端として示しており、3 回すべてで繰り返されました。
そして、Fable による 27 の長い上昇のアニメーション。工芸面で高評価だった理由がわかります。
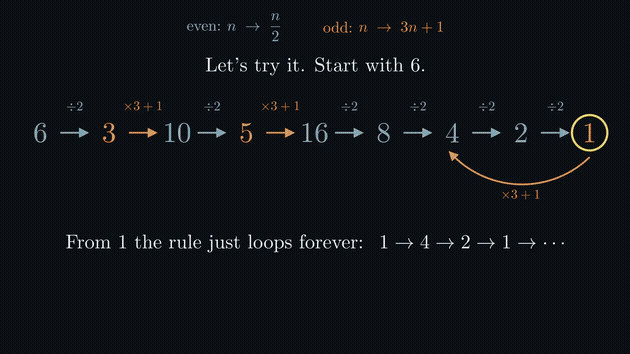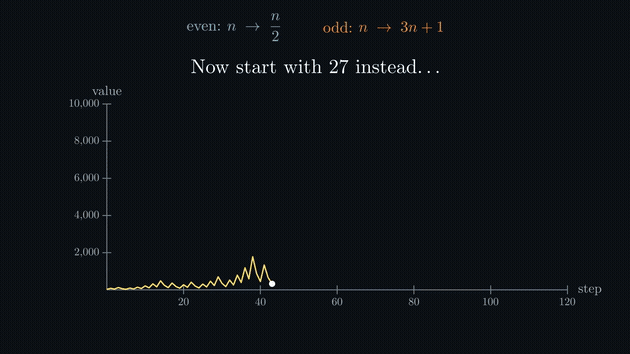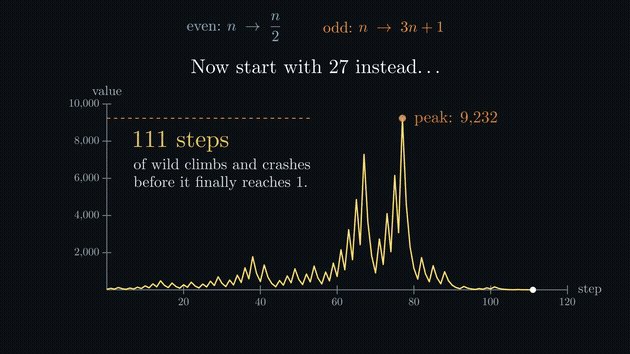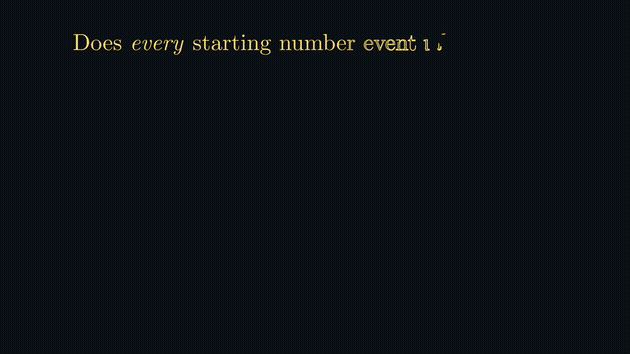
コスト差は大きく、Fable のスクリプトは 1 本あたり $3.84~$4.35、Astra は $0.40~$0.84 でした。Fable は出力(推論を含む)トークンが 4~10 倍多く、速度もかなり遅かったためです。
| 指標 | GPT-6.2 Astra | Claude Fable 5.2 |
|---|
| 各実行のコスト(USD) | $0.84, $0.61, $0.40 | $4.35, $3.84, $4.19 |
| 出力トークン(推論含む) | 17,551, 10,828, 8,124 | 84,822, 74,457, 81,316 |
| 正確性(各実行) | 5, 5, 5 | 4, 4, 4 |
| 総合評価(4 軸の平均、各実行) | 4.8, 4.8, 3.8 | 4.2, 4.8, 4.5 |
では勝者は?品質では引き分け、周辺要素では Astra。虚偽の表示なしで同等水準の動画を、コストは約 1/6 で実現。Fable の一貫性は確かですが、古い事実を自信満々に繰り返す癖も確かに見られました。
GPT-6.2 Astra と Claude Fable 5.2 を選ぶ基準
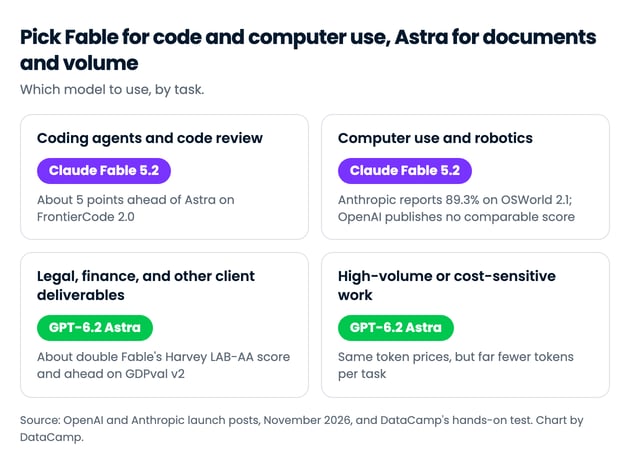
トークン単価が同じなので、判断は 2 つの問いに集約されます。タスクは Fable のコーディング/コンピュータ操作の強みを活かせるか、そしてタスク当たり数倍のトークン消費を許容できるか。
GPT-6.2 Astra を選ぶなら…
- クライアント納品向けのドキュメント、法務ドラフト、財務分析を作成する(Astra はプロ業務系ベンチで優位)。
- 大量のタスクを回す(Astra はトークン消費が少ないため、同一レートでも請求が下がる)。
- ターミナルやノートブックでの科学分析が必要(科学系ベンチでいずれも Astra が優位)。
- 創作・解説のようなオープンエンド作業での正確性を重視(当社テストに同じ)。
Claude Fable 5.2 を選ぶなら…
- 実リポジトリでコーディングエージェントを走らせる(Fable は FrontierCode 2.0 で約 5 ポイント優位)。
- エージェントがデスクトップソフトを操作する(Fable は OSWorld 2.1 で 89.3% を報告、Astra の同等スコアは未公開)。
- AWS Bedrock、Google Vertex AI、Azure AI Foundry を経由して展開する(いずれも Fable を掲載。Azure のドキュメントに Astra の記載はなく、他 2 つでも確認できませんでした)。
- 長い固定コンテキストを再利用する(Fable のキャッシュ済み入力は半額)。
GPT-6.2 Astra と Claude Fable 5.2 の始め方
| 利用面 | GPT-6.2 Astra | Claude Fable 5.2 |
|---|
| コンシューマー向けアプリ | ChatGPT Work および Codex(Plus、Pro、Enterprise、Edu) | Claude アプリ(全ユーザー利用可) |
| ファーストパーティ API | OpenAI API | Claude Platform |
| クラウドプラットフォーム | 2026 年 11 月 17 日時点の Azure AI Foundry ドキュメントに未掲載 | AWS Bedrock、Google Vertex AI、Azure AI Foundry |
| コーディングエージェント | Codex;執筆時点では Cursor および GitHub Copilot のドキュメントに未掲載 | GitHub Copilot;執筆時点では Cursor のドキュメントに未掲載 |
| サードパーティルーター | OpenRouter | OpenRouter |
| API モデル ID | gpt-6.2-astra | claude-fable-5-2 |
最大の違いはクラウドでの到達性です。Fable は 3 大クラウドすべてで利用可能ですが、Astra は OpenAI 自社の API と製品を通じてアクセスします。OpenRouter では、両者は 1 文字列の差し替えで切り替え可能です。
from openai import OpenAI
client = OpenAI(base_url="https://openrouter.ai/api/v1")
response = client.chat.completions.create(
model="openai/gpt-6.2-astra",
messages=[{"role": "user", "content": "Review this pull request..."}],
)
print(response.choices[0].message.content)提供:
フルセットアップについては、Fable 5.2 API チュートリアルとGPT-6 Astra API チュートリアルをご覧ください。
まとめ
能力面では GPT-6.2 Astra と Claude Fable 5.2 は分野ごとに勝敗が分かれます。プロフェッショナル業務と分析は Astra、コーディングとコンピュータ操作は Fable。
コスト面では、Astra がほぼ常に優位です。トークン単価が同じでも、消費量の差が大きいためです。
Anthropic のモデルでの構築に関心がある場合は、当社のIntroduction to Claude Models コースをどうぞ。OpenAI に関心があるなら、Working with the OpenAI API をお試しください。
Anthropic は 11 月上旬に新たなフラッグシップとして Claude Fable 5.2 をリリースしました。2026 年 11 月 17 日、OpenAI はそれに応える形で新たなフロンティアモデル GPT-6.2 Astra を発表し、公開されたチャートでは多くのベンチマークで Fable 5.2 と Astra が並んでいます。
両モデルは現在、トークン単価がまったく同じに設定されています。紙の上では純粋な性能勝負ですが、実際の請求は別の物語を語り、私たちの実地テストも同様の結果になりました。
AI とデータ分野の最新情報を追うなら、週刊ニュースレター The Median の購読をおすすめします。
要点(TL;DR)
GPT-6.2 Astra とは?
GPT-6.2 Astra は OpenAI のフロンティアモデルで、2026 年 11 月に GPT-6.2 ファミリーの最上位(GPT-6.2 Sol の上位)としてリリースされました。
売りはタスク当たりコストを抑えたプロフェッショナルな出力です。テンプレートに沿うスライド、ワークブック、ドキュメントに加え、CAD やシミュレーションツールでのコンピュータ操作も掲げています。
OpenAI の発表記事で概要が説明されており、前世代を対象とした当社のGPT-6 Astra API チュートリアルでは構築方法を解説しています。
Claude Fable 5.2 とは?
Claude Fable 5.2 は Anthropic のフラッグシップモデルで、審査済みのサイバーセキュリティおよびバイオメディカル組織向けのバージョンである Claude Mythos 5.2 とともに 2026 年 11 月にリリースされました。
Anthropic は、長期の技術業務に向けたモデルとして位置づけています。エージェント型コーディング、コンピュータ操作、リサーチタスクに強く、トークンを最大 2.5 倍速で生成する高速モードも任意で用意されています。
当社のFable 5.2 ガイドで発表内容を整理し、Fable 5.2 API チュートリアルでは仮説検定エージェントの構築を実演しています。
GPT-6.2 Astra vs Claude Fable 5.2:主要比較
能力面は割れています。多くのベンチマーク差は数ポイント。対してコスト差は明確です。トークン単価は同じでも、同一タスクの完了に Fable はより多くのトークンを要します。
価格:実際に支払う金額
トークンレートはほぼ同一でも、最大の違いは価格です。差は各タスクで消費するトークン量にあります。
トークンレートの比較
異なるのはキャッシュ済み入力のみで、Fable は Astra の半額です。これは長い固定コンテキストを繰り返し読むエージェントに有利です。OpenAI は 272K トークン超のリクエストで Astra の入力レートを倍にしていますが、Anthropic の発表には Fable の同種サーチャージは記載されていません。
実際のワークロードの費用
標準レートでの計算は、(ボリューム ÷ 100 万)× レートを入出力で合算:
トークン数が等しければ Fable が高くなることはなく、キャッシュ多用の行は明確に安くなる唯一のケースです。ただし、ここでは「トークン数が等しい」という前提があります。
同じタスクで費用が違う理由
OpenAI の発表チャートには両モデルのタスク当たりコストが含まれており、Fable はすべてで高価です。Vals Science Index で 2.1 倍から、Agents' Last Exam では 20.8 倍(Astra の $2.89 に対して $60.05)まで。これは主に各モデルの最高の推論努力レベルでの比較による、OpenAI による競合測定値なので、目安として扱ってください。
原因は出力の長さです。同一レートでも、出力(推論トークンを含む)を数倍多く書くモデルは、コストも数倍になります。以下の当社テストでも同様の傾向が見られました。
プロフェッショナル業務とエージェント型ワークフロー
ここは GPT-6.2 Astra が明確にリード。すべての要件を満たした法務成果物のみが加点される Harvey LAB-AA では、Astra が 15.0% に対し Fable は 7.2% です。
クライアント向けドキュメントや分析では Astra が無難です。AutomationBench は互角で、Anthropic の Remote Labor Index の結果には GPT-6.2 の対抗値がまだありません。
エージェント型コーディング
両社が公表している唯一のベンチマークでは Fable 5.2 が強力です。FrontierCode 2.0 で 49.1%(メンテナのマージ基準を満たすかで評価)と、Astra の 44.2% を上回ります。
OpenAI の FrontierCode チャートはトレードオフを示しています。Fable はより高いスコアに到達しますが、タスク当たりコストが大幅に高くなります。
品質重視でコーディングエージェントを走らせるなら、Fable が有力です。
科学、CAD、汎用推論
ここは分かれます。GPT-6.2 Astra は科学系ベンチで優位、Fable 5.2 は広範な推論の複合指標で優位、CAD は引き分けです。
科学分析には Astra に分があり、汎用推論は Fable に軍配。ただし複合では 3 ポイント未満の差です。
コンピュータ操作、3D、ロボティクス
Anthropic は Fable 5.2 のコンピュータ操作とロボティクスで強い結果(OSWorld 2.1 で 89.3% など)を報告していますが、OpenAI は GPT-6.2 Astra の同等スコアを公開していないため、正面比較はできません。共有されている唯一の数値は Astra に有利です。Artificial Analysis の AA-3D(ブラインドの 3D ビルドを人間が投票)では、Astra が Elo 1,318 で 1 位、Fable は 1,271 です。
デスクトップソフトを操作するエージェントが主なワークロードなら、現時点の裏付けは Fable のほうが強いと言えます。
GPT-6.2 Astra と Claude Fable 5.2 の実地検証
競合する 2 社のベンチマークだけでは不十分なので、両モデルに同じ創造的コーディング課題を、同一プロンプト・同一ツールで与えました。
課題は、Python の著名なアニメーションライブラリ Manim で、高校生向けにコラッツ予想を 60 秒で解説するスクリプトを作ること。ルール自体は単純(偶数は半分、奇数は 3 倍して 1 を足す)ですが、すべての初期値が 1 に至ることは誰も証明していません。
難しいのは、モデル自身は動画を見られない点です。スクリプトは一発でレンダリングが通り、見栄えがよく、内容が正確でなければなりません。解説動画は「もっともらしい装飾」を誘いますが、画面上の主張はすべて真である必要があります。
両モデルとも OpenCode 上で、固定のツール面(ファイルの読み取り・検索・編集のみ)を使い、同一の高い推論努力、各 1 セッションのクリーン環境で実行しました。創作ブリーフは偶然性が高いため、各モデルを 3 回ずつ走らせ、計 6 本をレンダリングしています。
その後、動画を A~F にシャッフルしてブラインド評価し、4 つの観点で採点しました。画面上の内容がすべて真か、学習者が概念を学べるか、見ていて興味を引くか、仕上がりとして完成しているか。以下は GPT-6.2 Astra のベスト動画の一場面です。
主な結果は次のとおりです。
以下が Fable の動画の主張です。事実としては間違いではないものの、5 年前の到達点を現状の最先端として示しており、3 回すべてで繰り返されました。
そして、Fable による 27 の長い上昇のアニメーション。工芸面で高評価だった理由がわかります。
コスト差は大きく、Fable のスクリプトは 1 本あたり $3.84~$4.35、Astra は $0.40~$0.84 でした。Fable は出力(推論を含む)トークンが 4~10 倍多く、速度もかなり遅かったためです。
では勝者は?品質では引き分け、周辺要素では Astra。虚偽の表示なしで同等水準の動画を、コストは約 1/6 で実現。Fable の一貫性は確かですが、古い事実を自信満々に繰り返す癖も確かに見られました。
GPT-6.2 Astra と Claude Fable 5.2 を選ぶ基準
トークン単価が同じなので、判断は 2 つの問いに集約されます。タスクは Fable のコーディング/コンピュータ操作の強みを活かせるか、そしてタスク当たり数倍のトークン消費を許容できるか。
GPT-6.2 Astra を選ぶなら…
Claude Fable 5.2 を選ぶなら…
GPT-6.2 Astra と Claude Fable 5.2 の始め方
gpt-6.2-astraclaude-fable-5-2最大の違いはクラウドでの到達性です。Fable は 3 大クラウドすべてで利用可能ですが、Astra は OpenAI 自社の API と製品を通じてアクセスします。OpenRouter では、両者は 1 文字列の差し替えで切り替え可能です。
フルセットアップについては、Fable 5.2 API チュートリアルとGPT-6 Astra API チュートリアルをご覧ください。
まとめ
能力面では GPT-6.2 Astra と Claude Fable 5.2 は分野ごとに勝敗が分かれます。プロフェッショナル業務と分析は Astra、コーディングとコンピュータ操作は Fable。
コスト面では、Astra がほぼ常に優位です。トークン単価が同じでも、消費量の差が大きいためです。
Anthropic のモデルでの構築に関心がある場合は、当社のIntroduction to Claude Models コースをどうぞ。OpenAI に関心があるなら、Working with the OpenAI API をお試しください。