Tracks
AI สำหรับวิศวกรรมซอฟต์แวร์
7 ชม.
การแข่งขันโมเดลเปิดขยับอีกครั้งเมื่อวันที่ 16 กรกฎาคม 2026 เมื่อ Moonshot AI เปิดตัว Kimi K3 โมเดลขนาด 2.8 ล้านล้านพารามิเตอร์พร้อมหน้าต่างบริบท 1 ล้านโทเคนและความสามารถด้านวิสัยทัศน์โดยกำเนิด นี่คือโมเดลเปิดที่ใหญ่ที่สุดที่ Moonshot ส่งออก เกินกว่า Kimi K2 อย่างมาก และเป็นตัวแรกที่พวกเขาอธิบายว่าเข้าสู่ระดับ 3 ล้านล้านพารามิเตอร์
หากต้องการเรื่องราวการเปิดตัว เจาะสถาปัตยกรรม กราฟผลทดสอบ การเปรียบเทียบกับ Claude, GPT และห้องทดลองในจีนอื่น ๆ รวมถึงรายการข้อจำกัดของ Moonshot เรายกไว้ในบล็อกโพสต์ Kimi K3 บทความนี้เป็นฝั่งลงมือทำ รวมถึงวิธีเข้าถึงและพฤติกรรมของโมเดลเมื่อใช้งานจริง ผู้เขียนจะพาไปดู 5 ตัวอย่างเล็ก ๆ สี่ตัวอย่างผ่าน API ซึ่งแสดงการใช้โทเคนและต้นทุนจริง และสองตัวอย่างในเว็บแอป kimi.com โดยรวมแล้วครอบคลุมว่่า K3 จัดการกับ:
สี่ตัวอย่างผ่าน API รันเมื่อวันที่ 17 กรกฎาคม 2026 บนโมเดล kimi-k3 และมีค่าใช้จ่ายราว 11 เซนต์ในการรันครั้งแรก หรือไม่กี่เซนต์เมื่อการแคชเริ่มทำงาน
ทางที่เร็วที่สุดในการลองโมเดลคือ kimi.com ซึ่งเว็บแอปและแอปบนมือถือรัน Kimi K3 สำหรับงานเอเจนต์ทั่วไปโดยไม่ต้องตั้งค่า
สำหรับงานหนักขึ้นอย่างรายงานและแดชบอร์ด มี Kimi Work เป็นแอปเดสก์ท็อป
หากทำงานในเทอร์มินัล Kimi Code เป็นเอเจนต์ช่วยเขียนโค้ดที่ติดตั้งจาก npm ในชื่อ @moonshot-ai/kimi-code และสามารถเลือกโมเดลได้ด้วยคำสั่ง /model การใช้ K3 ใน Kimi Code ต้องเป็นสมาชิกแบบชำระเงิน และหน้าต่าง 1 ล้านโทเคนเต็มต้องใช้ระดับสมาชิกที่สูงกว่า
บทความนี้เน้นที่ API ตรงและเว็บแอป แต่ก็มีเอเจนต์เทอร์มินัลให้ใช้หากต้องการ
อย่างไรก็ดี K3 ไม่ได้มาแทนพี่น้องของมัน ตารางด้านล่างแสดงว่าไลน์อัปปัจจุบันแบ่งบทบาทกันอย่างไร
|
โมเดล |
หน้าต่างบริบท |
เหมาะที่สุดสำหรับ |
|
|
1,048,576 โทเคน |
งานธงเรือ: โค้ดยาว วิสัยทัศน์ งานความรู้ |
|
|
262,144 โทเคน |
งานโค้ดโดยเฉพาะ พร้อมตัวเลือกความเร็วสูงที่เร็วกว่า |
|
|
262,144 โทเคน |
แชตข้อความ รูปภาพ และวิดีโอทั่วไป |
สรุปสั้น ๆ คือ K3 เป็นโมเดลที่ควรเริ่มต้นเมื่อมีงานที่ผสมโค้ด เครื่องมือ เอกสาร และรูปภาพ หรือเมื่อจำเป็นต้องใช้หน้าต่าง 1 ล้านโทเคนจริง ๆ สำหรับการสร้างโค้ดล้วนที่ความเร็วสำคัญกว่าบริบท kimi-k2.7-code ยังเป็นตัวเลือกที่สมเหตุสมผลกว่า ดังนั้นอย่าคิดว่าโมเดลใหม่ล่าสุดจะเหมาะเสมอไป
API เข้ากันได้กับ OpenAI SDK ดังนั้นหากเคยใช้มาก่อน เกือบไม่มีอะไรใหม่ ต้องมี Python 3.9 ขึ้นไปและคีย์ API
ก่อนอื่น ลงชื่อเข้าใช้แพลตฟอร์ม Kimi และเปิด หน้าคีย์ API ในคอนโซล สร้างคีย์ คัดลอกครั้งเดียว และเก็บไว้ในที่ปลอดภัย เพราะจะไม่เห็นอีก นอกจากนี้ต้องมียอดเงินเล็กน้อยในบัญชีเพื่อทำการเรียกใช้ สำหรับบทความนี้ไม่กี่ดอลลาร์ก็เพียงพอ
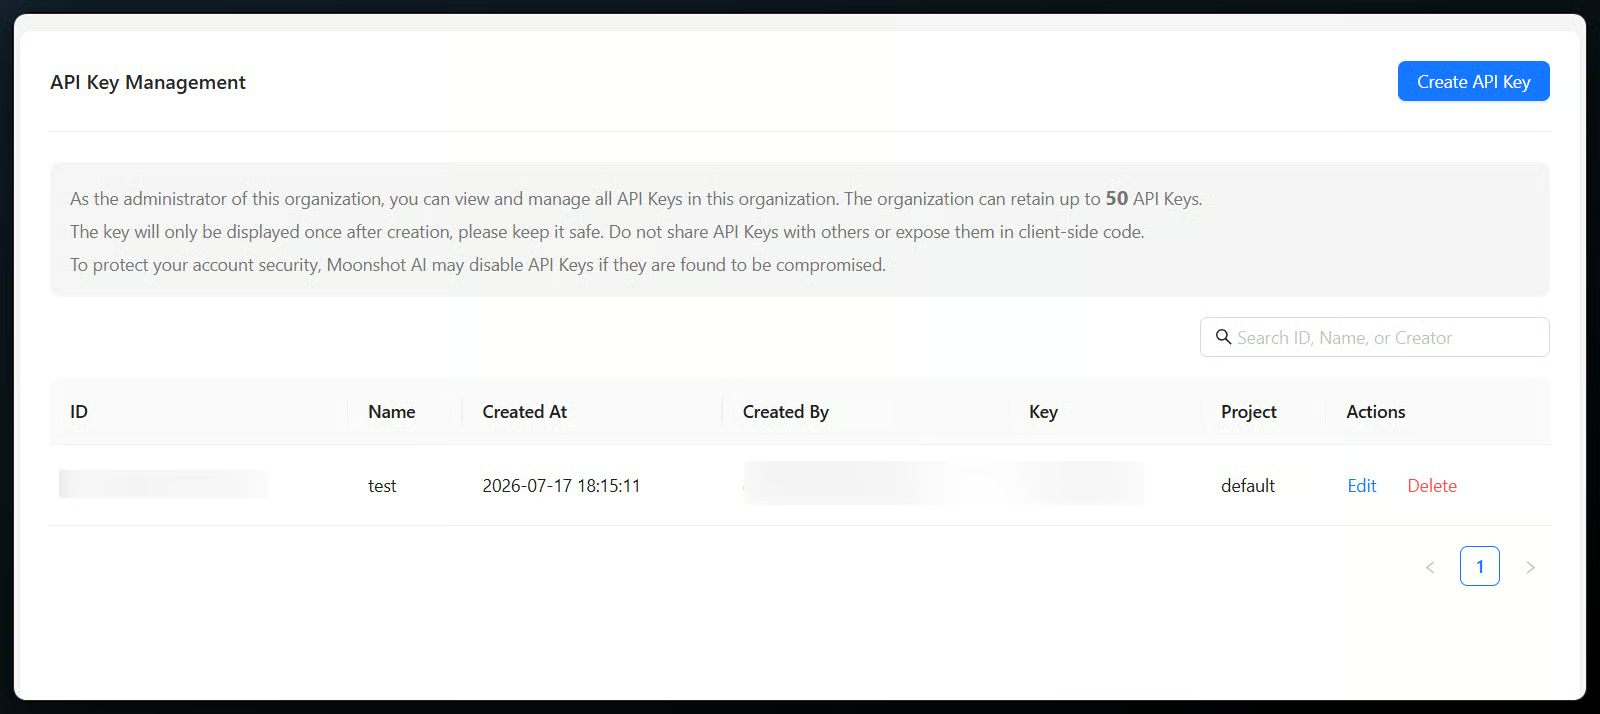
การสร้างคีย์ API ของ Kimi K3 ภาพโดยผู้เขียน
ต่อไป ติดตั้ง OpenAI SDK ลงในสภาพแวดล้อม คำสั่งเดียวก็เสร็จ
python -m pip install --upgrade "openai>=1.0"คำสั่งนี้ดึงไลบรารีไคลเอนต์ที่ใช้ในตัวอย่างที่เหลือ และไม่มีอะไรเฉพาะของ Kimi ที่ต้องติดตั้งเพิ่ม
การอ่านคีย์จากตัวแปรสภาพแวดล้อมดีกว่าการวางลงในโค้ด กำหนดค่า MOONSHOT_API_KEY ในเชลล์หรือไฟล์ .env จากนั้นชี้ไคลเอนต์ไปยัง base URL ของ Moonshot
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["MOONSHOT_API_KEY"],
    base_url="https://api.moonshot.ai/v1",
)
มีเพียงสองอย่างที่ต่างจากการตั้งค่า OpenAI มาตรฐานคือ base_url และชื่อโมเดลคือ kimi-k3 เมื่อเรียบร้อย ก็พร้อมทำการเรียกครั้งแรก
มาลองคำขอแรก ผู้เขียนขอให้โมเดลแนะนำตัวเอง ซึ่งกลายเป็นช่วงเวลาตรงไปตรงมาน่าประทับใจ
completion = client.chat.completions.create(
    model="kimi-k3",
    messages=[{"role": "user", "content": "Introduce Kimi K3 in one sentence."}],
    max_completion_tokens=800,
)
print(completion.choices[0].message.content)
คำตอบคือการปฏิเสธอย่างสุภาพที่จะคาดเดา: โมเดลระบุว่าไม่มีข้อมูลที่เชื่อถือได้เกี่ยวกับ Kimi K3 เนื่องจากถูกฝึกมาก่อนที่ตัวมันเองจะเปิดตัว และชี้ไปที่ประกาศของ Moonshot แทน นี่เป็นการเตือนที่ดีว่าโมเดลไม่รู้เรื่องตัวเอง คำเรียก API นี้มีค่าใช้จ่ายประมาณเจ็ดในสิบของเซนต์ สังเกตการกำหนดเพดาน max_completion_tokens ซึ่งผู้เขียนตั้งไว้ทุกคำเรียกในบทความเพื่อกันเอาต์พุตยืดยาวจนค่าใช้จ่ายพุ่ง
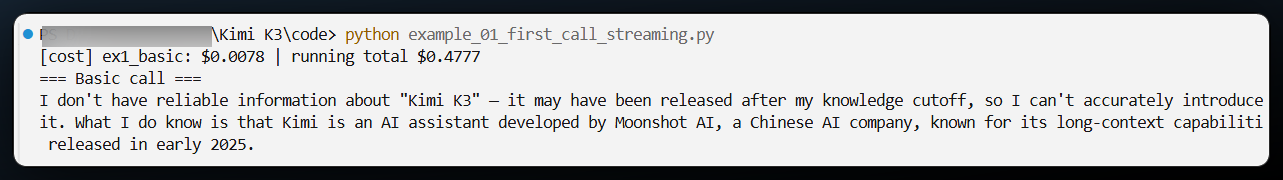
ผลลัพธ์การเรียก API ครั้งแรกของ Kimi K3 ภาพโดยผู้เขียน
K3 ให้เหตุผลเสมอ และ API จะส่งการให้เหตุผลผ่านช่องแยกจากคำตอบ เมื่อสตรีม แต่ละชิ้นอาจมี reasoning_content, contentสุดท้าย หรือทั้งสองอย่าง จึงสามารถแยกพื้นที่แสดงความคิดและคำตอบได้
stream = client.chat.completions.create(
    model="kimi-k3",
    messages=[{"role": "user", "content": "A bat and a ball cost $1.10 together. The bat costs $1.00 more than the ball. How much is the ball?"}],
    max_completion_tokens=1200,
    stream=True,
    stream_options={"include_usage": True},
)

for chunk in stream:
    if not chunk.choices:
        continue
    delta = chunk.choices[0].delta
    reasoning = getattr(delta, "reasoning_content", None)
    if reasoning:
        print(reasoning, end="", flush=True)
    if delta.content:
        print(delta.content, end="", flush=True)
โมเดลสตรีมการทำงานก่อน: รู้จักโจทย์ไม้เบสบอลกับลูกบอลว่าเป็นแบบทดสอบ Cognitive Reflection Test คลาสสิก ระบุคำตอบ直สัญชาตญาณที่ผิดคือ $0.10 จากนั้นแก้อัลเจบราจนได้ว่าลูกบอลราคา $0.05 และตรวจสอบว่า $1.05 บวก $0.05 ได้ $1.10 ส่วนที่มีประโยชน์คือการแยกส่วน: ในแอปจริงจะแสดง content ให้ผู้ใช้ และเก็บ reasoning_contentไว้สำหรับล็อก เพราะการแสดงเหตุผลดิบในโปรดักชันมักไม่ใช่สิ่งที่ต้องการ คำเรียกนี้ใช้เอาต์พุต 488 โทเคนและมีค่าใช้จ่ายไม่ถึงหนึ่งเซนต์
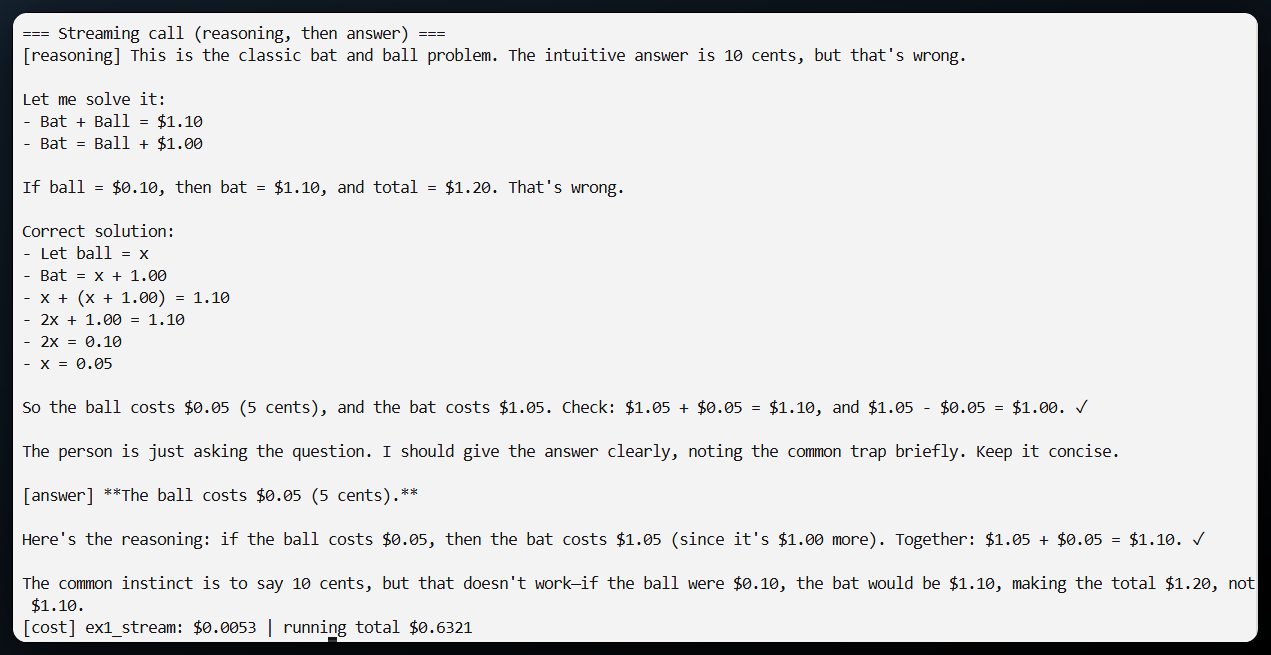
สตรีมเหตุผลแล้วตามด้วยคำตอบสุดท้าย ภาพโดยผู้เขียน
Kimi K3 เป็นโมเดลในไลน์อัปที่รองรับ tool_choice="required" ซึ่งบังคับให้เกิดการเรียกเครื่องมืออย่างน้อยหนึ่งครั้งในเทิร์น นั่นมีประโยชน์เมื่ออยากให้โมเดลดึงข้อมูลมาก่อนแทนการเดา ที่นี่ผู้เขียนให้เครื่องมือจำลองสองตัว คือการค้นหาราคาและตรวจสต็อก บังคับให้เรียกเครื่องมือ รันเครื่องมือในเครื่อง แล้วขอผลลัพธ์เป็น JSON แบบเคร่งครัดด้วย response_format
first = client.chat.completions.create(
    model="kimi-k3",
    messages=messages,
    tools=TOOLS,
    tool_choice="required",
    max_completion_tokens=2500,
)
assistant_message = first.choices[0].message
messages.append(assistant_message)

for tool_call in assistant_message.tool_calls or []:
    args = json.loads(tool_call.function.arguments)
    messages.append({"role": "tool", "tool_call_id": tool_call.id, "content": run_tool(tool_call.function.name, args)})
โมเดลเรียกทั้งสองเครื่องมือด้วยรหัสสินค้าที่ถูกต้อง แล้วส่งสรุปคำสั่งซื้อที่สะอาดตาเป็น JSON: คีย์บอร์ดเชิงกล 5 ตัว ชิ้นละ $89 รวม $445 และตั้งค่าสถานะสต็อกเป็น true รายละเอียดสองอย่างที่ทำให้ใช้งานได้จริงคือ ต้องผนวกข้อความผู้ช่วยทั้งก้อนกลับเข้าบทสนทนาก่อนเพิ่มผลเครื่องมือ และควรแยกวิเคราะห์เฉพาะ content สำหรับ JSON ห้ามใช้ฟิลด์ reasoning คำเรียกคู่กันนี้มีค่าใช้จ่ายรวมกันไม่ถึงหนึ่งเซนต์
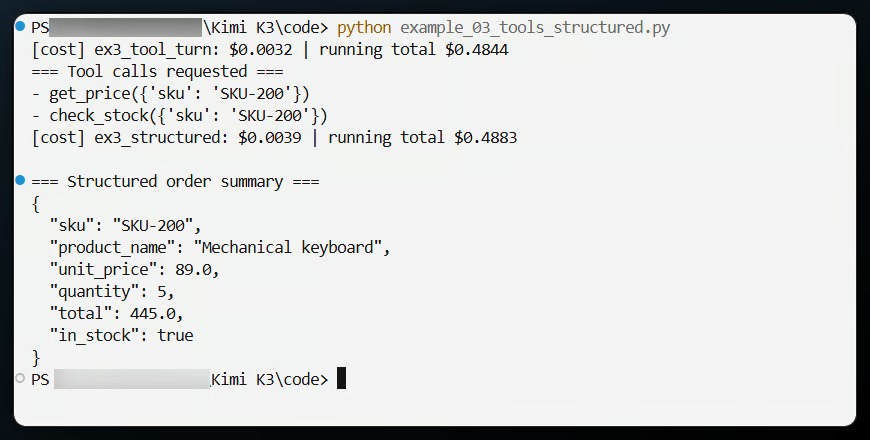
การเรียกเครื่องมือและเอาต์พุต JSON แบบมีโครงสร้าง ภาพโดยผู้เขียน
หากมีเครื่องมือหลายสิบตัว การส่งคำนิยามทั้งหมดทุกคำขอทำให้เปลืองโทเคนและรกพรอมป์ต Kimi K3 ให้ฉีดคำนิยามเครื่องมือระหว่างบทสนทนาด้วยข้อความ system ที่มีฟิลด์ tools และไม่มี content เครื่องมือจะพร้อมใช้งานตั้งแต่นั้นไป ช่วยกันไม่ให้แค็ตตาล็อกเครื่องมือขนาดใหญ่เข้าไปอยู่ในพรีฟิกซ์ที่แคชไว้จนกว่าจะต้องใช้จริง
messages = [
    {"role": "user", "content": "Convert 100 US dollars to euros at a rate of 0.92."},
    {"role": "system", "tools": [{
        "type": "function",
        "function": {
            "name": "convert_currency",
            "description": "Convert an amount from one currency to another",
            "parameters": {
                "type": "object",
                "properties": {"amount": {"type": "number"}, "rate": {"type": "number"}},
                "required": ["amount", "rate"],
            },
        },
    }]},
]
completion = client.chat.completions.create(model="kimi-k3", messages=messages)
print(completion.choices[0].message.tool_calls)
K3 รับเครื่องมือที่เพิ่งโหลดและเรียกใช้ convert_currency ด้วย amount เท่ากับ 100 และ rate 0.92 ตามที่ตั้งใจไว้ สิ่งหนึ่งที่ต้องจำคือเซิร์ฟเวอร์จะไม่เก็บคำนิยามนี้ไว้ให้ จึงต้องส่งข้อความ system ซ้ำในคำขอถัด ๆ ไปหากอยากให้เครื่องมือยังพร้อมใช้งาน คำเรียกนี้ถูกที่สุดในชุดที่ประมาณสองในสิบของเซนต์
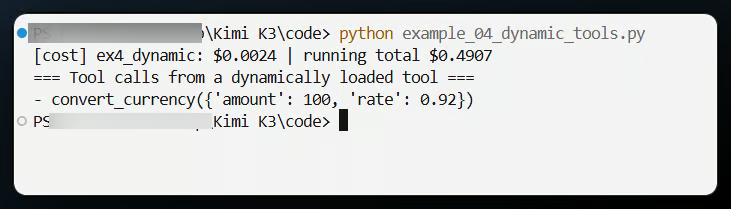
การเรียกใช้เครื่องมือแปลงสกุลเงินที่โหลดแบบไดนามิก ภาพโดยผู้เขียน
ตัวอย่างนี้คือจุดที่หน้าต่าง 1 ล้านโทเคนใช้งานได้จริง การแคชบริบท เป็นแบบอัตโนมัติ ไม่มี ID แคชและไม่มีอายุการเก็บที่ต้องจัดการ ส่งพรีฟิกซ์ขนาดใหญ่ รักษาให้เหมือนเดิมเป๊ะในคำขอถัดไป และส่วนที่ซ้ำจะคิดค่าบริการในอัตรา cache hit แทน cache miss เพื่อให้เห็นความต่าง ผู้เขียนใช้ฐานความรู้ราว 33,000 โทเคนและถามคำถามเกี่ยวกับมัน
knowledge = Path("knowledge_base.md").read_text(encoding="utf-8")
completion = client.chat.completions.create(
    model="kimi-k3",
    messages=[
        {"role": "system", "content": knowledge},
        {"role": "user", "content": "What is the rated payload of the Atlas robot?"},
    ],
    max_completion_tokens=600,
)
ครั้งแรกที่ส่งพรีฟิกซ์นั้น ไม่มีส่วนไหนถูกแคช และคำขอมีค่าใช้จ่ายราว 9.9 เซนต์สำหรับอินพุตประมาณ 33,000 โทเคน หลังจากพรีฟิกซ์ถูกเห็นแล้ว คำขอเดียวกันชนแคชในพรีฟิกซ์ 32,512 โทเคนทั้งหมดและมีค่าใช้จ่ายราว 1.1 เซนต์ ลดลงเกือบเก้าเท่า เหตุผลคือช่องว่างราคา: อินพุตที่แคชแล้วคิด $0.30 ต่อหนึ่งล้านโทเคน เทียบกับ $3.00 สำหรับที่ไม่ได้แคช ข้อสังเกตคือการเขียนแคชเป็นแบบอะซิงก์ จึงยังไม่เกิด hit ในคำขอที่ยิงติดกันทันที จะมีผลในคำขอถัดไป ดังนั้นรันสคริปต์สองครั้งห่างกันหนึ่งนาทีจะเห็น miss ก่อนแล้วจึง hit
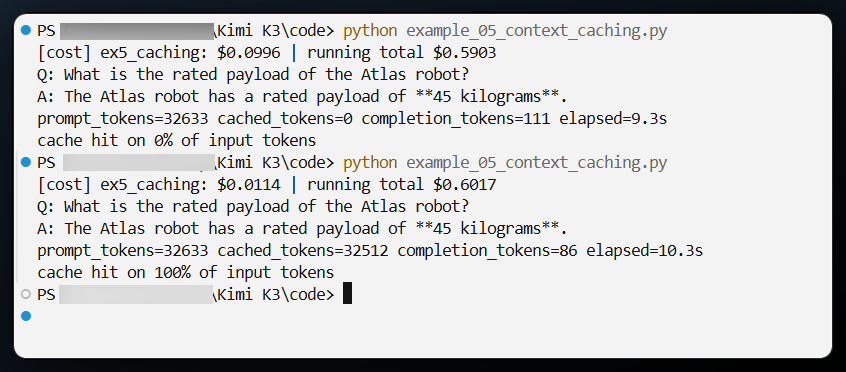
ค่าใช้จ่ายเมื่อพลาดแคชเทียบกับเมื่อชนแคช ภาพโดยผู้เขียน
K3 รองรับวิสัยทัศน์โดยกำเนิด และ API เป็นวิธีใช้ที่สะอาด แม้จะไม่รับ URL รูปภาพสาธารณะ ต้องส่งรูปเป็น data URL แบบ base64 และทำให้ content ของข้อความเป็นอาร์เรย์ของอ็อบเจ็กต์ แยกส่วนรูปภาพและข้อความ ผู้เขียนเรนเดอร์แดชบอร์ดเล็ก ๆ พร้อมบั๊กเลย์เอาต์ตั้งใจไว้ สกรีนช็อต แล้วถาม K3 ว่าผิดอะไร
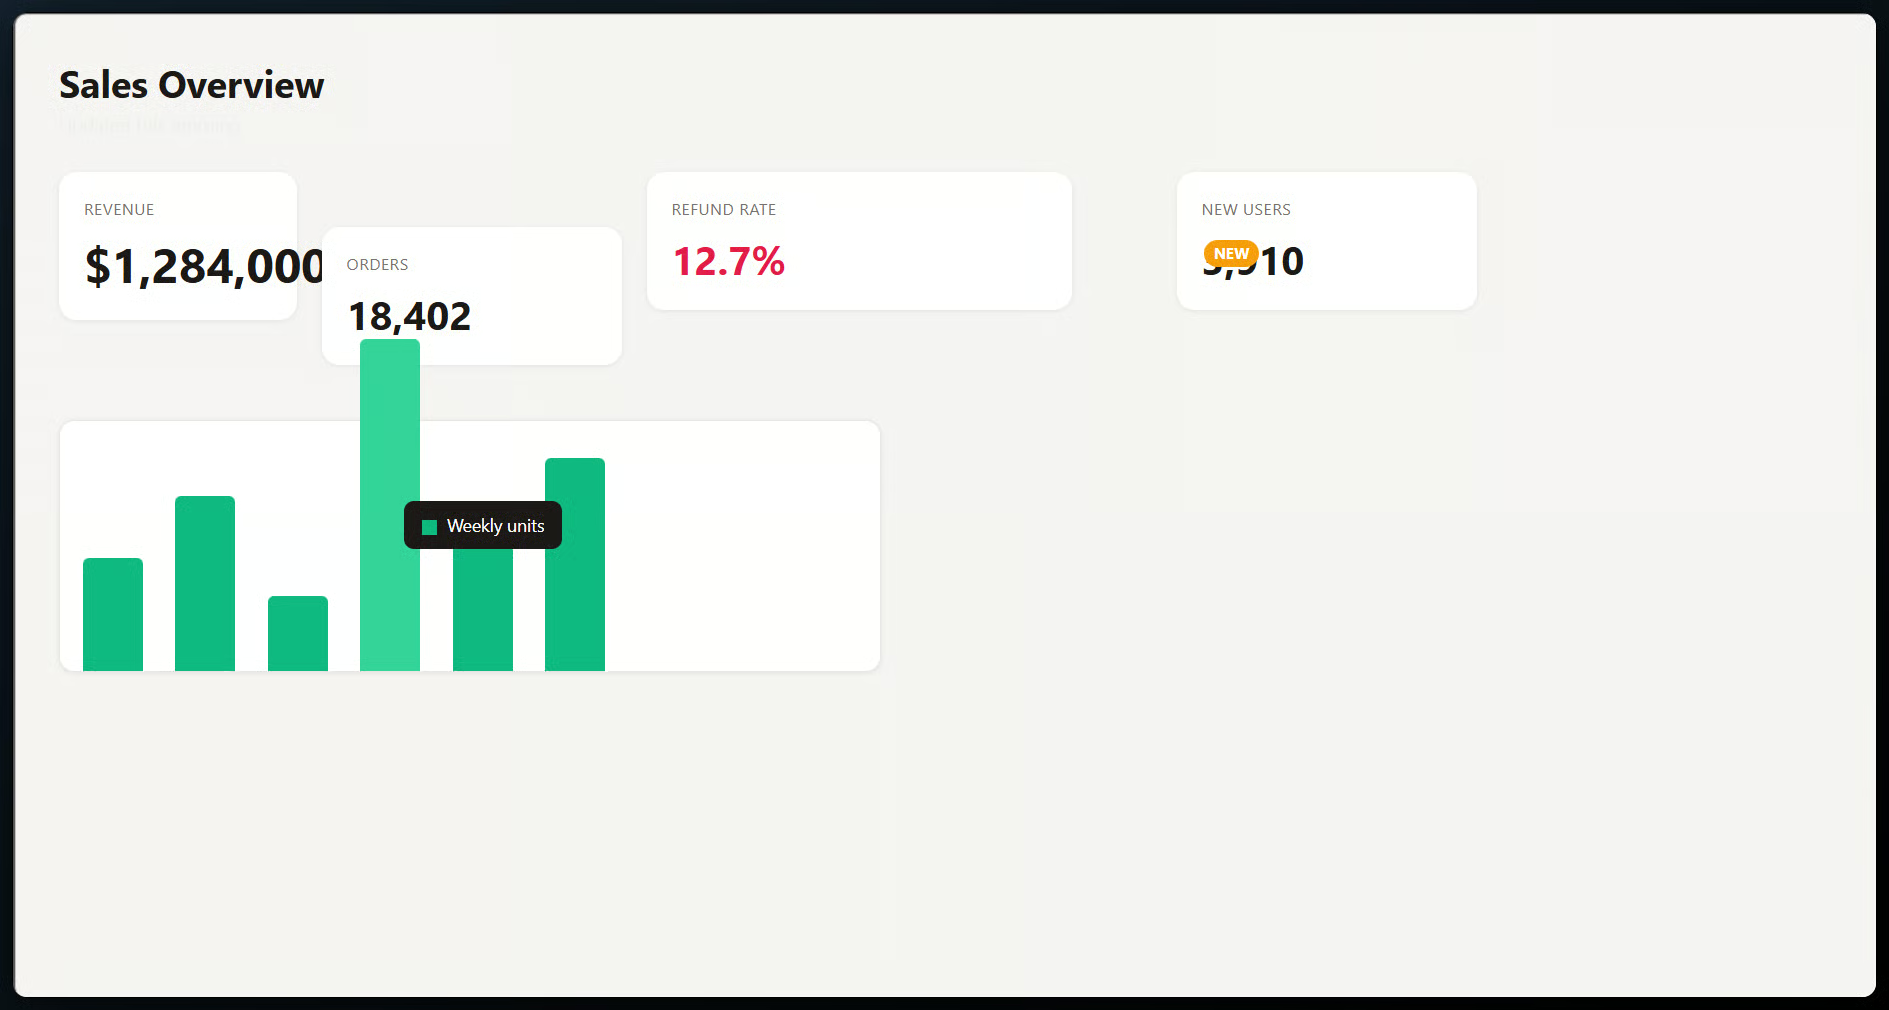
แดชบอร์ดที่มีบั๊กเลย์เอาต์ตั้งใจไว้ ภาพโดยผู้เขียน
import base64
from pathlib import Path

image_data = base64.b64encode(Path("broken_dashboard.png").read_bytes()).decode()
completion = client.chat.completions.create(
    model="kimi-k3",
    messages=[{
        "role": "user",
        "content": [
            {"type": "image_url", "image_url": {"url": f"data:image/png;base64,{image_data}"}},
            {"type": "text", "text": "List the layout and alignment problems you can see, and give a short CSS fix for each."},
        ],
    }],
    max_completion_tokens=3500,
)
print(completion.choices[0].message.content)
K3 อ่านรูปได้ดี มันจับได้ว่าการ์ดหนึ่งใบวางต่ำกว่าบรรทัดและซ้อนทับกับการ์ดข้าง ๆ ป้ายไปค้างบนตัวเลข (ถึงขั้นอ่านเลข 3,910 ที่ถูกปิดเป็น 5,910 ซึ่งเป็นบั๊กที่ยืนยันตัวเอง) ช่องว่างก่อนการ์ดใบสุดท้ายไม่เท่ากัน แท่งกราฟล้นขึ้นไปชนการ์ดด้านบน และทูลทิปทับอยู่เหนือแท่ง พร้อมให้วิธีแก้ CSS สั้น ๆ สำหรับแต่ละข้อ เช่น ย้ายการ์ดมาอยู่ในกริดเดียวกัน อย่างไรก็ตาม มันข้ามซับไตเติลที่คอนทราสต์ต่ำแทบมองไม่เห็น ดังนั้นวิสัยทัศน์จะจับสิ่งที่เตะตาได้ดีกว่ารายละเอียดเล็กน้อย คำเรียกนี้มีค่าใช้จ่ายราวสองเซนต์
ตัวอย่าง API เป็นไปได้ด้วยดี แต่มีขอบขรุขระบางอย่างที่ควรเอ่ยไว้เพื่อจะได้ไม่แปลกใจ ผู้เขียนพบส่วนใหญ่โดยตรง
ตอนนี้มีเพียง reasoning_effort="max" เท่านั้น จึงยังปรับลดการคิดเพื่อลดค่าใช้จ่ายไม่ได้
การตั้งค่าการสุ่มตัวอย่างถูกล็อก ค่าอย่าง temperature, top_p และค่า penalty ต่าง ๆ ถูกล็อก จึงควรงดส่งค่าเหล่านี้แทนการจูน
เอาต์พุตอาจยาวและมีค่าใช้จ่ายสูง กำหนดเพดาน max_completion_tokens ตามในตัวอย่าง และตรวจสอบลูปของเอเจนต์ให้ดี
API ไม่รองรับ URL รูปภาพสาธารณะ จึงวางแผนใช้ base64 หรืออัปโหลดไฟล์สำหรับงานวิสัยทัศน์
ไม่มีข้อใดถึงขั้นเป็นดีลเบรกเกอร์ แต่มีผลต่อวิธีใช้งานโมเดล สิ่งที่ควรจับตาที่สุดคือค่าเอาต์พุต
จากที่ลองใช้งาน มีสองอย่างที่โดดเด่น การเรียกเครื่องมือและเอาต์พุตแบบมีโครงสร้างไม่ต้องรีทราย และการแคชสำคัญกว่าที่คาด เพราะการใช้พรีฟิกซ์ยาวเดิมซ้ำทำให้คำขอขนาดใหญ่ส่งซ้ำได้ในราคาถูก ดังนั้นสำหรับการวิเคราะห์ระดับรีโพซิทอรี การเรียกบริบทยาวซ้ำ ๆ หรือวิศวกรรมมัลติโหมด K3 เป็นค่าเริ่มต้นที่สมเหตุสมผล; สำหรับแชตรวดเร็วราคาต่ำหรือควบคุมการสุ่มตัวอย่างอย่างแม่นยำ โมเดลที่เล็กกว่าจะง่ายกว่า รายละเอียดน้ำหนักเปิดและสัญญาอนุญาตที่กล่าวไว้ก่อนหน้า ควรชัดเจนขึ้นหลังการปล่อยวันที่ 27 กรกฎาคม
สำหรับพื้นหลังเพิ่มเติมเกี่ยวกับแพตเทิร์นที่ตัวอย่างเหล่านี้ใช้ ดูคอร์ส Developing AI Systems with the OpenAI API ของเรา ซึ่งครอบคลุมการเรียกฟังก์ชันและการเชื่อมโมเดลเข้ากับเครื่องมือภายนอกใน Python
เรียนรู้กับ DataCamp
Tracks
Courses
Tracks