说明:在 Gemini 3.7 Flash 发布仅几周后,Google 又发布了 Gemini 3.8 Flash。在我们的 Gemini 3.8 Flash API 教程 中查看其实际表现。
Google 发布了 Gemini 3.7 Flash,这是其迄今最强的 Flash 等级模型,直指编码与代理型工作流。发布时,Google 的旗舰 Gemini 3.5 Pro 仍在延期中,路透社将其视为 DeepMind 能否跟上 Anthropic 和 OpenAI 的一次考验。
亮眼的数据相当激进。Gemini 3.7 Flash 在 FrontierCode 1.1 Main 上得分 43.6%(较 3.6 Flash 的 34.4% 大幅提升),在 Code Arena 的网页开发 Elo 达到 1588,并以每 100 万输入 token 0.75 美元、每 100 万输出 token 3.75 美元的试销价推出,约为 3.6 Flash 初始价格的一半。
本文将全面介绍 Gemini 3.7 Flash 的更新点,涵盖其功能、基准测试表现,并提供您可自行运行的上手测试。若要深入了解其对手模型,请参阅我们的 GPT-5.6 Terra 与 Claude Sonnet 5 对比 以及 Claude 学习指南。
要点速览
- Gemini 3.7 Flash 是 Google 最强的 Flash 模型,面向编码与代理型工作流,具备 100 万 token 上下文窗口。
- 试销价至 2026 年 12 月 31 日为每 100 万输入 token 0.75 美元、每 100 万输出 token 3.75 美元,之后恢复至 1.50/7.50 美元标准价。
- 在与 Claude Sonnet 5 和 GPT-5.6 Terra 的对比中,位列 FrontierCode 1.1(43.6%)、GDP.pdf(34.0%)、Harvey LAB-AA(90.7%)与 GDM-MRCR 长上下文(97.0%)之首。
- GPT-5.6 Terra 仍在 DeepSWE、Terminal-bench 与 OSWorld 代理型评测上领先。
- 可通过 Gemini API、Google Antigravity、Gemini Enterprise 与 Gemini Spark 获取。
什么是 Gemini 3.7 Flash?
Gemini 3.7 Flash 是 Google 的中端主力模型,被定位为最强的 Flash 级别,用于复杂编码、代理型工作流与可靠的多步执行。其承接三周前发布的 Gemini 3.6 Flash,Google 将质量跃升归功于开发者反馈与算法改进。
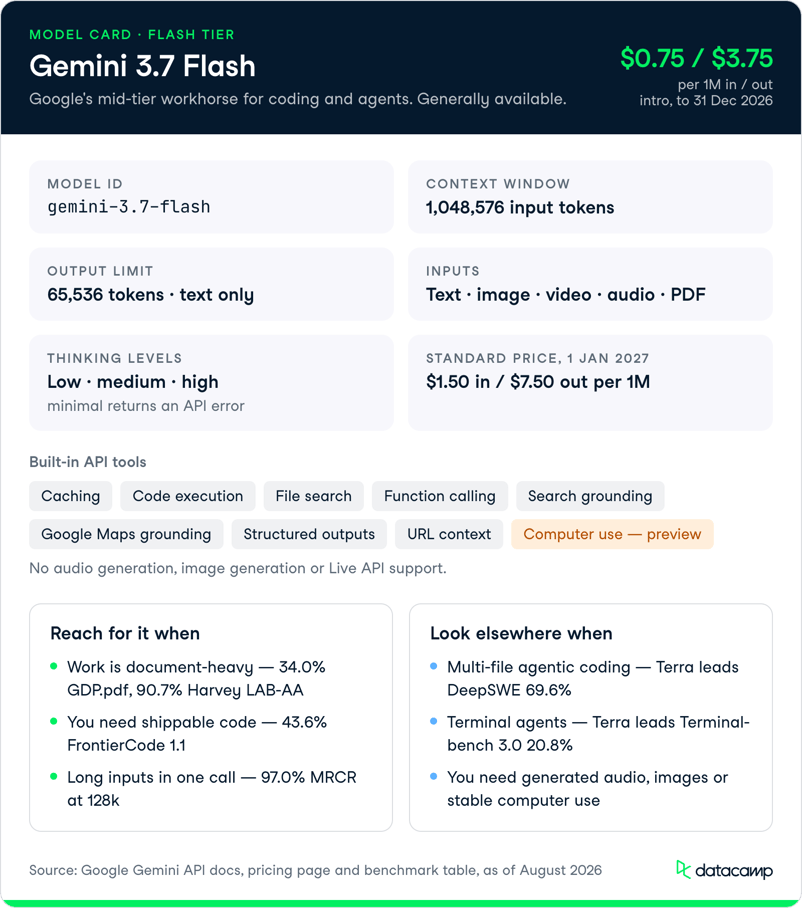
该模型通过 Gemini API 面向一般可用,提供 100 万 token 上下文窗口(1,048,576 个输入 token)与 65,536 个输出 token 上限。它支持文本、图像、视频、音频与 PDF 输入,并仅输出文本。Google 提供低、中、高三档可调“思考”级别,但若请求不支持的 minimal 设置,API 会返回错误。
最具代表性的基准是长周期软件工程评测 DeepSWE v1.1:3.7 Flash 得分 65.3%,而其前身在 FrontierCode 上为 34.4%,在 DeepSWE 本身仅为 48.6%。在降价的同时带来单代大幅跃升并不常见。
 Gemini 3.7 Flash 有何新变化?
核心是以更低价格提供更强的 Flash 模型,指令遵循更好,在代理循环中所需“看护”更少。以下是对从业者最重要的变化。
更强的编码与问题解决
您可以将更棘手的调试与重构交给 Gemini 3.7 Flash,并期待更高的一次通过率。Google 报告其在生产代码质量的 FrontierCode 1.1 Main 上得分 43.6%(3.6 Flash 为 34.4%),在长周期软件工程的 DeepSWE v1.1 上为 65.3%。
对工程师的直接影响是重试更少。Google 称该模型更善于应对阻碍,并更忠实地执行指令,从而减少让廉价模型在实际用时上“变贵”的人工监管。
更快的网页应用与 UI 生成
Gemini 3.7 Flash 生成可用布局与功能完整的网页应用所需提示词更少。在 Code Arena 的网页开发榜上,其 Elo 为 1588,对比 3.6 Flash 的 1538 与 Claude Sonnet 5 的 1541。
在生成 UI 时,模型也能贴合参考输入,无论该参考是截图、图像,还是完整的设计系统。若您提供定价页的模型稿,它会尽力复现设计一致性,而非即兴给出通用布局。
更好的多步代理执行
该模型在规划与工具调用上投入更多精力,而这正是廉价模型常出错之处。在面向真实商业工作流的私有评测 AutomationBench 上,3.7 Flash 得分 30.4%,对比 3.6 Flash 的 17.0% 与 Claude Sonnet 5 的 10.7%。
通过 API 可用的内置工具包括缓存、代码执行、文件搜索、函数调用、搜索加持、Google 地图加持、结构化输出与 URL 上下文。计算机使用功能已提供但标注为预览,我暂不建议围绕其构建生产级代理。
改进的文档与知识型工作
Gemini 3.7 Flash 在金融、法律与生物科学等知识密集领域具备更强的推理与文档理解能力。在专家级 PDF 理解的 GDP.pdf 基准上,其得分 34.0%(3.6 Flash 为 22.0%);在复杂法律工作流的 Harvey LAB-AA 上达 90.7%。
若您的工作涉及从密集的年报或合同中提取结构化答案,这是值得测试的一次更新。模型仍仅输出文本,因此不会生成其读到的图表,只会进行描述或摘要。
更低价格,便于代理规模化
试销价将 Flash 代理的运行成本较 3.6 Flash 发布时价格腰斩。至 2026 年 12 月 31 日,输入每 100 万 token 0.75 美元,输出每 100 万 token 3.75 美元。
- 输入:每 100 万 token 0.75 美元(试销),2027 年 1 月 1 日起涨至 1.50 美元
- 输出:每 100 万 token 3.75 美元(试销),2027 年 1 月 1 日起涨至 7.50 美元
作为对比,按 Google 自家基准表,Claude Sonnet 5 的输入为 2.00 美元、输出为 10.00 美元;GPT-5.6 Terra 的输入为 2.00 美元、输出为 12.00 美元。就裸 token 价而言,3.7 Flash 以明显优势压低二者。
Gemini 3.7 Flash 基准测试
Google 的基准表将 Gemini 3.7 Flash 与 3.6 Flash、Claude Sonnet 5、GPT-5.6 Terra 及 Muse Spark 1.2 对比。总体规律一致:3.7 Flash 几乎在所有评测上胜过前代,并与更昂贵的对手互有胜负,不过 GPT-5.6 Terra 在若干代理型编码评测上略胜一筹。
Gemini 3.7 Flash 与竞品一览
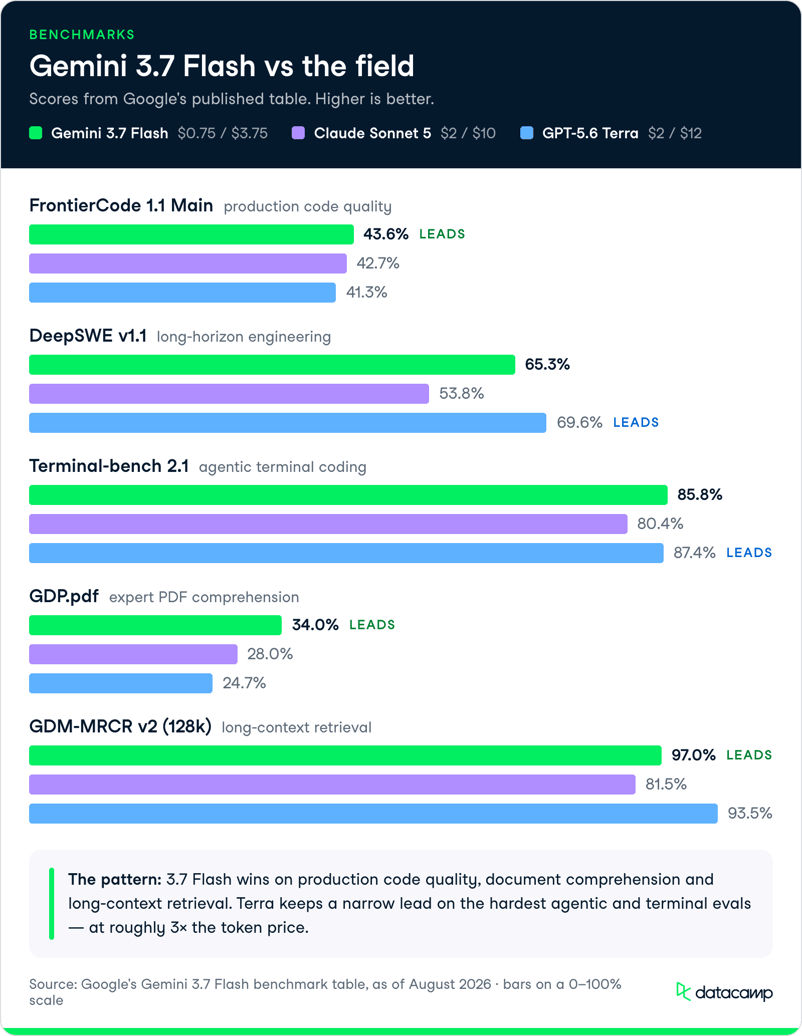
以下是 Google 基准表中四款模型的关键数据对比。
| 指标 | Gemini 3.7 Flash | Claude Sonnet 5 | GPT-5.6 Terra |
|---|
| 输入价格 / 100 万 | $0.75 | $2.00 | $2.00 |
| 输出价格 / 100 万 | $3.75 | $10.00 | $12.00 |
| FrontierCode 1.1 Main | 43.6% | 42.7% | 41.3% |
| DeepSWE v1.1 | 65.3% | 53.8% | 69.6% |
| Terminal-bench 2.1 | 85.8% | 80.4% | 87.4% |
| GDP.pdf | 34.0% | 28.0% | 24.7% |
| GDM-MRCR v2 (128k) | 97.0% | 81.5% | 93.5% |
FrontierCode 1.1 Main
FrontierCode 1.1 Main 衡量生产代码质量,奖励的是正确且可交付的代码,而非仅语法正确。
Gemini 3.7 Flash 得分 43.6%,领先于 Claude Sonnet 5 的 42.7%、GPT-5.6 Terra 的 41.3%,以及其前代 3.6 Flash 的 34.4%。
以 Flash 等级模型在生产代码质量上超越两款前沿对手,且 token 成本仅为其三分之一,这是本次发布最突出的结果。
DeepSWE v1.1
DeepSWE v1.1 测试长周期软件工程,即需要在多步中维持上下文的多文件任务。
在该项上,3.7 Flash 得分 65.3%,相较 3.6 Flash 的 48.6% 提升显著,但 GPT-5.6 Terra 以 69.6% 领先,Claude Sonnet 5 以 53.8% 跟随。
结论:3.7 Flash 在长周期编码上大幅缩小与 Terra 的差距,但尚未反超。若您需要多文件代理型编码的绝对上限,该评测上 Terra 仍胜。
Terminal-bench 2.1 与 3.0
Terminal-bench 衡量代理型终端编码,即模型通过命令行完成任务。
在 Terminal-bench 2.1 上,3.7 Flash 得分 85.8%,对比 3.6 Flash 的 78.0% 与 Claude Sonnet 5 的 80.4%,但 GPT-5.6 Terra 以 87.4% 领先。
更新的通用代理能力评测 Terminal-bench 3.0 整体更难:3.7 Flash 得分 14.9%,显著高于 3.6 Flash 的 5.4%,与 Claude Sonnet 5 的 14.6% 大致持平,落后于 Terra 的 20.8%。
这些较低的绝对数值有助于提醒我们:通用代理的可靠性仍有很长的路要走。
GDP.pdf 与 Harvey LAB-AA
GDP.pdf 测试专家级 PDF 文档理解,Harvey LAB-AA 测试复杂法律工作流。
Gemini 3.7 Flash 在两项上均领先:GDP.pdf 得分 34.0%,高于 Claude Sonnet 5 的 28.0% 与 GPT-5.6 Terra 的 24.7%;Harvey LAB-AA 得分 90.7%,高于 Sonnet 5 的 90.1% 与 Terra 的 85.2%。
若您的工作负载以法律或金融的重文档分析为主,这里是“最便宜的模型恰好也是最准确”的少见组合。
GDM-MRCR v2 长上下文
GDM-MRCR v2(8-needle)衡量长上下文检索,测试模型能否在长输入中找到多处埋藏信息。
在 128k 平均长度下,3.7 Flash 得分 97.0%,高于 3.6 Flash 的 91.8%、Claude Sonnet 5 的 81.5%,以及 GPT-5.6 Terra 的 93.5%。
凭借 100 万 token 上下文窗口与表中最强的 8-needle 检索能力,3.7 Flash 非常适合在单次调用中塞入超大文档或长转录的管线。
在我们对比 Terra 与 Sonnet 5 时,长上下文检索是二者的明显分水岭之一,而 3.7 Flash 现在在这一档位上位于两者之上。
GPT-5.6 Terra 仍领先的领域
也有必要如实面对短板。
GPT-5.6 Terra 在 DeepSWE v1.1(69.6% vs 65.3%)、Terminal-bench 2.1(87.4% vs 85.8%)、Terminal-bench 3.0(20.8% vs 14.9%)与 OSWorld-2.0 代理型计算机使用(50.2% vs 47.9%)上优于 Gemini 3.7 Flash。
总体模式是:Terra 在最难的代理型与终端编码评测上略有优势,而 3.7 Flash 则在生产代码质量、文档理解与长上下文检索上取胜。对您而言谁更合适,取决于瓶颈在代理可靠性还是在成本。
Gemini 3.7 Flash 定价与可用性
Gemini 3.7 Flash 现已在多种 Google 入口普遍可用。
API 模型 ID 为 gemini-3.7-flash,您可在 Google AI Studio、Android Studio,或以代理为先的 Google Antigravity 环境中开始构建。
- 开发者:通过 Google AI Studio 与 Android Studio 使用 Gemini API;在 Google Antigravity 中进行代理工作流
- 企业:Gemini Enterprise Agent Platform 与 Gemini Enterprise 应用
- 个人:Gemini Spark——Gemini 应用中的 24/7 个人代理,面向 160 多个国家/地区的 Google AI Pro 与 Ultra 订阅用户
价格为至 2026 年 12 月 31 日每 100 万输入 token 0.75 美元、每 100 万输出 token 3.75 美元。自 2027 年 1 月 1 日起,恢复为输入 1.50 美元、输出 7.50 美元。请注意,该模型不支持音频生成、图像生成与 Live API,计算机使用功能仅为预览。
结语
在旗舰 Gemini 3.5 Pro 持续延期之际,Gemini 3.7 Flash 体现了 Google 的快速迭代与降价策略。
在 3.6 Flash 发布仅三周后即以半价推出改进版 Flash,表明公司正试图在中端市场取胜,而大多数生产量也的确集中于此。
坦白说,若您的工作负载是文档理解、可投产的网页与应用代码,或长上下文检索,这就是值得优先选择的模型:它在这些方面全面压过 Claude Sonnet 5 与 GPT-5.6 Terra,且成本只是其一小部分。
若您的瓶颈在最艰难的代理型终端编码,Terra 仍在 DeepSWE 与 Terminal-bench 上略有领先,而您也需要为这一“上限”多付费用。
随着 DeepMind 领导层调整与 Pro 模型延期,Google 正依靠 Flash 证明其仍具竞争力。就其新近公布的基准表看,对于一款中端模型,这一论点大体站得住脚。
如果您想亲手上手此类模型,建议先从我们的 AI Fundamentals 技能路径 打好基础,再将 Gemini 3.7 Flash 接入您自己的代理管线。


说明:在 Gemini 3.7 Flash 发布仅几周后,Google 又发布了 Gemini 3.8 Flash。在我们的 Gemini 3.8 Flash API 教程 中查看其实际表现。
Google 发布了 Gemini 3.7 Flash,这是其迄今最强的 Flash 等级模型,直指编码与代理型工作流。发布时,Google 的旗舰 Gemini 3.5 Pro 仍在延期中,路透社将其视为 DeepMind 能否跟上 Anthropic 和 OpenAI 的一次考验。
亮眼的数据相当激进。Gemini 3.7 Flash 在 FrontierCode 1.1 Main 上得分 43.6%(较 3.6 Flash 的 34.4% 大幅提升),在 Code Arena 的网页开发 Elo 达到 1588,并以每 100 万输入 token 0.75 美元、每 100 万输出 token 3.75 美元的试销价推出,约为 3.6 Flash 初始价格的一半。
本文将全面介绍 Gemini 3.7 Flash 的更新点,涵盖其功能、基准测试表现,并提供您可自行运行的上手测试。若要深入了解其对手模型,请参阅我们的 GPT-5.6 Terra 与 Claude Sonnet 5 对比 以及 Claude 学习指南。
要点速览
什么是 Gemini 3.7 Flash?
Gemini 3.7 Flash 是 Google 的中端主力模型,被定位为最强的 Flash 级别,用于复杂编码、代理型工作流与可靠的多步执行。其承接三周前发布的 Gemini 3.6 Flash,Google 将质量跃升归功于开发者反馈与算法改进。
该模型通过 Gemini API 面向一般可用,提供 100 万 token 上下文窗口(1,048,576 个输入 token)与 65,536 个输出 token 上限。它支持文本、图像、视频、音频与 PDF 输入,并仅输出文本。Google 提供低、中、高三档可调“思考”级别,但若请求不支持的
minimal设置,API 会返回错误。最具代表性的基准是长周期软件工程评测 DeepSWE v1.1:3.7 Flash 得分 65.3%,而其前身在 FrontierCode 上为 34.4%,在 DeepSWE 本身仅为 48.6%。在降价的同时带来单代大幅跃升并不常见。
核心是以更低价格提供更强的 Flash 模型,指令遵循更好,在代理循环中所需“看护”更少。以下是对从业者最重要的变化。
更强的编码与问题解决
您可以将更棘手的调试与重构交给 Gemini 3.7 Flash,并期待更高的一次通过率。Google 报告其在生产代码质量的 FrontierCode 1.1 Main 上得分 43.6%(3.6 Flash 为 34.4%),在长周期软件工程的 DeepSWE v1.1 上为 65.3%。
对工程师的直接影响是重试更少。Google 称该模型更善于应对阻碍,并更忠实地执行指令,从而减少让廉价模型在实际用时上“变贵”的人工监管。
更快的网页应用与 UI 生成
Gemini 3.7 Flash 生成可用布局与功能完整的网页应用所需提示词更少。在 Code Arena 的网页开发榜上,其 Elo 为 1588,对比 3.6 Flash 的 1538 与 Claude Sonnet 5 的 1541。
在生成 UI 时,模型也能贴合参考输入,无论该参考是截图、图像,还是完整的设计系统。若您提供定价页的模型稿,它会尽力复现设计一致性,而非即兴给出通用布局。
更好的多步代理执行
该模型在规划与工具调用上投入更多精力,而这正是廉价模型常出错之处。在面向真实商业工作流的私有评测 AutomationBench 上,3.7 Flash 得分 30.4%,对比 3.6 Flash 的 17.0% 与 Claude Sonnet 5 的 10.7%。
通过 API 可用的内置工具包括缓存、代码执行、文件搜索、函数调用、搜索加持、Google 地图加持、结构化输出与 URL 上下文。计算机使用功能已提供但标注为预览,我暂不建议围绕其构建生产级代理。
改进的文档与知识型工作
Gemini 3.7 Flash 在金融、法律与生物科学等知识密集领域具备更强的推理与文档理解能力。在专家级 PDF 理解的 GDP.pdf 基准上,其得分 34.0%(3.6 Flash 为 22.0%);在复杂法律工作流的 Harvey LAB-AA 上达 90.7%。
若您的工作涉及从密集的年报或合同中提取结构化答案,这是值得测试的一次更新。模型仍仅输出文本,因此不会生成其读到的图表,只会进行描述或摘要。
更低价格,便于代理规模化
试销价将 Flash 代理的运行成本较 3.6 Flash 发布时价格腰斩。至 2026 年 12 月 31 日,输入每 100 万 token 0.75 美元,输出每 100 万 token 3.75 美元。
作为对比,按 Google 自家基准表,Claude Sonnet 5 的输入为 2.00 美元、输出为 10.00 美元;GPT-5.6 Terra 的输入为 2.00 美元、输出为 12.00 美元。就裸 token 价而言,3.7 Flash 以明显优势压低二者。
Gemini 3.7 Flash 基准测试
Google 的基准表将 Gemini 3.7 Flash 与 3.6 Flash、Claude Sonnet 5、GPT-5.6 Terra 及 Muse Spark 1.2 对比。总体规律一致:3.7 Flash 几乎在所有评测上胜过前代,并与更昂贵的对手互有胜负,不过 GPT-5.6 Terra 在若干代理型编码评测上略胜一筹。
Gemini 3.7 Flash 与竞品一览
以下是 Google 基准表中四款模型的关键数据对比。
FrontierCode 1.1 Main
FrontierCode 1.1 Main 衡量生产代码质量,奖励的是正确且可交付的代码,而非仅语法正确。
Gemini 3.7 Flash 得分 43.6%,领先于 Claude Sonnet 5 的 42.7%、GPT-5.6 Terra 的 41.3%,以及其前代 3.6 Flash 的 34.4%。
以 Flash 等级模型在生产代码质量上超越两款前沿对手,且 token 成本仅为其三分之一,这是本次发布最突出的结果。
DeepSWE v1.1
DeepSWE v1.1 测试长周期软件工程,即需要在多步中维持上下文的多文件任务。
在该项上,3.7 Flash 得分 65.3%,相较 3.6 Flash 的 48.6% 提升显著,但 GPT-5.6 Terra 以 69.6% 领先,Claude Sonnet 5 以 53.8% 跟随。
结论:3.7 Flash 在长周期编码上大幅缩小与 Terra 的差距,但尚未反超。若您需要多文件代理型编码的绝对上限,该评测上 Terra 仍胜。
Terminal-bench 2.1 与 3.0
Terminal-bench 衡量代理型终端编码,即模型通过命令行完成任务。
在 Terminal-bench 2.1 上,3.7 Flash 得分 85.8%,对比 3.6 Flash 的 78.0% 与 Claude Sonnet 5 的 80.4%,但 GPT-5.6 Terra 以 87.4% 领先。
更新的通用代理能力评测 Terminal-bench 3.0 整体更难:3.7 Flash 得分 14.9%,显著高于 3.6 Flash 的 5.4%,与 Claude Sonnet 5 的 14.6% 大致持平,落后于 Terra 的 20.8%。
这些较低的绝对数值有助于提醒我们:通用代理的可靠性仍有很长的路要走。
GDP.pdf 与 Harvey LAB-AA
GDP.pdf 测试专家级 PDF 文档理解,Harvey LAB-AA 测试复杂法律工作流。
Gemini 3.7 Flash 在两项上均领先:GDP.pdf 得分 34.0%,高于 Claude Sonnet 5 的 28.0% 与 GPT-5.6 Terra 的 24.7%;Harvey LAB-AA 得分 90.7%,高于 Sonnet 5 的 90.1% 与 Terra 的 85.2%。
若您的工作负载以法律或金融的重文档分析为主,这里是“最便宜的模型恰好也是最准确”的少见组合。
GDM-MRCR v2 长上下文
GDM-MRCR v2(8-needle)衡量长上下文检索,测试模型能否在长输入中找到多处埋藏信息。
在 128k 平均长度下,3.7 Flash 得分 97.0%,高于 3.6 Flash 的 91.8%、Claude Sonnet 5 的 81.5%,以及 GPT-5.6 Terra 的 93.5%。
凭借 100 万 token 上下文窗口与表中最强的 8-needle 检索能力,3.7 Flash 非常适合在单次调用中塞入超大文档或长转录的管线。
在我们对比 Terra 与 Sonnet 5 时,长上下文检索是二者的明显分水岭之一,而 3.7 Flash 现在在这一档位上位于两者之上。
GPT-5.6 Terra 仍领先的领域
也有必要如实面对短板。
GPT-5.6 Terra 在 DeepSWE v1.1(69.6% vs 65.3%)、Terminal-bench 2.1(87.4% vs 85.8%)、Terminal-bench 3.0(20.8% vs 14.9%)与 OSWorld-2.0 代理型计算机使用(50.2% vs 47.9%)上优于 Gemini 3.7 Flash。
总体模式是:Terra 在最难的代理型与终端编码评测上略有优势,而 3.7 Flash 则在生产代码质量、文档理解与长上下文检索上取胜。对您而言谁更合适,取决于瓶颈在代理可靠性还是在成本。
Gemini 3.7 Flash 定价与可用性
Gemini 3.7 Flash 现已在多种 Google 入口普遍可用。
API 模型 ID 为
gemini-3.7-flash,您可在 Google AI Studio、Android Studio,或以代理为先的 Google Antigravity 环境中开始构建。价格为至 2026 年 12 月 31 日每 100 万输入 token 0.75 美元、每 100 万输出 token 3.75 美元。自 2027 年 1 月 1 日起,恢复为输入 1.50 美元、输出 7.50 美元。请注意,该模型不支持音频生成、图像生成与 Live API,计算机使用功能仅为预览。
结语
在旗舰 Gemini 3.5 Pro 持续延期之际,Gemini 3.7 Flash 体现了 Google 的快速迭代与降价策略。
在 3.6 Flash 发布仅三周后即以半价推出改进版 Flash,表明公司正试图在中端市场取胜,而大多数生产量也的确集中于此。
坦白说,若您的工作负载是文档理解、可投产的网页与应用代码,或长上下文检索,这就是值得优先选择的模型:它在这些方面全面压过 Claude Sonnet 5 与 GPT-5.6 Terra,且成本只是其一小部分。
若您的瓶颈在最艰难的代理型终端编码,Terra 仍在 DeepSWE 与 Terminal-bench 上略有领先,而您也需要为这一“上限”多付费用。
随着 DeepMind 领导层调整与 Pro 模型延期,Google 正依靠 Flash 证明其仍具竞争力。就其新近公布的基准表看,对于一款中端模型,这一论点大体站得住脚。
如果您想亲手上手此类模型,建议先从我们的 AI Fundamentals 技能路径 打好基础,再将 Gemini 3.7 Flash 接入您自己的代理管线。