Let op: Slechts enkele weken na de lancering van Gemini 3.7 Flash bracht Google Gemini 3.8 Flash uit. Zie het in actie in onze Gemini 3.8 Flash API-tutorial.
Google heeft Gemini 3.7 Flash uitgebracht, zijn meest capabele Flash-model tot nu toe, gericht op codering en agentwerkstromen. De lancering komt terwijl Google’s vlaggenschip Gemini 3.5 Pro nog vertraagd is, wat Reuters aanhaalde als een test of DeepMind kan meekomen met Anthropic en OpenAI.
De opvallende cijfers zijn stevig. Gemini 3.7 Flash scoort 43,6% op FrontierCode 1.1 Main (omhoog van 34,4% voor 3.6 Flash), haalt 1588 Elo op Code Arena voor webontwikkeling en wordt geïntroduceerd voor $0,75 per 1M inputtokens en $3,75 per 1M outputtokens, de helft van de oorspronkelijke 3.6 Flash-kosten.
In dit artikel behandel ik alles wat nieuw is aan Gemini 3.7 Flash: de functies, de benchmarks en praktische tests die je zelf kunt draaien. Wil je dieper in de concurrenten duiken, bekijk dan onze gidsen voor GPT-5.6 Terra vs Claude Sonnet 5 en hoe je Claude leert gebruiken.
In een notendop
- Gemini 3.7 Flash is Google’s meest capabele Flash-model, gericht op codering en agentwerkstromen, met een contextvenster van 1M tokens.
- Introductieprijzen zijn $0,75/1M input en $3,75/1M outputtokens t/m 31 december 2026, daarna $1,50/$7,50 standaard.
- Het leidt FrontierCode 1.1 (43,6%), GDP.pdf (34,0%), Harvey LAB-AA (90,7%) en GDM-MRCR long context (97,0%) ten opzichte van Claude Sonnet 5 en GPT-5,6 Terra.
- GPT-5.6 Terra leidt nog steeds op DeepSWE, Terminal-bench en OSWorld agent-evaluaties.
- Beschikbaar via de Gemini API, Google Antigravity, Gemini Enterprise en Gemini Spark.
Wat is Gemini 3.7 Flash?
Gemini 3.7 Flash is Google’s mid-tier werkpaard, gepositioneerd als het meest capabele Flash-model voor complexe codering, agentwerkstromen en betrouwbare uitvoering in meerdere stappen. Het volgt Gemini 3.6 Flash op, dat drie weken eerder verscheen, en Google schrijft de kwaliteitswinst toe aan feedback van ontwikkelaars en algoritmische aanpassingen.
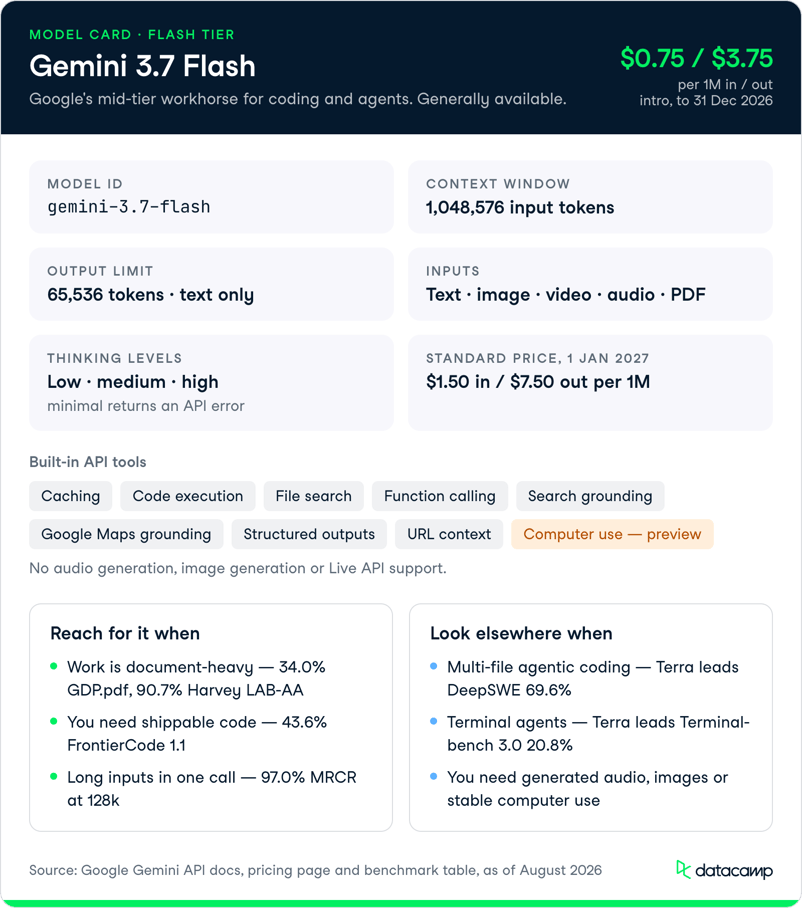
Het model is algemeen beschikbaar via de Gemini API met een contextvenster van 1M tokens (1.048.576 inputtokens) en een limiet van 65.536 outputtokens. Het accepteert tekst-, beeld-, video-, audio- en PDF-input en geeft alleen tekst terug. Google biedt instelbare denklevels laag, medium en hoog, al geeft de API een fout als je de niet-ondersteunde instelling minimal opvraagt.
De meest veelzeggende benchmarkkop is DeepSWE v1.1, een langetermijn-evaluatie voor software-engineering, waar 3.7 Flash 65,3% scoort tegenover 34,4% voor zijn voorganger op FrontierCode en slechts 48,6% voor 3.6 Flash op DeepSWE zelf. Dat is een grote generatie-overstijgende sprong voor een model dat óók in prijs is gedaald, wat ongebruikelijk is.
 Wat is er nieuw in Gemini 3.7 Flash?
Het verhaal hier: een capabeler Flash-model voor een lagere prijs, met betere instructie-opvolging en minder micromanagement in agentloops. Dit zijn de belangrijkste veranderingen voor praktijkgebruikers.
Sterkere codering en probleemoplossing
Je kunt Gemini 3.7 Flash zwaarder debug- en refactorwerk geven en een hogere nauwkeurigheid bij de eerste poging verwachten. Google rapporteert 43,6% op FrontierCode 1.1 Main voor productiecodekwaliteit, omhoog van 34,4% voor 3.6 Flash, en 65,3% op DeepSWE v1.1 voor langetermijn-software-engineering.
Voor werkende engineers betekent dit in de praktijk: minder retries. Volgens Google past het model zich beter aan obstakels aan en volgt het instructies nauwkeuriger, wat het handmatige toezicht vermindert dat goedkopere modellen in wandkloktijd alsnog duur maakt.
Snellere webapp- en UI-generatie
Gemini 3.7 Flash genereert functionele layouts en feature-complete webapps in minder prompts dan 3.6 Flash. Op de webontwikkelingsranglijst van Code Arena scoort het 1588 Elo tegenover 1538 voor 3.6 Flash en 1541 voor Claude Sonnet 5.
Het model kan ook een referentie-input volgen bij UI-generatie, of die referentie nu een screenshot, een afbeelding of een volledig designsysteem is. Geef je het een mock-up van een prijspagina, dan probeert het de ontwerpconsistentie te reproduceren in plaats van een generieke layout te improviseren.
Betere agent-uitvoering in meerdere stappen
Het model steekt meer effort in planning en toolcalls, precies waar goedkope modellen vaak onderuitgaan. Op AutomationBench, een private evaluatie voor echte bedrijfsworkflows, scoort 3.7 Flash 30,4% tegenover 17,0% voor 3.6 Flash en 10,7% voor Claude Sonnet 5.
Ingebouwde tools via de API omvatten caching, code-executie, bestandszoektocht, functieaanroepen, search grounding, grounding met Google Maps, gestructureerde outputs en URL-context. Computergebruik is aanwezig maar gemarkeerd als preview, dus ik zou er nog geen productie-agents omheen bouwen.
Verbeterd document- en kenniswerk
Gemini 3.7 Flash gaat beter om met kennisintensieve domeinen zoals finance, recht en biowetenschappen, met sterkere redenering en documentbegrip. Op de GDP.pdf-benchmark voor expert-PDF-begrip scoort het 34,0% tegenover 22,0% voor 3.6 Flash, en op Harvey LAB-AA voor complexe juridische workflows haalt het 90,7%.
Als je werk bestaat uit het extraheren van gestructureerde antwoorden uit dichtgetimmerde jaarverslagen of contracten, is dit de release die het testen waard is. Het model geeft nog steeds alleen tekst uit, dus het genereert niet de grafieken die het leest, maar beschrijft of vat ze samen.
Lagere prijs voor schaalbare agents
De introductieprijs halveert de kosten van Flash-gebaseerde agents ten opzichte van de lanseerprijzen van 3.6 Flash. Tot en met 31 december 2026 betaal je $0,75 per 1M inputtokens en $3,75 per 1M outputtokens.
- Input: $0,75 per 1M tokens (introductie), stijgend naar $1,50 per 1M op 1 januari 2027
- Output: $3,75 per 1M tokens (introductie), stijgend naar $7,50 per 1M op 1 januari 2027
Ter vergelijking: Claude Sonnet 5 zit op $2,00 input en $10,00 output in Google’s eigen benchmarktabel, en GPT-5.6 Terra op $2,00 input en $12,00 output. Op kale tokenprijs onderbiedt 3.7 Flash beide ruim.
Gemini 3.7 Flash-benchmarks
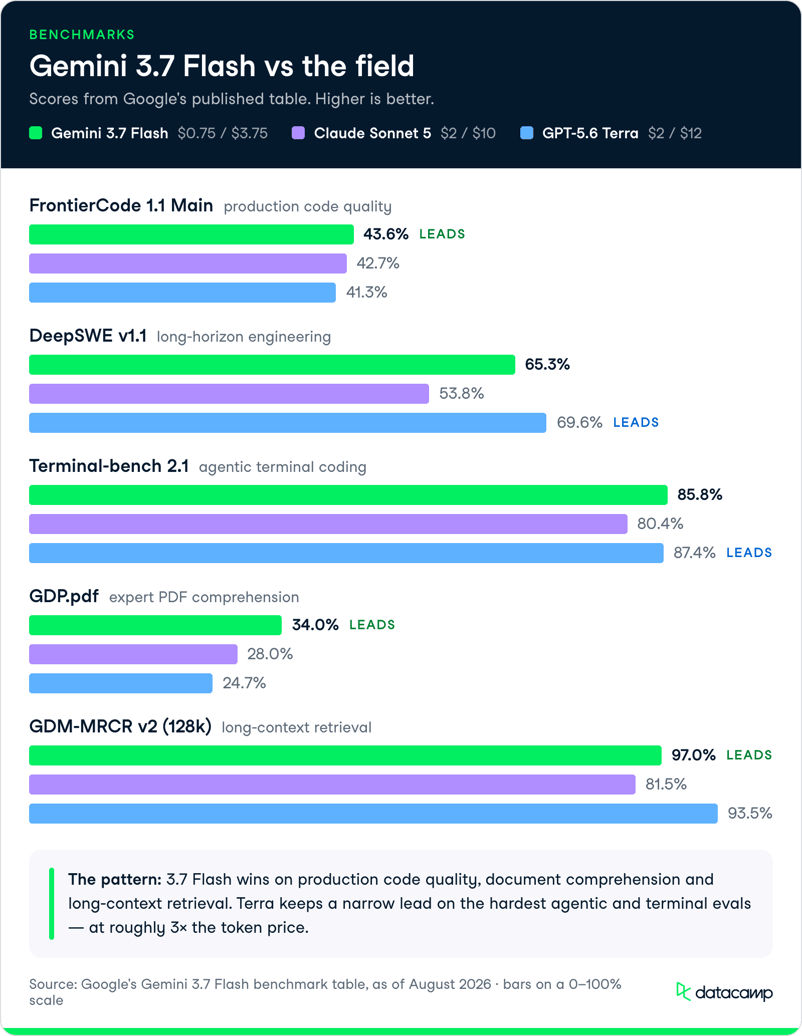
Google’s benchmarktabel zet Gemini 3.7 Flash af tegen 3.6 Flash, Claude Sonnet 5, GPT-5.6 Terra en Muse Spark 1.2. Het patroon is consistent: 3.7 Flash verslaat zijn voorganger op vrijwel elke evaluatie en wisselt klappen uit met duurdere rivalen, al heeft GPT-5.6 Terra een voorsprong op verschillende agentische code-evaluaties.
Gemini 3.7 Flash vs de rest in één oogopslag
Zo liggen de kerncijfers voor de vier modellen in Google’s benchmarktabel op een rij.
| Metric | Gemini 3.7 Flash | Claude Sonnet 5 | GPT-5.6 Terra |
|---|
| Inputprijs / 1M | $0.75 | $2.00 | $2.00 |
| Outputprijs / 1M | $3.75 | $10.00 | $12.00 |
| FrontierCode 1.1 Main | 43.6% | 42.7% | 41.3% |
| DeepSWE v1.1 | 65.3% | 53.8% | 69.6% |
| Terminal-bench 2.1 | 85.8% | 80.4% | 87.4% |
| GDP.pdf | 34.0% | 28.0% | 24.7% |
| GDM-MRCR v2 (128k) | 97.0% | 81.5% | 93.5% |
FrontierCode 1.1 Main
FrontierCode 1.1 Main meet productiecodekwaliteit en beloont dus code die correct en klaar voor gebruik is, niet alleen syntactisch geldig.
Gemini 3.7 Flash scoort 43,6%, vóór Claude Sonnet 5 met 42,7%, GPT-5.6 Terra met 41,3% en zijn eigen voorganger 3.6 Flash met 34,4%.
Dat een Flash-model beide toonaangevende rivalen voorbijstreeft op productiecodekwaliteit is hét opvallende resultaat van deze release, zeker voor een derde van hun tokenkosten.
DeepSWE v1.1
DeepSWE v1.1 test langetermijn-software-engineering, oftewel taken met meerdere bestanden die over veel stappen consistente context vereisen.
Hier scoort 3.7 Flash 65,3%, een grote sprong van 48,6% voor 3.6 Flash, maar GPT-5.6 Terra leidt met 69,6%, en Claude Sonnet 5 volgt met 53,8%.
De conclusie: 3.7 Flash heeft het grootste deel van de kloof met Terra op langetermijn-codering gedicht, maar is er niet overheen gegaan. Als je de absolute top nodig hebt voor agentische codering over meerdere bestanden, wint Terra die specifieke evaluatie nog steeds.
Terminal-bench 2.1 en 3.0
Terminal-bench meet agentische terminalcodering, waarbij het model een command line aanstuurt om taken te voltooien.
Op Terminal-bench 2.1 scoort 3.7 Flash 85,8% tegenover 78,0% voor 3.6 Flash en 80,4% voor Claude Sonnet 5, al leidt GPT-5.6 Terra met 87,4%.
De nieuwere Terminal-bench 3.0 voor algemene agentcapaciteiten is voor iedereen lastiger: 3.7 Flash scoort 14,9%, ruim boven 3.6 Flash met 5,4%, ongeveer gelijk aan Claude Sonnet 5 met 14,6%, en achter Terra met 20,8%.
Deze lage absolute cijfers zijn een nuttige reality check voor hoe ver de algemene betrouwbaarheid van agents nog moet gaan.
GDP.pdf en Harvey LAB-AA
GDP.pdf test expertbegrip van PDF-documenten, en Harvey LAB-AA test complexe juridische workflows.
Gemini 3.7 Flash leidt beide: 34,0% op GDP.pdf tegenover 28,0% voor Claude Sonnet 5 en 24,7% voor GPT-5.6 Terra, en 90,7% op Harvey LAB-AA tegenover 90,1% voor Sonnet 5 en 85,2% voor Terra.
Als je workload documentzware juridische of financiële analyse is, dan is dit waar het goedkoopste model in de tabel ook nog eens het meest accuraat is, een zeldzame combinatie.
GDM-MRCR v2 long context
GDM-MRCR v2 (8-needle) meet long-context retrieval en test of het model meerdere verborgen stukjes informatie kan vinden in een lange input.
Op het 128k-gemiddelde scoort 3.7 Flash 97,0%, vóór 3.6 Flash met 91,8%, Claude Sonnet 5 met 81,5% en GPT-5.6 Terra met 93,5%.
Met een contextvenster van 1M tokens en de sterkste 8-needle-retrieval op de tabel is 3.7 Flash een sterke keuze voor pipelines die grote documenten of lange transcripties in één call proppen.
Toen we Terra en Sonnet 5 vergeleken, was long-context retrieval een van de scherpere onderscheiders tussen hen, en 3.7 Flash zit nu boven beide in deze bandbreedte.
Waar GPT-5.6 Terra nog leidt
Het is goed om eerlijk te zijn over de verliezen.
GPT-5.6 Terra verslaat Gemini 3.7 Flash op DeepSWE v1.1 (69,6% vs 65,3%), Terminal-bench 2.1 (87,4% vs 85,8%), Terminal-bench 3.0 (20,8% vs 14,9%) en OSWorld-2.0 agentisch computergebruik (50,2% vs 47,9%).
Het patroon is dat Terra een kleine voorsprong houdt op de moeilijkste agentische en terminalcode-evaluaties, terwijl 3.7 Flash wint op productiecodekwaliteit, documentbegrip en long-context retrieval. Wat voor jou wint hangt ervan af of je bottleneck agentbetrouwbaarheid of kosten zijn.
Gemini 3.7 Flash: prijs en beschikbaarheid
Gemini 3.7 Flash is nu algemeen beschikbaar via verschillende Google-oppervlakken.
De API-model-ID is gemini-3.7-flash, en je kunt beginnen in Google AI Studio, Android Studio of de agent-first omgeving Google Antigravity.
- Developers: Gemini API via Google AI Studio en Android Studio; agentworkflows in Google Antigravity
- Enterprises: Gemini Enterprise Agent Platform en de Gemini Enterprise-app
- Individuen: Gemini Spark, de 24/7 persoonlijke agent in de Gemini-app, voor Google AI Pro- en Ultra-abonnees in meer dan 160 landen
De prijs is $0,75 per 1M inputtokens en $3,75 per 1M outputtokens t/m 31 december 2026. Op 1 januari 2027 gelden standaardtarieven van $1,50 input en $7,50 output. Let op: audiogeneratie, afbeeldingsgeneratie en de Live API worden niet ondersteund voor dit model, en computergebruik is alleen preview.
Slotgedachten
Gemini 3.7 Flash laat zien dat Google snel levert en prijzen verlaagt terwijl het vlaggenschip Gemini 3.5 Pro vertraagd blijft.
Een verbeterd Flash-model uitbrengen drie weken na 3.6 Flash, voor de helft van de tokenkosten, oogt als een bedrijf dat wil winnen in de mid-tier, waar het meeste productievolume zit.
Eerlijk gezegd is dit voor mij het model om te kiezen als je workload documentbegrip, productieklare web- en appcode of long-context retrieval is, waar het Claude Sonnet 5 en GPT-5.6 Terra direct verslaat terwijl het een fractie kost.
Als je bottleneck de lastigste agentische terminalcodering is, houdt Terra nog een kleine voorsprong op DeepSWE en Terminal-bench, en betaal je meer voor dat plafond.
Met de wisseling in het DeepMind-leiderschap en de vertraging van het Pro-model leunt Google op Flash om te bewijzen dat het nog kan concurreren. Op de benchmarktabel die het net publiceerde, gaat dat argument grotendeels op voor een mid-tier model.
Wil je zelf met dit soort modellen aan de slag, begin dan met onze AI Fundamentals skill track om een basis te leggen voordat je Gemini 3.7 Flash in je eigen agentpipelines integreert.


Let op: Slechts enkele weken na de lancering van Gemini 3.7 Flash bracht Google Gemini 3.8 Flash uit. Zie het in actie in onze Gemini 3.8 Flash API-tutorial.
Google heeft Gemini 3.7 Flash uitgebracht, zijn meest capabele Flash-model tot nu toe, gericht op codering en agentwerkstromen. De lancering komt terwijl Google’s vlaggenschip Gemini 3.5 Pro nog vertraagd is, wat Reuters aanhaalde als een test of DeepMind kan meekomen met Anthropic en OpenAI.
De opvallende cijfers zijn stevig. Gemini 3.7 Flash scoort 43,6% op FrontierCode 1.1 Main (omhoog van 34,4% voor 3.6 Flash), haalt 1588 Elo op Code Arena voor webontwikkeling en wordt geïntroduceerd voor $0,75 per 1M inputtokens en $3,75 per 1M outputtokens, de helft van de oorspronkelijke 3.6 Flash-kosten.
In dit artikel behandel ik alles wat nieuw is aan Gemini 3.7 Flash: de functies, de benchmarks en praktische tests die je zelf kunt draaien. Wil je dieper in de concurrenten duiken, bekijk dan onze gidsen voor GPT-5.6 Terra vs Claude Sonnet 5 en hoe je Claude leert gebruiken.
In een notendop
Wat is Gemini 3.7 Flash?
Gemini 3.7 Flash is Google’s mid-tier werkpaard, gepositioneerd als het meest capabele Flash-model voor complexe codering, agentwerkstromen en betrouwbare uitvoering in meerdere stappen. Het volgt Gemini 3.6 Flash op, dat drie weken eerder verscheen, en Google schrijft de kwaliteitswinst toe aan feedback van ontwikkelaars en algoritmische aanpassingen.
Het model is algemeen beschikbaar via de Gemini API met een contextvenster van 1M tokens (1.048.576 inputtokens) en een limiet van 65.536 outputtokens. Het accepteert tekst-, beeld-, video-, audio- en PDF-input en geeft alleen tekst terug. Google biedt instelbare denklevels laag, medium en hoog, al geeft de API een fout als je de niet-ondersteunde instelling
minimalopvraagt.De meest veelzeggende benchmarkkop is DeepSWE v1.1, een langetermijn-evaluatie voor software-engineering, waar 3.7 Flash 65,3% scoort tegenover 34,4% voor zijn voorganger op FrontierCode en slechts 48,6% voor 3.6 Flash op DeepSWE zelf. Dat is een grote generatie-overstijgende sprong voor een model dat óók in prijs is gedaald, wat ongebruikelijk is.
Het verhaal hier: een capabeler Flash-model voor een lagere prijs, met betere instructie-opvolging en minder micromanagement in agentloops. Dit zijn de belangrijkste veranderingen voor praktijkgebruikers.
Sterkere codering en probleemoplossing
Je kunt Gemini 3.7 Flash zwaarder debug- en refactorwerk geven en een hogere nauwkeurigheid bij de eerste poging verwachten. Google rapporteert 43,6% op FrontierCode 1.1 Main voor productiecodekwaliteit, omhoog van 34,4% voor 3.6 Flash, en 65,3% op DeepSWE v1.1 voor langetermijn-software-engineering.
Voor werkende engineers betekent dit in de praktijk: minder retries. Volgens Google past het model zich beter aan obstakels aan en volgt het instructies nauwkeuriger, wat het handmatige toezicht vermindert dat goedkopere modellen in wandkloktijd alsnog duur maakt.
Snellere webapp- en UI-generatie
Gemini 3.7 Flash genereert functionele layouts en feature-complete webapps in minder prompts dan 3.6 Flash. Op de webontwikkelingsranglijst van Code Arena scoort het 1588 Elo tegenover 1538 voor 3.6 Flash en 1541 voor Claude Sonnet 5.
Het model kan ook een referentie-input volgen bij UI-generatie, of die referentie nu een screenshot, een afbeelding of een volledig designsysteem is. Geef je het een mock-up van een prijspagina, dan probeert het de ontwerpconsistentie te reproduceren in plaats van een generieke layout te improviseren.
Betere agent-uitvoering in meerdere stappen
Het model steekt meer effort in planning en toolcalls, precies waar goedkope modellen vaak onderuitgaan. Op AutomationBench, een private evaluatie voor echte bedrijfsworkflows, scoort 3.7 Flash 30,4% tegenover 17,0% voor 3.6 Flash en 10,7% voor Claude Sonnet 5.
Ingebouwde tools via de API omvatten caching, code-executie, bestandszoektocht, functieaanroepen, search grounding, grounding met Google Maps, gestructureerde outputs en URL-context. Computergebruik is aanwezig maar gemarkeerd als preview, dus ik zou er nog geen productie-agents omheen bouwen.
Verbeterd document- en kenniswerk
Gemini 3.7 Flash gaat beter om met kennisintensieve domeinen zoals finance, recht en biowetenschappen, met sterkere redenering en documentbegrip. Op de GDP.pdf-benchmark voor expert-PDF-begrip scoort het 34,0% tegenover 22,0% voor 3.6 Flash, en op Harvey LAB-AA voor complexe juridische workflows haalt het 90,7%.
Als je werk bestaat uit het extraheren van gestructureerde antwoorden uit dichtgetimmerde jaarverslagen of contracten, is dit de release die het testen waard is. Het model geeft nog steeds alleen tekst uit, dus het genereert niet de grafieken die het leest, maar beschrijft of vat ze samen.
Lagere prijs voor schaalbare agents
De introductieprijs halveert de kosten van Flash-gebaseerde agents ten opzichte van de lanseerprijzen van 3.6 Flash. Tot en met 31 december 2026 betaal je $0,75 per 1M inputtokens en $3,75 per 1M outputtokens.
Ter vergelijking: Claude Sonnet 5 zit op $2,00 input en $10,00 output in Google’s eigen benchmarktabel, en GPT-5.6 Terra op $2,00 input en $12,00 output. Op kale tokenprijs onderbiedt 3.7 Flash beide ruim.
Gemini 3.7 Flash-benchmarks
Google’s benchmarktabel zet Gemini 3.7 Flash af tegen 3.6 Flash, Claude Sonnet 5, GPT-5.6 Terra en Muse Spark 1.2. Het patroon is consistent: 3.7 Flash verslaat zijn voorganger op vrijwel elke evaluatie en wisselt klappen uit met duurdere rivalen, al heeft GPT-5.6 Terra een voorsprong op verschillende agentische code-evaluaties.
Gemini 3.7 Flash vs de rest in één oogopslag
Zo liggen de kerncijfers voor de vier modellen in Google’s benchmarktabel op een rij.
FrontierCode 1.1 Main
FrontierCode 1.1 Main meet productiecodekwaliteit en beloont dus code die correct en klaar voor gebruik is, niet alleen syntactisch geldig.
Gemini 3.7 Flash scoort 43,6%, vóór Claude Sonnet 5 met 42,7%, GPT-5.6 Terra met 41,3% en zijn eigen voorganger 3.6 Flash met 34,4%.
Dat een Flash-model beide toonaangevende rivalen voorbijstreeft op productiecodekwaliteit is hét opvallende resultaat van deze release, zeker voor een derde van hun tokenkosten.
DeepSWE v1.1
DeepSWE v1.1 test langetermijn-software-engineering, oftewel taken met meerdere bestanden die over veel stappen consistente context vereisen.
Hier scoort 3.7 Flash 65,3%, een grote sprong van 48,6% voor 3.6 Flash, maar GPT-5.6 Terra leidt met 69,6%, en Claude Sonnet 5 volgt met 53,8%.
De conclusie: 3.7 Flash heeft het grootste deel van de kloof met Terra op langetermijn-codering gedicht, maar is er niet overheen gegaan. Als je de absolute top nodig hebt voor agentische codering over meerdere bestanden, wint Terra die specifieke evaluatie nog steeds.
Terminal-bench 2.1 en 3.0
Terminal-bench meet agentische terminalcodering, waarbij het model een command line aanstuurt om taken te voltooien.
Op Terminal-bench 2.1 scoort 3.7 Flash 85,8% tegenover 78,0% voor 3.6 Flash en 80,4% voor Claude Sonnet 5, al leidt GPT-5.6 Terra met 87,4%.
De nieuwere Terminal-bench 3.0 voor algemene agentcapaciteiten is voor iedereen lastiger: 3.7 Flash scoort 14,9%, ruim boven 3.6 Flash met 5,4%, ongeveer gelijk aan Claude Sonnet 5 met 14,6%, en achter Terra met 20,8%.
Deze lage absolute cijfers zijn een nuttige reality check voor hoe ver de algemene betrouwbaarheid van agents nog moet gaan.
GDP.pdf en Harvey LAB-AA
GDP.pdf test expertbegrip van PDF-documenten, en Harvey LAB-AA test complexe juridische workflows.
Gemini 3.7 Flash leidt beide: 34,0% op GDP.pdf tegenover 28,0% voor Claude Sonnet 5 en 24,7% voor GPT-5.6 Terra, en 90,7% op Harvey LAB-AA tegenover 90,1% voor Sonnet 5 en 85,2% voor Terra.
Als je workload documentzware juridische of financiële analyse is, dan is dit waar het goedkoopste model in de tabel ook nog eens het meest accuraat is, een zeldzame combinatie.
GDM-MRCR v2 long context
GDM-MRCR v2 (8-needle) meet long-context retrieval en test of het model meerdere verborgen stukjes informatie kan vinden in een lange input.
Op het 128k-gemiddelde scoort 3.7 Flash 97,0%, vóór 3.6 Flash met 91,8%, Claude Sonnet 5 met 81,5% en GPT-5.6 Terra met 93,5%.
Met een contextvenster van 1M tokens en de sterkste 8-needle-retrieval op de tabel is 3.7 Flash een sterke keuze voor pipelines die grote documenten of lange transcripties in één call proppen.
Toen we Terra en Sonnet 5 vergeleken, was long-context retrieval een van de scherpere onderscheiders tussen hen, en 3.7 Flash zit nu boven beide in deze bandbreedte.
Waar GPT-5.6 Terra nog leidt
Het is goed om eerlijk te zijn over de verliezen.
GPT-5.6 Terra verslaat Gemini 3.7 Flash op DeepSWE v1.1 (69,6% vs 65,3%), Terminal-bench 2.1 (87,4% vs 85,8%), Terminal-bench 3.0 (20,8% vs 14,9%) en OSWorld-2.0 agentisch computergebruik (50,2% vs 47,9%).
Het patroon is dat Terra een kleine voorsprong houdt op de moeilijkste agentische en terminalcode-evaluaties, terwijl 3.7 Flash wint op productiecodekwaliteit, documentbegrip en long-context retrieval. Wat voor jou wint hangt ervan af of je bottleneck agentbetrouwbaarheid of kosten zijn.
Gemini 3.7 Flash: prijs en beschikbaarheid
Gemini 3.7 Flash is nu algemeen beschikbaar via verschillende Google-oppervlakken.
De API-model-ID is
gemini-3.7-flash, en je kunt beginnen in Google AI Studio, Android Studio of de agent-first omgeving Google Antigravity.De prijs is $0,75 per 1M inputtokens en $3,75 per 1M outputtokens t/m 31 december 2026. Op 1 januari 2027 gelden standaardtarieven van $1,50 input en $7,50 output. Let op: audiogeneratie, afbeeldingsgeneratie en de Live API worden niet ondersteund voor dit model, en computergebruik is alleen preview.
Slotgedachten
Gemini 3.7 Flash laat zien dat Google snel levert en prijzen verlaagt terwijl het vlaggenschip Gemini 3.5 Pro vertraagd blijft.
Een verbeterd Flash-model uitbrengen drie weken na 3.6 Flash, voor de helft van de tokenkosten, oogt als een bedrijf dat wil winnen in de mid-tier, waar het meeste productievolume zit.
Eerlijk gezegd is dit voor mij het model om te kiezen als je workload documentbegrip, productieklare web- en appcode of long-context retrieval is, waar het Claude Sonnet 5 en GPT-5.6 Terra direct verslaat terwijl het een fractie kost.
Als je bottleneck de lastigste agentische terminalcodering is, houdt Terra nog een kleine voorsprong op DeepSWE en Terminal-bench, en betaal je meer voor dat plafond.
Met de wisseling in het DeepMind-leiderschap en de vertraging van het Pro-model leunt Google op Flash om te bewijzen dat het nog kan concurreren. Op de benchmarktabel die het net publiceerde, gaat dat argument grotendeels op voor een mid-tier model.
Wil je zelf met dit soort modellen aan de slag, begin dan met onze AI Fundamentals skill track om een basis te leggen voordat je Gemini 3.7 Flash in je eigen agentpipelines integreert.