
课程
Practical AI with Google Gemini and NotebookLM
2 小时
10K
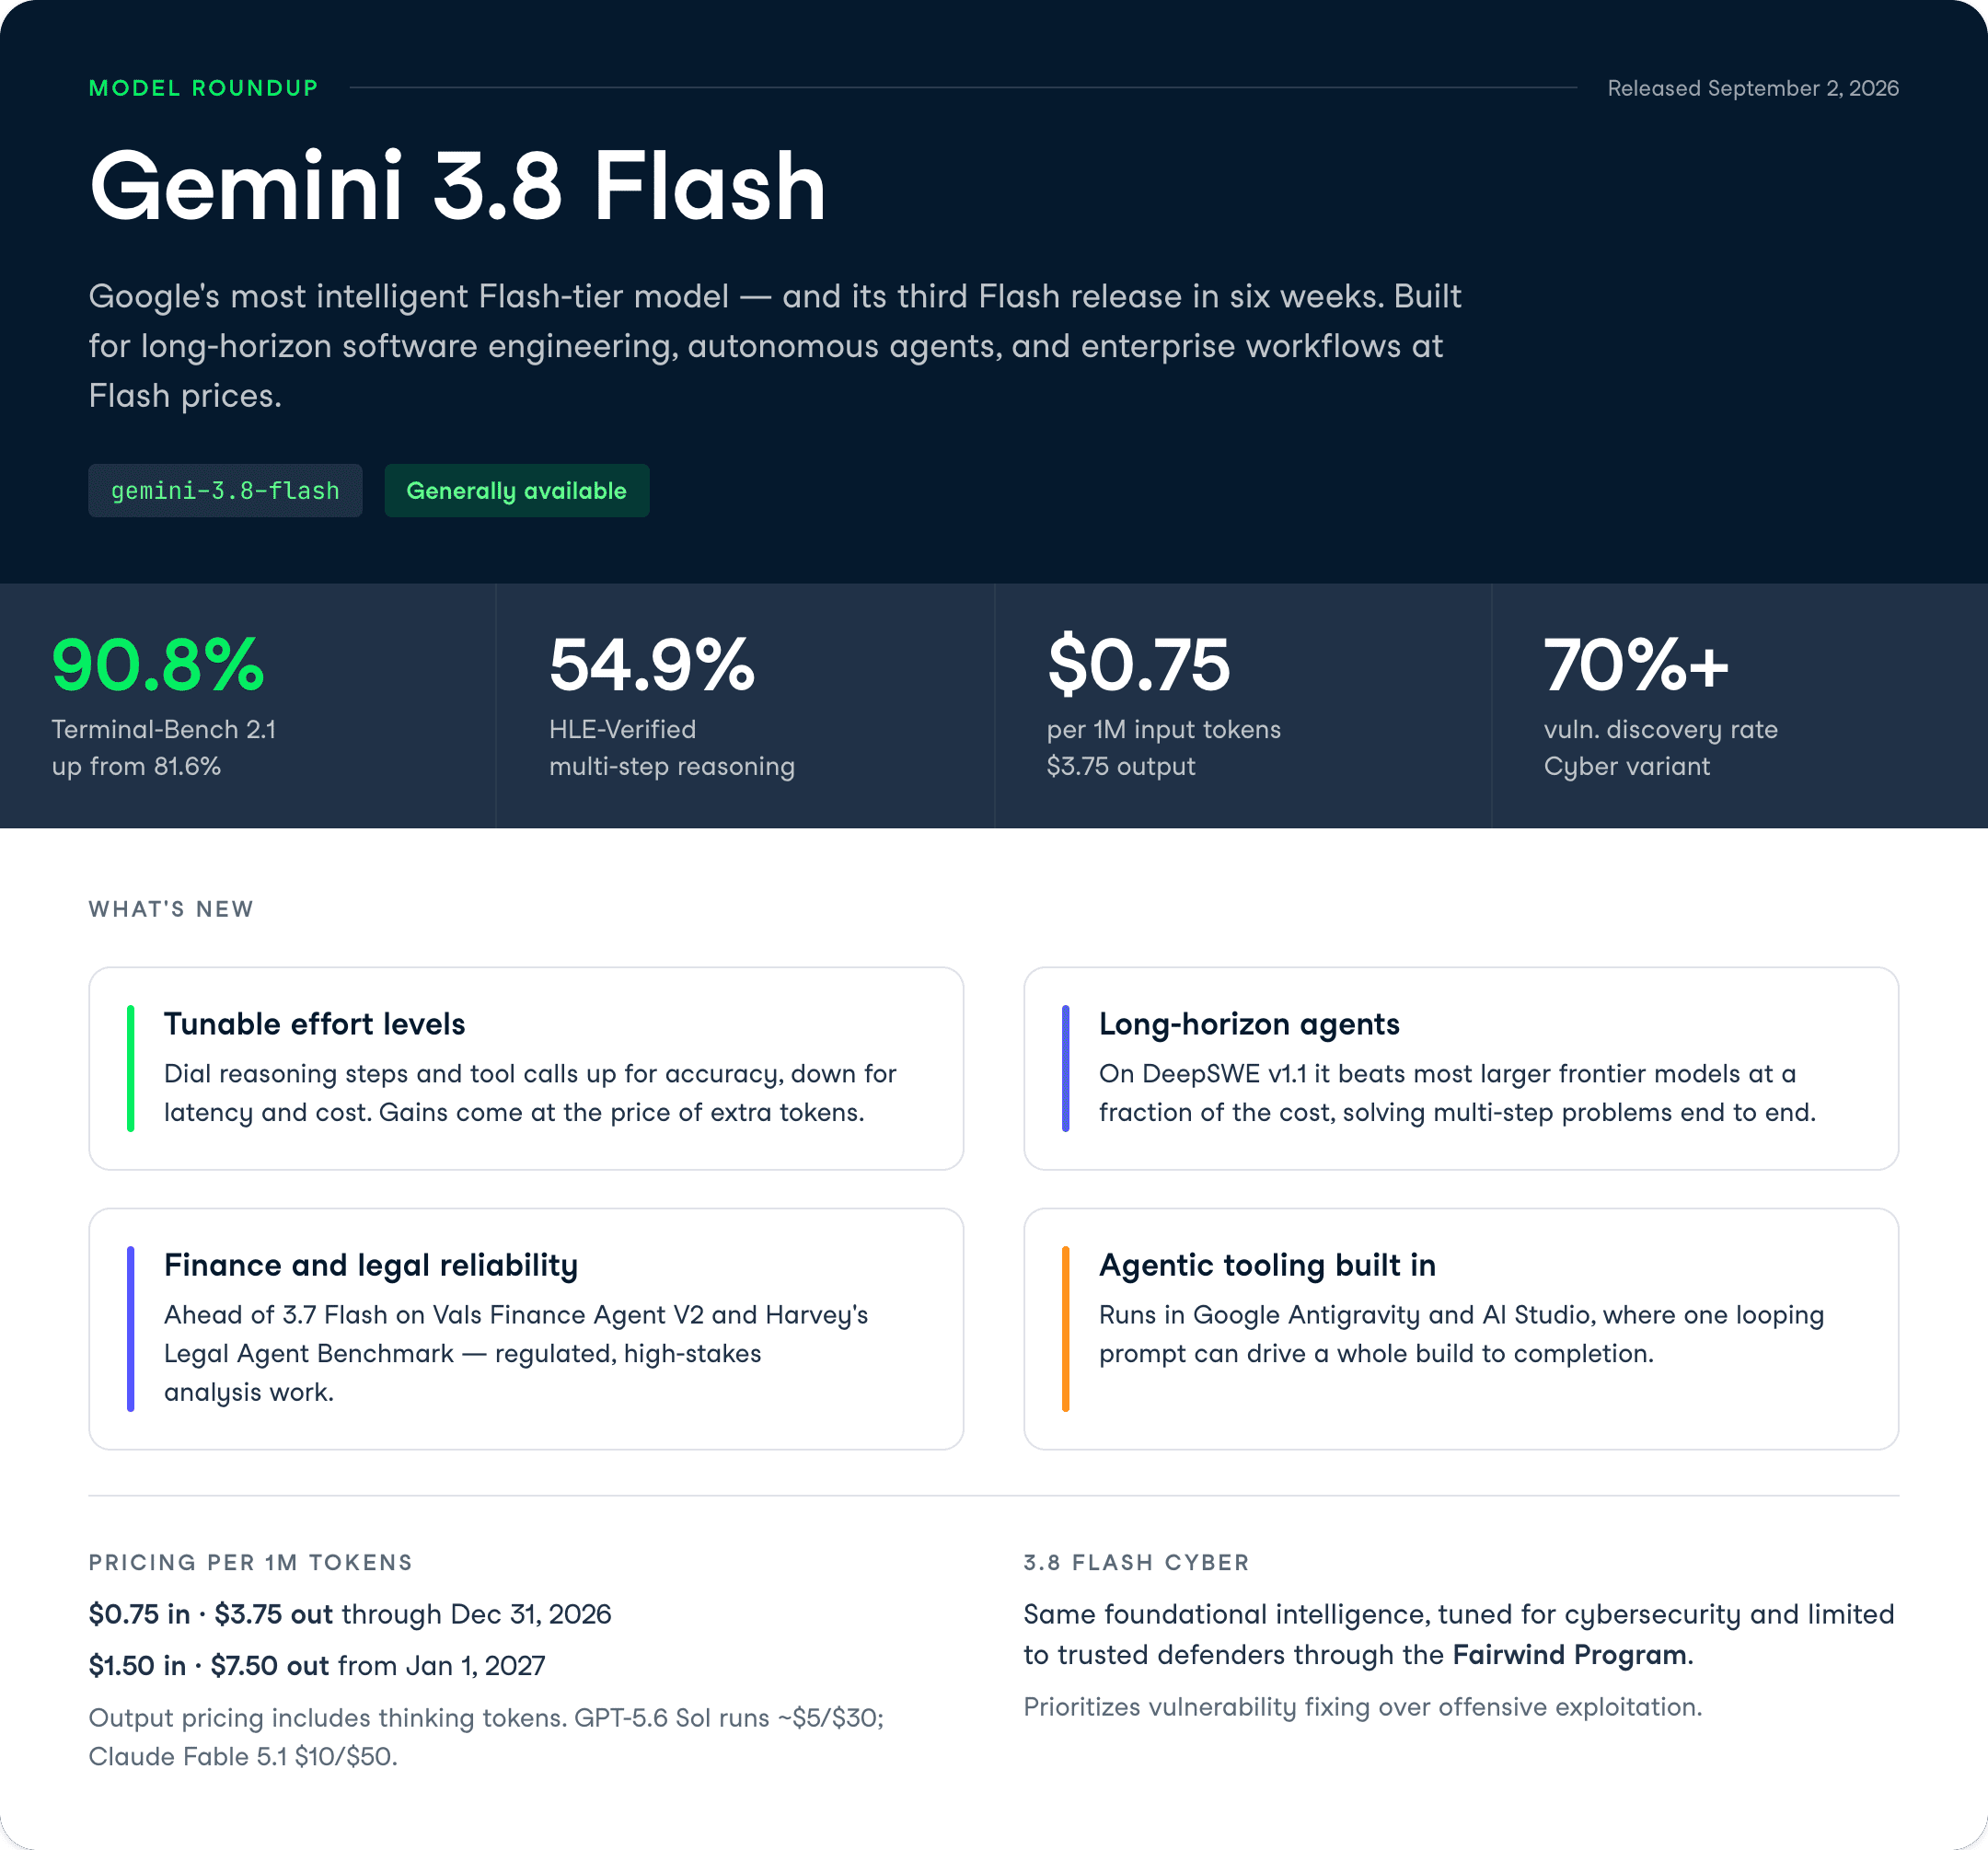
Google 正在以难以跟上的速度发布 Flash 系列模型。Gemini 3.8 Flash 是该公司六周内发布的第三个 Flash 模型,在保持与三周前的 3.7 Flash 相同的速度和低成本的同时,成为 Flash 阶梯中推理与编程能力最强的模型。
除了标准模型,Google 还推出了 Gemini 3.8 Flash Cyber,这是一款为网络安全工作调优的变体,仅通过 Fairwind Program(与新模型同日上线的受限访问项目)向受信任的防御方开放。两者共享相同的基础智能。
亮点数据相当强劲:Gemini 3.8 Flash 在 Terminal-Bench 2.1 上得分 90.8%(较 3.7 Flash 的 81.6% 大幅提升),HLE-Verified 得分 54.9%,而 Cyber 变体在真实场景中的漏洞发现率超过 70%。
本文将全面介绍 Gemini 3.8 Flash 与 3.8 Flash Cyber 的新变化,涵盖新功能、基准测试,并通过上手示例检验其表现。您可在我们的 Gemini 3.8 Flash API 教程中查看模型实际效果,并在我们的Gemini 3.8 Live指南中了解 Google 最新的语音助手模型。
想快速了解其竞争对手,请参阅我们的对比指南:DeepSeek v4.1 vs Gemini 3.8 Flash 与 Claude Opus 5 vs Sonnet 5。
Gemini 3.8 Flash 是 Google 最智能的 Flash 阶梯模型,专为长时程软件工程、自主代理,以及复杂的企业级工作流而设计。
它定位低于 Pro 阶梯(如 Gemini 3.1 Pro),但价格仅为其一小部分,并在 2026 年 12 月 31 日前维持每 100 万输入 token $0.75、每 100 万输出 token $3.75 的入门价。
与 3.7 Flash 的主要差别在于:3.8 Flash 会“更卖力”。
在复杂任务上,它会执行额外的推理步骤并迭代调用工具,这使其性能接近更高成本的前沿模型。代价是 token 开销:在更高“努力等级”下,模型可能会消耗更多 token 来挤出最后几分准确度。
最醒目的基准成绩来自 Terminal-Bench 2.1:3.8 Flash 得分 90.8%,而 3.7 Flash 为 81.6%。Terminal-Bench 衡量模型端到端完成真实命令行与编程任务的可靠性,因此 9 分的跃升直接指向更好的“代理式编程”行为。
 Gemini 3.8 Flash 有哪些新变化?
3.8 Flash 的功能更面向运行代理和长时间编程会话的开发者,而非普通闲聊用户。
以下是值得关注的能力。
您可以根据更重视准确性还是成本,灵活调高或调低模型的“努力”。
这很重要,因为 3.8 Flash 的提升是以额外 token 为代价取得的。
如果您的工作负载以效率优先,Google 明确表示您可以继续使用 3.7 Flash,且其将获得完整支持。
对于 Google 来说,在发布帖中加入这样的说明相当坦诚,也表明“努力拨盘”是真实的权衡,而非免费性能。
Gemini 3.8 Flash 旨在运行无需手把手引导、可完成多步工程问题的代理。
在长时程软件工程基准 DeepSWE v1.1 上,它以更低成本优于多数更大的前沿模型,同时能端到端解决复杂问题。
对于构建编程代理的从业者,这个指标至关重要。
Reddit 与 X 上的提前体验者称其为“以 Flash 价位达到 Fable 5 水平的性能”,而华尔街日报的报道也提到,在 Google 内部的 Jetski 正面对比测试中,工程师更偏好用于编程的 3.8 Flash 而非 Anthropic 的 Opus 模型。
这是一个颇具进攻性的竞争主张,值得在 API 广泛开放后加以验证。
3.8 Flash 面向受监管、高风险、错误代价高的领域。
它在 Vals Finance Agent V2 与 Harvey's Legal Agent Benchmark 上优于 3.7 Flash 和其他前沿模型,这两项基准测试金融与法律领域的分析与报告能力。
设想一个工作流:代理阅读一组季度文件并起草合规摘要,或将合同条款与政策对照审阅。此类任务对可靠性的要求不同于通用聊天,Google 正将 3.8 Flash 直接定位为这些知识领域中的企业级自主方案。
Gemini 3.8 Flash 运行在 Google Antigravity 与 Google AI Studio 中,单个循环提示即可驱动完整构建流程。
Google 自己的示例是一款完全可玩的 DOS 风格 Google 地图,由 Antigravity 中的一条提示生成,包含地点、路线和街景。
在您的工作中,不妨设想输入一句话:“构建一个交互式仪表板,读取此 CSV,绘制三种图表,并支持按地区筛选”,然后让代理式循环迭代直至可运行。
循环指令模式能放大高努力等级的价值,因为模型会持续打磨,而非停留在初稿。
基准成绩并不均衡——这比“全面领先”更有参考价值,因为它能告诉您提升落在哪里。
编程与终端任务显著提升,而考试型推理几乎未动。
以下数据来自 Google 的开发者文档与公告。
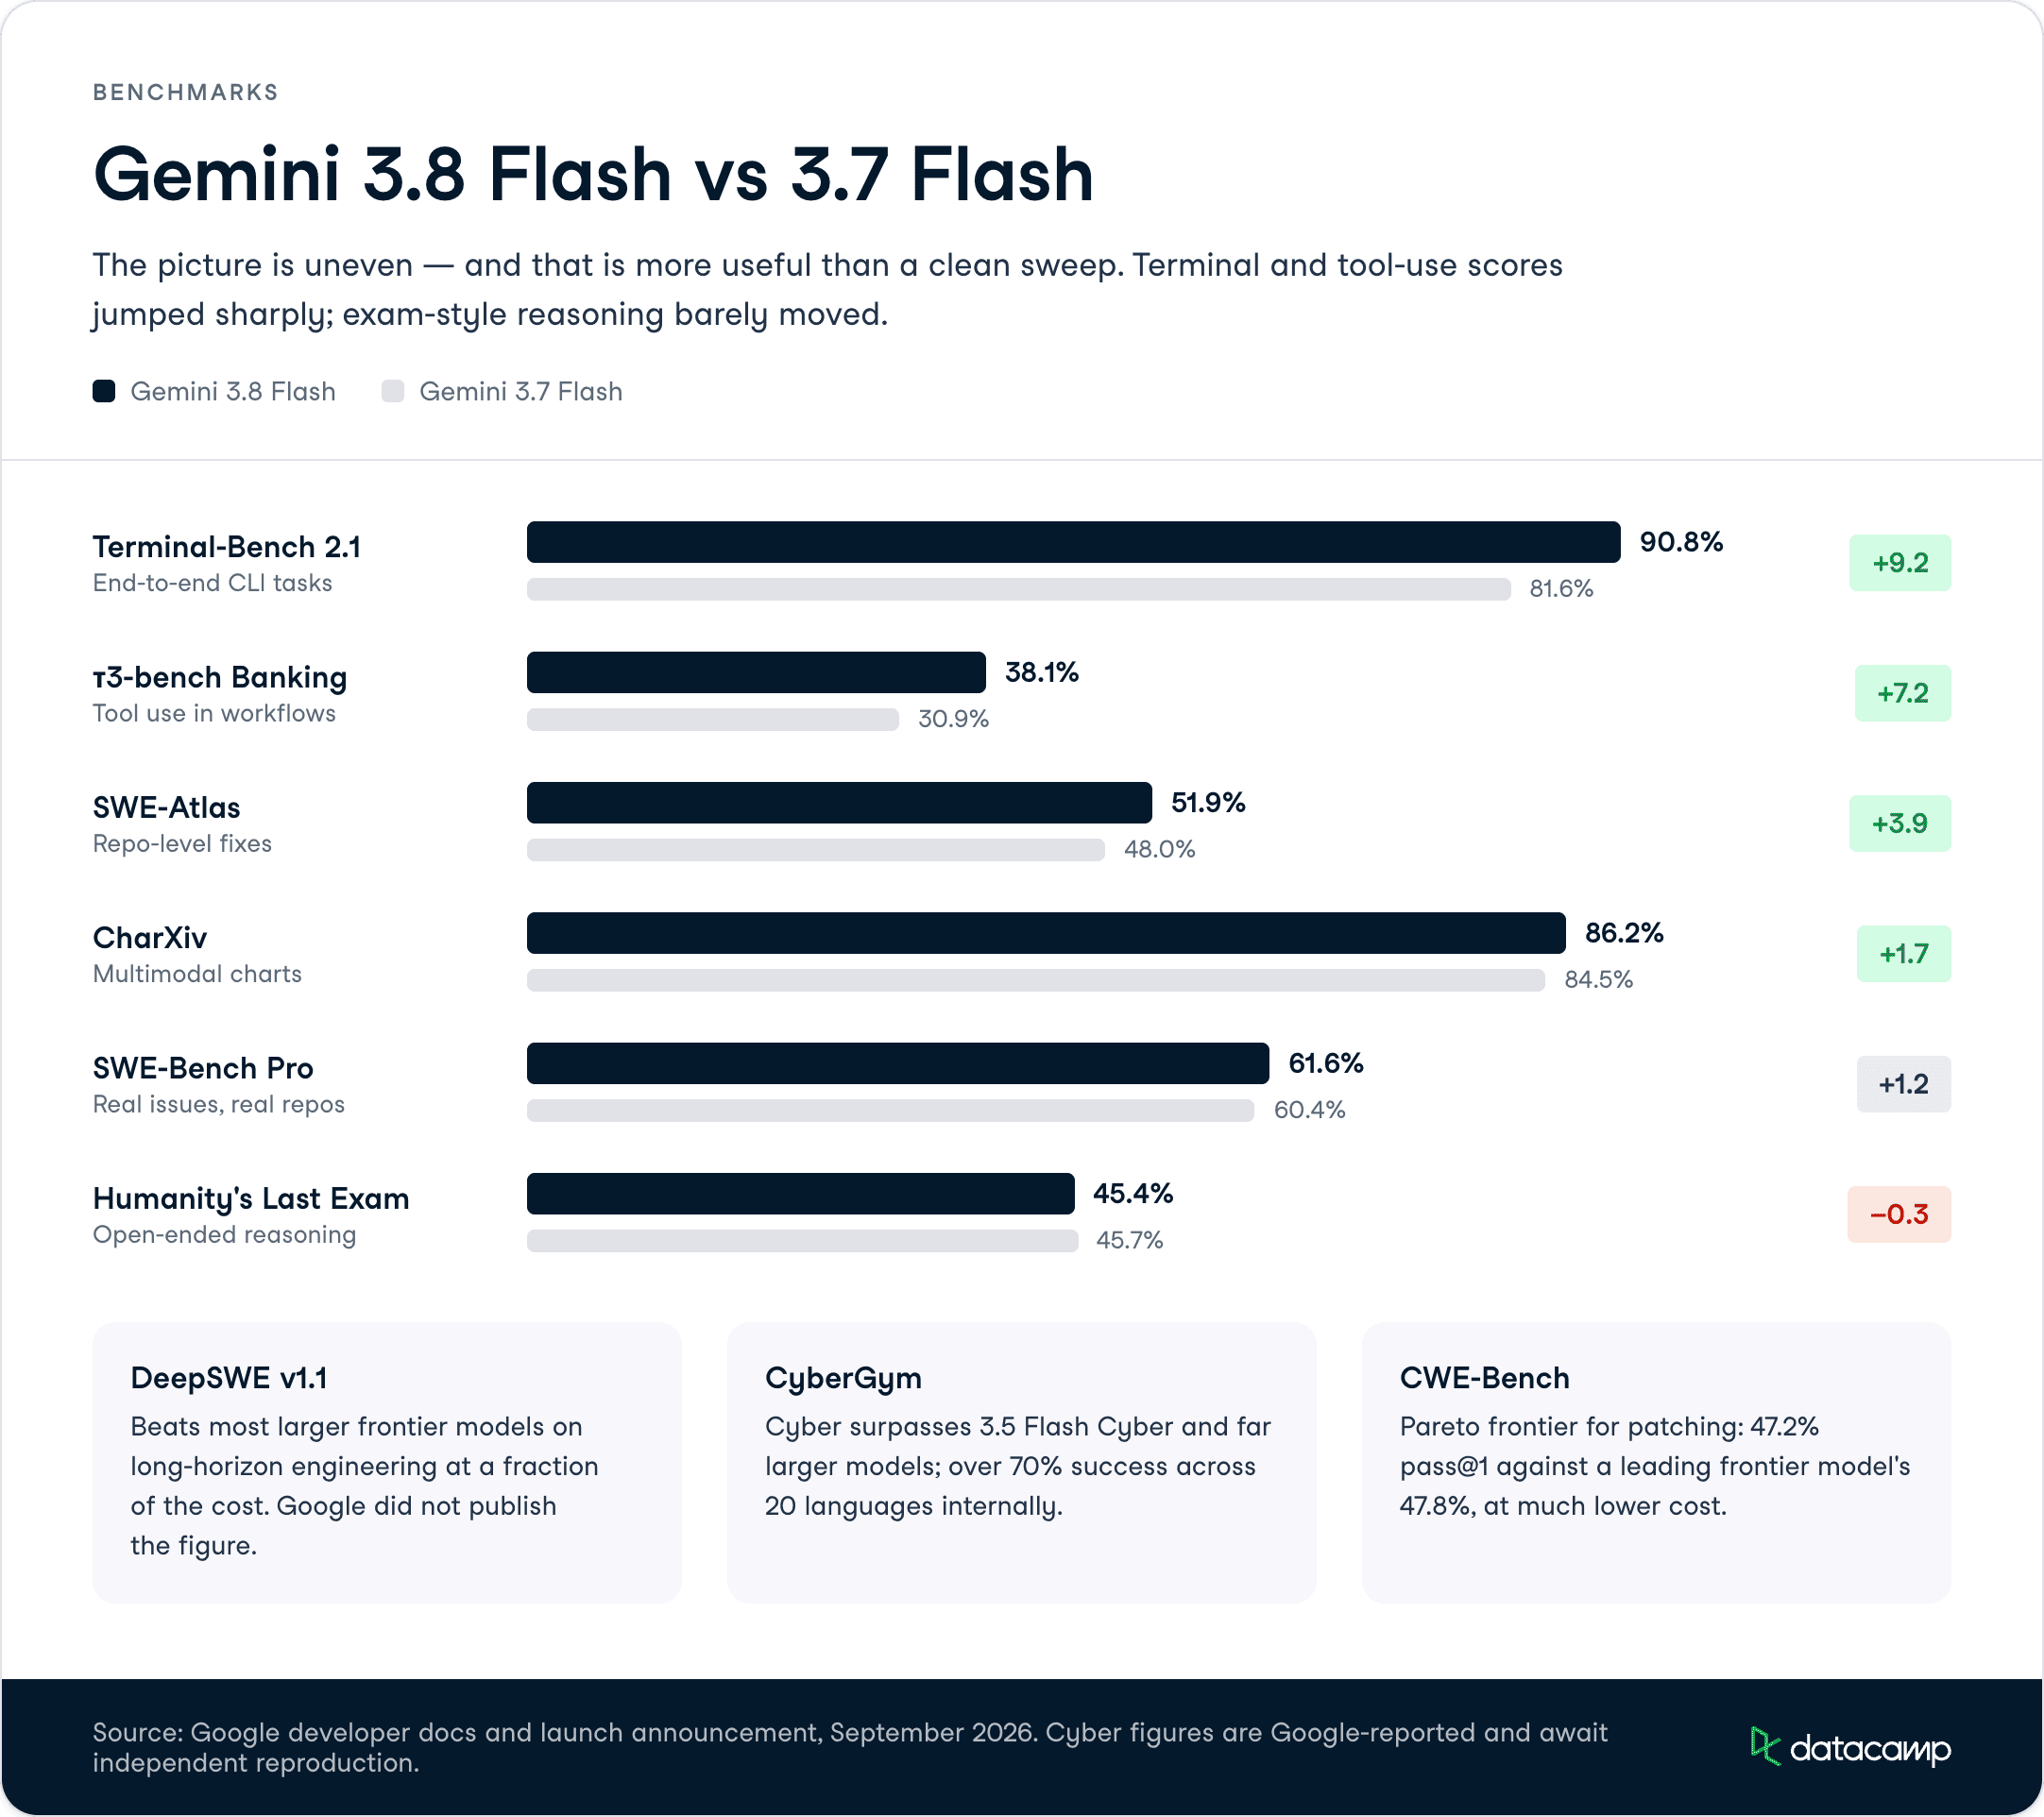
Gemini 3.8 Flash 在 Terminal-Bench 2.1 上得分 90.8%,高于 3.7 Flash 的 81.6%。
该基准衡量模型从头到尾完成真实命令行与编程任务的可靠性,包括运行工具与从错误中恢复。
作为中端竞品背景参考,在我们的GPT-5.6 Terra vs Claude Sonnet 5 对比中,Terra 在 Terminal-Bench 2.1 上得分 87.4%,Sonnet 5 为 80.4%。在这条分数线上,3.8 Flash 的 90.8% 略胜二者——对于一款每 100 万输入 token 收费 $0.75 的 Flash 阶梯模型而言,颇具意义。
在长时程软件工程基准 DeepSWE v1.1 上,3.8 Flash 以更低成本优于多数更大的前沿模型。
Google 在提炼笔记中未公布精确百分比,但强调其能自主、端到端地解决复杂工程问题。
这是支撑“能把活儿干完的代理”这一卖点的基准。
如果您的工作负载涉及代理对代码库进行多步迭代,相比一次性的编程评分,DeepSWE 更贴近您的现实。
在 SWE-Bench Pro 上,3.8 Flash 得分 61.6%,对比 3.7 Flash 的 60.4%;在 SWE-Atlas 上为 51.9%,对比 48.0%。
这些都是仓库级的软件工程基准,衡量在真实代码库中修复真实问题的能力。
SWE-Bench Pro 仅 1 分多的提升较为温和,值得注意。更大的跃升出现在 Terminal-Bench 上,因此如果您特别在意终端与工具的可靠性,3.8 Flash 正是在此处与前代拉开差距。
3.8 Flash 在 HLE-Verified(跨理工、人文与专业领域的多步推理测试)上达到 54.9%。
而在 Google 开发者文档更广泛的 Humanity's Last Exam 对比中,分数基本持平:3.8 Flash 为 45.4%,3.7 Flash 为 45.7%。
通用考试型推理并未显著进步,因此如果您的用例偏重高难度的开放式推理,而非编程与工具使用,从 3.7 升级到 3.8 Flash 或许不值额外 token。
Gemini 3.8 Flash Cyber 在漏洞发现与修复上给出前沿级表现。
在行业标准的自主漏洞发现基准 CyberGym 上,它超越了 3.5 Flash Cyber 与体量更大的前沿模型;在覆盖 20 种编程语言的 Google 内部基准上,其成功率超过 70%。
在由 Collinear 运行的外部修复基准 CWE-Bench 上,Cyber 位于帕累托前沿,pass@1 为 47.2%,接近领先前沿模型的 47.8%,且成本更低。
Google 有意将优先级放在漏洞修复而非进攻性利用上,这与 Anthropic 默认为 Sonnet 5 启用网络安全防护的做法相呼应(正如我们在Opus 5 vs Sonnet 5 评测中所述,其在 Firefox 漏洞开发评测上为 0.0%)。
下表展示了新模型与其发布仅数周的前代之间的对比:
| 基准 | Gemini 3.8 Flash | Gemini 3.7 Flash |
|---|---|---|
| Terminal-Bench 2.1 | 90.8% | 81.6% |
| SWE-Bench Pro | 61.6% | 60.4% |
| SWE-Atlas | 51.9% | 48.0% |
| τ³-bench Banking | 38.1% | 30.9% |
| CharXiv(多模态) | 86.2% | 84.5% |
| Humanity's Last Exam | 45.4% | 45.7% |
Gemini 3.8 Flash 已通过 Google AI Studio 与 Gemini Enterprise Agent Platform 面向大众提供,发布于 2026 年 9 月 2 日,API 模型 ID 为 gemini-3.8-flash。
3.8 Flash Cyber 变体仅通过 Fairwind Program 向受信任防御方开放,未面向大众发布。
定价延续 3.7 Flash 的入门价:
以 2026 年 9 月的竞品为参照:GPT-5.6 Sol 约为每 100 万 token 输入 $5、输出 $30,新的 Claude Fable 5.1 为输入 $10、输出 $50。
Gemini 3.8 Flash 以显著优势压低两者价格,这正是 Flash 阶梯的意义所在。
Gemini 3.8 Flash 展示了 Google 在编程模型价值端的强力推进,策略清晰:以 $0.75 的输入价匹配接近前沿的编程性能,并以每隔几周一款的节奏持续发布新 Flash 模型。
Terminal-Bench 2.1 上的 90.8% 与不足 $1 的定价,使其成为代理式编程工作负载的有力默认选择。
我的看法是,这次发布并不均衡,而 Google 也坦承这一点。
终端与工具使用分数跃升,DeepSWE 以及金融与法律基准有所提升,但 HLE 基本持平,SWE-Bench Pro 几乎未动。
如果您构建编程代理,这是对 3.7 Flash 的一次实质性升级。
如果您需要高难度的开放式推理,升级的理由较弱,为效率优先工作继续使用 3.7 Flash 是合理选择。
从长期看,Cyber 变体更耐人寻味。真实场景 70%+ 的漏洞发现率与位于帕累托前沿的修复能力,辅以 Fairwind Program 的准入门槛,并在防御优先于利用的倾向下运作,对于已将其用于自家代码安全的公司而言,是一种可辩护的定位。
在完全接受 CyberGym 与 CWE-Bench 的数字前,我希望看到独立复现实验,因为目前几乎所有数据都来自 Google 自身。
如果您希望围绕此类模型构建代理与编程工作流,我们的 AI Agent Fundamentals 技能路径是一个不错的起点。
DataCamp 热门课程
课程
课程
课程