当今最成功的组织在决策中高度依赖数据。许多具备数据通识能力的组织每天都会生成数百万行数据,供各类团队使用和分析。要让团队具备访问和使用数据的能力,其中一个关键挑战是确保数据被收集、可信、可靠、可行动且可被发现。
为在复杂的数据版图中前行,许多组织开发并开源了自研技术,即数据发现工具。
在一次近期的网络研讨会中,DataCamp 产品研究副总裁 Ramnath Vaidyanathan 阐述了组织如何从“数据被动”(无人具备相关技能或访问权限)走向“数据通识”(人人都能访问并具备使用数据与做出数据驱动决策的技能)。组织可以通过投资于 IPTOP 框架(基础设施、人才、工具、组织与流程)来提升数据成熟度。随着组织通过数据基础设施投资来扩大数据访问,他们需要通过数据发现工具来提供便捷的数据可发现性。
如果人们无法访问数据、不了解所收集数据的背景、找不到所需内容,那么数据就无用可用。这正是数据发现工具至关重要的原因。——Ramnath Vaidyanathan,DataCamp 产品研究副总裁
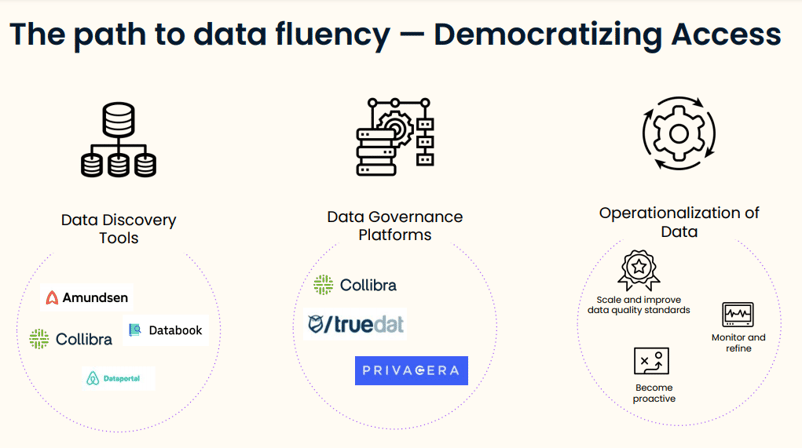
许多数据驱动型公司已在其数据基础设施中部署了数据发现工具。我们来看看诸如 Uber Databook 与 Lyft Amundsen 等知名数据发现工具背后的动因与驱动力。
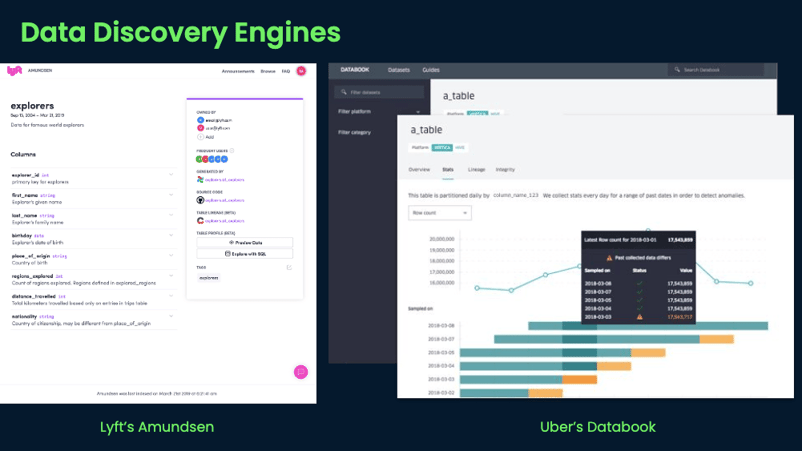
需要关注的数据发现挑战
数据发现的一大挑战在于生产力与合规性。Lyft 指出,随着其数据规模呈指数级增长,并预计在未来至少 10 年以相似速度继续增长,这些挑战愈发突出。在开发 Amundsen 时,他们注意到分析师约有 25% 的时间花在数据发现上。同时,他们在所服务国家面临愈加严格的合规要求。
Uber 也表达了类似担忧,因为其业务从网约车主业扩展到 Uber Eats、Uber Freight 与 Jump Bikes 等服务。开发 Databook 时,Uber 每天有超过 1500 万次出行、并在不同团队中拥有 18,000 名员工。另一个挑战在于其数据存在于多种形式,包括 Hive、Presto 和 Vertica。分析师需要能够高效访问并理解各类数据源,以实现数据通识。
Facebook 构建了 Nemo 数据发现平台,以在角色与地域不断扩展、数据规模与复杂度不断提升的背景下,满足对高质量、可信数据的需求。由于所分析数据涉及隐私问题,Facebook 在向特定分析师开放数据表时也面临重大合规性要求。
Airbnb 的 John Bodley 在 2017 年一次大会演讲中提到:“随着 Airbnb 的发展,数据在体量、复杂度与晦涩程度上的挑战也随之增长。”这意味着员工常常发现数据“被割裂、难以访问且缺乏背景”。结果是员工会重复创建数据表,如果不信任数据就不会使用。Airbnb 开发了 Dataportal,通过消除这些阻碍高效数据分析的障碍,大幅提升数据发现流程的效率。
这些挑战具有普遍性、与行业无关,适用于任何希望在组织内扩大数据驱动决策的机构。随着组织致力于实现数据通识,对易于发现的数据的需求将变得至关重要。
既然我们已了解数据发现的挑战,接下来看看各类数据发现工具如何应对这些问题。Uber将成功的数据发现平台目标分解为四个组成部分:
- 可扩展性:能够轻松为数据表添加元数据、存储与实体
- 可访问性:能够以编程方式访问所有元数据
- 可伸缩性:能够支持大量并发读取请求
- 能力:能够在多个数据中心间支持读写请求
随着组织的数据能力不断成熟,实现这些数据发现目标的程度也会提升。随着数据规模扩大,上述每一项能力都愈发重要。
Lyft 的工程团队认为,“元数据是未来应用的圣杯”。他们将元数据分为两类。第一类是用于描述的数据集,包括应用上下文(即人们为使用数据需要了解的内容)、行为(即谁拥有特定数据集及其常见使用模式)和变更(即数据集随时间如何变化)。第二类是被描述的数据,即组织中以任意格式存储的任何数据,如数据存储、仪表盘、数据流等。
在开发 Airbnb 的数据发现平台 Dataportal 时,元数据是其为数据管道增值的核心组成部分。在 Dataportal 引入之前,由于缺乏上下文与元数据,许多员工对所用数据并不信任。Airbnb 认为,“对整个数据生态的理解——从事件日志的产出到其在可视化中的消费——所带来的价值大于各部分价值之和。”
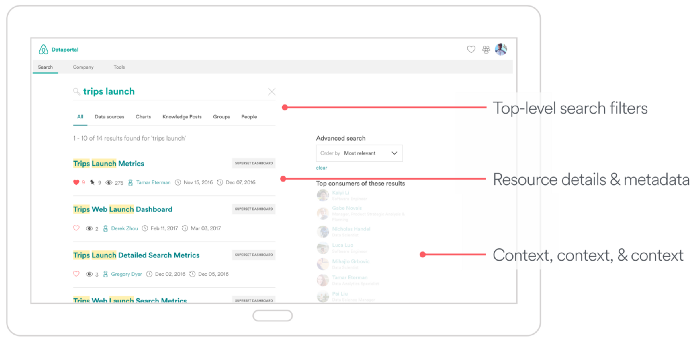
通过数据发现确保高质量搜索结果
在具备这些上下文后,数据发现离不开高效搜索。无论每张数据表多么可信、易懂,只有当分析师能快速找到所需数据时,数据发现平台才真正有用。
Lyft Amundsen 的落地页允许用户使用自然语言查询搜索数据表,并提供组织内最常用数据表的可见性以便快速访问。此外,分析师可以选择对数据表留下反馈,以优化后续搜索结果。
Facebook 的数据发现方案 Nemo,允许分析师按使用情况、隐私限制与数据新近程度进行筛选,同时借助 Facebook 在自然语言处理方面的优势,支持用户在搜索栏中输入问题以获取相关数据表。
Uber Databook 则提供类似的搜索筛选能力,允许分析师按名称、所有者、列及嵌套列等维度进行过滤。Uber 利用 Elasticsearch 快速高效地返回搜索结果。
通过数据发现实现数据民主化
扩大数据通识与提升数据可发现性相辅相成,因为分析师需要便捷地访问数据,才能做出以数据为依据的决策。
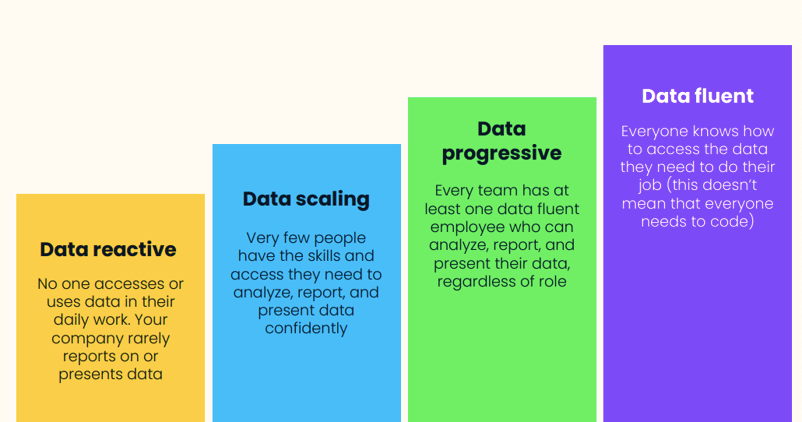
数据成熟度较低的组织应着重于构建数据技能与文化,并扩展数据基础设施。然而,随着组织在数据成熟度道路上不断进步并扩大数据访问,构建可扩展、可伸缩的数据发现能力将成为迈向数据驱动型组织的关键。欲深入了解推动组织数据成熟度提升的各项杠杆,您可观看我们的网络研讨会:通往数据通识之路,或参与数据成熟度评估。

当今最成功的组织在决策中高度依赖数据。许多具备数据通识能力的组织每天都会生成数百万行数据,供各类团队使用和分析。要让团队具备访问和使用数据的能力,其中一个关键挑战是确保数据被收集、可信、可靠、可行动且可被发现。
为在复杂的数据版图中前行,许多组织开发并开源了自研技术,即数据发现工具。
在一次近期的网络研讨会中,DataCamp 产品研究副总裁 Ramnath Vaidyanathan 阐述了组织如何从“数据被动”(无人具备相关技能或访问权限)走向“数据通识”(人人都能访问并具备使用数据与做出数据驱动决策的技能)。组织可以通过投资于 IPTOP 框架(基础设施、人才、工具、组织与流程)来提升数据成熟度。随着组织通过数据基础设施投资来扩大数据访问,他们需要通过数据发现工具来提供便捷的数据可发现性。
数据通识型公司如何使用数据发现工具
许多数据驱动型公司已在其数据基础设施中部署了数据发现工具。我们来看看诸如 Uber Databook 与 Lyft Amundsen 等知名数据发现工具背后的动因与驱动力。
需要关注的数据发现挑战
数据发现的一大挑战在于生产力与合规性。Lyft 指出,随着其数据规模呈指数级增长,并预计在未来至少 10 年以相似速度继续增长,这些挑战愈发突出。在开发 Amundsen 时,他们注意到分析师约有 25% 的时间花在数据发现上。同时,他们在所服务国家面临愈加严格的合规要求。
Uber 也表达了类似担忧,因为其业务从网约车主业扩展到 Uber Eats、Uber Freight 与 Jump Bikes 等服务。开发 Databook 时,Uber 每天有超过 1500 万次出行、并在不同团队中拥有 18,000 名员工。另一个挑战在于其数据存在于多种形式,包括 Hive、Presto 和 Vertica。分析师需要能够高效访问并理解各类数据源,以实现数据通识。
Facebook 构建了 Nemo 数据发现平台,以在角色与地域不断扩展、数据规模与复杂度不断提升的背景下,满足对高质量、可信数据的需求。由于所分析数据涉及隐私问题,Facebook 在向特定分析师开放数据表时也面临重大合规性要求。
Airbnb 的 John Bodley 在 2017 年一次大会演讲中提到:“随着 Airbnb 的发展,数据在体量、复杂度与晦涩程度上的挑战也随之增长。”这意味着员工常常发现数据“被割裂、难以访问且缺乏背景”。结果是员工会重复创建数据表,如果不信任数据就不会使用。Airbnb 开发了 Dataportal,通过消除这些阻碍高效数据分析的障碍,大幅提升数据发现流程的效率。
这些挑战具有普遍性、与行业无关,适用于任何希望在组织内扩大数据驱动决策的机构。随着组织致力于实现数据通识,对易于发现的数据的需求将变得至关重要。
数据发现工具的四大核心目标
既然我们已了解数据发现的挑战,接下来看看各类数据发现工具如何应对这些问题。Uber将成功的数据发现平台目标分解为四个组成部分:
随着组织的数据能力不断成熟,实现这些数据发现目标的程度也会提升。随着数据规模扩大,上述每一项能力都愈发重要。
Lyft 和 Airbnb 提供详尽的元数据
Lyft 的工程团队认为,“元数据是未来应用的圣杯”。他们将元数据分为两类。第一类是用于描述的数据集,包括应用上下文(即人们为使用数据需要了解的内容)、行为(即谁拥有特定数据集及其常见使用模式)和变更(即数据集随时间如何变化)。第二类是被描述的数据,即组织中以任意格式存储的任何数据,如数据存储、仪表盘、数据流等。
在开发 Airbnb 的数据发现平台 Dataportal 时,元数据是其为数据管道增值的核心组成部分。在 Dataportal 引入之前,由于缺乏上下文与元数据,许多员工对所用数据并不信任。Airbnb 认为,“对整个数据生态的理解——从事件日志的产出到其在可视化中的消费——所带来的价值大于各部分价值之和。”
来源:Airbnb
通过数据发现确保高质量搜索结果
在具备这些上下文后,数据发现离不开高效搜索。无论每张数据表多么可信、易懂,只有当分析师能快速找到所需数据时,数据发现平台才真正有用。
Lyft Amundsen 的落地页允许用户使用自然语言查询搜索数据表,并提供组织内最常用数据表的可见性以便快速访问。此外,分析师可以选择对数据表留下反馈,以优化后续搜索结果。
Facebook 的数据发现方案 Nemo,允许分析师按使用情况、隐私限制与数据新近程度进行筛选,同时借助 Facebook 在自然语言处理方面的优势,支持用户在搜索栏中输入问题以获取相关数据表。
Uber Databook 则提供类似的搜索筛选能力,允许分析师按名称、所有者、列及嵌套列等维度进行过滤。Uber 利用 Elasticsearch 快速高效地返回搜索结果。
通过数据发现实现数据民主化
扩大数据通识与提升数据可发现性相辅相成,因为分析师需要便捷地访问数据,才能做出以数据为依据的决策。
数据成熟度较低的组织应着重于构建数据技能与文化,并扩展数据基础设施。然而,随着组织在数据成熟度道路上不断进步并扩大数据访问,构建可扩展、可伸缩的数据发现能力将成为迈向数据驱动型组织的关键。欲深入了解推动组织数据成熟度提升的各项杠杆,您可观看我们的网络研讨会:通往数据通识之路,或参与数据成熟度评估。