आज की सबसे सफल संस्थाएँ निर्णय लेने के लिए बड़े पैमाने पर डेटा पर निर्भर हैं। इनमें से कई डेटा-कुशल संगठन हर दिन लाखों पंक्तियों का डेटा बनाते हैं, जिनका उपयोग विभिन्न टीमों द्वारा किया और विश्लेषित किया जाता है। टीमों को डेटा तक पहुँचने और उस पर काम करने की क्षमता देने की एक प्रमुख चुनौती यह सुनिश्चित करना है कि डेटा संग्रहीत, विश्वसनीय, भरोसेमंद, क्रियान्वयन योग्य, और खोजने योग्य हो।
इन जटिल डेटा परिदृश्यों में दिशा पाने के लिए, कई संगठनों ने इन-हाउस तकनीकें विकसित की हैं और उन्हें ओपन-सोर्स भी किया है, जिन्हें डेटा डिस्कवरी टूल्स कहा जाता है।
हालिया वेबिनार में, DataCamp के VP of Product Research, Ramnath Vaidyanathan बताते हैं कि संगठन डेटा-प्रतिक्रियात्मक स्थिति, जहाँ किसी के पास डेटा पर काम करने के कौशल या पहुँच नहीं होती, से डेटा-कुशल स्थिति तक कैसे जा सकते हैं, जहाँ हर किसी के पास डेटा पर काम करने और डेटा-आधारित निर्णय लेने के लिए पहुँच और कौशल होते हैं। संगठन IPTOP फ्रेमवर्क—इन्फ्रास्ट्रक्चर, लोग, टूल्स, संगठन, और प्रक्रियाएँ—में निवेश के जरिए अपनी डेटा परिपक्वता बढ़ा सकते हैं। जैसे-जैसे संगठन डेटा इन्फ्रास्ट्रक्चर में निवेश करके डेटा की पहुँच बढ़ाते हैं, उन्हें डेटा डिस्कवरी टूल्स के साथ आसान डेटा खोज-क्षमता प्रदान करनी होगी।
यदि लोग डेटा तक पहुँच ही नहीं पाते, यदि वे एकत्र किए गए डेटा का संदर्भ नहीं समझते, और जो उन्हें चाहिए वह नहीं ढूँढ पाते, तो डेटा उपयोगी नहीं है। इसी कारण डेटा डिस्कवरी टूल्स अत्यंत महत्वपूर्ण हैं। — Ramnath Vaidyanathan, VP of Product Research, DataCamp
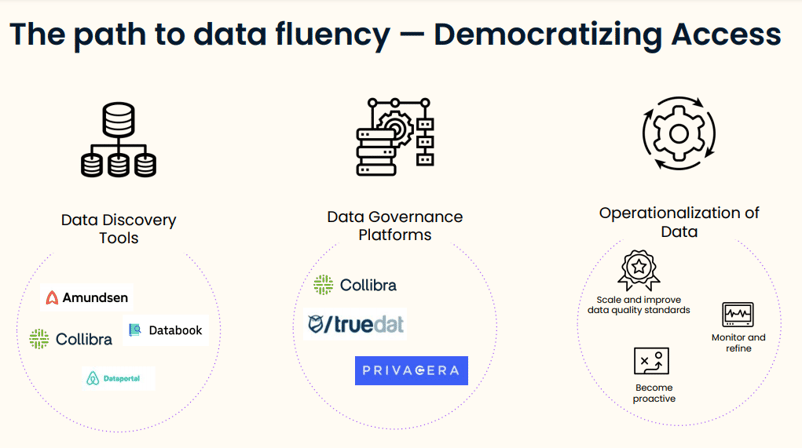
कई डेटा-चालित कंपनियों ने अपनी डेटा इन्फ्रास्ट्रक्चर में डेटा डिस्कवरी टूल्स लागू किए हैं। आइए Uber Databook और Lyft Amundsen जैसे प्रमुख डेटा डिस्कवरी टूल्स के पीछे की प्रेरणाओं और कारकों की जाँच करें।
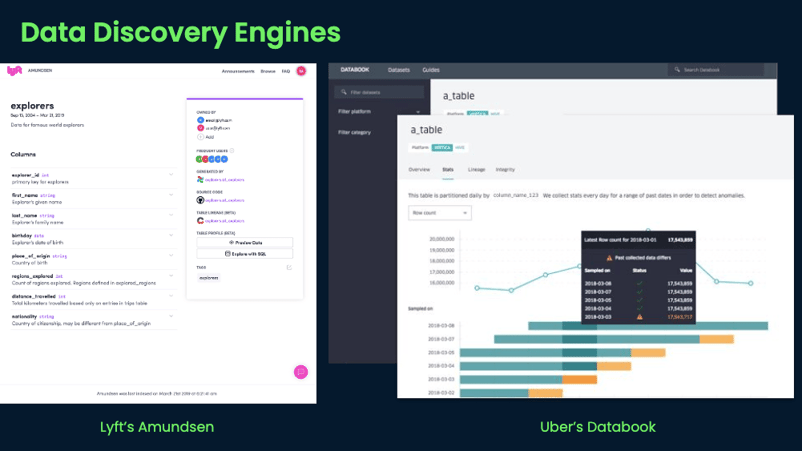
ध्यान देने योग्य डेटा डिस्कवरी चुनौतियाँ
एक प्रमुख डेटा डिस्कवरी चुनौती है उत्पादकता और अनुपालन। Lyft ने बताया कि जैसे-जैसे उसके डेटा का आकार घातीय रूप से बढ़ा और कम से कम अगले 10 वर्षों तक इसी दर से बढ़ने का अनुमान था, उसे इन चुनौतियों का सामना करना पड़ा। Amundsen विकसित करते समय उन्होंने नोट किया कि एक विश्लेषक का लगभग 25% समय डेटा डिस्कवरी में चला जाता था। जिन देशों में वे सेवाएँ देते थे, वहाँ अनुपालन की माँगें भी लगातार कड़ी होती जा रही थीं।
Uber ने भी समान चिंताएँ व्यक्त कीं जब उसने अपनी प्राथमिक राइड-शेयरिंग ऐप से आगे बढ़कर Uber Eats, Uber Freight, और Jump Bikes जैसी सेवाओं में विस्तार करना शुरू किया। Databook विकसित करते समय, Uber के पास रोज़ाना 1.5 करोड़ से अधिक यात्राएँ और विभिन्न टीमों में 18,000 कर्मचारी थे। एक और चुनौती यह थी कि उसका डेटा कई अलग-अलग रूपों में मौजूद था, जिनमें Hive, Presto, और Vertica शामिल थे। विश्लेषकों को डेटा फ्लुएंसी हासिल करने के लिए विभिन्न डेटा स्रोतों तक कुशलतापूर्वक पहुँचने और उन्हें समझने में सक्षम होना आवश्यक था।
Facebook ने अपना Nemo डेटा डिस्कवरी प्लेटफ़ॉर्म इसलिए बनाया ताकि भूमिकाओं और भौगोलिक स्थानों में डेटा के आकार और जटिलता बढ़ने के साथ उच्च-गुणवत्ता और भरोसेमंद डेटा की आवश्यकता को पूरा किया जा सके। जिन डेटा का वे विश्लेषण करते हैं, उनसे जुड़ी गोपनीयता चिंताओं के कारण, Facebook को विशिष्ट विश्लेषकों को टेबल उपलब्ध कराते समय महत्वपूर्ण अनुपालन मुद्दों का भी समाधान करना पड़ा।
Airbnb के John Bodley ने 2017 के एक सम्मेलन में दिए गए भाषण में कहा, “जैसे-जैसे Airbnb बढ़ता है, वैसे-वैसे डेटा की मात्रा, जटिलता, और अस्पष्टता से जुड़ी चुनौतियाँ भी बढ़ती हैं।” इसका अर्थ है कि कर्मचारियों को अक्सर डेटा “अलग-थलग, दुर्गम, और संदर्भहीन” लगता था। नतीजतन, कर्मचारी डुप्लिकेट टेबल बना रहे थे और यदि उन्हें डेटा पर भरोसा नहीं होता था, तो वे उसका उपयोग नहीं करते थे। Airbnb ने Dataportal विकसित किया ताकि उत्पादक डेटा विश्लेषण में आने वाली इन बाधाओं को दूर करके डेटा डिस्कवरी प्रक्रिया को कहीं अधिक कुशल बनाया जा सके।
ये चुनौतियाँ व्यापक हैं, उद्योग-निर्पेक्ष हैं, और किसी भी ऐसे संगठन पर लागू होती हैं जो डेटा-आधारित निर्णय-निर्माण को स्केल करना चाहता है। जैसे-जैसे संगठन डेटा-कुशल बनने की ओर अग्रसर होंगे, आसानी से खोजने योग्य डेटा की आवश्यकता अत्यंत महत्वपूर्ण होती जाएगी।
अब जब हम डेटा डिस्कवरी चुनौतियों को समझ गए हैं, तो देखते हैं कि विभिन्न डेटा डिस्कवरी टूल्स उन्हें कैसे संबोधित करते हैं। Uber एक सफल डेटा डिस्कवरी प्लेटफ़ॉर्म के लक्ष्यों को चार घटकों में विभाजित करता है:
- विस्तार-क्षमता: टेबलों में मेटाडेटा, स्टोरेज, और एंटिटी को आसानी से जोड़ने की क्षमता
- एक्सेसिबिलिटी: सभी मेटाडेटा तक प्रोग्रामेटिक रूप से पहुँचने की क्षमता
- स्केलेबिलिटी: बहुत अधिक समवर्ती रीड रिक्वेस्ट का समर्थन करने की क्षमता
- शक्ति: कई डेटा सेंटर्स में रीड और राइट रिक्वेस्ट का समर्थन करने की क्षमता
जैसे-जैसे संगठन अपनी डेटा दक्षताओं को परिपक्व करते हैं, इन डेटा डिस्कवरी लक्ष्यों की प्राप्ति बढ़ती जाती है। उनके डेटा के पैमाने के बढ़ने के साथ, इन प्रत्येक घटकों का महत्व और अधिक बढ़ जाता है।
Lyft की इंजीनियरिंग टीम का तर्क है कि “मेटाडेटा भविष्य के अनुप्रयोगों का पवित्र कंघी है।” वे मेटाडेटा को दो उपश्रेणियों में बाँटते हैं। पहली, वर्णनात्मक डेटा का सेट है, जिसमें एप्लिकेशन संदर्भ (अर्थात, डेटा के साथ काम करने के लिए मनुष्यों को क्या जानना चाहिए), व्यवहार (अर्थात, किसी विशेष डेटासेट का स्वामी कौन है और उसके सामान्य उपयोग पैटर्न क्या हैं), और परिवर्तन (अर्थात, समय के साथ डेटासेट कैसे बदल रहा है) शामिल हैं। दूसरा घटक वह डेटा है जिसका वर्णन किया जा रहा है—जो संगठन में किसी भी प्रारूप में संग्रहीत कोई भी डेटा हो सकता है, जैसे डाटा स्टोर्स, डैशबोर्ड, डाटा स्ट्रीम्स, आदि।
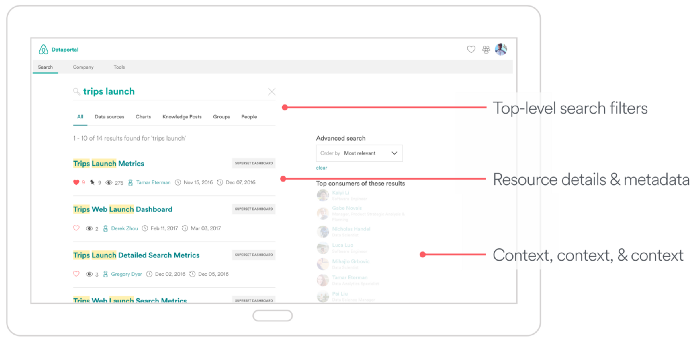
Dataportal, Airbnb का डेटा डिस्कवरी प्लेटफ़ॉर्म, विकसित करते समय, मेटाडेटा डेटा पाइपलाइन में प्लेटफ़ॉर्म के जोड़े गए मूल्य का अभिन्न हिस्सा था। Dataportal के आने से पहले, संदर्भ और मेटाडेटा की कमी के कारण कई कर्मचारी उस डेटा पर भरोसा नहीं करते थे जिसका वे उपयोग कर रहे थे। Airbnb का मानना है कि “पूरे डेटा इकोसिस्टम की समझ—किसी इवेंट लॉग के निर्माण से लेकर उसके विज़ुअलाइज़ेशन में उपभोग तक—अपने हिस्सों के योग से अधिक मूल्य प्रदान करती है।”
डेटा डिस्कवरी के साथ उच्च-गुणवत्ता वाले खोज परिणाम सुनिश्चित करें
एक बार यह संदर्भ उपलब्ध हो जाने पर, डेटा डिस्कवरी के लिए प्रभावी खोज आवश्यक है। प्रत्येक टेबल कितनी ही भरोसेमंद और आसानी से समझने योग्य क्यों न हो, डेटा डिस्कवरी प्लेटफ़ॉर्म तभी उपयोगी हैं जब विश्लेषक अपनी ज़रूरत का डेटा जल्दी से ढूँढ सकें।
Lyft Amundsen का लैंडिंग पेज उपयोगकर्ताओं को प्राकृतिक भाषा क्वेरी के माध्यम से टेबल खोजने देता है और त्वरित पहुँच के लिए संगठन में सबसे लोकप्रिय टेबलों की दृश्यता प्रदान करता है। साथ ही, विश्लेषक भविष्य की खोज परिणामों को बेहतर बनाने के लिए टेबल पर फीडबैक भी दे सकते हैं।
Facebook का डेटा डिस्कवरी समाधान, Nemo, विश्लेषकों को उपयोग, गोपनीयता प्रतिबंधों, और डेटा की नवीनता पर फ़िल्टर करने देता है, साथ ही उपयोगकर्ताओं को सर्च बार में प्रश्न टाइप करके प्रासंगिक टेबल पाने की सुविधा देकर Facebook की प्राकृतिक भाषा प्रसंस्करण क्षमता का लाभ उठाता है।
Uber Databook भी समान खोज-फ़िल्टरिंग क्षमताएँ प्रदान करता है, जिससे विश्लेषक नाम, स्वामी, कॉलम, और नेस्टेड कॉलम जैसे आयामों पर फ़िल्टर कर सकते हैं। Uber त्वरित और प्रभावी खोज परिणाम देने के लिए Elasticsearch का उपयोग करता है।
डेटा डिस्कवरी के माध्यम से डेटा लोकतंत्रीकरण तक पहुँचना
डेटा फ्लुएंसी को स्केल करना और डेटा की खोज-क्षमता को बढ़ाना साथ-साथ चलते हैं, क्योंकि विश्लेषकों को डेटा-आधारित निर्णय लेने के लिए डेटा तक आसान पहुँच चाहिए।
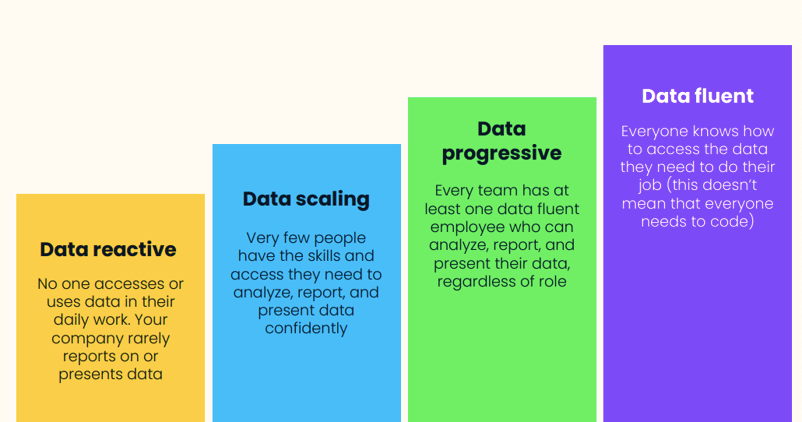
कम डेटा परिपक्वता वाले संगठनों को डेटा कौशल और संस्कृति विकसित करने और डेटा इन्फ्रास्ट्रक्चर को स्केल करने पर ध्यान देना चाहिए। हालाँकि, जैसे-जैसे संगठन अपनी डेटा परिपक्वता यात्रा में आगे बढ़ते हैं और डेटा पहुँच का विस्तार करते हैं, विस्तारणीय और स्केलेबल डेटा डिस्कवरी को सक्षम करना डेटा-चालित संगठन बनने के लिए अनिवार्य होगा। संगठनात्मक डेटा परिपक्वता बढ़ाने के सभी उपायों पर गहन चर्चा के लिए हमारा वेबिनार data fluency का मार्ग देखें या data maturity assessment लें।

आज की सबसे सफल संस्थाएँ निर्णय लेने के लिए बड़े पैमाने पर डेटा पर निर्भर हैं। इनमें से कई डेटा-कुशल संगठन हर दिन लाखों पंक्तियों का डेटा बनाते हैं, जिनका उपयोग विभिन्न टीमों द्वारा किया और विश्लेषित किया जाता है। टीमों को डेटा तक पहुँचने और उस पर काम करने की क्षमता देने की एक प्रमुख चुनौती यह सुनिश्चित करना है कि डेटा संग्रहीत, विश्वसनीय, भरोसेमंद, क्रियान्वयन योग्य, और खोजने योग्य हो।
इन जटिल डेटा परिदृश्यों में दिशा पाने के लिए, कई संगठनों ने इन-हाउस तकनीकें विकसित की हैं और उन्हें ओपन-सोर्स भी किया है, जिन्हें डेटा डिस्कवरी टूल्स कहा जाता है।
हालिया वेबिनार में, DataCamp के VP of Product Research, Ramnath Vaidyanathan बताते हैं कि संगठन डेटा-प्रतिक्रियात्मक स्थिति, जहाँ किसी के पास डेटा पर काम करने के कौशल या पहुँच नहीं होती, से डेटा-कुशल स्थिति तक कैसे जा सकते हैं, जहाँ हर किसी के पास डेटा पर काम करने और डेटा-आधारित निर्णय लेने के लिए पहुँच और कौशल होते हैं। संगठन IPTOP फ्रेमवर्क—इन्फ्रास्ट्रक्चर, लोग, टूल्स, संगठन, और प्रक्रियाएँ—में निवेश के जरिए अपनी डेटा परिपक्वता बढ़ा सकते हैं। जैसे-जैसे संगठन डेटा इन्फ्रास्ट्रक्चर में निवेश करके डेटा की पहुँच बढ़ाते हैं, उन्हें डेटा डिस्कवरी टूल्स के साथ आसान डेटा खोज-क्षमता प्रदान करनी होगी।
डेटा-कुशल कंपनियाँ डेटा डिस्कवरी टूल्स का उपयोग कैसे करती हैं
कई डेटा-चालित कंपनियों ने अपनी डेटा इन्फ्रास्ट्रक्चर में डेटा डिस्कवरी टूल्स लागू किए हैं। आइए Uber Databook और Lyft Amundsen जैसे प्रमुख डेटा डिस्कवरी टूल्स के पीछे की प्रेरणाओं और कारकों की जाँच करें।
ध्यान देने योग्य डेटा डिस्कवरी चुनौतियाँ
एक प्रमुख डेटा डिस्कवरी चुनौती है उत्पादकता और अनुपालन। Lyft ने बताया कि जैसे-जैसे उसके डेटा का आकार घातीय रूप से बढ़ा और कम से कम अगले 10 वर्षों तक इसी दर से बढ़ने का अनुमान था, उसे इन चुनौतियों का सामना करना पड़ा। Amundsen विकसित करते समय उन्होंने नोट किया कि एक विश्लेषक का लगभग 25% समय डेटा डिस्कवरी में चला जाता था। जिन देशों में वे सेवाएँ देते थे, वहाँ अनुपालन की माँगें भी लगातार कड़ी होती जा रही थीं।
Uber ने भी समान चिंताएँ व्यक्त कीं जब उसने अपनी प्राथमिक राइड-शेयरिंग ऐप से आगे बढ़कर Uber Eats, Uber Freight, और Jump Bikes जैसी सेवाओं में विस्तार करना शुरू किया। Databook विकसित करते समय, Uber के पास रोज़ाना 1.5 करोड़ से अधिक यात्राएँ और विभिन्न टीमों में 18,000 कर्मचारी थे। एक और चुनौती यह थी कि उसका डेटा कई अलग-अलग रूपों में मौजूद था, जिनमें Hive, Presto, और Vertica शामिल थे। विश्लेषकों को डेटा फ्लुएंसी हासिल करने के लिए विभिन्न डेटा स्रोतों तक कुशलतापूर्वक पहुँचने और उन्हें समझने में सक्षम होना आवश्यक था।
Facebook ने अपना Nemo डेटा डिस्कवरी प्लेटफ़ॉर्म इसलिए बनाया ताकि भूमिकाओं और भौगोलिक स्थानों में डेटा के आकार और जटिलता बढ़ने के साथ उच्च-गुणवत्ता और भरोसेमंद डेटा की आवश्यकता को पूरा किया जा सके। जिन डेटा का वे विश्लेषण करते हैं, उनसे जुड़ी गोपनीयता चिंताओं के कारण, Facebook को विशिष्ट विश्लेषकों को टेबल उपलब्ध कराते समय महत्वपूर्ण अनुपालन मुद्दों का भी समाधान करना पड़ा।
Airbnb के John Bodley ने 2017 के एक सम्मेलन में दिए गए भाषण में कहा, “जैसे-जैसे Airbnb बढ़ता है, वैसे-वैसे डेटा की मात्रा, जटिलता, और अस्पष्टता से जुड़ी चुनौतियाँ भी बढ़ती हैं।” इसका अर्थ है कि कर्मचारियों को अक्सर डेटा “अलग-थलग, दुर्गम, और संदर्भहीन” लगता था। नतीजतन, कर्मचारी डुप्लिकेट टेबल बना रहे थे और यदि उन्हें डेटा पर भरोसा नहीं होता था, तो वे उसका उपयोग नहीं करते थे। Airbnb ने Dataportal विकसित किया ताकि उत्पादक डेटा विश्लेषण में आने वाली इन बाधाओं को दूर करके डेटा डिस्कवरी प्रक्रिया को कहीं अधिक कुशल बनाया जा सके।
ये चुनौतियाँ व्यापक हैं, उद्योग-निर्पेक्ष हैं, और किसी भी ऐसे संगठन पर लागू होती हैं जो डेटा-आधारित निर्णय-निर्माण को स्केल करना चाहता है। जैसे-जैसे संगठन डेटा-कुशल बनने की ओर अग्रसर होंगे, आसानी से खोजने योग्य डेटा की आवश्यकता अत्यंत महत्वपूर्ण होती जाएगी।
डेटा डिस्कवरी टूल्स के चार प्रमुख लक्ष्य
अब जब हम डेटा डिस्कवरी चुनौतियों को समझ गए हैं, तो देखते हैं कि विभिन्न डेटा डिस्कवरी टूल्स उन्हें कैसे संबोधित करते हैं। Uber एक सफल डेटा डिस्कवरी प्लेटफ़ॉर्म के लक्ष्यों को चार घटकों में विभाजित करता है:
जैसे-जैसे संगठन अपनी डेटा दक्षताओं को परिपक्व करते हैं, इन डेटा डिस्कवरी लक्ष्यों की प्राप्ति बढ़ती जाती है। उनके डेटा के पैमाने के बढ़ने के साथ, इन प्रत्येक घटकों का महत्व और अधिक बढ़ जाता है।
Lyft और Airbnb विस्तृत मेटाडेटा प्रदान करते हैं
Lyft की इंजीनियरिंग टीम का तर्क है कि “मेटाडेटा भविष्य के अनुप्रयोगों का पवित्र कंघी है।” वे मेटाडेटा को दो उपश्रेणियों में बाँटते हैं। पहली, वर्णनात्मक डेटा का सेट है, जिसमें एप्लिकेशन संदर्भ (अर्थात, डेटा के साथ काम करने के लिए मनुष्यों को क्या जानना चाहिए), व्यवहार (अर्थात, किसी विशेष डेटासेट का स्वामी कौन है और उसके सामान्य उपयोग पैटर्न क्या हैं), और परिवर्तन (अर्थात, समय के साथ डेटासेट कैसे बदल रहा है) शामिल हैं। दूसरा घटक वह डेटा है जिसका वर्णन किया जा रहा है—जो संगठन में किसी भी प्रारूप में संग्रहीत कोई भी डेटा हो सकता है, जैसे डाटा स्टोर्स, डैशबोर्ड, डाटा स्ट्रीम्स, आदि।
Dataportal, Airbnb का डेटा डिस्कवरी प्लेटफ़ॉर्म, विकसित करते समय, मेटाडेटा डेटा पाइपलाइन में प्लेटफ़ॉर्म के जोड़े गए मूल्य का अभिन्न हिस्सा था। Dataportal के आने से पहले, संदर्भ और मेटाडेटा की कमी के कारण कई कर्मचारी उस डेटा पर भरोसा नहीं करते थे जिसका वे उपयोग कर रहे थे। Airbnb का मानना है कि “पूरे डेटा इकोसिस्टम की समझ—किसी इवेंट लॉग के निर्माण से लेकर उसके विज़ुअलाइज़ेशन में उपभोग तक—अपने हिस्सों के योग से अधिक मूल्य प्रदान करती है।”
स्रोत: Airbnb
डेटा डिस्कवरी के साथ उच्च-गुणवत्ता वाले खोज परिणाम सुनिश्चित करें
एक बार यह संदर्भ उपलब्ध हो जाने पर, डेटा डिस्कवरी के लिए प्रभावी खोज आवश्यक है। प्रत्येक टेबल कितनी ही भरोसेमंद और आसानी से समझने योग्य क्यों न हो, डेटा डिस्कवरी प्लेटफ़ॉर्म तभी उपयोगी हैं जब विश्लेषक अपनी ज़रूरत का डेटा जल्दी से ढूँढ सकें।
Lyft Amundsen का लैंडिंग पेज उपयोगकर्ताओं को प्राकृतिक भाषा क्वेरी के माध्यम से टेबल खोजने देता है और त्वरित पहुँच के लिए संगठन में सबसे लोकप्रिय टेबलों की दृश्यता प्रदान करता है। साथ ही, विश्लेषक भविष्य की खोज परिणामों को बेहतर बनाने के लिए टेबल पर फीडबैक भी दे सकते हैं।
Facebook का डेटा डिस्कवरी समाधान, Nemo, विश्लेषकों को उपयोग, गोपनीयता प्रतिबंधों, और डेटा की नवीनता पर फ़िल्टर करने देता है, साथ ही उपयोगकर्ताओं को सर्च बार में प्रश्न टाइप करके प्रासंगिक टेबल पाने की सुविधा देकर Facebook की प्राकृतिक भाषा प्रसंस्करण क्षमता का लाभ उठाता है।
Uber Databook भी समान खोज-फ़िल्टरिंग क्षमताएँ प्रदान करता है, जिससे विश्लेषक नाम, स्वामी, कॉलम, और नेस्टेड कॉलम जैसे आयामों पर फ़िल्टर कर सकते हैं। Uber त्वरित और प्रभावी खोज परिणाम देने के लिए Elasticsearch का उपयोग करता है।
डेटा डिस्कवरी के माध्यम से डेटा लोकतंत्रीकरण तक पहुँचना
डेटा फ्लुएंसी को स्केल करना और डेटा की खोज-क्षमता को बढ़ाना साथ-साथ चलते हैं, क्योंकि विश्लेषकों को डेटा-आधारित निर्णय लेने के लिए डेटा तक आसान पहुँच चाहिए।
कम डेटा परिपक्वता वाले संगठनों को डेटा कौशल और संस्कृति विकसित करने और डेटा इन्फ्रास्ट्रक्चर को स्केल करने पर ध्यान देना चाहिए। हालाँकि, जैसे-जैसे संगठन अपनी डेटा परिपक्वता यात्रा में आगे बढ़ते हैं और डेटा पहुँच का विस्तार करते हैं, विस्तारणीय और स्केलेबल डेटा डिस्कवरी को सक्षम करना डेटा-चालित संगठन बनने के लिए अनिवार्य होगा। संगठनात्मक डेटा परिपक्वता बढ़ाने के सभी उपायों पर गहन चर्चा के लिए हमारा वेबिनार data fluency का मार्ग देखें या data maturity assessment लें।