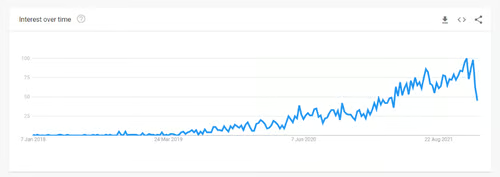
机器学习运维(MLOps)如今已成为众多数据领导者和从业者的核心关注点,过去两年关注度显著上升。这一迅猛增长背后,是许多组织面临的重大挑战:在机器学习和人工智能上的投入未能带来承诺的投资回报。
2019 年,Venturebeat 报道称,只有 13% 的机器学习模型能够进入生产环境。尽管 KDNuggets 的一项最新投票显示 2022 年有所改善,仍有 35% 的受访者提到技术障碍阻碍了模型部署。
麦肯锡的《2021 年人工智能现状》报告显示,AI 采用率已从 2020 年的 50% 上升至 56%。随着组织加大对机器学习系统和人才的投入,高效部署并从模型中提取价值的必要性愈发明显。这正是 MLOps 发挥作用的地方。成功采用 MLOps 的组织正在获得更好的投资回报。通过采用 MLOps,数据团队缩短了机器学习系统的原型设计、开发与部署时间。
MLOps 的目标是将技术与组织变革相结合,把软件工程理念应用于机器学习。将机器学习视为一门工程学科,它为模型进入生产提供了更直接的路径,并使生产环境中的模型具备更长的生命周期。
本文将界定什么是 MLOps、为什么它很重要,并提出当今定义成功 MLOps 实践的五项指导原则。
什么是 MLOps?
MLOps 最恰当的定义是:“一套工具、实践、技术与文化,确保机器学习系统的可靠、可扩展部署。” MLOps 借鉴了软件工程的最佳实践,如自动化与自动化测试、版本控制、敏捷原则的实施以及数据管理,以降低技术债务。
技术债务(或代码债务)源自软件工程领域。它描述了由于快速开发而累积的“债务”,即将自动化、文档、单元测试等流程推迟到后续重构。简而言之,就是开发团队当下未采纳最佳实践而背负到未来的债务。
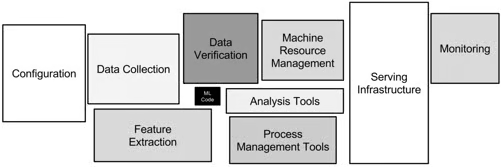
机器学习系统可能会产生较高水平的技术债务,因为数据科学家产出的模型只是更大拼图中的一小部分——还涉及基础设施、模型监控、特征存储等诸多要素。
是什么让 MLOps 与众不同
旨在减少技术债务的软件工程最佳实践通常被称为 DevOps。DevOps 将编写代码、版本管理、测试等开发活动,与发布、部署、监控等 IT 运维活动相结合。
DevOps 的两项核心原则是持续集成与持续交付(CI/CD)。
- 持续集成(CI):定期构建、测试并将新的代码变更合并到共享代码库中。
- 持续交付(CD):对应用所做的任何变更都会自动测试并上传到代码库,以便部署到生产环境。
将机器学习系统推向生产并进行规模化,会带来额外的复杂性。软件工程主要是设计输入输出明确的解决方案;而机器学习系统则依赖真实世界数据,并通过统计方法建模。这引入了更多需要考虑的因素,例如:
- 数据:机器学习接收的是高度复杂的输入数据。这些数据必须经过转换,才能让模型产出有意义的预测。
- 建模:开发机器学习系统需要大量实验。要高效开展实验,必须跟踪每次实验的数据变更和参数。
- 测试:除了对应用中小而可测的部分进行独立测试的单元测试之外,机器学习系统还需要更复杂的数据与模型性能测试。例如,测试新的输入数据是否与训练数据具有相似的统计特性。
- 模型漂移:机器学习模型的性能总会随时间衰减。其主要原因有两方面:概念漂移,即我们试图预测的结果的性质发生变化。一个典型例子是新冠疫情封锁期间,许多零售商的厕纸等商品销量意外激增。一个基于常态数据训练的模型会如何应对?数据漂移,则是自变量的属性因季节性、消费者行为变化或新品发布等因素而发生改变。
- 持续训练:为应对模型漂移,必须在有新数据时对模型进行再训练。
- 流水线管理: 数据在输入模型前需经历多步转换,并应在训练前后定期测试。流水线将这些步骤串联起来,便于高效监控与维护。
成功实施 MLOps 的 5 项原则
采用 MLOps 并非只是与新的 SaaS 供应商合作,或启动新的云计算实例那样简单。它需要周密规划,并在团队与部门之间保持一致的方法。以下是成功实施 MLOps 的五项原则:
了解您的 MLOps 成熟度
诸如微软和谷歌等领先云厂商用成熟度模型来看待 MLOps 的采用。原因在于,MLOps 需要组织变革和现代化的工作方式,而这只有在组织的系统与流程逐步成熟的过程中才能实现。
成功采用 MLOps 需要对组织在 MLOps 成熟度上的进展进行坦诚评估。在可靠的成熟度评估基础上,组织就能了解可以采取哪些策略来提升成熟度。这可能涉及流程变更,如将 DevOps 应用于部署,或为团队补充新的人才。
理解成熟度水平如何帮助组织为 MLOps 项目排序也至关重要。例如,特征库是一个集中存放常用机器学习特征的数据仓库。对于数据成熟度较高、存在多个分散数据团队且需要使用一致特征并减少重复工作的组织,特征库非常有用。但如果一个组织只有少数几位数据科学家,特征库可能并不值得投入时间。
通过采用 MLOps 成熟度模型,组织可以让团队、流程与技术栈协同发展。这确保了在实施前能够进行迭代,并对工具进行测试。
在流程中引入自动化
自动化与成熟度模型的理念一脉相承。广泛而先进的自动化有助于提升组织的 MLOps 成熟度。在缺乏 MLOps 的环境中,机器学习系统中的许多任务依靠人工执行,包括数据清洗与转换、特征工程、训练/测试数据划分、编写模型训练代码等。手工执行这些步骤会增加出错空间,也占用了本应用于实验探索的时间。
自动化的一个优秀示例是持续再训练,数据团队可为数据摄取、验证、实验、特征工程、模型测试等环节搭建流水线。持续再训练常被视为机器学习自动化的早期步骤之一,有助于避免模型漂移。
MLOps 中的流水线与数据工程或 DevOps 中的并无二致。机器学习流水线是一系列步骤,用于编排数据流入并流出机器学习模型。
为说明流水线的威力,我们设想这样一个场景:数据科学家手动提取了部分数据,但已将数据验证、数据准备、模型训练与评估流程实现了自动化。模型投入生产用于新数据预测时,这条流水线即可复用。
重视实验与追踪
实验是机器学习生命周期的核心。数据科学家会在数据集、特征、机器学习模型及其超参数等方面进行实验。实验过程中可调整的“杠杆”很多。要找到正确组合,必须对每次实验迭代进行追踪。
在传统的基于笔记本的实验中,数据科学家会手动记录模型参数和细节。这可能导致流程不一致,并增大人为错误的空间。手工执行也很耗时,成为快速实验的重大障碍。
虽然 git 被广泛用于代码追踪,但数据科学家开展的不同实验并不容易进行版本控制。此时,数据团队可以使用模型注册表,为数据科学家提供存储模型、追踪性能和其他变更的场所。
对实验进行追踪,使数据团队在必要时能够回滚模型,并改进整体的模型审计流程。它能显著减少数据科学家的手动工作量,为更多实验留出时间。所有这些都通过版本化与追踪显著提升了结果的可复现性。
超越 CI/CD
我们已在 DevOps 语境下讨论了 CI/CD,而它们同样是高成熟度 MLOps 的关键组成部分。
- 将 CI 应用于 MLOps 时,我们把对代码的自动化测试与验证扩展到数据与模型。
- 类似地,随着模型的再训练,CD 的理念也适用于流水线与模型。
我们还可以考虑其他“持续”概念:
- 持续训练(CT):我们已经提到,随着自动化程度提高,可在新数据可用时对模型进行再训练。
- 持续监控(CM):模型性能下降是触发再训练的另一原因。我们也应了解模型是否仍在业务指标上创造价值。
将这些持续性理念与自动化测试相结合,既能实现快速实验,又能确保在规模化场景下将错误降至最低。此外,成功落实这四种“持续”概念,还能大幅缩短部署时间。
回到我们在自动化部分提到的示例流水线。将 CI/CD 概念应用于此,意味着将代码库存放在代码仓库中。按照 CI 的做法,会对该仓库执行一系列自动化单元测试,例如测试工程化特征、确保不存在缺失值、测试是否过拟合。随后可对流水线的各个组件进行验证与部署,确保兼容性与算力需求得到测试与满足。这样的自动化水平能够实现快速的新部署,使组织能够及时应对外部驱动与变化。
推动组织变革
组织变革必须与 MLOps 成熟度的提升同步推进。这需要促进团队协作的流程变革,从而打破信息孤岛。在某些情况下,还需对团队进行重组,以支持 MLOps 成熟度的持续提升。微软的成熟度模型涵盖了随着成熟度提升,人们的行为应如何改变。
在低成熟度环境中,数据科学家、数据工程师与软件工程师通常各自为战。随着成熟度提升,所有成员都需要协作。数据科学家与数据工程师必须合作,将实验代码转化为可复用的流水线;而软件工程师与数据工程师必须合作,将模型自动集成到应用代码中。
加强协作可降低整个部署流程对单个人的依赖,确保通过团队合作来减少高成本的手工工作。这些不同领域的专长汇聚在一起,推动实现高成熟度 MLOps 所需的自动化水平。加强协作与自动化对于降低技术债务至关重要。
MLOps 的崛起仍处于早期阶段
MLOps 源于对快速、高效部署机器学习模型的需求。随着企业在机器学习上的投入不断加大,开发出的模型愈来愈多,对 MLOps 的需求也随之增长。尽管 MLOps 仍处于早期阶段,但可以肯定的是,组织正试图围绕一套原则达成共识,以释放机器学习的投资回报。
如果您希望进一步了解 MLOps,欢迎查看以下资源:

机器学习运维(MLOps)如今已成为众多数据领导者和从业者的核心关注点,过去两年关注度显著上升。这一迅猛增长背后,是许多组织面临的重大挑战:在机器学习和人工智能上的投入未能带来承诺的投资回报。
2019 年,Venturebeat 报道称,只有 13% 的机器学习模型能够进入生产环境。尽管 KDNuggets 的一项最新投票显示 2022 年有所改善,仍有 35% 的受访者提到技术障碍阻碍了模型部署。
麦肯锡的《2021 年人工智能现状》报告显示,AI 采用率已从 2020 年的 50% 上升至 56%。随着组织加大对机器学习系统和人才的投入,高效部署并从模型中提取价值的必要性愈发明显。这正是 MLOps 发挥作用的地方。成功采用 MLOps 的组织正在获得更好的投资回报。通过采用 MLOps,数据团队缩短了机器学习系统的原型设计、开发与部署时间。
MLOps 的目标是将技术与组织变革相结合,把软件工程理念应用于机器学习。将机器学习视为一门工程学科,它为模型进入生产提供了更直接的路径,并使生产环境中的模型具备更长的生命周期。
本文将界定什么是 MLOps、为什么它很重要,并提出当今定义成功 MLOps 实践的五项指导原则。
什么是 MLOps?
MLOps 最恰当的定义是:“一套工具、实践、技术与文化,确保机器学习系统的可靠、可扩展部署。” MLOps 借鉴了软件工程的最佳实践,如自动化与自动化测试、版本控制、敏捷原则的实施以及数据管理,以降低技术债务。
技术债务(或代码债务)源自软件工程领域。它描述了由于快速开发而累积的“债务”,即将自动化、文档、单元测试等流程推迟到后续重构。简而言之,就是开发团队当下未采纳最佳实践而背负到未来的债务。
机器学习系统可能会产生较高水平的技术债务,因为数据科学家产出的模型只是更大拼图中的一小部分——还涉及基础设施、模型监控、特征存储等诸多要素。
是什么让 MLOps 与众不同
旨在减少技术债务的软件工程最佳实践通常被称为 DevOps。DevOps 将编写代码、版本管理、测试等开发活动,与发布、部署、监控等 IT 运维活动相结合。
DevOps 的两项核心原则是持续集成与持续交付(CI/CD)。
将机器学习系统推向生产并进行规模化,会带来额外的复杂性。软件工程主要是设计输入输出明确的解决方案;而机器学习系统则依赖真实世界数据,并通过统计方法建模。这引入了更多需要考虑的因素,例如:
成功实施 MLOps 的 5 项原则
采用 MLOps 并非只是与新的 SaaS 供应商合作,或启动新的云计算实例那样简单。它需要周密规划,并在团队与部门之间保持一致的方法。以下是成功实施 MLOps 的五项原则:
了解您的 MLOps 成熟度
诸如微软和谷歌等领先云厂商用成熟度模型来看待 MLOps 的采用。原因在于,MLOps 需要组织变革和现代化的工作方式,而这只有在组织的系统与流程逐步成熟的过程中才能实现。
成功采用 MLOps 需要对组织在 MLOps 成熟度上的进展进行坦诚评估。在可靠的成熟度评估基础上,组织就能了解可以采取哪些策略来提升成熟度。这可能涉及流程变更,如将 DevOps 应用于部署,或为团队补充新的人才。
理解成熟度水平如何帮助组织为 MLOps 项目排序也至关重要。例如,特征库是一个集中存放常用机器学习特征的数据仓库。对于数据成熟度较高、存在多个分散数据团队且需要使用一致特征并减少重复工作的组织,特征库非常有用。但如果一个组织只有少数几位数据科学家,特征库可能并不值得投入时间。
通过采用 MLOps 成熟度模型,组织可以让团队、流程与技术栈协同发展。这确保了在实施前能够进行迭代,并对工具进行测试。
在流程中引入自动化
自动化与成熟度模型的理念一脉相承。广泛而先进的自动化有助于提升组织的 MLOps 成熟度。在缺乏 MLOps 的环境中,机器学习系统中的许多任务依靠人工执行,包括数据清洗与转换、特征工程、训练/测试数据划分、编写模型训练代码等。手工执行这些步骤会增加出错空间,也占用了本应用于实验探索的时间。
自动化的一个优秀示例是持续再训练,数据团队可为数据摄取、验证、实验、特征工程、模型测试等环节搭建流水线。持续再训练常被视为机器学习自动化的早期步骤之一,有助于避免模型漂移。
MLOps 中的流水线与数据工程或 DevOps 中的并无二致。机器学习流水线是一系列步骤,用于编排数据流入并流出机器学习模型。
为说明流水线的威力,我们设想这样一个场景:数据科学家手动提取了部分数据,但已将数据验证、数据准备、模型训练与评估流程实现了自动化。模型投入生产用于新数据预测时,这条流水线即可复用。
重视实验与追踪
实验是机器学习生命周期的核心。数据科学家会在数据集、特征、机器学习模型及其超参数等方面进行实验。实验过程中可调整的“杠杆”很多。要找到正确组合,必须对每次实验迭代进行追踪。
在传统的基于笔记本的实验中,数据科学家会手动记录模型参数和细节。这可能导致流程不一致,并增大人为错误的空间。手工执行也很耗时,成为快速实验的重大障碍。
虽然 git 被广泛用于代码追踪,但数据科学家开展的不同实验并不容易进行版本控制。此时,数据团队可以使用模型注册表,为数据科学家提供存储模型、追踪性能和其他变更的场所。
对实验进行追踪,使数据团队在必要时能够回滚模型,并改进整体的模型审计流程。它能显著减少数据科学家的手动工作量,为更多实验留出时间。所有这些都通过版本化与追踪显著提升了结果的可复现性。
超越 CI/CD
我们已在 DevOps 语境下讨论了 CI/CD,而它们同样是高成熟度 MLOps 的关键组成部分。
我们还可以考虑其他“持续”概念:
将这些持续性理念与自动化测试相结合,既能实现快速实验,又能确保在规模化场景下将错误降至最低。此外,成功落实这四种“持续”概念,还能大幅缩短部署时间。
回到我们在自动化部分提到的示例流水线。将 CI/CD 概念应用于此,意味着将代码库存放在代码仓库中。按照 CI 的做法,会对该仓库执行一系列自动化单元测试,例如测试工程化特征、确保不存在缺失值、测试是否过拟合。随后可对流水线的各个组件进行验证与部署,确保兼容性与算力需求得到测试与满足。这样的自动化水平能够实现快速的新部署,使组织能够及时应对外部驱动与变化。
推动组织变革
组织变革必须与 MLOps 成熟度的提升同步推进。这需要促进团队协作的流程变革,从而打破信息孤岛。在某些情况下,还需对团队进行重组,以支持 MLOps 成熟度的持续提升。微软的成熟度模型涵盖了随着成熟度提升,人们的行为应如何改变。
在低成熟度环境中,数据科学家、数据工程师与软件工程师通常各自为战。随着成熟度提升,所有成员都需要协作。数据科学家与数据工程师必须合作,将实验代码转化为可复用的流水线;而软件工程师与数据工程师必须合作,将模型自动集成到应用代码中。
加强协作可降低整个部署流程对单个人的依赖,确保通过团队合作来减少高成本的手工工作。这些不同领域的专长汇聚在一起,推动实现高成熟度 MLOps 所需的自动化水平。加强协作与自动化对于降低技术债务至关重要。
MLOps 的崛起仍处于早期阶段
MLOps 源于对快速、高效部署机器学习模型的需求。随着企业在机器学习上的投入不断加大,开发出的模型愈来愈多,对 MLOps 的需求也随之增长。尽管 MLOps 仍处于早期阶段,但可以肯定的是,组织正试图围绕一套原则达成共识,以释放机器学习的投资回报。
如果您希望进一步了解 MLOps,欢迎查看以下资源: