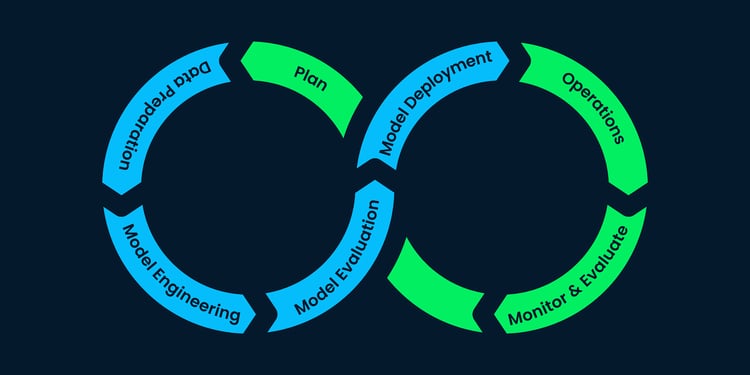
Las operaciones de machine learning (MLOps) se han convertido en una prioridad para muchos responsables y profesionales de datos, con un interés que ha crecido con fuerza en los dos últimos años. Este auge meteórico está impulsado por un reto importante al que se enfrentan muchas organizaciones: la inversión en machine learning e IA no está ofreciendo el retorno prometido.

En 2019, Venturebeat informó de que solo el 13% de los modelos de machine learning llegan a producción. Aunque una encuesta reciente de KDNuggets sugiere una mejora en 2022, el 35% de las personas encuestadas seguía mencionando obstáculos técnicos que impedían desplegar sus modelos.
El informe State of AI 2021 de McKinsey muestra que la adopción de IA ha subido al 56%, desde el 50% en 2020. A medida que las organizaciones incrementan la inversión en sus sistemas de machine learning y en talento, la necesidad de desplegar modelos con eficiencia y extraer valor de ellos es más evidente que nunca. Ahí es donde entra MLOps. Las organizaciones que adoptan MLOps con éxito están viendo mejores retornos de sus inversiones. Al implantar MLOps, los equipos de datos reducen el tiempo necesario para prototipar, desarrollar y desplegar sistemas de machine learning.
El objetivo de MLOps es combinar tecnología con cambios organizativos para aplicar conceptos de ingeniería de software al machine learning. Al tratar el machine learning como una disciplina de ingeniería, se abre una vía más directa hacia la producción y se alarga la vida útil de los modelos en producción.
En este artículo definiremos MLOps, por qué es importante y presentaremos cinco principios clave que marcan una práctica de MLOps exitosa hoy.
¿Qué es MLOps?
MLOps se define mejor como "un conjunto de herramientas, prácticas, técnicas y cultura que garantizan el despliegue fiable y escalable de sistemas de machine learning". MLOps toma prestadas buenas prácticas de la ingeniería de software como la automatización y las pruebas automatizadas, el control de versiones, la adopción de principios ágiles y la gestión de datos para reducir la deuda técnica.
La deuda técnica o deuda de código es un concepto propio de la ingeniería de software. Describe la "deuda" que se acumula como resultado de un desarrollo acelerado en el que procesos como la automatización, la documentación y las pruebas unitarias se refactorizan más adelante. En pocas palabras, es la deuda que los equipos de desarrollo arrastran al futuro por no adoptar las mejores prácticas en el presente.
Los sistemas de machine learning pueden acumular altos niveles de deuda técnica, ya que los modelos que crean los data scientists son solo una pieza de un rompecabezas mayor, que incluye infraestructura, monitorización de modelos, almacenamiento de features y muchas otras consideraciones.

Qué hace único a MLOps
Las buenas prácticas de ingeniería de software orientadas a reducir la deuda técnica se conocen como DevOps. DevOps combina las actividades de desarrollo (escritura de código, versionado y pruebas) con las operaciones de TI (lanzamiento, despliegue y monitorización).
Los dos principios básicos de DevOps son la integración continua y la entrega continua (CI/CD).
- Integración continua (CI): los nuevos cambios de código se compilan, prueban y fusionan con regularidad en un repositorio compartido.
- Entrega continua (CD): cualquier cambio realizado en una aplicación se prueba automáticamente y se sube a un repositorio, desde donde puede desplegarse en un entorno en producción.
Llevar a producción y escalar sistemas de machine learning añade complejidad. La ingeniería de software diseña sobre todo soluciones bien definidas con entradas y salidas precisas. En cambio, los sistemas de machine learning dependen de datos del mundo real que se modelan mediante métodos estadísticos. Esto introduce consideraciones adicionales que hay que tener en cuenta, como por ejemplo:
- Datos: el machine learning consume datos de entrada muy complejos. Estos datos deben transformarse para que los modelos puedan generar predicciones útiles.
- Modelado: desarrollar sistemas de machine learning requiere experimentación. Para experimentar con eficiencia, es esencial registrar los cambios en los datos y los parámetros de cada experimento.
- Pruebas: más allá de las pruebas unitarias, donde se testean de forma independiente partes pequeñas y comprobables de una aplicación, los sistemas de machine learning requieren pruebas más complejas tanto de los datos como del rendimiento del modelo. Por ejemplo, comprobar si los nuevos datos de entrada comparten propiedades estadísticas similares a las de los datos de entrenamiento.
- Deriva del modelo: el rendimiento de los modelos de machine learning siempre se degrada con el tiempo. La causa principal es doble. La deriva de concepto se da cuando cambian las propiedades del resultado que intentamos predecir. Un buen ejemplo ocurrió durante los confinamientos por la COVID-19, cuando muchos minoristas experimentaron un pico inesperado en productos como el papel higiénico. ¿Cómo respondería a eso un modelo entrenado con datos "normales"? La deriva de datos, por otro lado, aparece cuando cambian las propiedades de las variables independientes por distintos factores, como la estacionalidad, cambios en el comportamiento del consumidor o el lanzamiento de nuevos productos.
- Entrenamiento continuo: los modelos deben reentrenarse a medida que llegan nuevos datos para combatir la deriva.
- Gestión de pipelines: los datos deben pasar por varias transformaciones antes de alimentar a un modelo y conviene probarlos con regularidad antes y después del entrenamiento. Los pipelines combinan estos pasos para poder monitorizarlos y mantenerlos con eficiencia.
5 principios para un MLOps exitoso
Adoptar MLOps no es tan sencillo como contratar a un nuevo proveedor SaaS o levantar nuevas instancias de cómputo en la nube. Requiere planificación cuidadosa y un enfoque coherente entre equipos y departamentos. Estos son cinco principios para una implantación exitosa de MLOps:
Conoce tu nivel de madurez en MLOps
Proveedores líderes de la nube como Microsoft y Google analizan la adopción de MLOps con un modelo de madurez. Esto se debe a que MLOps exige cambios organizativos y formas modernas de trabajo, algo que solo ocurre con el tiempo, a medida que los sistemas y procesos de la organización maduran.
Adoptar MLOps con éxito requiere una evaluación honesta del progreso de la organización en su madurez de MLOps. Con una evaluación fiable, las organizaciones pueden entender qué tácticas aplicar para subir de nivel de madurez. Esto puede implicar cambios de proceso, como aplicar DevOps al despliegue, o incorporar nuevos perfiles al equipo.
También es clave entender cómo los niveles de madurez ayudan a priorizar iniciativas de MLOps. Por ejemplo, un feature store es un repositorio único que centraliza features comunes para machine learning. Los feature stores son útiles para organizaciones con cierta madurez de datos donde muchos equipos necesitan usar features consistentes y reducir trabajo duplicado. Si una organización solo tiene unas pocas personas de ciencia de datos, probablemente un feature store no compense el esfuerzo.
Al usar un modelo de madurez para MLOps, las organizaciones permiten que equipos, procesos y stack tecnológico evolucionen a la par. Así se asegura la iteración y se pueden probar herramientas antes de implantarlas.
Aplica automatización en tus procesos
La automatización va de la mano del concepto de modelos de madurez. Una automatización amplia y avanzada facilita que una organización aumente su madurez en MLOps. En entornos sin MLOps, muchas tareas dentro de los sistemas de machine learning se ejecutan de forma manual: limpieza y transformación de datos, ingeniería de features, partición de entrenamiento y test, escritura del código de entrenamiento del modelo, etc. Al hacer estos pasos a mano, las personas de ciencia de datos introducen más margen de error y pierden tiempo que sería mejor dedicar a la experimentación.
Un gran ejemplo de automatización es el reentrenamiento continuo, donde los equipos de datos pueden configurar pipelines para ingesta y validación de datos, experimentación, ingeniería de features, pruebas de modelos y más. Considerado a menudo como uno de los primeros pasos en la automatización de ML, el reentrenamiento continuo ayuda a evitar la deriva del modelo.
Los pipelines en MLOps no difieren de los de data engineering o DevOps. Un pipeline de machine learning es una serie de pasos que orquestan el flujo de datos hacia y desde un modelo.
Para ilustrar el poder de los pipelines, imagina un caso en el que el equipo de datos ha extraído parte de los datos manualmente, pero ha podido automatizar la validación, la preparación de datos, el entrenamiento del modelo y su evaluación. Este pipeline puede reutilizarse después, cuando el modelo pase a producción, para predecir sobre datos nuevos.
Prioriza la experimentación y su trazabilidad
La experimentación es una parte central del ciclo de vida del machine learning. Los data scientists prueban con datasets, features, modelos y sus hiperparámetros, etc. Hay muchos "mandos" que tocar durante la experimentación. Para dar con la combinación adecuada, es esencial registrar cada iteración de los experimentos.
En la experimentación tradicional basada en notebooks, las personas de ciencia de datos registran manualmente parámetros y detalles de los modelos. Esto puede provocar incoherencias y aumentar el margen de error humano. La ejecución manual también consume tiempo y dificulta la experimentación rápida.
Aunque git se usa ampliamente para versionar código, no es sencillo controlar las versiones de los diferentes experimentos que se ejecutan. Aquí es donde los equipos de datos pueden usar model registries, un lugar donde almacenar modelos, seguir su rendimiento y otros cambios.
Seguir los experimentos permite a los equipos de datos revertir modelos si es necesario y mejora el proceso de auditoría. Reduce un esfuerzo manual considerable, dejando más tiempo para experimentar. Todo ello se traduce en una reproducibilidad de resultados muy superior gracias al versionado y la trazabilidad.
Ve más allá del CI/CD
Ya hemos visto CI/CD en el contexto de DevOps, pero también son componentes esenciales de un MLOps maduro.
- Al aplicar CI a MLOps, extendemos las pruebas y validaciones automatizadas del código para cubrir también los datos y los modelos.
- De forma similar, los conceptos de CD aplican a los pipelines y a los modelos cuando se reentrenan.
También podemos considerar otros conceptos "continuos":
- Entrenamiento continuo (CT): ya hemos visto cómo una mayor automatización permite reentrenar un modelo cuando llegan datos nuevos.
- Monitorización continua (CM): otro motivo para reentrenar un modelo es la caída de rendimiento. Además, debemos entender si los modelos siguen aportando valor frente a los indicadores de negocio.
Aplicar estos conceptos continuos junto con pruebas automatizadas permite una experimentación rápida y garantiza un mínimo de errores a escala. Además, implantar con éxito los cuatro conceptos continuos puede reducir drásticamente el tiempo hasta el despliegue.
Pensemos en el pipeline del que hablábamos en la sección de automatización. Aplicar conceptos de CI/CD a este caso daría como resultado una base de código almacenada en un repositorio. En línea con CI, se ejecutarían una serie de pruebas unitarias automatizadas sobre ese repositorio, como probar las features diseñadas, asegurar que no hay valores ausentes y comprobar el sobreajuste. Luego, los componentes individuales del pipeline pueden validarse y desplegarse, garantizando la compatibilidad y que las necesidades de cómputo están probadas y cubiertas. Este nivel de automatización permite despliegues ágiles, lo que ayuda a las organizaciones a reaccionar ante factores externos y cambios.
Adopta cambios organizativos
El cambio organizativo debe avanzar en paralelo a la evolución en la madurez de MLOps. Esto requiere cambios de proceso que fomenten la colaboración entre equipos, rompiendo silos. En algunos casos, es necesario reestructurar equipos para facilitar una madurez consistente de MLOps. El modelo de madurez de Microsoft cubre cómo debe cambiar el comportamiento de las personas a medida que crece la madurez.
En entornos de baja madurez, data scientists, ingenieros y desarrolladores de software suelen trabajar en silos. A medida que aumenta la madurez, todas las personas deben colaborar. Data scientists e ingenieros han de trabajar juntos para convertir el código de experimentación en pipelines repetibles, mientras que ingenieros de software y de datos deben colaborar para integrar los modelos en el código de las aplicaciones de forma automática.
Una mayor colaboración hace que todo el proceso de despliegue dependa menos de una sola persona. Garantiza trabajo en equipo para reducir esfuerzos manuales costosos. Estas áreas de especialidad se unen para desarrollar el nivel de automatización que requiere un MLOps maduro. Más colaboración y más automatización son esenciales para reducir la deuda técnica.
El auge de MLOps aún está en su infancia
MLOps nació por la necesidad de desplegar modelos de ML de forma rápida y eficiente. Con las empresas invirtiendo con fuerza en machine learning, cada vez se desarrollan más modelos, lo que aumenta la demanda de MLOps. Aunque MLOps sigue en una fase temprana, podemos decir con seguridad que las organizaciones buscan converger en un conjunto de principios que desbloquee el ROI del machine learning.
Si te interesa aprender más sobre MLOps, echa un vistazo a estos recursos:
- A practical guide to MLOps by Noah Gift
- Operationalizing Machine Learning with MLOps with Alessya Visnjic
- From Predictions to Decisions with Dan Becker
- Our Guide to MLOps Certifications