本教程由我们的社区成员贡献,已由 DataCamp 编辑以提高清晰度与准确性。
想要分享您的专业见解?我们非常期待!欢迎通过我们的社区投稿表单提交文章或创意。
机器学习在对简单与复杂数据的精确建模上都取得了巨大成功。机器学习带来的机会无处不在,但多数方法在实际应用中的“固定”特性,正成为 AI 采纳的减速因素。持续学习正是为此而生。
持续学习是一种机器学习方法,使模型在无需显式再训练的情况下整合新数据。它在传统机器学习基础之上发展,直面现实世界数据的动态本质,打造可随时间提升性能的自适应模型。
什么是持续学习?
持续学习(Continuous Learning),亦称持续机器学习(CML),是指模型无需重新训练,直接从新的数据流中学习的过程。
不同于传统方法先在静态数据集上训练、部署,再定期再训练,持续学习模型会迭代更新参数,以反映数据中新出现的分布。
在这一过程中,模型通过学习最新迭代并在新数据到来时更新其知识而自我改进。持续学习的模型生命周期由于其内在的动态性,使模型能够长期保持相关性。
持续机器学习的类型
持续机器学习的建模方法多种多样。常见策略包括增量学习、迁移学习以及终身学习。
其他示例还有经验回放方法和正则化技术。
与所有数据相关工作一样,方法选择并非黑白分明,而是取决于数据、模型架构、期望性能、任务复杂度以及可用算力。很多时候会组合多种方法来增强学习能力。
持续学习流程
持续学习是对传统机器学习建模的演进。因此,它同样涉及许多相同的建模环节:预处理、模型选择、超参数调优、训练、部署与监控。
在持续学习流程中还需增加两个步骤:数据复现(rehearsal)以及持续学习策略的实施。这些步骤确保模型能根据应用与数据任务的语境,高效地从新数据流中学习。
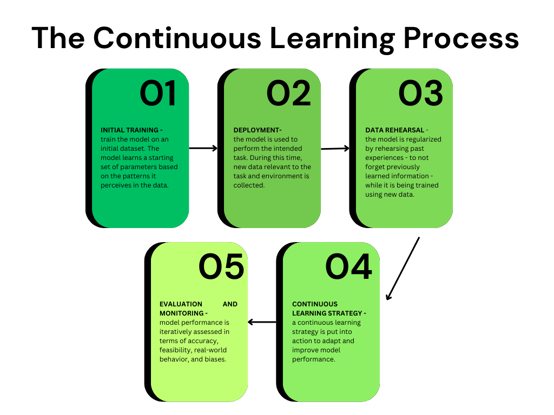
图 1:面向机器学习的持续学习流程图
持续学习的优势
持续学习适用于各类数据项目:描述性、诊断性、预测性和规范性。它在涉及快速变化数据的场景中尤为重要。与传统机器学习方法相比,其优势包括:
- 泛化性。持续学习使模型在面对新数据时更具稳健性与准确性。
- 信息保留。通过采用持续学习策略,模型会考虑过去迭代中获得的知识,从而随时间累积信息。
- 适应性。采用持续学习的模型能够适应新知识(如概念漂移与新趋势),从而在长期内具备更强的预测能力。
持续学习的局限
持续学习方法并非没有局限。根据任务的性质与预期结果,在采用此类方法前需要充分考量。
从运营视角看,一个挑战在于:
- 成本。持续学习方法虽有效,但通常比传统方法更具计算复杂性,因为模型需持续适应新数据。此类复杂性往往意味着更高的经济成本,原因在于需要更多的数据、人力与算力资源。
从建模视角看,一些缺点包括:
- 模型管理。每当模型参数基于新数据更新时,实际上就形成了一个新模型。因此,持续学习方法可能产生大量模型,增大甄别最佳表现模型的难度。
- 数据漂移。要让持续学习物有所值,我们必须处理大量新数据。然而,一旦特征分布发生突变,此类模型也有可能丧失预测能力。可在另一篇文章了解更多数据漂移相关内容。
成本难以轻易规避,但与建模相关的挑战可通过完善的方法论与人工干预来缓解。模型版本管理、监控与评估等实践对跟踪模型性能至关重要。此外,人工干预对于落实上述实践、以及就数据做出权衡决策(如更新频率与更新规模)同样重要。
持续学习的应用
考虑到持续学习带来的额外成本与复杂性,该方法最适用于存在持续新数据流的应用。这意味着数据任务所处的环境必须持续演化。
当前的持续学习应用包括:
- 计算机视觉。图像驱动数据的动态特性,使持续学习方法在训练算法以识别与分类视觉信息方面颇受欢迎,常用于人脸识别与影像技术。
- 网络安全。在 IT 安全基础设施中实施持续学习以确保持续监控,是检测钓鱼、网络入侵与垃圾信息等安全操作的关键。
- 医疗健康。鉴于疾病的演变特性,持续学习方法被用于多个医疗领域,以提升与疾病诊断相关的工作流。诸如肿瘤学与放射学等专业率先探索了用于此目的的持续学习型 AI。
- 机器人。持续学习被用于提升机器人在不同环境中的适应性与表现,使其能够基于过往与新增经验,在变化条件下优化行动。
持续学习的未来
技术进步推动的数字化、前所未有的数据增长以及社会经济思维的变化,意味着持续学习在未来将被更广泛采用。因为用于各类应用建模的算法需要具备足够的适应性,才能应对每天在生活各个领域中不断增长的数据流。
从当下的计算机视觉应用到未来如智慧城市管理等潜在场景,持续学习有望重塑我们对人工智能成果的期待,将机器智能提升至新高度。
要有效落地持续学习策略,关键在于克服内在挑战,如计算成本、模型管理复杂性以及与数据漂移相关的风险。若您希望系统掌握如何在生产环境中高效开发与管理机器学习模型,并了解如何随时间持续改进这些模型,欢迎报名 DataCamp 的《以 MLOps 思维打造可投产的机器学习模型》课程。该课程将帮助您掌握设计面向生产、且能适应不断演化数据格局的机器学习模型所需的知识与技能。

本教程由我们的社区成员贡献,已由 DataCamp 编辑以提高清晰度与准确性。
想要分享您的专业见解?我们非常期待!欢迎通过我们的社区投稿表单提交文章或创意。
机器学习在对简单与复杂数据的精确建模上都取得了巨大成功。机器学习带来的机会无处不在,但多数方法在实际应用中的“固定”特性,正成为 AI 采纳的减速因素。持续学习正是为此而生。
持续学习是一种机器学习方法,使模型在无需显式再训练的情况下整合新数据。它在传统机器学习基础之上发展,直面现实世界数据的动态本质,打造可随时间提升性能的自适应模型。
什么是持续学习?
持续学习(Continuous Learning),亦称持续机器学习(CML),是指模型无需重新训练,直接从新的数据流中学习的过程。
不同于传统方法先在静态数据集上训练、部署,再定期再训练,持续学习模型会迭代更新参数,以反映数据中新出现的分布。
在这一过程中,模型通过学习最新迭代并在新数据到来时更新其知识而自我改进。持续学习的模型生命周期由于其内在的动态性,使模型能够长期保持相关性。
持续机器学习的类型
持续机器学习的建模方法多种多样。常见策略包括增量学习、迁移学习以及终身学习。
其他示例还有经验回放方法和正则化技术。
与所有数据相关工作一样,方法选择并非黑白分明,而是取决于数据、模型架构、期望性能、任务复杂度以及可用算力。很多时候会组合多种方法来增强学习能力。
持续学习流程
持续学习是对传统机器学习建模的演进。因此,它同样涉及许多相同的建模环节:预处理、模型选择、超参数调优、训练、部署与监控。
在持续学习流程中还需增加两个步骤:数据复现(rehearsal)以及持续学习策略的实施。这些步骤确保模型能根据应用与数据任务的语境,高效地从新数据流中学习。
图 1:面向机器学习的持续学习流程图
持续学习的优势
持续学习适用于各类数据项目:描述性、诊断性、预测性和规范性。它在涉及快速变化数据的场景中尤为重要。与传统机器学习方法相比,其优势包括:
持续学习的局限
持续学习方法并非没有局限。根据任务的性质与预期结果,在采用此类方法前需要充分考量。
从运营视角看,一个挑战在于:
从建模视角看,一些缺点包括:
成本难以轻易规避,但与建模相关的挑战可通过完善的方法论与人工干预来缓解。模型版本管理、监控与评估等实践对跟踪模型性能至关重要。此外,人工干预对于落实上述实践、以及就数据做出权衡决策(如更新频率与更新规模)同样重要。
持续学习的应用
考虑到持续学习带来的额外成本与复杂性,该方法最适用于存在持续新数据流的应用。这意味着数据任务所处的环境必须持续演化。
当前的持续学习应用包括:
持续学习的未来
技术进步推动的数字化、前所未有的数据增长以及社会经济思维的变化,意味着持续学习在未来将被更广泛采用。因为用于各类应用建模的算法需要具备足够的适应性,才能应对每天在生活各个领域中不断增长的数据流。
从当下的计算机视觉应用到未来如智慧城市管理等潜在场景,持续学习有望重塑我们对人工智能成果的期待,将机器智能提升至新高度。
要有效落地持续学习策略,关键在于克服内在挑战,如计算成本、模型管理复杂性以及与数据漂移相关的风险。若您希望系统掌握如何在生产环境中高效开发与管理机器学习模型,并了解如何随时间持续改进这些模型,欢迎报名 DataCamp 的《以 MLOps 思维打造可投产的机器学习模型》课程。该课程将帮助您掌握设计面向生产、且能适应不断演化数据格局的机器学习模型所需的知识与技能。