Este tutorial es una valiosa aportación de nuestra comunidad y DataCamp lo ha editado para garantizar su claridad y exactitud.
¿Te gustaría compartir tu experiencia? ¡Nos encantará conocerte! Envía tus artículos o ideas a través de nuestro formulario de colaboración con la comunidad.
El machine learning ha logrado modelar con gran precisión tanto datos simples como complejos. Las oportunidades que ofrece están por todas partes, pero la rigidez de muchos enfoques en producción frena la adopción de la IA. Ahí es donde entra el aprendizaje continuo.
El aprendizaje continuo es un enfoque de machine learning que permite a los modelos integrar datos nuevos sin necesidad de reentrenarlos explícitamente. Se apoya en los fundamentos del machine learning tradicional para abordar la naturaleza dinámica de los datos del mundo real, creando modelos adaptables que pueden mejorar el rendimiento con el tiempo.
¿Qué es el aprendizaje continuo?
El aprendizaje continuo, también conocido como continuous machine learning (CML), es un proceso en el que un modelo aprende de flujos de datos nuevos sin ser reentrenado.
A diferencia de los enfoques tradicionales, donde los modelos se entrenan con un conjunto de datos estático, se ponen en producción y se reentrenan de forma periódica, los modelos de aprendizaje continuo actualizan sus parámetros de manera iterativa para reflejar nuevas distribuciones en los datos.
En este proceso, el modelo se va perfeccionando al aprender de cada iteración y actualizar su conocimiento a medida que llegan datos nuevos. Gracias a su carácter dinámico, el ciclo de vida de un modelo de aprendizaje continuo le permite mantenerse relevante con el paso del tiempo.
Tipos de aprendizaje continuo
Existen varios enfoques de aprendizaje continuo para modelar. Entre las estrategias más populares están el aprendizaje incremental, el transfer learning y el aprendizaje de por vida (lifelong learning).
Otros ejemplos incluyen los métodos de experiencia repetida (experience replay) y las técnicas de regularización.
Como en todo lo relacionado con datos, la elección no es blanco o negro. Depende de los datos, la arquitectura del modelo, el rendimiento deseado, la complejidad de la tarea y los recursos computacionales disponibles. A menudo se combina más de un enfoque para potenciar las capacidades de aprendizaje.
El proceso de aprendizaje continuo
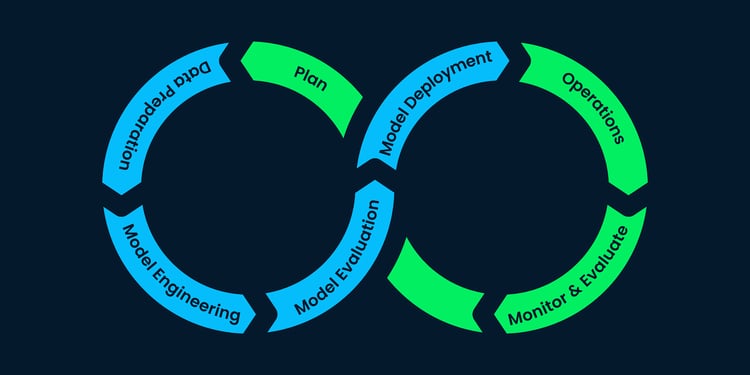
El aprendizaje continuo es una evolución del modelado tradicional de machine learning. Por ello, comparte muchos de sus principios: preprocesado, selección de modelo, ajuste de hiperparámetros, entrenamiento, despliegue y monitorización.
En el aprendizaje continuo se añaden dos pasos más: la repetición de datos (data rehearsal) y la implementación de una estrategia de aprendizaje continuo. Estos pasos garantizan que el modelo aprenda con eficacia de los flujos de datos nuevos en función de la aplicación y el contexto de la tarea.

Figura 1: diagrama de flujo del proceso de aprendizaje continuo en machine learning
Ventajas del aprendizaje continuo
El aprendizaje continuo puede ser útil en todo tipo de proyectos de datos: descriptivos, diagnósticos, predictivos y prescriptivos. Es especialmente importante cuando los datos cambian con rapidez. Frente a un enfoque tradicional, sus beneficios incluyen:
- Generalización. El aprendizaje continuo hace que el modelo sea más robusto y preciso ante datos nuevos.
- Retención de información. Al aplicar una estrategia de aprendizaje continuo, el modelo tiene en cuenta el conocimiento adquirido en iteraciones anteriores y acumula información con el tiempo.
- Adaptabilidad. Un modelo con aprendizaje continuo se adapta a conocimientos nuevos —como el drift de concepto y las tendencias—, lo que a la larga mejora su capacidad predictiva.
Limitaciones del aprendizaje continuo
El aprendizaje continuo también tiene limitaciones. Conviene valorarlas antes de optar por un enfoque de este tipo en función de la naturaleza de la tarea y de los resultados esperados.
Desde el punto de vista operativo, un desafío es:
- Coste. Aunque eficaces, las aproximaciones de aprendizaje continuo suelen ser más complejas computacionalmente que las tradicionales, ya que el modelo debe adaptarse de forma constante a datos nuevos. Esta complejidad suele traducirse en mayores costes económicos al requerir más datos, personas y recursos de cómputo.
Desde la perspectiva del modelado, algunos inconvenientes son:
- Gestión de modelos. Cada vez que un modelo actualiza sus parámetros con datos nuevos, se genera una nueva versión. Por ello, el aprendizaje continuo puede producir muchas variantes, lo que complica identificar cuáles rinden mejor.
- Data drift. Para que el aprendizaje continuo merezca la pena, hay que procesar un gran volumen de datos nuevos. Sin embargo, el modelo puede perder capacidad predictiva si la distribución de características cambia de forma brusca. Puedes saber más sobre el data drift en otro artículo.
Aunque el coste no es fácil de sortear, los retos de modelado pueden mitigarse con una buena metodología y con intervención humana. Prácticas como el versionado, la monitorización y la evaluación de modelos son clave para seguir su rendimiento. Además, la intervención humana es importante para aplicar estas prácticas y tomar decisiones contingentes sobre los datos, como la frecuencia y el tamaño de las actualizaciones.
Aplicaciones del aprendizaje continuo
Dado el coste y la complejidad añadidos del aprendizaje continuo, este enfoque encaja mejor en aplicaciones con un flujo constante de datos nuevos. Es decir, el entorno de la tarea debe estar en continua evolución.
Las aplicaciones actuales del aprendizaje continuo incluyen:
- Visión por computador. La naturaleza dinámica de los datos basados en imágenes hace que los enfoques de aprendizaje continuo sean muy populares para entrenar algoritmos que identifican y clasifican información visual. Se aplican con frecuencia en reconocimiento facial y tecnologías de imagen.
- Ciberseguridad. Se implementan enfoques de aprendizaje continuo para garantizar una monitorización constante en infraestructuras de seguridad TI. Son clave para detectar phishing, intrusiones de red y spam, entre otras operaciones de seguridad.
- Sanidad. Dada la evolución constante de las enfermedades, el aprendizaje continuo se utiliza en varios ámbitos sanitarios para optimizar los flujos de trabajo de diagnóstico. Especialidades como la oncología y la radiología han sido pioneras en explorar la IA de aprendizaje continuo con este fin.
- Robótica. El aprendizaje continuo se ha utilizado para mejorar la adaptabilidad y el rendimiento de robots en distintos entornos, permitiéndoles optimizar sus acciones en condiciones cambiantes a partir de experiencias pasadas y nuevas.
El futuro del aprendizaje continuo
La digitalización impulsada por los avances tecnológicos, la generación de datos sin precedentes y los cambios de mentalidad socioeconómicos harán que el aprendizaje continuo se adopte cada vez más. Los algoritmos que modelan distintas aplicaciones deberán ser lo bastante adaptables para afrontar el creciente caudal de datos en todas las áreas de la vida, cada día.
Desde aplicaciones actuales como la visión por computador hasta otras futuras como la gestión de smart cities, el aprendizaje continuo puede revolucionar lo que esperamos de la inteligencia artificial y llevar la inteligencia de las máquinas a otro nivel.
Para implementar estrategias de aprendizaje continuo con eficacia, es fundamental superar retos inherentes como los costes computacionales, la complejidad en la gestión de modelos y los riesgos asociados al data drift. Si quieres dominar el desarrollo y la gestión de modelos de machine learning en producción y aprender cómo mejorarlos de forma continua, no te pierdas el curso de DataCamp Developing Machine Learning Models for Production with an MLOps Mindset. Te aportará los conocimientos y las habilidades necesarias para diseñar modelos listos para producción y capaces de adaptarse a entornos de datos en constante cambio.