

下一篇博文将解释如何将主动学习与迁移学习结合使用,以最佳方式利用现有(及新增)数据。广义而言,凡是借助外部信息以提升性能或泛化能力的机器学习应用,都可归入迁移学习。
迁移学习:定义
迁移学习的总体思想,是在标注数据充足的任务上学到的知识,迁移到标注数据稀缺的场景中加以利用。创建标注数据代价高昂,因此充分利用现有数据集至关重要。
在传统机器学习模型中,首要目标是基于从训练数据中学习到的模式,对未见过的数据实现良好的泛化。有了迁移学习,您尝试通过借用为另一项任务所学到的模式来“启动”这一泛化过程。本质上,您并非从一张(通常随机初始化的)白纸开始学习过程,而是从已用于解决其他任务的已学模式出发。
知识与模式的迁移在多种领域皆有可能。今天的文章将通过多个不同领域的示例来说明迁移学习。其目标是激励数据科学家在机器学习项目中尝试迁移学习,并让他们了解其优缺点。
我认为,透彻理解迁移学习之所以是数据科学家的关键技能,有三点原因:
- 迁移学习是任何学习形式的核心。人类并非为了每一项任务或问题都被逐条教授才能取得成功。每个人都会遇到前所未有的情境,我们仍能临机应变地解决问题。从大量经验中学习并将“知识”迁移到新环境,这正是迁移学习的精髓。从这个角度看,迁移学习与泛化在概念层面高度相似。主要区别在于,迁移学习常用于“跨任务迁移知识”,而非在某一特定任务内泛化。因此,迁移学习与所有机器学习模型所需的泛化理念本就内在相连。
- 迁移学习是让深度学习技术在众多小数据场景中取得突破的关键。深度学习几乎无处不在于学术研究,但大量现实场景往往没有数百万条标注样本来训练模型。深度学习技术需要海量数据来调优神经网络中的数以百万计的参数。尤其在监督学习中,这意味着您需要大量(且成本极高)的标注数据。给图像打标签听上去很简单,但在自然语言处理(NLP)中,要构建大规模标注数据集则需要专家知识。以词性标注语料库 Penn Treebank 为例,耗时 7 年完成,并需要受训语言学家的紧密合作。迁移学习是降低数据集规模以使神经网络可行的一种方式。其他可行方法还包括转向更具概率建模启发的模型,这类模型通常更适合处理有限数据集。
- 迁移学习既有显著优势,也存在局限。理解这些局限对成功的机器学习应用至关重要。只有当“合适”时,知识迁移才可能。精确定义在此语境下“合适”的含义并不容易,通常需要实验验证。不会有人因为幼儿能开玩具车,就去信任他驾驶法拉利。同样的道理适用于迁移学习:尽管难以量化,但迁移学习存在上限,并非一劳永逸的通用解法。
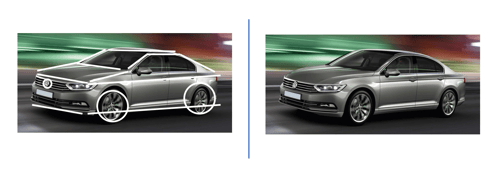 | 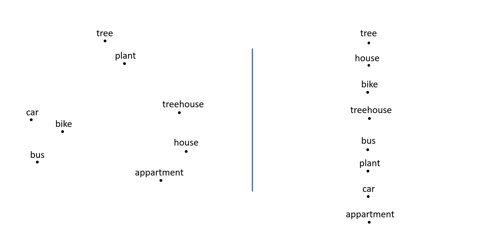 |
迁移学习的一般概念
迁移学习的要求
顾名思义,迁移学习需要具备将知识从一个领域转移到另一个领域的能力。迁移学习可以在高层面进行理解,即 NLP 的模型架构可复用于序列预测问题,因为许多 NLP 问题本质上都可归约为序列预测。迁移学习也可以在低层面理解,即您实际在不同模型之间复用参数(如 skip-gram、continuous bag-of-words 等)。迁移学习的要求一方面与问题相关,另一方面与模型相关。接下来的两个小节将分别讨论高层与低层的迁移学习方法。尽管在文献中这些概念可能有不同命名,但迁移学习这一总括性思想始终存在。
多任务学习
在多任务学习中,您同时在不同任务上训练一个模型。通常采用深度学习模型,因为它们具备灵活适配性。
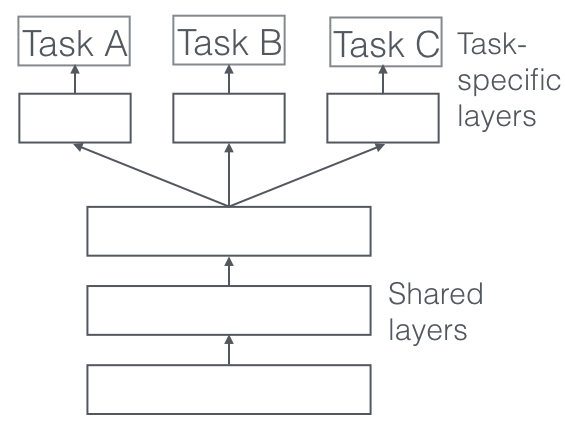
网络结构会被调整为:前若干层在不同任务间共享,随后是任务特定的若干层和输出。总体思路是,通过在不同任务上联合训练,网络将获得更好的泛化能力,因为模型被要求在一组需要相似“知识”或“处理”的任务上都表现良好。
以自然语言处理为例,假设模型的最终目标是实体识别。与其只在实体识别任务上训练,您还可以让它同时做词性分类、下一词预测等。如此,模型将受益于这些任务及其不同数据集所带来的结构学习。我强烈推荐阅读 Sebastian Ruder 的这篇博文以及这篇文章,二者都从多任务学习的角度进行探讨,便于您深入了解多任务学习。
特征提取器
深度学习模型的一大优势在于特征提取是“自动”的。基于标注数据与反向传播,网络能够自行确定任务所需的有用特征。网络会“找出”输入中哪些部分对(例如)图像分类重要。这意味着手工定义特征的工作被抽象掉了。深度学习网络可复用于其他问题,因为其提取的特征类型往往对其他问题也有用。本质上,在特征提取器的设置中,您使用网络的前几层来提取有用特征,但不使用网络的最终输出,因为那通常过于任务特定。
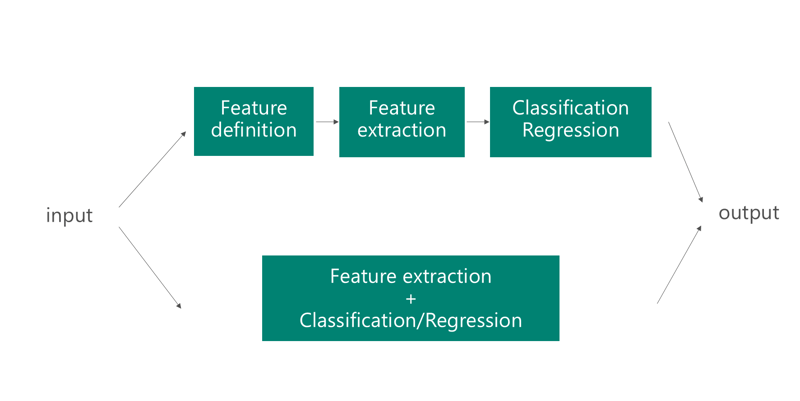
鉴于深度学习系统擅长特征提取,如何复用现有网络来为其他任务执行特征提取?可以将数据样本输入网络,并把网络中的某个中间层作为输出。该中间层可被视为对原始数据的一种定长、已处理过的表示。通常,特征提取器的概念多用于计算机视觉。此时将图像输入预训练网络(如 VGG 或 AlexNet),并在新的数据表示上使用其他机器学习方法。将某个中间层作为图像表示会显著降低原始数据维度,使其更适合传统机器学习技术(例如,对一个维度为 128 的小型图像表示,逻辑回归或 SVM 通常比在原始 128x128=16384 维上表现更好)。
迁移学习的应用
NLP
我之前的一篇博文讨论了如今许多 NLP 流水线都会使用词嵌入。与独热编码相比,词嵌入是一种更具信息量的词表示方式。它们被广泛使用,并存在多种变体。通常,这些变体在其来源语料(如维基百科、新闻文章等)以及嵌入模型的差异上有所不同。理解这些模型与语料的背景,有助于判断在词嵌入上进行迁移学习是否合理。人们往往不会把使用词嵌入称为迁移学习,但我并不同意这种看法,因为它与计算机视觉中的迁移学习非常相似。本质上,使用词嵌入意味着您在使用一个特征提取器或嵌入网络,把词转换为向量。
尽管 word2vec 已面世 4 年,但仍是极具影响力的词嵌入方法。另一方面,近期的方法如 FastText 已将词嵌入带到大量语言中。来自 word2vec 或 FastText 的嵌入,相较于词袋方法是重要的进步。然而,它们的有效性通常取决于问题领域。
想象您在为销售人员构建新闻推荐服务。销售人员希望收到那些可能对其产品感兴趣的公司的新闻。新闻文章中使用的词汇通常相当通用或广泛,这意味着其词汇往往能被大多数词嵌入所覆盖(取决于其训练语料)。此外,如果您让销售人员在几周内收集他们阅读的新闻文章,您就能马上获得一个规模可观的标注语料库。通过复用词嵌入,推荐引擎的表现很可能会显著提升。
另一方面,假设您需要对法律合同进行主题分类。并非一般的法律合同,而是与竞争法相关的法语法律合同。这类数据集通常没有标注,或只有一小部分文档被标注。下一节将说明在这种情况下,开箱即用的迁移学习为何难以奏效:
- 词表外(OOV)词是指训练时未见过的词。虽然 word2vec 和 FastText 基于维基百科或其他语料训练,但其词表是有限的。训练期间,出现频率不高的词常被剔除。这意味着,竞争法法律合同中的领域特定词语可能得不到支持。使用预训练词嵌入时,您通常会检查 OOV 词并将其替换为 UNK(未知词)标记,且所有这些词会被分配相同的向量。若语料是领域特定的,这种做法极其低效,因为领域特定词通常承载大量语义。如果大多数(承载语义的)词都被 UNK 替代,模型将无从学习。
- 相较于标准的预训练词嵌入,另一种选择是在大规模无监督文档集上对嵌入进行微调。注意,这只有在可用文档数量足够大的情况下才可行。这意味着,如果您有一个关于竞争法的大型语料库,就可以在更通用词的预训练词嵌入基础上,为领域特定词训练词嵌入。通常,从预训练词嵌入起步会加速整个过程,并使自训练词嵌入更容易。但请注意,这仍比直接使用开箱即用的词嵌入更难,并需要一定的语料准备与训练知识。
我强烈建议阅读这篇关于词嵌入现状的优秀博文。结合其中提到的问题与解决方案,对于在数据有限的情况下构建稳健的 NLP 系统与词嵌入至关重要。
Gensim、spaCy 和 FastText 是三个很棒的框架,能让您在机器学习应用中快速使用词嵌入。此外,它们也支持自定义词嵌入的训练。查看这个gensim 教程、这个spaCy 教程或这个FastText 教程以了解更多!
计算机视觉中的迁移学习
深度学习方法在计算机视觉领域取得了显著成功。不必再手工定义问题特定的特征,例如方向梯度直方图(HoG)特征、直方图特征等,深度学习使实践者能够训练以原始图像作为输入的模型。特征定义的原始复杂性,如今转移到了网络结构设计的复杂性上。尽管网络结构常被复用,但并无单一的架构组合策略。通常,深度学习技术是在巨大的数据集(如 ImageNet 或 MS COCO)上于研究环境中发明并应用的。为了在这些大数据集上提升性能,研究人员提出了深度与复杂度不断提高的网络架构。这些架构带来拥有数百万参数的模型,而这类模型(通常)难以扩展到小型图像数据集。若在不足 5,000 张图像的数据集上训练诸如残差网络(ResNet)或 VGG 网络的架构,往往会出现严重过拟合。近期的深度学习浪潮带来了重大进展,但似乎让仅有小数据集的数据科学家陷入了困境。
事实证明,深度学习网络会学习分层的特征表示(参见 Distill 的这篇博文)。这意味着底层更倾向于学习边缘等低层特征,而高层会学习更高阶、但难以解释的概念,如形状。这种分层表示的思想在网络于不同数据集上训练时同样出现,表明它们可在不同问题领域中复用。
在计算机视觉问题中使用迁移学习时,常见两种方法。
- 其一,如果有相当数量的图片(每类 >1,000 张),您可以用在其他数据集上训练过的模型权重来初始化新模型。训练时保留若干层不变(通常是前几层卷积层),只优化更高层的参数。其目标是减少需要优化的参数数量,同时复用底层特征。底层特征很可能不受问题领域影响而相对相似,而模型可以自由组合更高层以适应具体问题。
- 其二,如果仅有极少量图片(<1,000),在大多数情况下,重训现有模型仍会导致过拟合。相对于图像数量,需要优化的参数实在太多。即便如此,只要数据在视觉上与大型数据集中的图像相似,就可以将大型预训练网络(在该大型数据集上训练)作为特征提取器。更具体地,您移除大型网络的最后 N 层(通常 N=1 或 N=2),并将大型预训练网络的输出作为图像的特征表示。这同样基于一个假设:预训练网络的前几层学习到的是与具体问题无关的特征。随后,这些特征可以与 SVM 或逻辑回归等方法一起使用,类似于传统计算机视觉方法。不同的是,此时无需手工定义特征,而是把预训练网络当作特征提取器。
Keras 的 API允许您加载预训练网络并在训练期间固定若干层。在下一节中,我将再次讨论两个用例:一个适合用迁移学习,另一个则不适合。
设想您从事野生动物保护工作,希望对直播摄像头捕捉到的不同动物进行分类。尤其是在监测濒危物种时,标注数据可能难以收集。鉴于预训练网络常常是在广泛的概念域(涵盖食物、动物、物体等)上训练的,将其作为特征提取器或初始化器不失为一种选择。
另一方面,设想您需要为肿瘤科医生分析放射影像。这些图像不同于常见的猫狗图片,它们来自对患者进行扫描后的结果。尽管可将其转换为 RGB 图像,但通常以灰度表现扫描结果。虽然预训练网络能从 RGB 图像中检测形状与边缘,但在放射影像上可能难以奏效,因为这类图像并不在预训练模型的训练数据中。此外,在医疗场景下,标注数据通常较少。确实存在若干技术可利用(潜在大量的)未标注数据,但往往需要更多工作与微调。通常,这些技术会尝试通过逐层训练网络去重构图像(使用卷积与反卷积层)来预训练分类网络的权重。为改进收敛,常将这些技术与预训练网络结合使用。
上述两种计算机视觉方法都建立在一个重要假设之上:原始数据集中提取的模式在新数据集中同样有用。这种“有用性”难以量化,但却是必须考虑的重要前提。地震、超光谱,甚至医学影像与 ImageNet 中的图像相似性有限;而识别图片中的交通标志则依赖相当相似的模式。理解计算机视觉的问题领域,对成功应用计算机视觉至关重要。通过了解迁移学习中所用模型(数据集、技术等)的背景,您可以在实验中避免徒劳无功,把精力放在可能带来改观的模型微调上。
本文将介绍“迁移学习”的概念及其在机器学习应用中的用法。迁移学习不是一种机器学习模型或技术;它更像是机器学习中的一种“设计方法论”。另一种“设计方法论”的例子是主动学习。