直到几年前,您是否能想象一台机器可以创作艺术、编写故事,甚至理解医疗和法律等复杂数据?
大概不会。对我们大多数人来说,这还只是科幻小说中的情节,似乎离现实很遥远。
但生成式 AI 时代的到来,重塑了我们对机器能力的认知。
什么是生成式 AI?
生成式 AI 是人工智能的一个复杂分支,它让机器能够利用现有内容(文本、音频、视频,甚至代码)来生成全新的内容。
Gartner 将其列为“最具影响力且快速演进、能够带来生产力革命的技术之一”。
它正在迅速成为现实,并催生出众多创新应用,正在改变各行各业。例如,在媒体领域加速并增强内容创意,在零售领域用于营销,在医疗领域提供更完善且个性化的治疗方案,并在教育领域实现自适应的学习风格。
生成式 AI 的伦理关注点
此类应用进入市场的速度极具冲击力。
但当 OpenAI 首席执行官 Sam Altman 警示我们语言模型的危险时——风险是真实存在的,这要求我们在受益的同时保持谨慎,负责任地利用这项强大的技术。
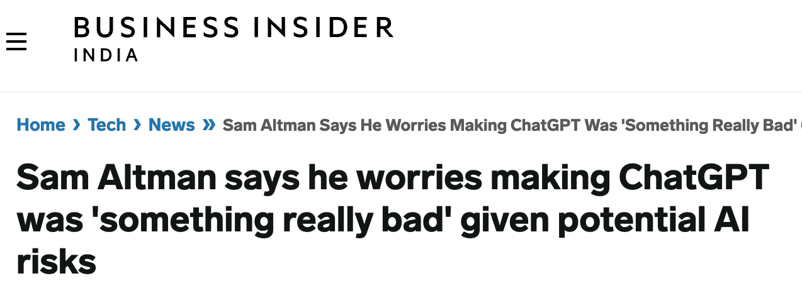
图片来源:Business Insider
让我们来了解使用生成式 AI 的一些关键伦理关注点。
有害内容的传播
尽管生成式 AI 系统生成类人内容的能力可以提升业务生产力,但也可能产出有害或冒犯性的内容。最令人担忧的危害来自 Deepfake 等工具,它们可以生成虚假的图像、视频、文本或语音,可能带有特定议程,或被用于煽动仇恨言论。
近日,一名诈骗者克隆了一名女孩的声音,通过伪造的绑架向其母亲勒索赎金。这些工具已经变得如此复杂,以至于很难分辨真假声音。
此外,自动生成的内容可能延续或放大从训练数据中学到的偏见,导致带有偏见、露骨或暴力的语言。此类有害内容需要人工干预,使其与组织在使用该技术时的商业伦理相一致。
版权与法律风险
与大多数 AI 模型一样,生成式 AI 模型依赖大量数据进行训练。基于其本质,它可能侵犯其他公司的版权和知识产权。对于使用预训练模型的公司而言,这会带来法律、声誉和财务风险,并可能对创作者和版权持有人造成负面影响。
数据隐私违规
底层训练数据可能包含敏感信息,包括可识别个人身份的信息(PII)。根据美国劳工部的定义,PII 是“可直接识别个人身份的数据,例如姓名、地址、社会安全号码或其他识别号码或代码、电话号码和电子邮件地址。”
侵犯用户隐私可能导致身份盗用,并可能被用于歧视或操纵。
因此,无论是预训练模型的开发者,还是将这些模型微调用于特定任务的公司,都必须遵守数据隐私指南,并确保在模型训练中移除 PII 数据。
我们举办了一场网络研讨会,讲解数据隐私法规,特别是 GDPR,以确保数据的合伦理使用。
敏感信息泄露
在强调谨慎使用用户数据的重要性的同时,还需考虑因无意泄露敏感信息而带来的风险,而 AI 能力的快速普及进一步放大了这一担忧。生成式 AI 工具,尤其是 ChatGPT,因其新奇与便捷,可能会诱使用户在探索新平台时忽视数据安全。
如果员工上传了法律合同、软件产品的源代码或专有信息等敏感细节,风险会显著增加。
无论是在财务、声誉还是法律方面,后果都可能十分严重,因此制定清晰的数据安全政策就变得显而易见且必不可少。
加剧既有偏见
AI 模型的好坏取决于其训练数据。如果训练数据反映了社会中存在的偏见,模型也会表现出类似的偏见——或者我们原本是这么认为的。彭博社近期的一项研究指出,这些模型甚至比其训练所用的真实世界数据更有偏见。
研究揭示了一个残酷现实:“依照 Stable Diffusion 展现的世界,白人男性是 CEO。女性很少是医生、律师或法官。深色皮肤的男性犯罪,而深色皮肤的女性在翻烤汉堡。”
要构建更公平的世界,数据必须相应反映这种目标,即在模型开发生命周期中纳入多元化的团队与视角。
劳动力角色与士气
一方面,生成式 AI 被视为释放生产力的下一波浪潮;另一方面,它也意味着工作岗位的流失,因为完成同样数量的工作所需的人手更少。
最新的麦肯锡报告也体现了对现有技能被替代的担忧——“当前的生成式 AI 和其他技术有潜力将如今占据员工 60% 至 70% 时间的工作活动实现自动化。”
尽管另一面显示许多岗位当下面临风险,但这并不意味着要停止生成式 AI 带来的转型;相反,这无疑要求采取措施,对劳动者进行技能提升或再培训,以适应先进 AI 时代带来的新角色。
数据来源可追溯性
围绕 AI 工具使用的多数问题都与数据相关,包括用户隐私、生成文本、图像、视频或音频等合成多模态数据。
此类系统需要维护数据的可信度与完整性,以避免使用带有偏见或来源可疑的数据。
缺乏透明度
AI 系统本质上是“黑箱”,这意味着很难理解它们如何得出特定的回答,或有哪些因素影响了它们的决策。
大型模型的涌现能力进一步加剧了这一差距,连开发者也会对其功能感到惊讶,这凸显出:“研究人员不仅在努力识别更多的涌现能力,还在试图弄清它们为何以及如何出现,以便尝试预测不可预测性。”
AI 生成错误信息的实例
近日,有一项研究评估参与者能否辨别 AI 生成的内容与人类撰写的内容。毫不意外,结果显示人们很难区分语言模型生成的内容,凸显了这些模型大规模传播错误信息的能力。
此类错误信息的一个前所未有的例子最近出现在美国法庭:一名律师引用了一个并不存在的法律案例,依赖于 ChatGPT 生成的回答。
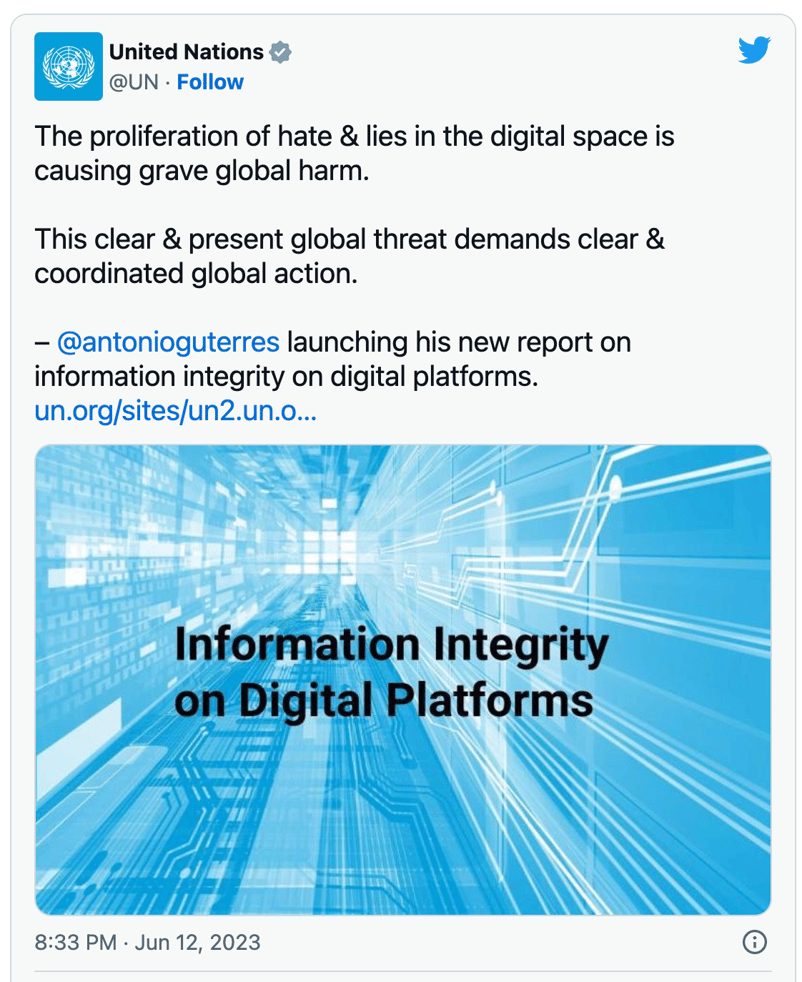
联合国也对 AI 生成的误导性内容表示担忧,认为其可能引发冲突与犯罪。
生成式 AI 的伦理最佳实践
在受控且受监管的方式下使用,由生成式 AI 模型发展带来的技术进步更有可能造福社会。这需要采用伦理最佳实践,以尽量减少伴随其优势而来的潜在危害。
保持知情并付诸行动
深入了解当下与未来的数据伦理格局。无论您是个人贡献者还是组织领导者,都要理解并掌握相应的应用指南。
您可以在另一篇文章中进一步阅读当下与未来的数据伦理格局及其应用指南。
与全球标准保持一致
同样值得熟悉的是 UNESCO 的 AI 伦理指南,所有 193 个成员国已于 2021 年 11 月通过。
该指南强调四项核心价值:
- 人权与尊严
- 和平与公正的社会
- 多样性与包容性
- 环境繁荣
它还概述了十项原则,包括比例性、安全、隐私、多方治理、责任、透明度、人类监督、可持续性、意识与公平。
该指南还就数据治理、环境、性别、教育、研究、健康与社会福祉等领域提出了政策行动方向。
参与伦理 AI 社群
还有许多其他团体,如 AI Ethics Lab 和 Montreal AI Ethics Institute,专注于提升伦理素养。共同的伦理原则包括透明度、可问责性、数据隐私与稳健性,重点面向技术提供方。
持续关注这些领域的最新进展,并参与围绕 AI 伦理的讨论,是确保生成式 AI 对所有用户都保持安全的关键一环。
培养警觉并持续学习
作为用户,我们有责任摒弃对数字世界“凡见即真”的天真想法。
相反,当我们在付诸实践之前开始通过事实核查,验证信息的真实性与来源时,多数问题将迎刃而解。
提升认知是把握生成式 AI 的关键,也是撰写此文的初衷。
结语
生成式 AI 通过创造新内容并提升生产力,拥有在医疗到教育等多个领域引发变革的巨大潜力。
然而,这项强大的技术也带来了重大的伦理关注点,包括有害内容的传播、版权侵权、数据隐私违规以及既有偏见的放大。
在我们持续发挥生成式 AI 能力的同时,至关重要的是采纳伦理最佳实践
您可以从我们的 Generative AI Concepts 课程开始您的学习之旅,并开始探索您今天就可以着手的生成式 AI 项目。


直到几年前,您是否能想象一台机器可以创作艺术、编写故事,甚至理解医疗和法律等复杂数据?
大概不会。对我们大多数人来说,这还只是科幻小说中的情节,似乎离现实很遥远。
但生成式 AI 时代的到来,重塑了我们对机器能力的认知。
什么是生成式 AI?
生成式 AI 是人工智能的一个复杂分支,它让机器能够利用现有内容(文本、音频、视频,甚至代码)来生成全新的内容。
Gartner 将其列为“最具影响力且快速演进、能够带来生产力革命的技术之一”。
它正在迅速成为现实,并催生出众多创新应用,正在改变各行各业。例如,在媒体领域加速并增强内容创意,在零售领域用于营销,在医疗领域提供更完善且个性化的治疗方案,并在教育领域实现自适应的学习风格。
生成式 AI 的伦理关注点
此类应用进入市场的速度极具冲击力。
但当 OpenAI 首席执行官 Sam Altman 警示我们语言模型的危险时——风险是真实存在的,这要求我们在受益的同时保持谨慎,负责任地利用这项强大的技术。
图片来源:Business Insider
让我们来了解使用生成式 AI 的一些关键伦理关注点。
有害内容的传播
尽管生成式 AI 系统生成类人内容的能力可以提升业务生产力,但也可能产出有害或冒犯性的内容。最令人担忧的危害来自 Deepfake 等工具,它们可以生成虚假的图像、视频、文本或语音,可能带有特定议程,或被用于煽动仇恨言论。
近日,一名诈骗者克隆了一名女孩的声音,通过伪造的绑架向其母亲勒索赎金。这些工具已经变得如此复杂,以至于很难分辨真假声音。
此外,自动生成的内容可能延续或放大从训练数据中学到的偏见,导致带有偏见、露骨或暴力的语言。此类有害内容需要人工干预,使其与组织在使用该技术时的商业伦理相一致。
版权与法律风险
与大多数 AI 模型一样,生成式 AI 模型依赖大量数据进行训练。基于其本质,它可能侵犯其他公司的版权和知识产权。对于使用预训练模型的公司而言,这会带来法律、声誉和财务风险,并可能对创作者和版权持有人造成负面影响。
数据隐私违规
底层训练数据可能包含敏感信息,包括可识别个人身份的信息(PII)。根据美国劳工部的定义,PII 是“可直接识别个人身份的数据,例如姓名、地址、社会安全号码或其他识别号码或代码、电话号码和电子邮件地址。”
侵犯用户隐私可能导致身份盗用,并可能被用于歧视或操纵。
因此,无论是预训练模型的开发者,还是将这些模型微调用于特定任务的公司,都必须遵守数据隐私指南,并确保在模型训练中移除 PII 数据。
我们举办了一场网络研讨会,讲解数据隐私法规,特别是 GDPR,以确保数据的合伦理使用。
敏感信息泄露
在强调谨慎使用用户数据的重要性的同时,还需考虑因无意泄露敏感信息而带来的风险,而 AI 能力的快速普及进一步放大了这一担忧。生成式 AI 工具,尤其是 ChatGPT,因其新奇与便捷,可能会诱使用户在探索新平台时忽视数据安全。
如果员工上传了法律合同、软件产品的源代码或专有信息等敏感细节,风险会显著增加。
无论是在财务、声誉还是法律方面,后果都可能十分严重,因此制定清晰的数据安全政策就变得显而易见且必不可少。
加剧既有偏见
AI 模型的好坏取决于其训练数据。如果训练数据反映了社会中存在的偏见,模型也会表现出类似的偏见——或者我们原本是这么认为的。彭博社近期的一项研究指出,这些模型甚至比其训练所用的真实世界数据更有偏见。
研究揭示了一个残酷现实:“依照 Stable Diffusion 展现的世界,白人男性是 CEO。女性很少是医生、律师或法官。深色皮肤的男性犯罪,而深色皮肤的女性在翻烤汉堡。”
要构建更公平的世界,数据必须相应反映这种目标,即在模型开发生命周期中纳入多元化的团队与视角。
劳动力角色与士气
一方面,生成式 AI 被视为释放生产力的下一波浪潮;另一方面,它也意味着工作岗位的流失,因为完成同样数量的工作所需的人手更少。
最新的麦肯锡报告也体现了对现有技能被替代的担忧——“当前的生成式 AI 和其他技术有潜力将如今占据员工 60% 至 70% 时间的工作活动实现自动化。”
尽管另一面显示许多岗位当下面临风险,但这并不意味着要停止生成式 AI 带来的转型;相反,这无疑要求采取措施,对劳动者进行技能提升或再培训,以适应先进 AI 时代带来的新角色。
数据来源可追溯性
围绕 AI 工具使用的多数问题都与数据相关,包括用户隐私、生成文本、图像、视频或音频等合成多模态数据。
此类系统需要维护数据的可信度与完整性,以避免使用带有偏见或来源可疑的数据。
缺乏透明度
AI 系统本质上是“黑箱”,这意味着很难理解它们如何得出特定的回答,或有哪些因素影响了它们的决策。
大型模型的涌现能力进一步加剧了这一差距,连开发者也会对其功能感到惊讶,这凸显出:“研究人员不仅在努力识别更多的涌现能力,还在试图弄清它们为何以及如何出现,以便尝试预测不可预测性。”
AI 生成错误信息的实例
近日,有一项研究评估参与者能否辨别 AI 生成的内容与人类撰写的内容。毫不意外,结果显示人们很难区分语言模型生成的内容,凸显了这些模型大规模传播错误信息的能力。
此类错误信息的一个前所未有的例子最近出现在美国法庭:一名律师引用了一个并不存在的法律案例,依赖于 ChatGPT 生成的回答。
联合国也对 AI 生成的误导性内容表示担忧,认为其可能引发冲突与犯罪。
生成式 AI 的伦理最佳实践
在受控且受监管的方式下使用,由生成式 AI 模型发展带来的技术进步更有可能造福社会。这需要采用伦理最佳实践,以尽量减少伴随其优势而来的潜在危害。
保持知情并付诸行动
深入了解当下与未来的数据伦理格局。无论您是个人贡献者还是组织领导者,都要理解并掌握相应的应用指南。
您可以在另一篇文章中进一步阅读当下与未来的数据伦理格局及其应用指南。
与全球标准保持一致
同样值得熟悉的是 UNESCO 的 AI 伦理指南,所有 193 个成员国已于 2021 年 11 月通过。
该指南强调四项核心价值:
它还概述了十项原则,包括比例性、安全、隐私、多方治理、责任、透明度、人类监督、可持续性、意识与公平。
该指南还就数据治理、环境、性别、教育、研究、健康与社会福祉等领域提出了政策行动方向。
参与伦理 AI 社群
还有许多其他团体,如 AI Ethics Lab 和 Montreal AI Ethics Institute,专注于提升伦理素养。共同的伦理原则包括透明度、可问责性、数据隐私与稳健性,重点面向技术提供方。
持续关注这些领域的最新进展,并参与围绕 AI 伦理的讨论,是确保生成式 AI 对所有用户都保持安全的关键一环。
培养警觉并持续学习
作为用户,我们有责任摒弃对数字世界“凡见即真”的天真想法。
相反,当我们在付诸实践之前开始通过事实核查,验证信息的真实性与来源时,多数问题将迎刃而解。
提升认知是把握生成式 AI 的关键,也是撰写此文的初衷。
结语
生成式 AI 通过创造新内容并提升生产力,拥有在医疗到教育等多个领域引发变革的巨大潜力。
然而,这项强大的技术也带来了重大的伦理关注点,包括有害内容的传播、版权侵权、数据隐私违规以及既有偏见的放大。
在我们持续发挥生成式 AI 能力的同时,至关重要的是采纳伦理最佳实践
您可以从我们的 Generative AI Concepts 课程开始您的学习之旅,并开始探索您今天就可以着手的生成式 AI 项目。