

学习路径
AI 基础知识
10 小时
实践并学习路径你的进步。
使用 Google 继续Mini-Max 算法在人工智能领域有着悠久历史,可追溯至 1920 年代。尽管彼时并未用“AI”来称呼计算机算法,但这一奠基性算法无疑为机器如何在对抗场景中做出最优决策提供了最早的洞见。该算法由约翰·冯·诺伊曼在其 1928 年论文《Zur Theorie der Gesellschaftsspiele》(《博弈论》)中首次形式化,为现代博弈论与决策算法奠定了基础。
1997 年,IBM 的“深蓝”使用 Mini-max 的高级变体击败了国际象棋世界冠军加里·卡斯帕罗夫。自那以后,该算法成为更复杂方法(如 蒙特卡洛树搜索(MCTS)和 强化学习系统)的基石。
在本文中,我们不会重现用于国际象棋的著名“深蓝”,而是用 Python 为井字棋构建一个更简单的版本。过程中,您将直观理解该算法的工作原理,并学会如何将其应用于更复杂的真实世界博弈。
Minimax 通常用于两人对弈类游戏(如国际象棋、井字棋或西洋跳棋)的决策。它让计算机能够提前规划多步,同时假设对手总会做出其最优选择。本节将通过井字棋的例子概览该算法。
在真实的井字棋里,每当轮到您下子,您会在假设对手也会下出最佳着法的前提下,努力做出最优一步。Minimax 算法做的正是这件事——通过前瞻所有可能走法来帮助计算机选出最优着法。
Minimax 的命名源于其工作方式:
轮到您时,您要做能最大化胜率的着法;轮到对手时,您假设对手会做出让您局面最差的着法(最小化)。
Minimax 在人工智能中之所以重要,主要有以下原因:
更酷的是,这一理念也广泛用于现实场景:
虽然 Minimax 听起来复杂,但本质上就是教计算机像谨慎的棋手那样,在决策前既考虑自己的着法,也考虑对手的应对。
我们用一个简单的井字棋示例来拆解 Minimax 的工作原理。假设您执 X,计算机执 O。
当轮到计算机走子时,它会按以下步骤进行:
计算机可以采用一个简单的计分体系:
可以将其想象成一棵可能性的树:
计算机在两种模式间切换:
1. 最大化模式(计算机回合):
2. 最小化模式(玩家回合):
假设在下面这个局面中轮到计算机(X):
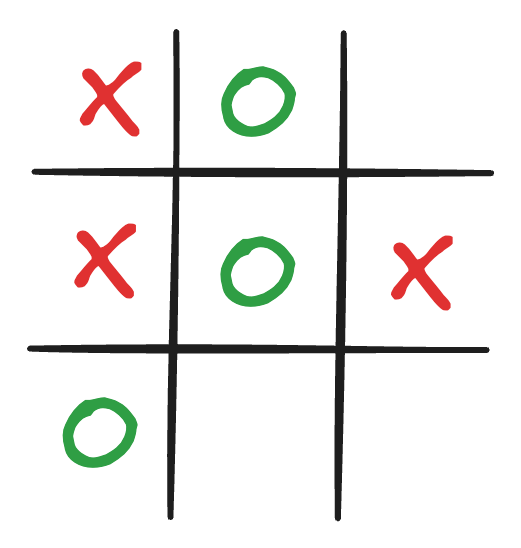
计算机会:
这种前瞻式思考让计算机每次都能下出完美的井字棋!
我们一步步编写 Minimax 算法。即便您对伪代码不熟悉也不用担心——可以把它当作在写自然语言步骤,之后再把它翻译为真正的代码!
Minimax 函数需要三样关键输入:
基本伪代码如下:
function minimax(board, depth, isMaximizingPlayer):
   # First, check if the game is over
   if game is won:
       return +10 if computer wins, -10 if human wins
   if game is tied:
       return 0

   # If it's the computer's turn (maximizing)
   if isMaximizingPlayer:
       bestScore = -infinity
       for each empty spot on board:
           make the move
           score = minimax(board, depth + 1, false)
           undo the move
           bestScore = max(score, bestScore)
       return bestScore

   # If it's the human's turn (minimizing)
   else:
       bestScore = +infinity
       for each empty spot on board:
           make the move
           score = minimax(board, depth + 1, true)
           undo the move
           bestScore = min(score, bestScore)
       return bestScore
尽管大多数伪代码用英语书写也易于理解,但上述示例的特别之处在于使用了递归。递归是指函数为解决更大的问题而反复调用自身。可以把它想象成两面相对的镜子——同一画面被不断重复,每次都更小一些。
在我们的 Minimax 算法中,需要用递归来遍历游戏中所有可能的未来着法。每次函数自调用,都是在考察下一步可能发生的情况。
这有助于我们通过检查游戏所有可能的演变来找出最佳着法,就像一个非常聪明的棋手不断思考“如果我这么走,他可能那样应对,然后我还能这样……”一直到终局。若想进一步理解递归,您可以阅读我们的递归专题教程。
让我们在一个简单局面中看看它如何工作:
1. 起始局面:
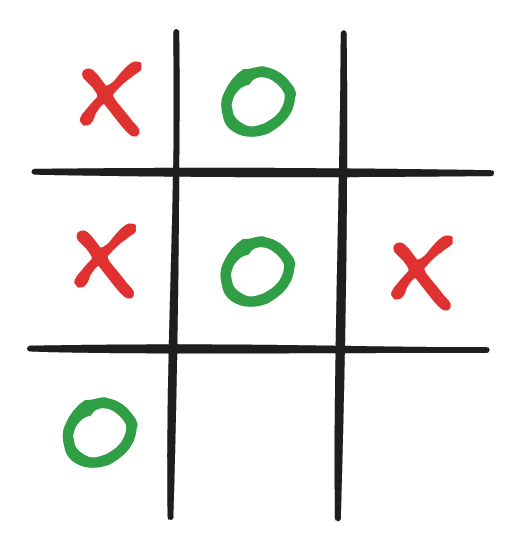
2. 计算机这样思考:
3. 对每个空位,计算机会:
可以把它类比为下国际象棋——您总在想“我若走这儿,他会走那儿,然后我还能走这儿……”不同的是,计算机可以同时考虑所有可能!
该算法的妙处在于:在假设双方完美对弈的前提下,它总能找到最优着法。好比您手里有一个能看到游戏所有未来的“水晶球”!
本节我们将用纯 Python 打造一个由 Mini-max 算法驱动、无法被击败的井字棋 AI。我们会将实现拆分为简单步骤,并解释每一步背后的直觉及其在整体中的作用。
首先,我们定义一个类来承载与计算机对弈所需的全部逻辑与方法:
class TicTacToe:
   def __init__(self):
       # Initialize empty board (using ' ' for empty squares)
       self.board = [" " for _ in range(9)]
       self.human_player = "O"
       self.ai_player = "X"

   def print_board(self):
       """Print the current state of the board"""
       for i in range(0, 9, 3):
           print(f"{self.board[i]} | {self.board[i+1]} | {self.board[i+2]}")
           if i < 6:
               print("---------")

   def available_moves(self):
       """Returns list of available moves (indices of empty squares)"""
       return [i for i, spot in enumerate(self.board) if spot == " "]
上述 __init__ 方法将新棋盘初始化为包含 9 个空格(以空格 " " 表示)的列表,索引 0–8 分别表示从左到右、从上到下的棋位。并设置两位玩家的棋子符号——人类用 "O",AI 用 "X"。
print_board 方法用于可视化当前棋盘状态。它以 3×3 网格打印棋面,并在行间绘制分割线,显示各自的落子。
available_moves 方法返回所有仍可落子的有效位置索引。它通过检查棋盘中仍为空格(" ")的位置,并返回其索引。对于 Minimax 来说,这是判断可选着法的关键。
这些方法构成了我们后续用 Minimax 构建 AI 的基础。
我们快速测试一下:
>>> game = TicTacToe()
>>> game.print_board()
  |   |
---------
  |   |
---------
  |   |

>>> game.available_moves()
[0, 1, 2, 3, 4, 5, 6, 7, 8]
如预期,目前棋盘为空,所有位置均可落子。
现在,添加一个落子方法:
class TicTacToe:
   ...

   def make_move(self, position, player):
       """Make a move on the board"""
       if self.board[position] == " ":
           self.board[position] = player
           return True
       return False
我们添加了 make_move 方法,它:
我们做几步并查看剩余着法:
>>> game = TicTacToe()

>>> game.make_move(0, "X")
>>> game.make_move(1, "O")

>>> game.print_board()
 X | O |
-----------
   |   |
-----------
   |   |

>>> game.available_moves()
[2, 3, 4, 5, 6, 7, 8]
运行正常。下一步,添加一个方法检查棋盘是否已满:
class TicTacToe:
   ...

   def is_board_full(self):
       """Check if the board is full"""
       return " " not in self.board
is_board_full 是一个布尔方法,用于判断棋盘上是否还有空位。
接着,添加一个方法以判断是否达成胜利状态:
class TicTacToe:
   ...

   def check_winner(self):
       """Check if there's a winner. Returns winner symbol or None"""
       # Check rows
       for i in range(0, 9, 3):
           if self.board[i] == self.board[i + 1] == self.board[i + 2] != " ":
               return self.board[i]

       # Check columns
       for i in range(3):
           if self.board[i] == self.board[i + 3] == self.board[i + 6] != " ":
               return self.board[i]

       # Check diagonals
       if self.board[0] == self.board[4] == self.board[8] != " ":
           return self.board[0]
       if self.board[2] == self.board[4] == self.board[6] != " ":
           return self.board[2]

       return None
check_winner 方法评估当前井字棋棋面,判断是否有胜者。它会检查所有可能的制胜组合:
1. 行(3 种可能):
2. 列(3 种可能):
3. 斜线(2 种可能):
每种情况都会检查三个位置是否包含相同且非空的玩家符号(X 或 O)。若发现制胜组合,则返回胜者的符号;若全部检查后仍无胜者,则返回 None。
我们在胜利与非胜利状态下测试该函数:
game = TicTacToe()

# Winning state
game.make_move(0, "X")
game.make_move(1, "X")
game.make_move(2, "X")

>>> game.print_board()
 X | X | X
-----------
   |   |
-----------
   |   |

>>> game.check_winner()
'X'

game = TicTacToe()

# Non-winning state
game.make_move(0, "X")
game.make_move(1, "O")
game.make_move(2, "O")
game.make_move(3, "X")

>>> game.print_board()
 X | O | O
-----------
 X |   |
-----------
   |   |

>>> game.check_winner() is None
True
最后,我们再添加一个布尔方法,用于判断游戏是否结束:
class TicTacToe:
   ...

   def game_over(self):
       """Check if the game is over"""
       return self.check_winner() is not None or self.is_board_full()
若找到胜者或棋盘已满,该方法返回 True。
至此,我们已构建出所有核心博弈机制:
print_board() 以可视方式显示当前棋面available_moves() 返回空位索引make_move() 在棋盘上落子check_winner() 在每步后检查行、列与对角是否形成胜利is_board_full() 判断是否无子可下game_over() 综合胜者与满盘判断这些方法为可玩的游戏提供了所需基础,涵盖落子与棋面状态判定等基本操作。
接下来是关键部分——用 Minimax 赋予计算机“思考能力”。
现在,我们在一个新方法中实现该算法:
class TicTacToe:
   ...

   def minimax(self, depth, is_maximizing):
       """
       Minimax algorithm implementation
       Returns the best score possible for the current board state
       """
       # Base cases
       winner = self.check_winner()
       if winner == self.ai_player:
           return 1
       if winner == self.human_player:
           return -1
       if self.is_board_full():
           return 0
该函数接收两个参数:
depth —— 记录递归深度。它可用于在复杂游戏中限制搜索深度,但在井字棋中通常无需限制。is_maximizing —— 一个布尔标志,指示当前是在寻找最大分(AI 回合)还是最小分(人类回合)。随着每次递归(轮换行棋)而交替。在函数体中,我们先定义基本情形:若 AI 获胜(winner == ai_player),返回 1(AI 最优结局);若人类获胜(winner == human_player),返回 -1(AI 最差结局);若棋盘已满且无胜者,则返回 0(平局)。
def minimax(self, depth, is_maximizing):
   ...

   # if it is the maximizing player's turn (AI), we want to maximize the score
   if is_maximizing:
       best_score = float("-inf")
       for move in self.available_moves():
           # Make a calculating move
           self.board[move] = self.ai_player
           # Recursively call minimax with the next depth and the minimizing player
           score = self.minimax(depth + 1, False)
           # Reset the move
           self.board[move] = " "
           # Update the best score
           best_score = max(score, best_score)
       return best_score
当 is_maximizing 为 True 时,我们在模拟 AI 的回合,目标是找到能带来最高分的着法。我们先将 best_score 设为负无穷,以便任何实际分数都更优。随后对每个可行着法,我们:
is_maximizing=False,因为下一手是人类)max() 记录目前为止的最高分这样我们就能检查 AI 的每一种可能着法。对每一步,都一路推演直到胜负或平局,再自底向上回溯,确定哪一个首手能让 AI 获胜概率最大。
现在实现人类的最小化部分:
def minimax(self, depth, is_maximizing):
   ...

   # if it is the maximizing player's turn (AI), we want to maximize the score
   if is_maximizing:
       ...

   else:
       # if it is the minimizing player's turn (human), we want to minimize the score
       best_score = float("inf")
       for move in self.available_moves():
           # Make a calculating move
           self.board[move] = self.human_player
           # Recursively call minimax with the next depth and the maximizing player
           score = self.minimax(depth + 1, True)
           # Reset the move
           self.board[move] = " "
           # Update the best score
           best_score = min(score, best_score)
       return best_score
当 is_maximizing 为 False 时,我们在模拟人类回合,目标是得到尽可能低的分(因为高分意味着 AI 胜利)。我们将 best_score 设为正无穷,以便任何实际分数都更低。对每个可行着法,我们:
is_maximizing=True,因下一手是 AI)递归评估后续发展min() 记录目前为止的最低分这模拟了人类玩家为阻止 AI 获胜而做出的最佳选择。由于正分代表 AI 胜利,人类会努力最小化分数。通过在最大化与最小化间轮换,算法可推导双方的最优走法序列。
算法已就绪,我们再实现一个方法,调用 minimax 来在每次人类落子后为 AI 挑选最佳着法:
class TicTacToe:
   ...

   def get_best_move(self):
       """Find the best move for AI using minimax"""
       best_score = float("-inf")
       best_move = None

       for move in self.available_moves():
           # Make a calculating move
           self.board[move] = self.ai_player
           # Recursively call minimax with the next depth and the minimizing player
           score = self.minimax(0, False)
           # Reset the move
           self.board[move] = " "

           # Update the best score
           if score > best_score:
               best_score = score
               best_move = move

       return best_move
get_best_move 方法负责用 Minimax 为 AI 选出最优着法。其流程为:
1. 以负无穷为初始最佳分,且未选择着法
2. 对棋盘上的每个可行着法:
3. 最终返回带来最高分的着法
这种方式保证了在假设人类也最优对弈的前提下,AI 总能选择胜率最高的着法。该方法会考虑所有可能的未来棋面,选择既最大化 AI 胜算、又最小化人类胜算的路径。
我们在一个示例局面上测试一下:
game = TicTacToe()

# Make a couple of moves
game.make_move(0, "X")
game.make_move(1, "O")

# Print the board

>>> game.print_board()
X | O |
---------
  |   |
---------
  |   |

>>> game.get_best_move()
3

# AI moves
>>> game.make_move(3, "X")

# I move
>>> game.make_move(4, "O")
>>> game.print_board()
X | O |
---------
X | O |
---------
  |   |

# Get the best move for AI
>>> game.get_best_move()
6
如您所见,AI 根据我的走法找到了制胜组合(虽然是个演示局面,但足以证明算法有效)。
现在我们已经实现并测试了 Minimax,来创建一个允许与 AI 对弈的游戏循环。
class TicTacToe:

   ...

   def play_game(self):
       """Main game loop"""
       print("Welcome to Tic Tac Toe!")
       print("You are 'O' and the AI is 'X'")
       print("Enter positions (0-8) as shown below:")
       print("0 | 1 | 2")
       print("---------")
       print("3 | 4 | 5")
       print("---------")
       print("6 | 7 | 8")
       print("\n")
play_game 方法先向玩家显示欢迎与操作说明。它指出人类使用 ‘O’,AI 使用 ‘X’,并打印标号为 0–8 的网格,指示每个数字对应的棋盘位置,方便玩家输入想要落子的位置编号。
# ... the rest of the class
def play_game(self):
   ...

   # Randomly decide who goes first
   import random

   ai_turn = random.choice([True, False])

   while not self.game_over():
       self.print_board()

       if ai_turn:
           print("\nAI's turn...")
           move = self.get_best_move()
           self.make_move(move, self.ai_player)
       else:
           while True:
               try:
                   move = int(input("\nYour turn (0-8): "))
                   if 0 <= move <= 8 and self.make_move(move, self.human_player):
                       break
                   else:
                       print("Invalid move! Try again.")
               except ValueError:
                   print("Please enter a number between 0 and 8!")

       ai_turn = not ai_turn
显示完初始指引后,游戏进入主循环。通过 random.choice([True, False]) 随机决定先手是 AI 还是人类,这为每局开局带来公平与不确定性。
主循环持续到 game_over() 返回 True(有人胜出或棋盘已满)。每回合都会用 print_board() 显示当前棋面。
若轮到 AI(ai_turn 为 True),程序会:
get_best_move() 用 Minimax 选出最优着法若轮到人类(ai_turn 为 False),程序会:
1. 进入循环以获取有效输入2. 提示输入 0–8 的位置编号3. 验证输入是否:
4. 若不合法则持续询问;若合法,则在选定位置放置 ‘O’
每步结束后,用 not 翻转 ai_turn,交替轮到对方。如此往复,直至一方胜出或棋局和棋。
输入校验可防止非法输入导致游戏崩溃,并提供有用提示,带来更健壮、友好的游戏体验。
def play_game(self):
   ...
   # Game over
   self.print_board()
   winner = self.check_winner()
   if winner == self.ai_player:
       print("\nAI wins!")
   elif winner == self.human_player:
       print("\nCongratulations! You win!")
   else:
       print("\nIt's a tie!")
当游戏结束时,会用 print_board() 显示最终棋面,并通过 check_winner() 判定胜者。游戏可能出现三种结局:
check_winner() 返回 AI 的符号('X'),表明 AI 形成连线check_winner() 返回人类的符号('O'),表明玩家形成连线程序会显示相应信息宣布结果,向玩家清晰反馈对局如何结束。
现在,将以上代码整合为一个 Python 脚本,并在末尾添加如下 if/main 语句:
# Start the game
if __name__ == "__main__":
   game = TicTacToe()
   game.play_game()
这样,当您用 python script.py 运行脚本时,游戏会立即开始。若您在解释与代码块之间有些迷失,可以在这个 GitHub gist 中找到完整代码。
下面是我玩的一局示例:
❯ python tic-tac-toe.py
Welcome to Tic Tac Toe!
You are 'O' and the AI is 'X'
Enter positions (0-8) as shown below:
0 | 1 | 2
---------
3 | 4 | 5
---------
6 | 7 | 8


  |   |
---------
  |   |
---------
  |   |

Your turn (0-8): 4
  |   |
---------
  | O |
---------
  |   |

AI's turn...
X |   |
---------
  | O |
---------
  |   |

Your turn (0-8): 5
X |   |
----------
  | O | O
----------
  |   |

AI's turn...
X |   |
---------
X | O | O
---------
  |   |

Your turn (0-8): 6
X |   |
---------
X | O | O
---------
O |   |

AI's turn...
X |   | X
---------
X | O | O
---------
O |   |

Your turn (0-8): 1
X | O | X
---------
X | O | O
---------
O |   |

AI's turn...
X | O | X
---------
X | O | O
---------
O | X |

Your turn (0-8): 8
X | O | X
---------
X | O | O
---------
O | X | O

It's a tie!
请记住,井字棋属于简单游戏,您无法击败 AI。结局不是平局就是您输!
现在,让我们在井字棋之外,从更一般的角度回顾该算法的定义。
Minimax 可形式化为一个在零和博弈中评估局面的递归函数。下面分解其组成与性质。
对于某个博弈状态 s,其 Minimax 值 V(s) 定义为:
V(s) =
   utility(s)                    if s is terminal
   max(V(s')) for all s' in S    if player = MAX
   min(V(s')) for all s' in S    if player = MIN
其中:
1. 完全信息
2. 零和博弈
3. 最优对弈
时间复杂度:O(b^m)
空间复杂度:O(bm)
对非终局状态,评估函数 f(s) 应当:
形式化表达:
f(s) = w₁x₁ + w₂x₂ + ... + wₙxₙ
其中:
在以下条件下,Minimax 能保证最优对弈:
因此它特别适用于国际象棋、井字棋、西洋跳棋等满足这些条件的游戏。
Minimax 在井字棋等简单游戏中表现出色,但面对更大的游戏会遇到问题。我们来看看如何加速它,以及它的短板在哪里。
设想您在下棋思考招法:一旦发现了制胜之路,就没必要把所有其他可能性都逐一验证。Alpha-Beta 剪枝的作用正是如此——它帮助计算机跳过那些显然不可能更优的分支。
可以这样打比方:
在国际象棋这类大型游戏中,可能走法太多,无法全盘搜索,于是我们添加搜索深度限制:
您无法把全盘每步都规划到终点,但可以提前规划几步!
Minimax 并不完美,主要问题有:
1. 分支过多
2. 时间开销
3. 不适合不确定性游戏
当今的博弈 AI 往往将 Minimax 与其他技术结合:
1. 机器学习
AlphaGo 等就靠此战胜人类冠军2. 模式识别
3. 记忆库
更酷的是?这些改进让计算机在很多游戏中的表现几乎媲美甚至超越人类!但请记住——即便加入了如此多的“黑科技”,Minimax 仍是使这一切运转的地基。
在本教程中,我们从基础概念到实践编码全面探索了 Minimax 算法。要点包括:
1. 核心概念
2. 实战技能
3. 进阶主题
Minimax 只是 AI 拼图中的一块。如果您想继续深入 AI 与算法,下面这些资源值得一读:
1. 相关算法
2. 机器学习应用
3. 完整学习路径
请记住,无论是构建简单游戏还是复杂 AI 系统,理解 Minimax 等算法都能为您学习更高阶的人工智能主题奠定坚实基础。持续练习、不断学习,更要坚持编码!
热门 AI 课程
学习路径
课程
实践并学习路径你的进步。
使用 Google 继续