

लर्निंग पाथ
एआई मूलभूत बातें
10 घंटा
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखेंMini-Max एल्गोरिदम का AI में समृद्ध इतिहास है, जिसकी शुरुआत 1920 के दशक से होती है। उस समय कंप्यूटर एल्गोरिदम के लिए AI शब्द प्रचलित नहीं था, लेकिन इस बुनियादी एल्गोरिदम ने निश्चित रूप से इस बारे में शुरुआती अंतर्दृष्टि दी कि मशीनें प्रतिद्वंद्वी परिस्थितियों में कैसे सर्वोत्तम निर्णय ले सकती हैं। इस एल्गोरिदम को पहली बार John von Neumann ने 1928 के अपने पेपर “Zur Theorie der Gesellschaftsspiele” (On the Theory of Games of Strategy) में औपचारिक रूप दिया, जिसने आधुनिक गेम थ्योरी और निर्णय एल्गोरिदम की नींव रखी।
1997 में, IBM के Deep Blue ने Mini-max के उन्नत वैरिएंट्स का उपयोग करके विश्व शतरंज चैंपियन Garry Kasparov को हरा दिया। तब से, यह एल्गोरिदम Monte Carlo Tree Search (MCTS) और reinforcement learning जैसे अधिक परिष्कृत तरीकों की रीढ़ रहा है।
इस लेख में, हम शतरंज के लिए मशहूर Deep Blue नहीं बनाएंगे, बल्कि Python में tic-tac-toe के लिए एक बहुत सरल संस्करण बनाएंगे। इस दौरान, आप समझेंगे कि एल्गोरिदम कैसे काम करता है और इसे अधिक जटिल वास्तविक-जीवन के खेलों पर कैसे लागू किया जा सकता है।
Minimax आमतौर पर दो-खिलाड़ी खेलों (जैसे शतरंज, टिक-टैक-टो या चेकर्स) के लिए निर्णय लेने वाला एल्गोरिदम है। यह कंप्यूटरों को कई चालों की योजना बनाने देता है, यह मानते हुए कि आपका प्रतिद्वंद्वी हमेशा अपनी सर्वश्रेष्ठ संभव चाल चलेगा। इस खंड में, हम tic-tac-toe के उदाहरण से एल्गोरिदम का अवलोकन देखेंगे।
वास्तविक tic-tac-toe में, जब भी आपकी बारी आती है, आप सबसे अच्छी संभव चाल खेलने की कोशिश करते हैं और मानते हैं कि आपका प्रतिद्वंद्वी भी अपनी सबसे अच्छी चाल खेलेगा। Minimax एल्गोरिदम यही करता है — यह कंप्यूटर को आगे की सभी संभावित चालों के बारे में सोचकर सबसे अच्छी चाल चुनने में मदद करता है।
Minimax नाम इस तरह काम करने से आया है:
जब आपकी बारी हो, आप ऐसी चालें चलना चाहते हैं जो जीतने की सबसे अच्छी संभावना दें (maximizing)। जब आपके प्रतिद्वंद्वी की बारी हो, तो आप मानते हैं कि वे ऐसी चालें चलेंगे जो आपके लिए सबसे खराब नतीजा दें (minimizing)।
कृत्रिम बुद्धिमत्ता में Minimax कई कारणों से अत्यंत महत्वपूर्ण है:
सबसे अच्छी बात? यही विचार कई वास्तविक-जीवन अनुप्रयोगों में भी इस्तेमाल होता है:
हालांकि Minimax जटिल लग सकता है, वास्तव में यह बस कंप्यूटर को एक सतर्क खिलाड़ी की तरह सोचना सिखाता है, जो निर्णय लेने से पहले अपनी और प्रतिद्वंदी की चालों पर विचार करता है।
आइए एक सरल tic-tac-toe उदाहरण से समझें कि Minimax कैसे काम करता है। मान लें आप X खेल रहे हैं, और कंप्यूटर O है।
जब कंप्यूटर की बारी आती है, तो वह ये कदम अपनाता है:
कंप्यूटर एक सरल स्कोरिंग सिस्टम अपना सकता है:
इसे संभावनाओं के पेड़ की तरह समझें:
कंप्यूटर दो तरह की सोच के बीच अदला-बदली करता है:
1. Maximizing मोड (कंप्यूटर की बारी):
2. Minimizing मोड (खिलाड़ी की बारी):
मान लें इस खेल में कंप्यूटर (X) की बारी है:
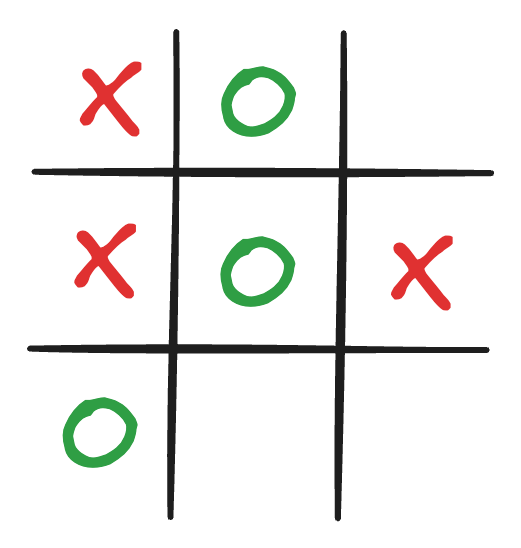
कंप्यूटर करेगा:
इस तरह आगे की सोच कंप्यूटर को हर बार tic-tac-toe बेहतरीन ढंग से खेलने में मदद करती है!
आइए चरण-दर-चरण देखें कि Minimax एल्गोरिदम कैसे लिखें। यदि आप स्यूडोकोड में नए हैं तो चिंता न करें — इसे असली कोड में बदलने से पहले सामान्य अंग्रेज़ी में चरण लिखने जैसा समझें!
Minimax फ़ंक्शन को काम करने के लिए तीन मुख्य चीजों की आवश्यकता होती है:
मूल स्यूडोकोड कुछ इस तरह दिखता है:
function minimax(board, depth, isMaximizingPlayer):
   # First, check if the game is over
   if game is won:
       return +10 if computer wins, -10 if human wins
   if game is tied:
       return 0

   # If it's the computer's turn (maximizing)
   if isMaximizingPlayer:
       bestScore = -infinity
       for each empty spot on board:
           make the move
           score = minimax(board, depth + 1, false)
           undo the move
           bestScore = max(score, bestScore)
       return bestScore

   # If it's the human's turn (minimizing)
   else:
       bestScore = +infinity
       for each empty spot on board:
           make the move
           score = minimax(board, depth + 1, true)
           undo the move
           bestScore = min(score, bestScore)
       return bestScore
अधिकांश स्यूडोकोड उदाहरण अंग्रेज़ी में पढ़े जाते हैं और आसानी से समझ आ जाते हैं, लेकिन ऊपर वाला उदाहरण अलग है क्योंकि यह recursion का उपयोग करता है। Recursion वह स्थिति है जब कोई फ़ंक्शन किसी बड़े समस्या को सुलझाने के लिए खुद को बार-बार कॉल करता है। इसे ऐसे समझें जैसे एक दर्पण के सामने दूसरा दर्पण हो — आपको वही छवि बार-बार, हर बार छोटी होती दिखती है।
हमारे Minimax एल्गोरिदम में recursion जरूरी है क्योंकि हम खेल में भविष्य की सभी संभावित चालों को देखना चाहते हैं। हर बार फ़ंक्शन खुद को कॉल करता है, वह अगली संभावित चाल को देख रहा होता है।
यह हमें हर संभव तरीके से खेल कैसे आगे बढ़ सकता है, यह जांचकर सर्वश्रेष्ठ चाल का पता लगाने में मदद करता है—जैसे कोई बहुत समझदार खिलाड़ी सोचे “यदि मैं यह करूं, तो वे वह करेंगे, फिर मैं यह कर सकता हूं…” और ऐसा तब तक चलता है जब तक खेल खत्म न हो जाए। Recursion के बारे में और जानने के लिए आप हमारा अलग recursion ट्यूटोरियल पढ़ सकते हैं।
देखते हैं यह एक साधारण खेल स्थिति में कैसे काम करता है:
1. शुरुआती स्थिति:
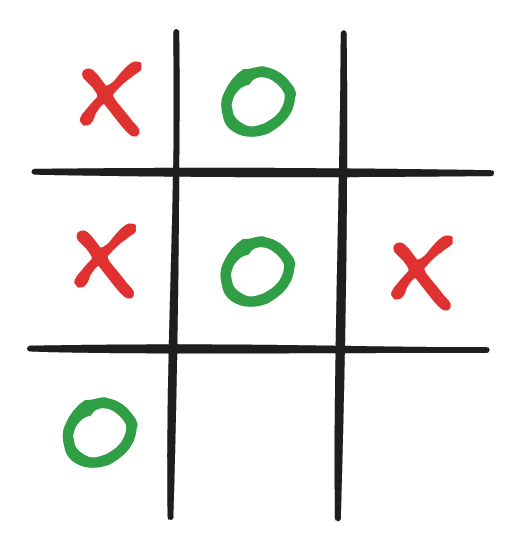
2. कंप्यूटर सोचता है:
3. हर खाली जगह के लिए, कंप्यूटर:
इसे शतरंज की तरह समझें — आप हमेशा सोचते हैं “यदि मैं यहां चलूं, तो वे वहां चलेंगे, फिर मैं यहां चल सकता हूं…” लेकिन कंप्यूटर एक साथ सभी संभावित चालों पर विचार कर सकता है!
इस एल्गोरिदम की अच्छी बात यह है कि यह हमेशा सर्वश्रेष्ठ चाल ढूंढ लेता है, यह मानते हुए कि दोनों खिलाड़ी पूर्णता के साथ खेलते हैं। यह मानो आपके पास ऐसा क्रिस्टल बॉल हो जो खेल के सभी संभावित भविष्य दिखाती हो!
इस खंड में, हम शुद्ध Python में Mini-max एल्गोरिदम द्वारा संचालित एक अजेय tic-tac-toe AI बनाएंगे। हम इम्प्लीमेंटेशन को सरल चरणों में तोड़ेंगे और प्रत्येक के पीछे की समझ और खेल की बड़ी तस्वीर में उसकी भूमिका समझाएंगे।
सबसे पहले, हम एक क्लास परिभाषित करते हैं जो वह सभी आवश्यक लॉजिक और मेथड्स रखती है जिनकी हमें अपने कंप्यूटर के साथ tic-tac-toe खेलने के लिए जरूरत है:
class TicTacToe:
   def __init__(self):
       # Initialize empty board (using ' ' for empty squares)
       self.board = [" " for _ in range(9)]
       self.human_player = "O"
       self.ai_player = "X"

   def print_board(self):
       """Print the current state of the board"""
       for i in range(0, 9, 3):
           print(f"{self.board[i]} | {self.board[i+1]} | {self.board[i+2]}")
           if i < 6:
               print("---------")

   def available_moves(self):
       """Returns list of available moves (indices of empty squares)"""
       return [i for i, spot in enumerate(self.board) if spot == " "]
ऊपर, __init__ मेथड 9 खाली स्थानों (" ") की सूची के रूप में नया गेम बोर्ड इनिशियलाइज़ करता है, जिसमें 0-8 इंडेक्स बाएं से दाएं, ऊपर से नीचे तक पोज़िशन दर्शाते हैं। यह दो खिलाड़ी प्रतीक भी सेट करता है—मानव के लिए "O" और AI के लिए "X"।
print_board मेथड वर्तमान बोर्ड स्थिति को विज़ुअलाइज़ करने का तरीका देता है। यह 3x3 ग्रिड को पंक्तियों के बीच विभाजक रेखाओं के साथ प्रिंट करता है, जिससे प्रत्येक खिलाड़ी की चालें उनकी पोज़िशन में दिखाई देती हैं।
available_moves मेथड सभी वैध चालों (जो अभी भी चल सकती हैं) की सूची लौटाता है। यह बोर्ड पर वे पोज़िशन जांचकर करता है जो अभी भी खाली हैं (" ") और उनके इंडेक्स लौटाता है। यह minimax एल्गोरिदम के लिए बेहद महत्वपूर्ण होगा ताकि उसे पता हो कि किन चालों पर विचार किया जा सकता है।
ये मेथड्स वह नींव बनाते हैं जिन पर हम minimax एल्गोरिदम का उपयोग करके अपना AI खिलाड़ी बनाएंगे।
आइए इन्हें जल्दी से परखते हैं:
>>> game = TicTacToe()
>>> game.print_board()
  |   |
---------
  |   |
---------
  |   |

>>> game.available_moves()
[0, 1, 2, 3, 4, 5, 6, 7, 8]
उम्मीद के मुताबिक, फिलहाल हमारे पास खाली बोर्ड है और सभी चालें उपलब्ध हैं।
अब, चाल चलने के लिए एक मेथड जोड़ते हैं:
class TicTacToe:
   ...

   def make_move(self, position, player):
       """Make a move on the board"""
       if self.board[position] == " ":
           self.board[position] = player
           return True
       return False
हमने make_move मेथड जोड़ा है, जो:
चलो कुछ चालें चलते हैं और बची हुई चालें देखते हैं:
>>> game = TicTacToe()

>>> game.make_move(0, "X")
>>> game.make_move(1, "O")

>>> game.print_board()
 X | O |
-----------
   |   |
-----------
   |   |

>>> game.available_moves()
[2, 3, 4, 5, 6, 7, 8]
अच्छा काम कर रहा है। अगला कदम यह जांचने का मेथड जोड़ना है कि बोर्ड भर गया है या नहीं:
class TicTacToe:
   ...

   def is_board_full(self):
       """Check if the board is full"""
       return " " not in self.board
is_board_full एक बूलियन मेथड है जो जांचता है कि बोर्ड पर कोई खाली जगह बची है या नहीं।
अब हम एक मेथड जोड़ते हैं जो जांचे कि कोई जीत की स्थिति बन गई है या नहीं:
class TicTacToe:
   ...

   def check_winner(self):
       """Check if there's a winner. Returns winner symbol or None"""
       # Check rows
       for i in range(0, 9, 3):
           if self.board[i] == self.board[i + 1] == self.board[i + 2] != " ":
               return self.board[i]

       # Check columns
       for i in range(3):
           if self.board[i] == self.board[i + 3] == self.board[i + 6] != " ":
               return self.board[i]

       # Check diagonals
       if self.board[0] == self.board[4] == self.board[8] != " ":
           return self.board[0]
       if self.board[2] == self.board[4] == self.board[6] != " ":
           return self.board[2]

       return None
check_winner मेथड वर्तमान Tic-tac-toe बोर्ड की स्थिति का मूल्यांकन करके तय करता है कि कोई विजेता है या नहीं। यह सभी संभावित विजयी संयोजनों की जांच करता है:
1. पंक्तियां (3 संभावनाएं):
2. कॉलम (3 संभावनाएं):
3. विकर्ण (2 संभावनाएं):
हर संयोजन के लिए, यह जांचता है कि तीनों पोज़िशन एक ही खिलाड़ी का प्रतीक (X या O) रखती हैं और खाली नहीं हैं। यदि कोई विजयी संयोजन मिलता है, तो यह विजेता खिलाड़ी का प्रतीक लौटाता है। यदि सभी संभावनाएं जांचने के बाद भी कोई विजेता नहीं मिलता, तो यह None लौटाता है।
चलो इस फ़ंक्शन को विजयी और गैर-विजयी स्थितियों पर परखते हैं:
game = TicTacToe()

# Winning state
game.make_move(0, "X")
game.make_move(1, "X")
game.make_move(2, "X")

>>> game.print_board()
 X | X | X
-----------
   |   |
-----------
   |   |

>>> game.check_winner()
'X'

game = TicTacToe()

# Non-winning state
game.make_move(0, "X")
game.make_move(1, "O")
game.make_move(2, "O")
game.make_move(3, "X")

>>> game.print_board()
 X | O | O
-----------
 X |   |
-----------
   |   |

>>> game.check_winner() is None
True
अंत में, हम एक और बूलियन मेथड जोड़ते हैं ताकि बताया जा सके कि खेल खत्म हुआ है या नहीं:
class TicTacToe:
   ...

   def game_over(self):
       """Check if the game is over"""
       return self.check_winner() is not None or self.is_board_full()
यदि विजेता मिल गया हो या बोर्ड भर गया हो, तो यह मेथड True लौटाता है।
इस बिंदु तक, हमने सभी मुख्य गेम मैकेनिक्स बना लिए हैं:
print_board() वर्तमान गेम स्थिति को दृश्य रूप से दिखाता हैavailable_moves() खाली खानों के इंडेक्स लौटाता हैmake_move() बोर्ड पर खिलाड़ी का प्रतीक रखता हैcheck_winner() हर चाल के बाद पंक्तियों, कॉलमों और विकर्णों में जीत की जांच करता हैis_board_full() तय करता है कि अब कोई चाल बाकी है या नहींgame_over() विजेता-जांच और भरे बोर्ड की जांच को मिलाता हैये मेथड्स खेल योग्य गेम बनाने के लिए आवश्यक नींव प्रदान करते हैं, जैसे चाल चलना और गेम स्थिति निर्धारित करना।
अब आता है अहम हिस्सा — कंप्यूटर को Minimax के साथ “दिमाग” देना।
अब, गेम के लिए एल्गोरिदम एक नए मेथड में लागू करते हैं:
class TicTacToe:
   ...

   def minimax(self, depth, is_maximizing):
       """
       Minimax algorithm implementation
       Returns the best score possible for the current board state
       """
       # Base cases
       winner = self.check_winner()
       if winner == self.ai_player:
           return 1
       if winner == self.human_player:
           return -1
       if self.is_board_full():
           return 0
यह फ़ंक्शन दो पैरामीटर लेता है:
depth - यह ट्रैक करता है कि हम recursion में कितने लेवल गहरे हैं। इसे बहुत जटिल खेलों में सर्च गहराई सीमित करने के लिए इस्तेमाल किया जा सकता है, हालांकि tic-tac-toe के लिए इसकी जरूरत नहीं।is_maximizing - एक बूलियन फ्लैग जो दर्शाता है कि क्या हम वर्तमान में अधिकतम स्कोर (AI की बारी) या न्यूनतम स्कोर (मानव की बारी) तलाश रहे हैं। खिलाड़ियों के बारी-बारी से चलने के साथ हर recursive कॉल में यह बदलता है।फ़ंक्शन बॉडी में, हम बेस केस परिभाषित करके शुरू करते हैं: यदि खेल AI जीत चुका है (winner == ai_player), तो हम 1 लौटाते हैं—AI के लिए सर्वश्रेष्ठ नतीजा। यदि मानव जीत चुका है (winner == human_player), तो -1 लौटाते हैं—AI के लिए सबसे खराब नतीजा। यदि बोर्ड बिना विजेता के भर गया है, तो हम 0 लौटाते हैं—ड्रा।
def minimax(self, depth, is_maximizing):
   ...

   # if it is the maximizing player's turn (AI), we want to maximize the score
   if is_maximizing:
       best_score = float("-inf")
       for move in self.available_moves():
           # Make a calculating move
           self.board[move] = self.ai_player
           # Recursively call minimax with the next depth and the minimizing player
           score = self.minimax(depth + 1, False)
           # Reset the move
           self.board[move] = " "
           # Update the best score
           best_score = max(score, best_score)
       return best_score
जब is_maximizing True होता है, हम AI की बारी का सिमुलेशन कर रहे होते हैं और ऐसी चाल ढूंढना चाहते हैं जो संभवतः सबसे अधिक स्कोर दे। हम best_score को निगेटिव इन्फिनिटी से शुरू करते हैं ताकि कोई भी वास्तविक स्कोर बेहतर हो। फिर हर उपलब्ध चाल के लिए, हम:
is_maximizing=False के साथ minimax को रिकर्सिव कॉल करते हैं (क्योंकि अगली बारी मानव की होगी)max() से ट्रैक करते हैंइससे हम AI की हर संभावित चाल की जांच कर पाते हैं। हर चाल के लिए, हम देखते हैं आगे क्या हो सकता है, जब तक कोई जीत या बराबरी न हो। फिर हम उल्टे क्रम में तय करते हैं कि कौन-सी पहली चाल AI को जीतने का सबसे अच्छा मौका देती है।
अब, मानव के लिए minimizing भाग करते हैं:
def minimax(self, depth, is_maximizing):
   ...

   # if it is the maximizing player's turn (AI), we want to maximize the score
   if is_maximizing:
       ...

   else:
       # if it is the minimizing player's turn (human), we want to minimize the score
       best_score = float("inf")
       for move in self.available_moves():
           # Make a calculating move
           self.board[move] = self.human_player
           # Recursively call minimax with the next depth and the maximizing player
           score = self.minimax(depth + 1, True)
           # Reset the move
           self.board[move] = " "
           # Update the best score
           best_score = min(score, best_score)
       return best_score
जब is_maximizing False होता है, हम मानव खिलाड़ी की बारी का सिमुलेशन कर रहे होते हैं और ऐसी चाल ढूंढना चाहते हैं जो सबसे कम स्कोर दे (क्योंकि उच्च स्कोर का मतलब AI की जीत है)। हम best_score को पॉजिटिव इन्फिनिटी से शुरू करते हैं ताकि कोई भी वास्तविक स्कोर कम हो। हर उपलब्ध चाल के लिए, हम:
is_maximizing=True के साथ कॉल कर आगे का आकलन करते हैं (क्योंकि अगली बारी AI की होगी)min() से ट्रैक करते हैंयह मानव खिलाड़ी द्वारा AI को जीतने से रोकने के लिए सर्वोत्तम चालें खेलने का सिमुलेशन करता है। मानव स्कोर को न्यूनतम करना चाहता है क्योंकि पॉजिटिव स्कोर AI की जीत को दर्शाते हैं। maximizing और minimizing बारीयों के बीच बारी-बारी से चलते हुए, एल्गोरिदम दोनों खिलाड़ियों के लिए इष्टतम चाल अनुक्रम तय कर सकता है।
अब जब एल्गोरिदम तैयार है, हमें एक और मेथड चाहिए जो हर मानव चाल के बाद minimax का उपयोग कर AI के लिए सर्वश्रेष्ठ चाल तय करे:
class TicTacToe:
   ...

   def get_best_move(self):
       """Find the best move for AI using minimax"""
       best_score = float("-inf")
       best_move = None

       for move in self.available_moves():
           # Make a calculating move
           self.board[move] = self.ai_player
           # Recursively call minimax with the next depth and the minimizing player
           score = self.minimax(0, False)
           # Reset the move
           self.board[move] = " "

           # Update the best score
           if score > best_score:
               best_score = score
               best_move = move

       return best_move
get_best_move मेथड minimax एल्गोरिदम का उपयोग करके AI खिलाड़ी के लिए इष्टतम चाल निर्धारित करने के लिए जिम्मेदार है। यह इस प्रकार काम करता है:
1. सर्वश्रेष्ठ स्कोर को निगेटिव इन्फिनिटी और सर्वश्रेष्ठ चाल को None से शुरू करना
2. बोर्ड पर हर उपलब्ध चाल के लिए:
3. अंत में वह चाल लौटाना जो सबसे अधिक स्कोर तक पहुंचाती है
यह तरीका सुनिश्चित करता है कि AI वह चाल चुनेगा जो उसे जीतने का सबसे अच्छा मौका देती है, यह मानते हुए कि मानव खिलाड़ी भी इष्टतम रूप से खेलता है। यह मेथड सभी संभावित भविष्य की गेम स्थितियों पर विचार करता है और उस रास्ते को चुनता है जो AI के अवसरों को अधिकतम और मानव के अवसरों को न्यूनतम करता है।
आइए इसे एक नमूना गेम स्थिति पर परखते हैं:
game = TicTacToe()

# Make a couple of moves
game.make_move(0, "X")
game.make_move(1, "O")

# Print the board

>>> game.print_board()
X | O |
---------
  |   |
---------
  |   |

>>> game.get_best_move()
3

# AI moves
>>> game.make_move(3, "X")

# I move
>>> game.make_move(4, "O")
>>> game.print_board()
X | O |
---------
X | O |
---------
  |   |

# Get the best move for AI
>>> game.get_best_move()
6
जैसा कि आप देख सकते हैं, AI ने मेरी चालों के आधार पर विजयी संयोजन ढूंढ लिया (यह एक डमी स्थिति थी, लेकिन इससे साबित होता है कि हमारा एल्गोरिदम काम कर रहा है)।
अब जब हमने अपना minimax एल्गोरिदम लागू और परखा लिया है, तो एक गेम लूप बनाते हैं जो हमें AI के विरुद्ध खेलने दे।
class TicTacToe:

   ...

   def play_game(self):
       """Main game loop"""
       print("Welcome to Tic Tac Toe!")
       print("You are 'O' and the AI is 'X'")
       print("Enter positions (0-8) as shown below:")
       print("0 | 1 | 2")
       print("---------")
       print("3 | 4 | 5")
       print("---------")
       print("6 | 7 | 8")
       print("\n")
play_game मेथड स्वागत संदेश और खिलाड़ी के लिए निर्देश दिखाकर शुरू होता है। यह दिखाता है कि मानव खिलाड़ी ‘O’ इस्तेमाल करता है और AI ‘X’। फिर यह क्रमांकित ग्रिड (0–8) प्रिंट करता है ताकि खिलाड़ी जान सके कि बोर्ड पर कौन-सा नंबर किस पोज़िशन से मेल खाता है। इससे खिलाड़ी के लिए अपनी इच्छित चाल का नंबर दर्ज करना आसान हो जाता है।
# ... the rest of the class
def play_game(self):
   ...

   # Randomly decide who goes first
   import random

   ai_turn = random.choice([True, False])

   while not self.game_over():
       self.print_board()

       if ai_turn:
           print("\nAI's turn...")
           move = self.get_best_move()
           self.make_move(move, self.ai_player)
       else:
           while True:
               try:
                   move = int(input("\nYour turn (0-8): "))
                   if 0 <= move <= 8 and self.make_move(move, self.human_player):
                       break
                   else:
                       print("Invalid move! Try again.")
               except ValueError:
                   print("Please enter a number between 0 and 8!")

       ai_turn = not ai_turn
प्रारंभिक निर्देश दिखाने के बाद, खेल अपने मुख्य लूप में प्रवेश करता है। खेल यादृच्छिक रूप से तय करता है कि पहले कौन चाल चलेगा—AI या मानव—random.choice([True, False]) का उपयोग करके। यह हर खेल की शुरुआत में निष्पक्षता और अप्रत्याशितता का तत्व जोड़ता है।
मुख्य गेम लूप तब तक चलता है जब तक game_over() True नहीं लौटा देता (या तो कोई जीत गया हो या बोर्ड भर गया हो)। हर बारी के दौरान, वर्तमान बोर्ड स्थिति print_board() से दिखाई जाती है।
यदि AI की बारी है (ai_turn True है), तो प्रोग्राम:
get_best_move() कॉल कर minimax एल्गोरिदम से इष्टतम चाल निर्धारित करता हैयदि मानव की बारी है (ai_turn False है), तो प्रोग्राम:
1. वैध इनपुट लेने के लिए लूप में प्रवेश करता है2. 0–8 के बीच एक चाल नंबर पूछता है3. इनपुट का सत्यापन करता है:
4. वैध इनपुट मिलने तक पूछता रहता है। फिर खिलाड़ी का प्रतीक (‘O’) चुनी गई पोज़िशन पर रखकर चाल चलाता है
हर बारी के बाद, ai_turn को not से पलट दिया जाता है ताकि खिलाड़ी बारी-बारी से चालें चलें। इससे खेल आगे-पीछे होता रहता है, जब तक कोई जीत न जाए या खेल बराबरी पर न छूटे।
इनपुट वैलिडेशन सुनिश्चित करता है कि गलत यूज़र इनपुट से गेम क्रैश न करे और सही चालें दर्ज करने के लिए सहायक त्रुटि संदेश दे। इससे एक मज़बूत और यूज़र-फ्रेंडली अनुभव बनता है।
def play_game(self):
   ...
   # Game over
   self.print_board()
   winner = self.check_winner()
   if winner == self.ai_player:
       print("\nAI wins!")
   elif winner == self.human_player:
       print("\nCongratulations! You win!")
   else:
       print("\nIt's a tie!")
जब खेल खत्म हो जाता है, अंतिम बोर्ड स्थिति print_board() से दिखाई जाती है और विजेता check_winner() से तय होता है। खेल तीन तरीकों से खत्म हो सकता है:
check_winner() AI का प्रतीक ('X') लौटाता है, यानी AI ने विजयी लाइन बना लीcheck_winner() मानव का प्रतीक ('O') लौटाता है, यानी खिलाड़ी ने विजयी लाइन बना लीउचित संदेश दिखाकर खेल का परिणाम बताया जाता है। इससे खिलाड़ी को स्पष्ट फीडबैक मिलता है कि खेल कैसे खत्म हुआ।
अब समय है कि अब तक लिखे गए सभी कोड को एक Python स्क्रिप्ट में रखें और सबसे अंत में निम्न if/main क्लॉज जोड़ दें:
# Start the game
if __name__ == "__main__":
   game = TicTacToe()
   game.play_game()
इससे स्क्रिप्ट को python script.py से चलाते ही खेल शुरू हो जाएगा। यदि आप व्याख्याओं और कोड ब्लॉक्स के बीच कहीं खो गए हों, तो आप गेम का पूरा कोड इस GitHub gist में पा सकते हैं।
यहां एक नमूना खेल है जो मैंने खेला:
❯ python tic-tac-toe.py
Welcome to Tic Tac Toe!
You are 'O' and the AI is 'X'
Enter positions (0-8) as shown below:
0 | 1 | 2
---------
3 | 4 | 5
---------
6 | 7 | 8


  |   |
---------
  |   |
---------
  |   |

Your turn (0-8): 4
  |   |
---------
  | O |
---------
  |   |

AI's turn...
X |   |
---------
  | O |
---------
  |   |

Your turn (0-8): 5
X |   |
----------
  | O | O
----------
  |   |

AI's turn...
X |   |
---------
X | O | O
---------
  |   |

Your turn (0-8): 6
X |   |
---------
X | O | O
---------
O |   |

AI's turn...
X |   | X
---------
X | O | O
---------
O |   |

Your turn (0-8): 1
X | O | X
---------
X | O | O
---------
O |   |

AI's turn...
X | O | X
---------
X | O | O
---------
O | X |

Your turn (0-8): 8
X | O | X
---------
X | O | O
---------
O | X | O

It's a tie!
याद रखें, चूंकि tic-tac-toe एक सरल खेल है, AI को हराने का कोई मौका नहीं—या तो बराबरी होगी या आप हारेंगे!
अब, साधारण tic-tac-toe उदाहरण से आगे बढ़कर एल्गोरिदम की सामान्य परिभाषा की समीक्षा करते हैं।
Minimax एल्गोरिदम को शून्य-योग वाले खेल में स्थितियों का मूल्यांकन करने वाले एक recursive फ़ंक्शन के रूप में औपचारिक रूप से परिभाषित किया जा सकता है। इसके औपचारिक अवयवों और गुणों को समझते हैं।
किसी गेम स्टेट s के लिए, minimax मान V(s) इस प्रकार परिभाषित है:
V(s) =
   utility(s)                    if s is terminal
   max(V(s')) for all s' in S    if player = MAX
   min(V(s')) for all s' in S    if player = MIN
जहां:
1. परिपूर्ण सूचना
2. शून्य-योग प्रकृति
3. इष्टतम खेल
समय जटिलता: O(b^m)
स्पेस जटिलता: O(bm)
गैर-टर्मिनल स्टेट्स के लिए, मूल्यांकन फ़ंक्शन f(s) को यह होना चाहिए:
औपचारिक परिभाषा:
f(s) = w₁x₁ + w₂x₂ + ... + wₙxₙ
जहां:
Minimax एल्गोरिदम इन शर्तों के तहत इष्टतम खेल की गारंटी देता है:
इसीलिए यह शतरंज, tic-tac-toe और चेकर्स जैसे खेलों के लिए विशेष रूप से उपयुक्त है, जहां ये शर्तें पूरी होती हैं।
हालांकि Minimax tic-tac-toe जैसे सरल खेलों के लिए बेहतरीन है, बड़े खेलों में इसकी कुछ समस्याएं हैं। देखते हैं इसे कैसे बेहतर बनाया जा सकता है और यह कहां संघर्ष करता है।
मान लें आप शतरंज खेल रहे हैं और अपनी चालों के बारे में सोच रहे हैं। यदि आपको एक विजयी चाल मिल जाती है, तो बाकी सभी संभावित चालों की जांच करने की ज़रूरत नहीं, सही? Alpha-Beta Pruning भी यही करता है — यह कंप्यूटर को उन चालों को छोड़ने में मदद करता है जिनसे बेहतर कुछ मिलना संभव नहीं।
इसे ऐसे समझें:
शतरंज जैसे बड़े खेलों में, संभावित चालें बहुत अधिक होती हैं, सबकी जांच करना संभव नहीं। इसलिए हम गहराई की सीमा जोड़ते हैं:
आप खेल के अंत तक हर चाल की योजना नहीं बना सकते, लेकिन कुछ चालें आगे तक ज़रूर बना सकते हैं!
Minimax परिपूर्ण नहीं है। इसकी मुख्य समस्याएं ये हैं:
1. बहुत अधिक विकल्प
2. समय की समस्या
3. अनिश्चित खेलों के लिए उपयुक्त नहीं
आज का गेम AI अक्सर Minimax को अन्य बेहतरीन तकनीकों के साथ जोड़ता है:
1. मशीन लर्निंग
AlphaGo जैसे खेलों ने इसका उपयोग मानव चैंपियंस को हराने में किया2. पैटर्न पहचान
3. मेमोरी बैंक
सबसे अच्छी बात? ये सुधार कंप्यूटरों को इंसानों जितना अच्छा—कभी-कभी उससे भी बेहतर—खेलने में मदद करते हैं! लेकिन याद रहे — इन सभी उन्नतियों के बावजूद, Minimax ही वह नींव है जो सबको संभव बनाती है।
इस ट्यूटोरियल में, हमने Minimax एल्गोरिदम को मूल अवधारणाओं से लेकर व्यावहारिक इम्प्लीमेंटेशन तक खोजा। हमने यह सीखा:
1. मुख्य अवधारणाएं
2. इम्प्लीमेंटेशन स्किल्स
3. उन्नत विषय
Minimax एल्गोरिदम AI पहेली का सिर्फ एक हिस्सा है। यदि आप AI और एल्गोरिदम के बारे में और सीखने को लेकर उत्साहित हैं, तो अपनी यात्रा जारी रखने के लिए ये संसाधन बेहतरीन हैं:
1. संबंधित एल्गोरिदम
2. मशीन लर्निंग अनुप्रयोग
3. संपूर्ण लर्निंग ट्रैक्स
याद रखें, चाहे आप एक सरल गेम बना रहे हों या जटिल AI सिस्टम, Minimax जैसे एल्गोरिदम को समझना कृत्रिम बुद्धिमत्ता के अधिक उन्नत विषयों के लिए मजबूत आधार देता है। अभ्यास जारी रखें, सीखते रहें, और सबसे महत्वपूर्ण—कोडिंग करते रहें!
शीर्ष AI कोर्स
लर्निंग पाथ
कोर्स
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें