课程
Python 入门
4 小时
7.1M
实践并学习路径你的进步。
使用 Google 继续Python 的导入系统设计得简单直观。在大多数情况下,您可以将代码组织在多个文件中,并通过直接使用 import 语句将它们组合在一起。
不过,当模块开始相互依赖时,您可能会遇到一个令人抓狂的问题:循环导入。这类错误常常出其不意地出现,并伴随诸如以下让人困惑的信息:
ImportError: cannot import name 'X' from 'Y' (most likely due to a circular import)在本文中,我们将探讨什么是循环导入、为何会发生以及如何用简单有效的策略来解决它们。我们还会介绍如何设计您的代码来彻底避免这类问题,从而让项目更健壮、可维护且易于理解。
所谓循环导入,是指两个或多个 Python 模块直接或间接地相互依赖。Python 尝试导入这些模块时会陷入循环,导致导入过程无法完成。
下面是一个涉及两个模块的简单示例:
# file: module_a.py
from module_b import func_b

def func_a():
    print("Function A")
    func_b()
# file: module_b.py
from module_a import func_a
def func_b():
print("Function B")
func_a()运行其中任意一个文件都会产生如下错误:
ImportError: cannot import name 'func_a' from 'module_a' (most likely due to a circular import)这是怎么回事?Python 先加载 module_a,其中导入了 module_b。而 module_b 又尝试再次导入 module_a,此时 func_a 还未定义。由于 Python 只会对每个模块进行一次初始化,它最终处理的是一个尚未完整加载的 module_a,因此导入失败。
为了更好地理解,可以将导入流程想象成这样:
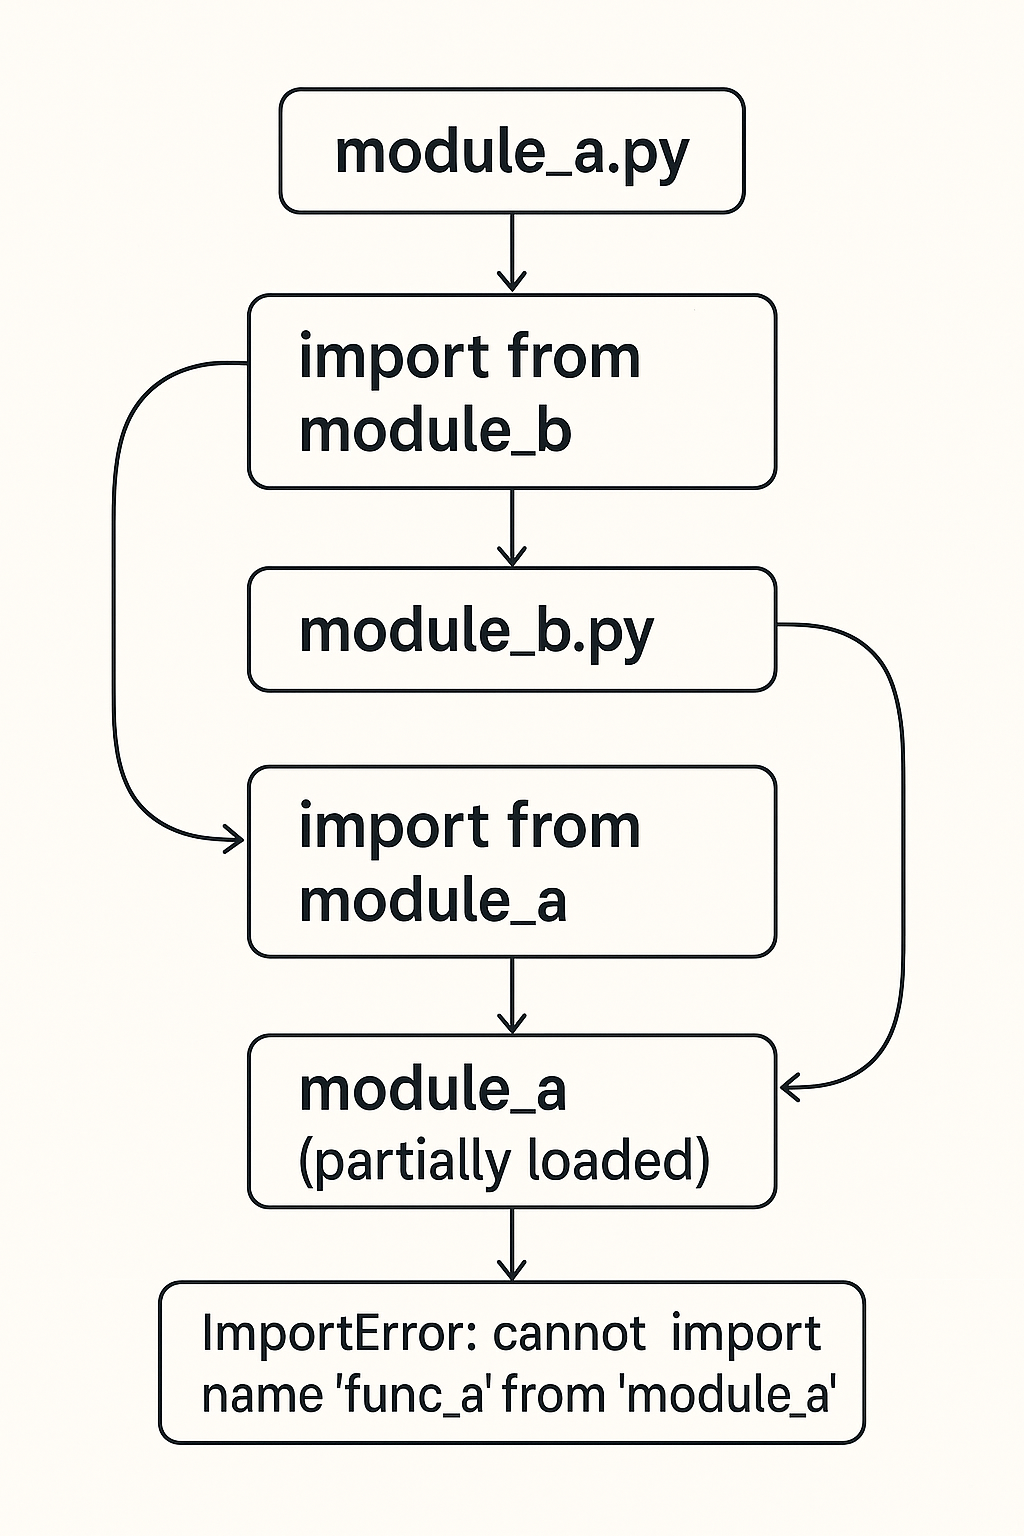 Python 中的循环导入流程。图片由作者提供。
这就形成了依赖环。由于 Python 不会重新加载正在导入过程中的模块,它会遇到缺失的定义并抛出错误。
以下是一些表明存在循环导入问题的常见信息:
ImportError: cannot import name 'X' from 'Y'
AttributeError: partially initialized module 'X' has no attribute 'Y'
这些错误尤其令人困惑,因为它们常常出现在调用栈的深处,而不是问题真正开始的那一行代码上。
循环导入通常并非有意为之,而是模块结构以及在模块间共享函数、类或常量的方式所导致的副作用。理解根本原因有助于您修复现有问题,并在代码库增长时避免制造新的问题。
一些设计模式和项目结构会无意间造成循环依赖。以下是最常见的几种场景:
两个模块相互导入以访问对方的功能。例如,utils.py 调用 core.py 中的函数,而 core.py 也从 utils.py 导入某些内容。两者都离不开对方而无法完全加载。
如果在顶层(即函数或方法之外)导入类或函数,它会在模块被导入时立即执行。如果该顶层导入引发了循环引用,就会出问题。
在面向对象设计中,一个类需要另一个类是很常见的。例如,一个 User 类使用 Profile 类,反之亦然。如果两者位于不同模块并在顶层导入,就会产生循环导入。
随着项目增长,跨模块的代码可能变得高度耦合。如果职责划分不清,很容易陷入相互依赖的导入乱麻中。
有时循环导入是由外部库引发的,尤其在使用带有插件或自动发现功能的框架时。它们可能间接触发导入,导致更难追踪的循环问题。
假设您正在构建一个基础的游戏引擎。您有两个模块:
physics.py 处理重力与碰撞逻辑。entities/post.py 定义玩家与敌人的类,并使用 physics.py 中的函数。代码可能如下所示:
# file: entities/post.py
from physics import apply_gravity  # Top-level import
class Player:
    def __init__(self, mass):
        self.mass = mass
    def update(self):
        apply_gravity(self)
# file: physics.py
from entities.post import Player # Top-level import creates circular dependency
def apply_gravity(entity):
if isinstance(entity, Player):
print(f"Applying gravity to player with mass {entity.mass}")现在,如果您尝试导入 Player 或运行游戏逻辑,将会得到以下错误:
Traceback (most recent call last):
  File "entities/post.py", line 1, in <module>
    from physics import apply_gravity
  File "physics.py", line 1, in <module>
    from entities.post import Player
ImportError: cannot import name 'Player' from 'entities.post' (most likely due to a circular import)
其背后的过程是:
entities/post.py 先被导入,并尝试从 physics.py 加载 apply_gravity()。
physics.py 开始加载,并尝试从 entities/post.py 导入 Player 类。
但此时 Player 尚未定义,Python 仍在处理 entities/post.py!
这就形成了一个循环:每个文件都在等待另一个先完成加载。Python 最终得到一个部分初始化的模块,并抛出 ImportError。
这类间接的循环依赖在将逻辑拆分到多个模块的大型项目中很常见。幸运的是,正如我们接下来将看到的,有多种方法可以解决和避免它。
循环导入不仅会导致导入错误,还可能以更隐蔽的方式影响您的代码。从令人困惑的错误信息到长期的架构问题,如果放任循环依赖不管,您可能会遇到以下情况。
循环导入最直接的影响是模块加载期间出现错误,通常有两种形式:
ImportError: cannot import name 'X' from 'Y':由于模块未完成加载,Python 尝试访问的名称尚未定义。
AttributeError: partially initialized module 'X' has no attribute 'Y':模块已被导入,但由于导入循环,您要使用的函数或类尚不存在。
这些错误令人沮丧,因为它们往往指向“症状”(例如缺失的函数),而非“病因”(循环导入)。
循环导入常常在代码库中形成看不见的依赖链。一个模块中的 bug 可能看起来源自另一个模块,从而让调试变得更加困难。您可能会把时间花在错误的文件上,却没意识到问题由更深层的循环引用引起。
这在大型应用中尤为棘手,因为一个文件顶部看似微小的导入就可能引发一连串问题。
循环导入通常意味着模块承担了过多职责或耦合过紧。当文件彼此以环状依赖时,就更难理解逻辑放在哪里以及代码各部分如何交互。
时间久了,这会让代码更难维护。新加入的团队成员(或者未来的您)在做任何更改之前,可能都要先花时间理清复杂的相互依赖。
在某些情况下,开发者尝试通过 importlib 或在函数内本地导入等方式进行动态或重复导入来“解决”循环导入。虽然可行,但也可能带来小幅的性能开销,因为在运行时会重复解析或延迟加载,尤其是在高频循环或大规模应用中。
更重要的是,循环导入往往预示着更深层次的设计问题,暗示代码缺乏清晰的关注点分离。过度相互依赖的模块更难测试、扩展与重构。换言之,循环导入不只是 bug,更是一种“代码异味”。
在下一节中,我们将通过本地导入、重构和动态加载等实用策略来修复循环导入。这些做法不仅能阻止错误,也能帮助您优化架构。为了概括循环导入的实际影响及其不只是“烦人”的原因,下面是它们造成的关键问题简要梳理:
|
问题 |
说明 |
|
ImportError / AttributeError |
Python 无法完成导入,因为模块只加载了一部分。这通常会产生晦涩的错误信息。 |
|
调试困难 |
错误常常出现在距离实际问题很远的地方,使根因分析变得棘手,尤其在大型代码库中。 |
|
可维护性差 |
循环依赖让代码更难重构或扩展。模块变得高度耦合且更难理解。 |
|
性能开销 |
诸如动态导入或延迟加载等变通方法可能引入小而不必要的运行时延迟。 |
|
架构异味 |
循环导入暗示关注点分离不足与项目结构不佳,令整个系统更脆弱。 |
识别这些症状是第一步。接下来,我们将探讨如何用同时改善功能与代码结构的策略来解决循环导入。
一旦在代码中识别出循环导入,值得庆幸的是,有多种有效方法可以解决它。下面我们逐一介绍最可靠的技巧。
循环导入往往源于模块做得太多或耦合过紧。最干净的修复方式之一是通过以下方式重新组织代码:
将共享功能移到第三个文件(如 common.py、utils.py 或 base.py)
如果两个模块在逻辑上属于同一单元,可将它们合并为一个。
来看一个抽取共享逻辑的示例:
# file: common.py
def apply_gravity(entity):
    print("Gravity applied to", entity)

# file: physics.py
from common import apply_gravity

# file: entities/post.py
from common import apply_gravity
通过将 apply_gravity() 移入 common.py,physics.py 与 entities/post.py 都能直接导入它,而无需彼此相互依赖。
不要在文件顶部导入,而是将导入语句放到真正用到它的函数或方法内部。这样会将导入推迟到函数被调用时,即所有模块都已加载之后。下面是方法内部延迟导入的示例:
# file: physics.py
def apply_gravity(entity):
    from entities.post import Player  # Local import
    if isinstance(entity, Player):
        print("Applying gravity")
当导入仅在特定情况下需要时,这种方式很有效。只要务必添加注释说明为何将导入放在此处即可。
使用 import module 会将名称解析推迟到运行时,从而避免过早查找而触发循环导入。下面的代码是会导致过早查找的直接导入示例:
from physics import apply_gravity # May cause a circular import更合适的方式是使用延迟的属性访问:
import physics
def update():
    physics.apply_gravity()
这种方法简单有效,尤其适用于您只是偶尔需要访问某个函数或类的情况。
在某些场景下,仅仅把导入语句放在文件底部(类/函数定义之后)就能解决问题。示例如下:
# file: module_a.py
def func_a():
    print("Function A")
from module_b import func_b  # Import after definitions
这仅在被导入的名称不需要在模块初始化期间使用时有效,请谨慎使用。
Python 内置的 importlib 模块允许以编程方式加载模块。这在可选插件或需要在运行时延迟导入的逻辑中尤其有用。
下面是使用 importlib.import_module 的示例
import importlib
def get_player_class():
    entities = importlib.import_module("entities.post")
    return entities.Player
这种方式完全避免顶层导入并保持依赖灵活。非常适合插件系统、扩展或动态路由逻辑。
面对多种可选策略,将它们对比会更有帮助。以下是一个速查表,帮助您为具体情境选择合适的修复方式:
|
修复方式 |
适用场景 |
作用机制 |
示例 |
|
重构模块 |
当两个模块依赖共享逻辑时 |
将共享代码移至中立位置,打破循环 |
抽取至 |
|
使用本地/延迟导入 |
当导入仅在函数或方法内部需要时 |
延迟到运行时导入,待所有模块加载完成后 |
|
|
使用 |
当只需访问少量函数或类时 |
推迟名称解析,避免过早访问 |
先 |
|
将导入移至底部 |
当导入的名称在初始化阶段不需要时 |
允许模块先完整定义自身再进行导入 |
将 |
|
使用 |
当处理可选模块、插件或运行时逻辑时 |
完全控制导入的时机与方式 |
|
修复循环导入固然重要,但从源头预防更为理想。一个组织良好、模块边界清晰的代码库更不易遭遇这类问题。
以下是一些在 Python 项目中避免循环导入的有效方法。
循环导入常源于项目结构不佳。通过在动手实现前先规划模块布局可避免此类问题。您可以先问自己:
使用自顶向下的方法或可视化工具,在编码前先勾勒模块如何交互。
诸如模型-视图-控制器(MVC)或分层架构等模式通过强制执行依赖层级,自然可防止循环导入。
这种自上而下的依赖流保持依赖关系清晰且单向。
尽量只导入模块对外公开的内容,而不是它的内部工具或类。例如,与其在另一个模块深处导入某个类,不如在该模块顶层暴露一个干净的 API。
# Good
from auth import authenticate_user  # Clean interface

# Risky
from auth.utils.token_handler import generate_token  # Fragile and tightly coupled
这种做法能让模块更易于重构,避免产生隐蔽的依赖。
相对导入(from .module import X)虽能让代码更简洁,但在层级很深的包中也可能加大循环引用的风险。
请谨慎使用,仅在确实提升可读性时才采用。在大型应用中,优先使用具有清晰模块路径的绝对导入。
如果两个模块依赖共享功能,考虑注入依赖而不是直接导入。示例如下:
# Instead of importing directly
def run_simulation():
    from physics import apply_gravity
    apply_gravity()

# Use dependency injection
def run_simulation(apply_gravity_fn):
    apply_gravity_fn()
这能让模块保持低耦合,同时也让单元测试更容易。
使用工具来检查并可视化模块之间的依赖关系:
pydeps:生成项目的依赖图。
snakeviz:可视化运行时剖析(若延迟导入影响性能时有用)。
pipdeptree:检查第三方包的依赖关系。
定期审视这些依赖图,有助于在问题爆发前捕捉循环导入。
最后,将导入结构纳入代码评审清单。尽早发现架构问题远比事后调试导入失败容易。快速查看导入树,能为未来省下大量排错时间。
循环导入是 Python 中最初看似神秘的陷阱之一,但一旦理解其背后的机制,诊断与修复就会容易得多。
归根结底,循环导入是模块结构与交互方式的副产物。它们往往出现在不断成长的项目中,当逻辑耦合过紧或跨文件的职责模糊时。但它们也提供了一个有益的信号——促使您退一步,重新评估架构,简化代码库。
如果您希望进一步提升 Python 技能,可查看 Writing Efficient Python Code,学习如何设计可维护的代码。您也可以通过我们的 Introduction to Python 课程夯实基础,或通过 Object-Oriented Programming in Python 深入模块化设计——这些都是很好的选择。