数据类型
第一步是了解数据集的构成。
您正在处理哪些变量?
通常可以将数据归入以下类别之一:
您将首先使用 pandas 的 from_csv 函数导入您可以在此代码库中找到的数据集。您还将把 beers 和 breweries 数据集合并,以便后续分析。
import pandas as pd

beers = pd.DataFrame.from_csv("https://raw.githubusercontent.com/nickhould/craft-beers-dataset/master/data/craftcans_beers.csv")
breweries = pd.DataFrame.from_csv("https://raw.githubusercontent.com/nickhould/craft-beers-dataset/master/data/craftcans_breweries.csv")

beers_and_breweries = pd.merge(beers,
                               breweries,
                               how='inner',
                               left_on="brewery_id",
                               right_on="id",
                               sort=True,
                               suffixes=('_beer', '_brewery'))技术支持
使用 pandas 库,您可以运行 dtypes 函数来列出每一列及其数据类型。
beers.dtypes技术支持
它会给出如下结果:
abv           float64
ibu           float64
id              int64
name           object
style          object
brewery_id      int64
ounces        float64
dtype: object技术支持
如上所示,该函数并不会对不同数据类型做出整洁的分组。各种数值数据类型(float64 和 int64)并未合并到我们期望的同一类别中。此外,某些列被标记为对象类型,这并不是很有帮助。
为此,您可以编写自己的函数,以确定 DataFrame 中每一列的类别。
def get_var_category(series):
    unique_count = series.nunique(dropna=False)
    total_count = len(series)
    if pd.api.types.is_numeric_dtype(series):
        return 'Numerical'
    elif pd.api.types.is_datetime64_dtype(series):
        return 'Date'
    elif unique_count==total_count:
        return 'Text (Unique)'
    else:
        return 'Categorical'

def print_categories(df):
    for column_name in df.columns:
        print(column_name, ": ", get_var_category(df[column_name]))技术支持
Beers 变量
print_categories(beers)技术支持
上述命令会返回如下结果:
abv :  Numerical
ibu :  Numerical
id :  Numerical
name :  Categorical
style :  Categorical
brewery_id :  Numerical
ounces :  Numerical技术支持
Breweries 变量
print_categories(breweries)技术支持
这将给出如下结果:
name :  Categorical
city :  Categorical
state :  Categorical
id :  Numerical技术支持
基于这些信息,您已能更好地理解数据集。您知道自己只在处理分类和数值数据。数值型变量可用于提取许多不同的度量,如均值、标准差等。分类型变量通常适合用于对数据进行分段和分组。例如,您可能希望了解不同啤酒风格之间的 IBU 有何差异。
描述性统计
本节将带您走过多种可用于更好理解数据的描述性统计。您会注意到,单独看每个度量并不太有用。将这些不同的度量结合起来,才能提取最大价值。
我们将聚焦于 IBU 变量,因为它是数值型变量。与分类型变量相比,这类变量可以计算的度量更广。您同样可以对分类型变量进行一些度量,但会受到更多限制。
长度
len 函数用于统计 Series 中观测值的数量。无论是否存在缺失或空值,该函数都会统计所有观测。
length = len(beers["ibu"])
print(length)技术支持
在这个 Series 中,我们共有 2410 条观测。
计数
count 函数将返回 Series 中非 NA/非空的观测数量。
count = beers["ibu"].count()
print(count)技术支持
如您所见,在该 Series 中有 1405 条非空观测。
缺失值
借助 Length 和 Count,我们现在可以计算缺失值的数量。缺失值的数量等于 Length 与 Count 之差。
number_of_missing_values = length - count
pct_of_missing_values = float(number_of_missing_values / length)
pct_of_missing_values = "{0:.1f}%".format(pct_of_missing_values*100)
print(pct_of_missing_values)技术支持
若要将缺失值输出为百分比,只需用缺失值数量除以观测总数(长度)。float 函数用于确保除法保留小数。format 函数用于将数字格式化为具有良好可读性的百分比。
在本例中,IBU 变量有将近 42% 的缺失。这一点很重要,因为它会影响您的分析。大多数描述性统计会忽略这些缺失值,这几乎肯定会带来偏差。
最小值/最大值
数据集的最小值和最大值可以通过对 Series 调用 min 和 max 函数轻松获得。
print("Minimum value: ", beers["ibu"].min())
print("Maximum value: ", beers["ibu"].max())技术支持
最小/最大值有助于理解变量的取值范围。在这里,IBU 的范围是 4 到 138。
众数
众数是数据集中出现频率最高的值。可以通过对 Series 使用 mode 函数获得。
print(beers["ibu"].mode())技术支持
在正态分布中,众数等于 mean 和 median。
在本例中,IBU 变量的众数是 20。它是数据集中最常见的 IBU 值。
均值
均值是一种集中趋势的度量。它表示各值之和除以非缺失观测的数量。
可以通过对 Series 使用 mean 函数获得。
mean = beers["ibu"].mean()技术支持
均值容易受到离群值影响。少数极端值就可能极大改变均值,将其上拉或下拉。
标准差
标准差是离散程度的度量。标准差越高,表示数据点分布在更宽的取值范围内。标准差与原始数值的单位相同。
standarddev = beers["ibu"].std()技术支持
在这里,标准差约为 26,精确值为 25.954065911259324。若 IBU 的分布为正态分布,您将知道约有 68% 的观测位于均值的一个标准差范围内。
分位数统计
分位数是将分布等分的切分点。许多分位数都有专门名称。如果将分布分成四等份,得到的分位数称为 quartile(四分位数)。您可以轻松地使用 Series 的 quantile 函数创建分位数。您可以向该函数传入一个数组,指定要计算的各分位数。在下面的例子中,我们希望将分布分为四等份。
quantile = beers["ibu"].quantile([.25, .5, .75])技术支持
| 0.25 | 21.0 |
| 0.50 | 35.0 |
| 0.75 | 64.0 |
| Name: ibu, | dtype: float64 |
如上所示,50% 分位数等于中位数。它将数据集一分为二。您还可以注意到,75% 的观测值小于或等于 64 个 IBU。此外,50% 的分布位于 21 到 64 个 IBU 之间。需注意,这些度量并未将缺失值纳入计算。
分布图
可视化在探索性数据分析中非常有用。本文不深入展开可视化主题。然而,谈到数据剖析,不得不提频数分布图的重要性。它是最简单却最强大的可视化之一,能够展现数据集中各取值的频率。
为创建该可视化,我们使用 seaborn`` 库与displot函数。该函数需要一个Series`,且不应包含缺失值。
import seaborn as sns
sns.set(color_codes=True)
sns.set_palette(sns.color_palette("muted"))

sns.distplot(beers["ibu"].dropna());技术支持
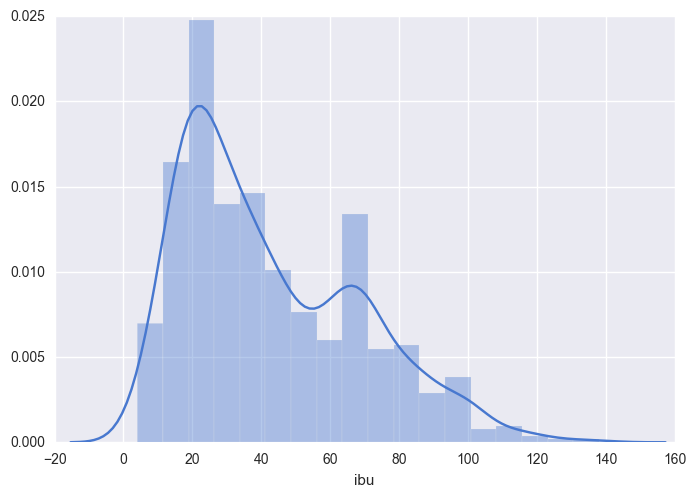
在该分布图中,您可以清晰看到我们先前计算的一些值。最小值接近 0 个 IBU,最大值接近 140 个 IBU。最频繁的值明显接近 20 个 IBU。此外,我们还能看到一个接近 60 个 IBU 的峰值。
为何该分布中会有两个峰?
是什么原因造成的?这是我们可以在探索性数据分析第二阶段继续挖掘的方面。
相关性
相关性是发现数值变量之间关系的好方法。计算相关性的方法有多种。皮尔逊相关系数是广泛使用的一种方法,用于衡量两个变量之间的线性依赖关系。相关系数范围从 -1 到 1。相关系数为 1 表示完全正相关,为 -1 表示完全负相关,为 0 表示不存在线性相关。我们可以在 Series 上使用 corr 函数进行该计算。默认情况下,该函数使用皮尔逊相关系数进行计算。也可以使用其他方法。
beers[["abv", "ibu", "ounces"]].corr()技术支持
| | abv | ibu | ounces |
| abv | 1 | 0.670621 | 0.172529 |
| ibu | 0.670621 | 1 | 0.054691 |
| ounces | 0.172529 | 0.054691 | 1 |
如上所示,IBU 与其自身的相关性为 1。显然,数值变量与自身完全相关。更有意思的是,您可以看到 ABV 与 IBU 的相关性为 0.670621。虽然这不是完全正相关,但相关程度仍然很高。这是我们可以在后续进一步探索的一个有趣点。
关于非数值变量的几点说明
前面提取的度量大多只适用于数值。若您处理的是诸如分类型等其他类型的数据,仍然可以收集一些有趣的度量。例如,可以计算数据集中各值的频率。
DataFrame 拥有一个名为 describe 的函数,可对数据集进行汇总。如果您的 DataFrame 仅包含分类型或文本值,汇总会针对该类型进行相应调整。
beers[["name", "style"]].describe()技术支持
| | name | style |
| count | 2410 | 2405 |
| unique | 2305 | 99 |
| top | Nonstop Hef Hop | American IPA |
| freq | 12 | 424 |


编者按:Jean-Nicholas Hould 是蒙特利尔英特尔安全部门的数据科学家,他在其博客上教授如何入门数据科学。
探索性数据分析(EDA)是一种旨在发现并概括数据集的统计方法。在数据科学流程的这个阶段,您需要探索数据集的结构、变量及其相互关系。
在本文中,您将聚焦于探索性数据分析的一个方面:数据剖析。
数据剖析旨在通过描述性统计来概括您的数据集。您需要借助大量度量来更好地理解数据集。数据类型、缺失值、均值、中位数和标准差只是剖析数据集时需要收集的诸多要素中的一部分。数据剖析的目标是让您对数据有扎实的理解,从而之后可以以多种方式开始查询和可视化数据。
了解您的数据来源
在进行任何 EDA 之前,您都应尽可能多地了解所分析数据的来源。您需要理解数据是如何收集的、如何处理的。数据上是否有可能影响您分析的既往转换?
您应能回答关于数据集的以下问题:
如果您不清楚数据从何而来,将很难从数据集中得出任何有意义的结论,也很容易犯下重大的分析错误。
此外,您还应确保数据集采用标准化的结构。推荐的格式是第三范式,也称为整洁数据。一个“整洁”的数据集具有以下属性:
遵循这种标准化格式将加快您的分析进程,因为它兼容许多工具和库。
数据剖析
在本文中,您将使用 CraftCans 网站的精酿啤酒数据集。该数据集仅包含来自美国酿酒厂的罐装啤酒的数据。从网站上并不清楚该数据集是否涵盖了美国所有的罐装啤酒。为稳妥起见,您应将该数据集视为可能包含偏差的样本。
以下是您将使用的数据集结构:
Beers:
ID:啤酒的唯一标识符。Name:啤酒名称。ABV:啤酒的酒精度(按体积)。IBU:啤酒的国际苦度单位。Style:啤酒风格。Ounces:啤酒盎司数。Breweries:
ID:酿酒厂的唯一标识符。Name:酿酒厂名称。City:酿酒厂所在城市。State:酿酒厂所在州。数据类型
第一步是了解数据集的构成。
您正在处理哪些变量?
通常可以将数据归入以下类别之一:
您将首先使用 pandas 的
from_csv函数导入您可以在此代码库中找到的数据集。您还将把beers和breweries数据集合并,以便后续分析。使用 pandas 库,您可以运行
dtypes函数来列出每一列及其数据类型。它会给出如下结果:
如上所示,该函数并不会对不同数据类型做出整洁的分组。各种数值数据类型(
float64和int64)并未合并到我们期望的同一类别中。此外,某些列被标记为对象类型,这并不是很有帮助。为此,您可以编写自己的函数,以确定
DataFrame中每一列的类别。Beers变量上述命令会返回如下结果:
Breweries变量这将给出如下结果:
基于这些信息,您已能更好地理解数据集。您知道自己只在处理分类和数值数据。数值型变量可用于提取许多不同的度量,如均值、标准差等。分类型变量通常适合用于对数据进行分段和分组。例如,您可能希望了解不同啤酒风格之间的
IBU有何差异。描述性统计
本节将带您走过多种可用于更好理解数据的描述性统计。您会注意到,单独看每个度量并不太有用。将这些不同的度量结合起来,才能提取最大价值。
我们将聚焦于
IBU变量,因为它是数值型变量。与分类型变量相比,这类变量可以计算的度量更广。您同样可以对分类型变量进行一些度量,但会受到更多限制。长度
len函数用于统计Series中观测值的数量。无论是否存在缺失或空值,该函数都会统计所有观测。在这个
Series中,我们共有 2410 条观测。计数
count函数将返回Series中非 NA/非空的观测数量。如您所见,在该
Series中有 1405 条非空观测。缺失值
借助
Length和Count,我们现在可以计算缺失值的数量。缺失值的数量等于Length与Count之差。若要将缺失值输出为百分比,只需用缺失值数量除以观测总数(长度)。
float函数用于确保除法保留小数。format函数用于将数字格式化为具有良好可读性的百分比。在本例中,
IBU变量有将近 42% 的缺失。这一点很重要,因为它会影响您的分析。大多数描述性统计会忽略这些缺失值,这几乎肯定会带来偏差。最小值/最大值
数据集的最小值和最大值可以通过对
Series调用min和max函数轻松获得。最小/最大值有助于理解变量的取值范围。在这里,
IBU的范围是 4 到 138。众数
众数是数据集中出现频率最高的值。可以通过对
Series使用mode函数获得。在正态分布中,众数等于
mean和median。在本例中,
IBU变量的众数是20。它是数据集中最常见的IBU值。均值
均值是一种集中趋势的度量。它表示各值之和除以非缺失观测的数量。
可以通过对
Series使用mean函数获得。均值容易受到离群值影响。少数极端值就可能极大改变均值,将其上拉或下拉。
中位数
中位数同样是集中趋势的度量。它是将数值按顺序排列后正好位于中间的位置。
对于偏态分布,中位数往往比均值更能代表集中趋势。
在
IBU的分布中,均值和中位数大致处于同一数量级。标准差
标准差是离散程度的度量。标准差越高,表示数据点分布在更宽的取值范围内。标准差与原始数值的单位相同。
在这里,标准差约为 26,精确值为 25.954065911259324。若
IBU的分布为正态分布,您将知道约有 68% 的观测位于均值的一个标准差范围内。分位数统计
分位数是将分布等分的切分点。许多分位数都有专门名称。如果将分布分成四等份,得到的分位数称为
quartile(四分位数)。您可以轻松地使用Series的quantile函数创建分位数。您可以向该函数传入一个数组,指定要计算的各分位数。在下面的例子中,我们希望将分布分为四等份。如上所示,50% 分位数等于中位数。它将数据集一分为二。您还可以注意到,75% 的观测值小于或等于 64 个
IBU。此外,50% 的分布位于 21 到 64 个IBU之间。需注意,这些度量并未将缺失值纳入计算。分布图
可视化在探索性数据分析中非常有用。本文不深入展开可视化主题。然而,谈到数据剖析,不得不提频数分布图的重要性。它是最简单却最强大的可视化之一,能够展现数据集中各取值的频率。
为创建该可视化,我们使用
seaborn`` 库与displot函数。该函数需要一个Series`,且不应包含缺失值。在该分布图中,您可以清晰看到我们先前计算的一些值。最小值接近 0 个
IBU,最大值接近 140 个IBU。最频繁的值明显接近 20 个IBU。此外,我们还能看到一个接近 60 个IBU的峰值。为何该分布中会有两个峰?
是什么原因造成的?这是我们可以在探索性数据分析第二阶段继续挖掘的方面。
相关性
相关性是发现数值变量之间关系的好方法。计算相关性的方法有多种。皮尔逊相关系数是广泛使用的一种方法,用于衡量两个变量之间的线性依赖关系。相关系数范围从 -1 到 1。相关系数为 1 表示完全正相关,为 -1 表示完全负相关,为 0 表示不存在线性相关。我们可以在
Series上使用corr函数进行该计算。默认情况下,该函数使用皮尔逊相关系数进行计算。也可以使用其他方法。如上所示,
IBU与其自身的相关性为 1。显然,数值变量与自身完全相关。更有意思的是,您可以看到ABV与IBU的相关性为0.670621。虽然这不是完全正相关,但相关程度仍然很高。这是我们可以在后续进一步探索的一个有趣点。关于非数值变量的几点说明
前面提取的度量大多只适用于数值。若您处理的是诸如分类型等其他类型的数据,仍然可以收集一些有趣的度量。例如,可以计算数据集中各值的频率。
DataFrame拥有一个名为describe的函数,可对数据集进行汇总。如果您的DataFrame仅包含分类型或文本值,汇总会针对该类型进行相应调整。剖析库
如您所见,收集描述性统计可能是个繁琐的过程。所幸已有一些库可以为您完成所有数据计算,并输出非常清晰的数据画像。
pandas-profiling就是其中之一。该库可即开即用地对您的数据集进行统计剖析。由于我们使用的数据集是整洁且标准化的,因此可以立即在数据集上使用该库。更多问题
通常,在您完成对数据集的剖析后,会产生比最初更多的问题。这很好,因为这些新问题将推动您的探索性数据分析。
以下是我们在进行此次剖析时收集的一些问题:
IBU有 41.7% 的取值缺失。为什么会这样?这将如何影响我们的分析?IBU的分布中有两个峰。是什么原因导致的?IBU与ABV之间的相关性如何解释?啤酒风格在这种相关性中有何影响?IBU、ABV或Style上是否存在差异?东海岸与西海岸又如何?数据剖析并非线性过程。随着您对数据集进行筛选与分段,您会反复回到这一过程,对数据的子集收集描述性统计。
后续步骤
在本文中,您了解了如何对数据集进行剖析。您现在知道如何将变量归入特定的数据类型组。您还对数据集计算了不同的描述性统计,并理解如何解读这些度量。最后,您看到了一些可帮助您完成剖析计算的库。更重要的是,您提出了比以往更多的问题,为您的探索性数据分析提供动力。
查看 DataCamp 的Python 探索性数据分析教程。