

Python 中的字符串切片
由于字符串是字符序列,您可以像处理 Python 列表或元组一样,通过切片和索引来访问它。字符串中的每个字符都有索引,且索引从 0 开始:
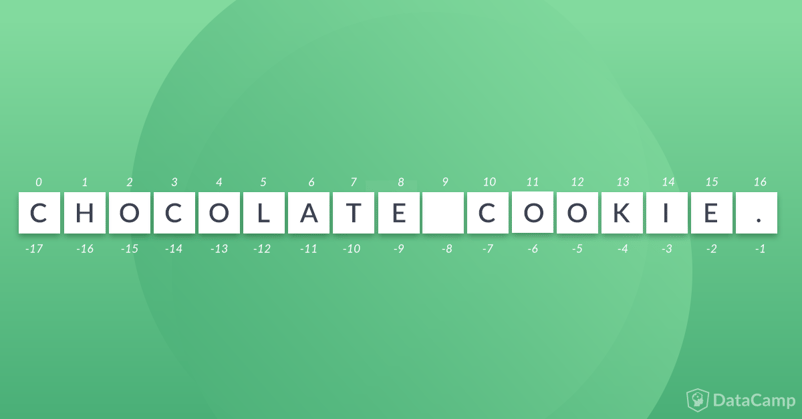
在上面的字符串中,第一个字符是 C,其索引为 0。最后一个字符是句号 .,它是字符串中的第 16 个字符。您也可以从反方向开始访问字符,起始于 -1,这意味着您也可以使用 -1 作为索引来访问字符串中的 .。在 Chocolate 和 cookie 之间还有一个空格,它同样是字符串的一部分,并有自己的索引,本例中为第 9 个。您可以通过切片来验证这一点。
由于 Python 字符串中的每个字符都有对应的索引编号,您可以像处理其他序列数据类型一样访问和操作字符串。切片是 Python 中的一种技术,允许您使用索引值从容器对象中选取特定元素或元素子集。切片可以避免您编写循环去遍历字符串索引以查找或访问某些子串。
snack = "Chocolate cookie."
print(snack[0])
print(snack[9])
print(snack[-1])
C
.
假设您想从下面的字符串中提取子串“cookie”。该如何做呢?
这种情况下,您可以使用区间切片。
区间切片的语法如下:[起始索引(包含): 结束索引(不包含)]
snack = "Chocolate cookie."
print(snack[10:16])
cookie
您也可以对结束索引使用负值来实现相同效果:
print(snack[10:-1]) # -1:由于切片中的结束索引不包含在内。
cookie
在切片时不提供结束索引,意味着从起始索引一直截取到句子的最后一个索引。同样地,省略起始索引则表示从字符串的第一个索引一直到结束索引:
# 未提供结束值
print(snack[0:])
# 未提供开始值(根据语法,结束值不包含)
print(snack[:-1])
# 这也是允许的
print(snack[:])
Chocolate cookie.
Chocolate cookie
Chocolate cookie.
字符串切片还可以接受第三个参数 stride(步长),表示从字符串取出第一个字符后,每次向前移动多少个字符。stride 的默认值为 1。
让我们通过示例来理解 stride:
number_string = "1020304050"
print(number_string[0:-1:2])
12345
提示:使用步长可以做一件很酷的事——反转字符串:
print(number_string[::-1]) #
0504030201
将步长设置为 -1 表示从最后一个字符开始,然后每次向后移动一个字符。
另外,如果将值设为 -2,则从最后一个字符开始,每次向后移动两个字符:
print(number_string[::-2]) #
00000
常见的字符串操作
切片、区间切片是您对字符串最常用的操作。还有字符串拼接,它就像加法一样简单:
string1 = 'Chocolate'
string2 = 'cookie'
snack = string1 + " " + string2
print(snack)
Chocolate cookie
不过,如果您尝试将字符串与其他数据类型拼接,这样做将不起作用。
cost = 15
string1 = "The total in Euro is: "
bill = string1 + cost
print(bill)
---------------------------------------------------------------------------
TypeError Traceback (most recent call last)
<ipython-input-218-7d5c5248b927> in <module>()
2 string1 = "The total in Euro is: "
3
----> 4 bill = string1 + cost
5 print(bill)
TypeError: Can't convert 'int' object to str implicitly
这里,您尝试将字符串与整数拼接,这是不允许的。解释器无法隐式判断您是要进行整数加法还是字符串拼接。不过,试试下面这样:
bill = string1 + str(cost)
print(bill)
The total in Euro is: 15
这是因为您显式地将整数转换为了字符串,然后再进行拼接。想了解更多数据类型转换,请查看这篇教程。
要重复一个字符串,请使用 * 运算符。
single_word = 'hip '
line1 = single_word * 2 + 'hurray! '
print(line1 * 3)
hip hip hurray! hip hip hurray! hip hip hurray!
您还可以使用 in 和 not in 来检查字符串中的成员关系:
sub_string1 = 'ice'
sub_string2 = 'glue'
string1 = 'ice cream'
if sub_string in string1:
print("There is " + sub_string + " in " + string1)
if sub_string2 not in string1:
print("Phew! No " + sub_string2 + " in " + string1)
There is ice in ice cream
Phew! No glue in ice cream
Python 提供了许多内置方法(或辅助函数)来操作字符串。替换子串、将段落中的特定单词大写、查找一个字符串在另一个字符串中的位置,都可以通过这些内置方法完成。
来看几个常用方法的细节:
str.capitalize():返回将首字母大写后的字符串副本。
str.capitalize('cookie')
'Cookie'
str.islower():如果字符串中所有字母都是小写则返回 true,否则返回 false。
snack = 'cookie'
snack.islower()
True
str.find(substring):返回子串在字符串中出现的最低索引。您也可以指定要搜索的起始与结束索引。如果未找到子串,则返回 -1。
str1 = 'I got you a cookie'
str2 = 'cook'
str1.find(str2)
12
str.count(substring):统计子串在字符串中出现的次数。也可指定字符串的起始与结束索引。
str1 = 'I got you a cookie, do you like cookies?'
str2 = 'cookie'
str1.count(str2)
2
str.isspace():如果字符串中仅包含空白字符则返回True,否则返回 false。空白字符包括空格、制表符、换行等。
在处理真实世界的数据集时,这会很有用,因为数据在格式转换时不一定总能正确编码空白。
str_space = ' '
str_space.isspace()
True
str_tab = '\t'
str_tab.isspace()
True
str_nextline = '''\n'''
str_nextline.isspace()
True
注意:您是否注意到了上面的 \t、\n?它们被称为转义字符,以 \(反斜杠)开头。在内部,它们不会被解释为普通字符串,而是作为表示其他含义的特殊字符。例如,\t 表示制表符。还有更多转义字符,您可以在我们的 Python 正则表达式教程中了解更多。
str.lstrip():移除字符串开头的所有空白。当处理真实世界的数据集时,这个函数同样很实用。
str1 = " I can't hear you. Are you alright? "
str2 = " Yes, all is good."
str3 = str1.lstrip() + str2.lstrip()
print(str3)
I can't hear you. Are you alright? Yes, all is good.
str.isdigit():如果字符串只包含数字则返回True,否则返回False。
number_string = "1020304050"
number_string.isdigit()
True
str.replace(substring, new):将字符串中所有出现的子串替换为新值。您还可以定义第三个参数max,最多替换max次。注意这不是原地替换,不可变特性仍然成立,实际会形成一个新字符串。
string1 = 'hip hip hurray! hip hip hurray! hip hip hurray!'
string2 = string1.replace('hip', 'Hip')
print(string1)
print(string2)
hip hip hurray! hip hip hurray! hip hip hurray!
Hip Hip hurray! Hip Hip hurray! Hip Hip hurray!
string1.replace('hip', 'Hip', 2)
'Hip Hip hurray! hip hip hurray! hip hip hurray!'
str.split(delimiter=""):根据分隔符(未提供则为空格)拆分字符串,并返回子串列表。
dessert = 'Cake, Cookie, Icecream'
list_dessert = string1.split(',')
您可以在 此处找到 Python 字符串方法的完整列表。
字符串格式化
Python 支持多种字符串格式化方式。在本节中,您将进一步了解这些格式化方法!
% 格式化
取模运算符 % 是 Python 的内置运算,被称为插值运算符。您需要在 % 后提供需要格式化或转换的数据类型。然后 % 运算会将 "%datatype" 片段替换为一个或多个指定数据类型的元素:
print("I bought %d Euro worth of %s!" %(200, 'cookies'))
I bought 200 Euro worth of cookies!
上例中,%d 用于整数,%s 用于字符串。其他可用的转换类型还有:o(八进制)、x(十六进制)、f(浮点小数格式)、c(单个字符,接受整数或单字符字符串)。
Formatter 类
formatter 类是内置字符串类之一。它通过 format() 方法提供复杂的变量替换与数值格式化能力。您可以通过重写其公有方法 format()、vformat() 来创建并自定义自己的字符串格式化行为。它还有一些供子类重写的方法:parse()、get_field()、get_value()、check_unused_args()、format_field() 和 convert_field()。不过,为了简明起见,您将只查看最常用的 format() 函数的用法……
print("I bought {0} Euro worth of {1}!".format(200,'cookies')) #按位置访问值
I bought 200 Euro worth of cookies!
print("I bought {total} Euro worth of {item}!".format(total = 200, item = 'cookies')) #按名称访问值
I bought 200 Euro worth of cookies!
'{:#<10}'.format('Cake') #将单词 'Cake' 左对齐,空位用 '#' 填充
'Cake######'
'{:#^10}'.format('Cake') #将单词 'Cake' 居中对齐,空位用 '#' 填充
'###Cake###'
'{:#>10}'.format('Cake') #将单词 'Cake' 右对齐,空位用 '#' 填充
'######Cake'
for num in range(1,10):
print('{0:{width}}'.format(num, width=5), end=' ')
1 2 3 4 5 6 7 8 9
模板字符串
与常见的基于 % 的替换不同,模板支持基于 $ 的替换。Python 2.4 引入模板的原因在于,尽管 % 字符串格式化功能强大而丰富,但它容易出错,并且对紧随 '%' 的格式要求较为严格,增加了复杂度。使用 % 格式化的一个常见错误是忘记结尾的格式字符,例如:%(variabl)e 中的 e。
模板定义了两个方法:substitute() 与 safe_substitute()。如下所示:
from string import Template #First you will need to import 'Tempalte' class
money = dict(who = 'You', to_whom = 'baker')
Template('$who owe the $to_whom a total of $$100').substitute(money)
'You owe the baker a total of $100'
注意上例中的 $$ 吗?
这是因为在模板中 $$ 是转义字符,会被替换成单个 $。这是模板的一条规则。另一个规则是如何在模板中定义标识符,通常的语法是:$identifier,也可以使用 ${identifier}。
这意味着 ${identifier} 与 $identifier 等价,但可用于如下场景:
word = dict(noun = 'feed')
Template('Please don\'t stop ${noun}ing me').substitute(word)
"Please don't stop feeding me"
来看 substitute() 与 safe_substitute() 的用法。
fact = Template('$alter_ego is weak but wait till he transforms to $superhero!')
fact.substitute(alter_ego='Bruce Banner', superhero='Hulk')
'Bruce Banner is weak but wait till he transforms to Hulk!'
hero = dict(alter_ego='Peter Parker')
fact.substitute(hero)
---------------------------------------------------------------------------
KeyError Traceback (most recent call last)
<ipython-input-244-c82f6a2ebc02> in <module>()
1 hero = dict(alter_ego='Peter Parker')
----> 2 fact.substitute(hero)
~/anaconda3/envs/tensorflow/lib/python3.5/string.py in substitute(*args, **kws)
127 raise ValueError('Unrecognized named group in pattern',
128 self.pattern)
--> 129 return self.pattern.sub(convert, self.template)
130
131 def safe_substitute(*args, **kws):
~/anaconda3/envs/tensorflow/lib/python3.5/string.py in convert(mo)
117 named = mo.group('named') or mo.group('braced')
118 if named is not None:
--> 119 val = mapping[named]
120 # We use this idiom instead of str() because the latter will
121 # fail if val is a Unicode containing non-ASCII characters.
KeyError: 'superhero'
上述示例抛出错误,是因为未定义 superhero。不过,试试这个……
fact.safe_substitute(hero)
'Peter Parker is weak but wait till he transforms to $superhero!'
safe_substitute() 是使用模板的一大优势。
您可能会问:为什么有这么多字符串格式化选项?
主要还是语法偏好的问题。这通常是在简洁与冗长之间做权衡,也取决于您对既有语法的熟悉程度。例如,来自 C 语言背景的人会觉得使用 % 进行字符串格式化更自然。Python 的模板语法更易写,而 format() 虽然更冗长,但功能更丰富。
格式化字符串字面量(f-string)
这是在 Python 3.6 中新增的另一种字符串格式化方法。格式化字符串字面量(f-string)是以字母 'f' 或 'F' 为前缀的字符串。您可以在花括号 { } 中定义要在字符串中使用的标识符。
为什么又需要一种新的字符串格式化方式?因为实用且简单之美,正因此!
看看下面的示例,您会明白为什么在 Python 中 f-string 的确是最简单、最实用的格式化方式。
alter_ego = 'Peter Parker'
superhero = 'spiderman'
f'{alter_ego} is weak but wait till he transforms to {superhero}!'
注意:上述代码仅适用于 Python 3.6 及以上版本。要检查您安装的 Python 版本,请在终端输入:python -V。或者,您也可以在 Python 中使用 sys 模块,如下所示:
import sys
sys.version
格式化字符串在运行时进行求值,这意味着您可以在 f-string 的花括号中使用任意 Python 表达式,这是使用 f-string 的另一大优势。
f'{alter_ego} is weak but wait till he transforms to {superhero.capitalize()}!'
f-string 已经很棒了!但更棒的是……与前面三种方法相比,f-string 也更快。这是因为它们会被预解析并以高效的字节码形式存储,从而加速执行。
拨动正确的“弦”!
恭喜您读到本教程的最后!您已经了解了什么是字符串,学习了字符串切片,并见识了可对字符串执行的一些操作。您还学习了多种字符串格式化的方法。但请记住,掌握任何技巧的关键在于实践!
字符串是 Python 中多种数据类型之一。想进一步了解列表、字典、元组和集合,请查看 DataCamp 的 Data Types for Data Science 课程。在这门课程中,您可以运用对数据类型的理解完成练习。您将使用芝加哥都会区的公共交通数据来进行数据科学实践。快去亲自体验一下吧……
字符串是由字母、单词或其他字符组成的集合。它是一种原生数据结构,是数据处理的基础。Python 内置了名为
str的字符串类。Python 字符串是“不可变”的,这意味着一旦创建便不能更改。进行字符串操作时,我们会创建新的字符串来表示计算得到的值,这正是由于其不可变的特性。在本教程中,您将深入了解字符串,并将涵盖以下主题:
Formatter类如果您想进一步学习 Python 中的数据结构,务必查看 DataCamp 的两部分课程:Python Data Science Toolbox。该课程会更深入讲解函数、迭代器、列表等内容。
字符串
您可以使用
str对象在 Python 中处理文本数据。字符串是由 Unicode 组成的不可变序列。Unicode 是用于表示各国语言中所有字符的系统。在 Unicode 中,每个字母、字符都以一个 4 字节的数字表示,每个数字对应一个唯一字符。要表示一个字符串,您需要用引号将其括起来。可以有多种方式:
三引号字符串允许您编写多行字符串,并且所有相关的空白都会包含在字符串中。
字符串是不可变的,这意味着如果您尝试更改字符串中的任何值,将会抛出错误。要引入更改,您必须创建一个新的字符串。
您可以使用内置函数
len()来获取字符串的长度: