

Python में स्ट्रिंग स्लाइसिंग
क्योंकि स्ट्रिंग्स वर्णों की एक सीक्वेंस हैं, आप उन्हें Python लिस्ट्स या ट्यूपल्स की तरह ही स्लाइसिंग और इंडेक्सिंग के ज़रिए एक्सेस कर सकते हैं। स्ट्रिंग्स में हर वर्ण के संदर्भ में इंडेक्सिंग होती है और इंडेक्सिंग 0 से शुरू होती है:
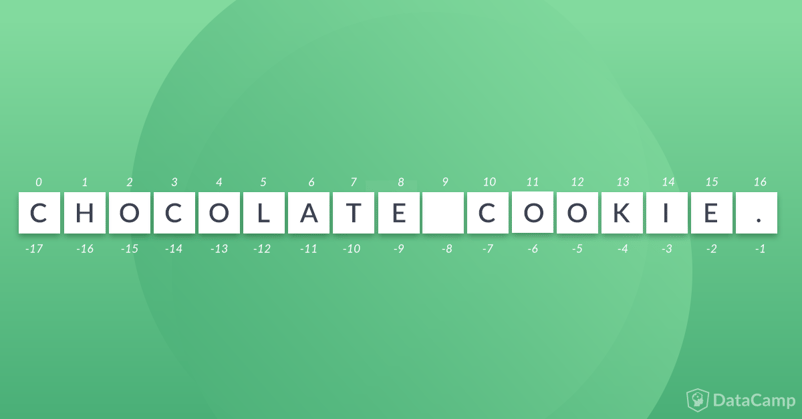
ऊपर दी गई स्ट्रिंग में, पहला इंडेक्स C है और उसका इंडेक्स 0 है। आखिरी वर्ण फुल-स्टॉप . है जो स्ट्रिंग का 16वां वर्ण है। आप विपरीत दिशा में भी -1 से शुरू करके वर्णों तक पहुँच सकते हैं, यानी आप . तक पहुँचने के लिए इंडेक्स मान -1 भी उपयोग कर सकते हैं। Chocolate और cookie के बीच में एक whitespace भी है, यह भी स्ट्रिंग का हिस्सा है और इसका अपना इंडेक्स है, इस मामले में 9वां। आप इसे स्लाइसिंग से जाँच सकते हैं।
क्योंकि Python स्ट्रिंग के हर वर्ण का एक संबंधित इंडेक्स नंबर होता है, आप अन्य अनुक्रमिक डाटा प्रकारों की तरह ही स्ट्रिंग्स को एक्सेस और मैनिपुलेट कर सकते हैं। स्लाइसिंग Python में एक तकनीक है जो आपको कंटेनर ऑब्जेक्ट से उनके इंडेक्स मानों का उपयोग कर किसी विशिष्ट एलिमेंट या एलिमेंट्स के उप-समुच्चय को चुनने देती है। स्लाइसिंग आपको अपनी स्ट्रिंग के इंडेक्सों पर जाने के लिए लूप लिखने से बचाती है ताकि कुछ सबस्ट्रिंग्स को खोजा या एक्सेस किया जा सके।
snack = "Chocolate cookie."
print(snack[0])
print(snack[9])
print(snack[-1])
C
.
मान लीजिए आप नीचे दी गई स्ट्रिंग से 'cookie' सबस्ट्रिंग निकालना चाहते हैं। आप यह कैसे करेंगे?
ऐसे मामलों में, आप रेंज स्लाइसिंग का उपयोग करते हैं।
रेंज स्लाइसिंग का सिंटैक्स इस प्रकार है: [Start index (included): Stop index (excluded)]
snack = "Chocolate cookie."
print(snack[10:16])
cookie
आप यह स्टॉप इंडेक्स के लिए निगेटिव मान का उपयोग करके भी कर सकते हैं:
print(snack[10:-1]) # -1: क्योंकि स्लाइसिंग में स्टॉप इंडेक्स एक्सक्लूडेड होता है।
cookie
स्टॉप इंडेक्स दिए बिना स्लाइसिंग का मतलब है कि आप स्टार्ट इंडेक्स से लेकर वाक्य के आखिरी इंडेक्स तक के वर्णों को कैप्चर करते हैं। इसी तरह, स्टार्ट इंडेक्स दिए बिना स्लाइसिंग का मतलब है कि आप स्ट्रिंग के एकदम पहले इंडेक्स से स्टॉप इंडेक्स तक लेते हैं:
# Stop मान न दिया गया
print(snack[0:])
# Start मान न दिया गया (सिंटैक्स के अनुसार Stop मान एक्सक्लूडेड)
print(snack[:-1])
# यह भी मान्य है
print(snack[:])
Chocolate cookie.
Chocolate cookie
Chocolate cookie.
स्ट्रिंग स्लाइसिंग तीसरा पैरामीटर stride भी स्वीकार कर सकती है, जो दर्शाता है कि पहले वर्ण को प्राप्त करने के बाद आप कितने वर्ण आगे बढ़ना चाहते हैं। stride का मान डिफॉल्ट रूप से 1 होता है।
बेहतर समझ के लिए stride को क्रिया में देखें:
number_string = "1020304050"
print(number_string[0:-1:2])
12345
टिप: स्ट्राइडिंग से आप एक बहुत बढ़िया काम कर सकते हैं — स्ट्रिंग को रिवर्स करना:
print(number_string[::-1]) #
0504030201
-1 का मान स्ट्राइड के लिए आपको आखिरी वर्ण से शुरू करके एक-एक कर पीछे बढ़ने देता है।
वैकल्पिक रूप से, यदि आप मान -2 देते हैं, तो आप आखिरी वर्ण से शुरू करते हैं और हर बार दो वर्ण पीछे बढ़ते हैं:
print(number_string[::-2]) #
00000
सामान्य स्ट्रिंग ऑपरेशंस
स्लाइसिंग, रेंज स्लाइसिंग वे सामान्य ऑपरेशन हैं जो आपको स्ट्रिंग्स पर करने होंगे। स्ट्रिंग कॉनकैटनेशन भी है, जो जोड़ने जितना सरल है:
string1 = 'Chocolate'
string2 = 'cookie'
snack = string1 + " " + string2
print(snack)
Chocolate cookie
हालाँकि, यदि आप किसी अन्य डाटा टाइप के साथ स्ट्रिंग को जोड़ने की कोशिश करते हैं तो यह काम नहीं करेगा।
cost = 15
string1 = "The total in Euro is: "
bill = string1 + cost
print(bill)
---------------------------------------------------------------------------
TypeError Traceback (most recent call last)
<ipython-input-218-7d5c5248b927> in <module>()
2 string1 = "The total in Euro is: "
3
----> 4 bill = string1 + cost
5 print(bill)
TypeError: Can't convert 'int' object to str implicitly
यहाँ, आपने एक स्ट्रिंग को एक इन्टीजर मान के साथ जोड़ने की कोशिश की, जो अनुमत नहीं है। इंटरप्रेटर यह स्वतः नहीं समझ सकता कि आप साधारण इन्टीजर जोड़ करना चाहते हैं या स्ट्रिंग कॉनकैटनेशन। हालाँकि, अब यह आज़माएँ:
bill = string1 + str(cost)
print(bill)
The total in Euro is: 15
क्योंकि आपने स्पष्ट रूप से इन्टीजर को स्ट्रिंग में बदला और फिर कॉनकैटनेशन लागू किया। डाटा टाइप कन्वर्ज़न के बारे में और जानने के लिए, यह ट्यूटोरियल देखें।
स्ट्रिंग को दोहराने के लिए, * ऑपरेशन का उपयोग करें।
single_word = 'hip '
line1 = single_word * 2 + 'hurray! '
print(line1 * 3)
hip hip hurray! hip hip hurray! hip hip hurray!
आप स्ट्रिंग में सदस्यता जाँचने के लिए in और not in का भी उपयोग कर सकते हैं:
sub_string1 = 'ice'
sub_string2 = 'glue'
string1 = 'ice cream'
if sub_string in string1:
print("There is " + sub_string + " in " + string1)
if sub_string2 not in string1:
print("Phew! No " + sub_string2 + " in " + string1)
There is ice in ice cream
Phew! No glue in ice cream
Python स्ट्रिंग्स को मैनिपुलेट करने के लिए कई बिल्ट-इन मेथड्स या हेल्पर फंक्शंस प्रदान करता है। सबस्ट्रिंग बदलना, किसी पैराग्राफ में कुछ शब्दों को कैपिटलाइज़ करना, किसी स्ट्रिंग के भीतर दूसरी स्ट्रिंग की पोज़ीशन ढूँढना — ये कुछ ऑपरेशन हैं जो आप इन बिल्ट-इन मेथड्स से कर सकते हैं।
इनमें से कुछ पर विस्तार से नज़र डालें:
str.capitalize(): स्ट्रिंग की एक प्रति लौटाता है जिसमें पहला वर्ण कैपिटलाइज़्ड होता है।
str.capitalize('cookie')
'Cookie'
str.islower(): यदि स्ट्रिंग के सभी वर्ण लोअरकेस हैं तो true लौटाता है, अन्यथा false।
snack = 'cookie'
snack.islower()
True
str.find(substring): स्ट्रिंग में वह न्यूनतम इंडेक्स लौटाता है जहाँ सबस्ट्रिंग मिलती है। आप स्ट्रिंग के भीतर खोज के लिए स्टार्ट और एंड इंडेक्स भी निर्दिष्ट कर सकते हैं। यदि सबस्ट्रिंग नहीं मिलती, तो -1 लौटाता है।
str1 = 'I got you a cookie'
str2 = 'cook'
str1.find(str2)
12
str.count(substring): गिनता है कि स्ट्रिंग में सबस्ट्रिंग कितनी बार आती है। आप स्ट्रिंग के लिए स्टार्ट और स्टॉप इंडेक्स भी निर्दिष्ट कर सकते हैं।
str1 = 'I got you a cookie, do you like cookies?'
str2 = 'cookie'
str1.count(str2)
2
str.isspace(): यदि स्ट्रिंग में केवल whitespace वर्ण हैं तोTrueलौटाता है, अन्यथा false। Whitespace वर्णों में स्पेस, टैब, newline आदि शामिल हैं।
यह वास्तविक जीवन के डेटासेट्स के साथ काम करते समय उपयोगी हो सकता है, जो एक फ़ॉर्मेट से दूसरे में रूपांतरण के दौरान हमेशा उचित स्पेसिंग एनकोड नहीं करते।
str_space = ' '
str_space.isspace()
True
str_tab = '\t'
str_tab.isspace()
True
str_nextline = '''\n'''
str_nextline.isspace()
True
नोट: क्या आपने ऊपर \t, \n देखा? इन्हें escape characters कहा जाता है। ये \ (बैकस्लैश) से शुरू होते हैं। आंतरिक रूप से, इन्हें सामान्य स्ट्रिंग्स की तरह नहीं समझा जाता, बल्कि ऐसे विशेष वर्णों के रूप में जो कुछ और दर्शाते हैं। उदाहरण — \t टैब को दर्शाता है। ऐसे और भी कई एस्केप कैरेक्टर्स हैं और आप उनके बारे में हमारे Python Regex ट्यूटोरियल में पढ़ सकते हैं।
str.lstrip(): स्ट्रिंग में सभी अग्रणी whitespace हटाता है। वास्तविक-जीवन के डेटासेट्स के साथ काम करते समय यह एक और उपयोगी फंक्शन है।
str1 = " I can't hear you. Are you alright? "
str2 = " Yes, all is good."
str3 = str1.lstrip() + str2.lstrip()
print(str3)
I can't hear you. Are you alright? Yes, all is good.
str.isdigit(): यदि स्ट्रिंग में केवल digits हैं तोTrueऔर अन्यथाFalseलौटाता है।
number_string = "1020304050"
number_string.isdigit()
True
str.replace(substring, new): स्ट्रिंग में सबस्ट्रिंग की सभी घटनाओं को new से बदलता है। आप तीसरा आर्गुमेंटmaxभी परिभाषित कर सकते हैं, जो अधिकतमmaxघटनाओं को बदलता है। याद रखें कि यह inplace रिप्लेसमेंट नहीं है, यानी इम्यूटेबल गुण यथावत रहता है और वास्तव में एक नई स्ट्रिंग बनती है।
string1 = 'hip hip hurray! hip hip hurray! hip hip hurray!'
string2 = string1.replace('hip', 'Hip')
print(string1)
print(string2)
hip hip hurray! hip hip hurray! hip hip hurray!
Hip Hip hurray! Hip Hip hurray! Hip Hip hurray!
string1.replace('hip', 'Hip', 2)
'Hip Hip hurray! hip hip hurray! hip hip hurray!'
str.split(delimiter=""): डिलीमीटर (यदि न दिया जाए तो स्पेस) के अनुसार स्ट्रिंग को विभाजित करता है और सबस्ट्रिंग्स की सूची लौटाता है।
dessert = 'Cake, Cookie, Icecream'
list_dessert = string1.split(',')
Python में स्ट्रिंग मेथड्स की पूरी सूची आपको यहाँ मिल सकती है।
स्ट्रिंग फॉर्मेटिंग
Python स्ट्रिंग को फॉर्मेट करने के कई तरीके सपोर्ट करता है। इस खंड में, आप फॉर्मेटिंग स्ट्रिंग्स के बारे में और सीखेंगे!
% फॉर्मेटिंग
मॉड्युलो % Python में एक बिल्ट-इन ऑपरेशन है। इसे इंटरपोलेशन ऑपरेटर के रूप में जाना जाता है। आपको % के बाद उस डाटा टाइप को देना होगा जिसे फॉर्मेट या कन्वर्ट करना है। फिर % ऑपरेशन '%datatype' वाक्यांश को निर्दिष्ट डाटा टाइप के शून्य या अधिक एलिमेंट्स से प्रतिस्थापित कर देता है:
print("I bought %d Euro worth of %s!" %(200, 'cookies'))
I bought 200 Euro worth of cookies!
आपने इन्टीजर्स के लिए %d और स्ट्रिंग्स के लिए %s देखा। अन्य कुछ कन्वर्ज़न टाइप्स हैं: ऑक्टल मानों के लिए o, हेक्साडेसिमल के लिए x, फ्लोटिंग पॉइंट डेसिमल फॉर्मेट के लिए f, एकल वर्ण के लिए c (इन्टीजर या सिंगल-कैरेक्टर स्ट्रिंग स्वीकार करता है)।
Formatter क्लास
formatter क्लास बिल्ट-इन स्ट्रिंग क्लासों में से एक है। यह format() मेथड का उपयोग करके जटिल वैरिएबल सब्स्टिट्यूशन और वैल्यू फॉर्मेटिंग की क्षमता प्रदान करता है। यह आपको इसके पब्लिक मेथड्स: format(), vformat() को फिर से लिखकर अपनी स्वयं की स्ट्रिंग फॉर्मेटिंग बिहेवियर्स बनाने और कस्टमाइज़ करने देता है। इसके कुछ मेथड्स सबक्लासेज़ द्वारा रिप्लेस किए जाने के लिए हैं: parse(), get_field(), get_value(), check_unused_args(), format_field() और convert_field()। हालाँकि, सरलता के लिए, आप केवल सबसे आम इस्तेमाल होने वाले format() फंक्शन को क्रिया में देखेंगे...
print("I bought {0} Euro worth of {1}!".format(200,'cookies')) #स्थिति के अनुसार मान एक्सेस करना
I bought 200 Euro worth of cookies!
print("I bought {total} Euro worth of {item}!".format(total = 200, item = 'cookies')) #नाम से मान एक्सेस करना
I bought 200 Euro worth of cookies!
'{:#<10}'.format('Cake') #शब्द 'Cake' के लिए बाएँ संरेखण, खाली जगह '#'
'Cake######'
'{:#^10}'.format('Cake') #शब्द 'Cake' के लिए मध्य संरेखण, खाली जगह '#'
'###Cake###'
'{:#>10}'.format('Cake') #शब्द 'Cake' के लिए दाएँ संरेखण, खाली जगह '#'
'######Cake'
for num in range(1,10):
print('{0:{width}}'.format(num, width=5), end=' ')
1 2 3 4 5 6 7 8 9
टेम्पलेट स्ट्रिंग्स
सामान्य % आधारित सब्स्टिट्यूशन्स के बजाय, टेम्पलेट्स $ आधारित सब्स्टिट्यूशन्स सपोर्ट करते हैं। Python संस्करण 2.4 में टेम्पलेट्स के परिचय के पीछे तर्क यह था कि भले ही % स्ट्रिंग फॉर्मेटिंग शक्तिशाली और समृद्ध है, वे त्रुटि-प्रवण हैं और '%' के बाद आने वाले फॉर्मेट्स के संदर्भ में काफी सख्त भी हैं, जिससे यह जटिल हो जाता है। % फॉर्मेटिंग के साथ एक सामान्य गलती है ट्रेलिंग फॉर्मेट कैरेक्टर भूल जाना, उदाहरण: %(variabl)e में e।
टेम्पलेट्स में कुछ मेथड्स परिभाषित हैं: substitute() और safe_substitute()। आप इन्हें ऐसे उपयोग कर सकते हैं:
from string import Template #सबसे पहले आपको 'Tempalte' क्लास इम्पोर्ट करनी होगी
money = dict(who = 'You', to_whom = 'baker')
Template('$who owe the $to_whom a total of $$100').substitute(money)
'You owe the baker a total of $100'
क्या आपने ऊपर $$ नोट किया?
क्योंकि टेम्पलेट में $$ एक एस्केप कैरेक्टर है जो एकल $ से प्रतिस्थापित हो जाता है। यह टेम्पलेट का एक नियम है। टेम्पलेट का एक और नियम यह है कि आप अपने टेम्पलेट के भीतर आइडेंटिफ़ायर कैसे परिभाषित करते हैं — सामान्य सिंटैक्स है: $identifier, और आप ${identifier} भी उपयोग कर सकते हैं।
अर्थात ${identifier} वही है जो $identifier, लेकिन ऐसे परिदृश्यों में काम आता है जैसे:
word = dict(noun = 'feed')
Template('Please don\'t stop ${noun}ing me').substitute(word)
"Please don't stop feeding me"
आइए देखें कि आप substitute() और safe_substitute() का उपयोग कैसे कर सकते हैं।
fact = Template('$alter_ego is weak but wait till he transforms to $superhero!')
fact.substitute(alter_ego='Bruce Banner', superhero='Hulk')
'Bruce Banner is weak but wait till he transforms to Hulk!'
hero = dict(alter_ego='Peter Parker')
fact.substitute(hero)
---------------------------------------------------------------------------
KeyError Traceback (most recent call last)
<ipython-input-244-c82f6a2ebc02> in <module>()
1 hero = dict(alter_ego='Peter Parker')
----> 2 fact.substitute(hero)
~/anaconda3/envs/tensorflow/lib/python3.5/string.py in substitute(*args, **kws)
127 raise ValueError('Unrecognized named group in pattern',
128 self.pattern)
--> 129 return self.pattern.sub(convert, self.template)
130
131 def safe_substitute(*args, **kws):
~/anaconda3/envs/tensorflow/lib/python3.5/string.py in convert(mo)
117 named = mo.group('named') or mo.group('braced')
118 if named is not None:
--> 119 val = mapping[named]
120 # We use this idiom instead of str() because the latter will
121 # fail if val is a Unicode containing non-ASCII characters.
KeyError: 'superhero'
ऊपर दिया गया उदाहरण त्रुटि देता है, क्योंकि superhero परिभाषित नहीं है। हालाँकि, यह आज़माएँ...
fact.safe_substitute(hero)
'Peter Parker is weak but wait till he transforms to $superhero!'
safe_substitute() टेम्पलेट का एक लाभ है।
आप पूछते हैं, इतने सारे स्ट्रिंग फॉर्मेटिंग विकल्प क्यों?
खैर, यह मुख्यतः सिंटैक्स प्राथमिकताओं का मामला है। यह आमतौर पर सरलता बनाम वर्णनात्मकता के बीच समझौते पर आता है और आपकी मौजूदा सिंटैक्स से परिचितता पर भी निर्भर करता है। उदाहरण के लिए, C प्रोग्रामिंग पृष्ठभूमि वाले लोगों के लिए स्ट्रिंग फॉर्मेटिंग के लिए % का उपयोग स्वाभाविक लगेगा। Python में टेम्पलेट्स लिखना सरल है, जबकि format() अधिक वर्णनात्मक हो सकता है पर अधिक फ़ीचर्स देता है।
फॉर्मेटेड स्ट्रिंग लिटरल (f-string)
यह स्ट्रिंग फॉर्मेटिंग की एक और विधि है जो Python संस्करण 3.6 में जोड़ी गई। एक फॉर्मेटेड स्ट्रिंग लिटरल या f-string वह स्ट्रिंग लिटरल है जिसके आगे 'f' या 'F' प्रीफ़िक्स होता है। आप अपनी स्ट्रिंग में घुमावदार कोष्ठकों { } के भीतर उपयोग किए जाने वाले आइडेंटिफ़ायर्स परिभाषित कर सकते हैं।
एक और स्ट्रिंग फॉर्मेटिंग विकल्प क्यों? व्यावहारिकता और सरलता सुंदर है — बस इसलिए!
नीचे दिए उदाहरण देखें कि क्यों f-strings वास्तव में Python में स्ट्रिंग्स को फॉर्मेट करने का सबसे सरल और व्यावहारिक तरीका हैं।
alter_ego = 'Peter Parker'
superhero = 'spiderman'
f'{alter_ego} is weak but wait till he transforms to {superhero}!'
नोट: ऊपर दिया कोड केवल Python संस्करण 3.6 और उसके बाद में ही काम करेगा। आपके सिस्टम में इंस्टॉल Python संस्करण जाँचने के लिए टर्मिनल पर टाइप करें: python -V। अन्यथा आप Python के भीतर sys मॉड्यूल का भी उपयोग कर सकते हैं। इसके लिए बस यह करें:
import sys
sys.version
फॉर्मेटेड स्ट्रिंग्स वास्तव में रनटाइम पर मूल्यांकित अभिव्यक्तियाँ होती हैं, यानी आप f-strings की घुमावदार कोष्ठकों के भीतर कोई भी Python अभिव्यक्ति उपयोग कर सकते हैं, जो f-string का एक और बड़ा लाभ है।
f'{alter_ego} is weak but wait till he transforms to {superhero.capitalize()}!'
क्या f-string पहले से ही शानदार नहीं है! लेकिन ठहरिए, यह और भी बेहतर हो जाता है... f-strings अन्य तीन तरीकों की तुलना में तेज़ भी हैं। क्योंकि इन्हें पहले से पार्स कर कुशल बाइटकोड में संग्रहीत किया जाता है ताकि निष्पादन तेज़ हो।
सही स्ट्रिंग्स खींचिए!
आप ट्यूटोरियल के अंत तक पहुँच गए हैं, बधाई! आपने देखा कि स्ट्रिंग्स क्या हैं, स्ट्रिंग स्लाइसिंग के बारे में सीखा और कुछ ऑपरेशंस देखे जो स्ट्रिंग्स पर किए जा सकते हैं। आपने स्ट्रिंग्स को फॉर्मेट करने के कई तरीके भी देखे। लेकिन याद रखें, किसी भी तकनीक में महारत का मूल मंत्र है — अभ्यास!
स्ट्रिंग्स Python में कई डाटा टाइप्स में से एक हैं। सूचियाँ, डिक्शनरीज़, ट्यूपल और सेट्स के बारे में और जानने के लिए DataCamp का Data Types for Data Science कोर्स देखें। इस कोर्स में आप डाटा टाइप्स के अपने ज्ञान का उपयोग करेंगे। आप डाटा साइंस उद्देश्यों के लिए शिकागो मेट्रोपॉलिटन क्षेत्र के ट्रांज़िट डाटा के साथ काम करेंगे। खुद देखने के लिए आगे बढ़ें...
स्ट्रिंग अक्षरों, शब्दों या अन्य वर्णों का संग्रह होती है। यह आदिम डाटा संरचनाओं में से एक है और डाटा मैनिपुलेशन के लिए बिल्डिंग ब्लॉक्स हैं। Python में
strनाम की एक बिल्ट-इन स्ट्रिंग क्लास होती है। Python स्ट्रिंग्स "immutable" होती हैं, यानी बनने के बाद बदली नहीं जा सकतीं। स्ट्रिंग मैनिपुलेशन के लिए, हम उनकी इम्यूटेबल विशेषता के कारण गणना किए गए मानों का प्रतिनिधित्व करने हेतु नई स्ट्रिंग्स बनाते जाते हैं।इस ट्यूटोरियल में, आप स्ट्रिंग्स को गहराई से देखेंगे और निम्नलिखित विषय कवर करेंगे:
Formatterक्लासयदि आप Python में डाटा संरचनाओं के बारे में और सीखना चाहते हैं, तो अवश्य देखें DataCamp का दो-भाग वाला Python Data Science Toolbox। यह कोर्स फंक्शंस, इटरेटर, लिस्ट्स आदि में और गहराई से जाता है।
स्ट्रिंग्स
आप Python में
strऑब्जेक्ट का उपयोग करके टेक्स्टुअल डाटा को संभाल सकते हैं। स्ट्रिंग्स यूनिकोड की इम्यूटेबल सीक्वेंस होती हैं। यूनिकोड एक प्रणाली है जो भाषाओं के सभी वर्णों को दर्शाने के लिए बनाई गई है। यूनिकोड में, प्रत्येक अक्षर/वर्ण को 4-बाइट संख्या के रूप में दर्शाया जाता है। हर संख्या एक अद्वितीय वर्ण को दर्शाती है।स्ट्रिंग को दर्शाने के लिए, आप उसे कोट्स में लिखते हैं। ऐसा करने के कई तरीके हो सकते हैं:
ट्रिपल-कोटेड स्ट्रिंग आपको मल्टीलाइन स्ट्रिंग्स के साथ काम करने देती है, और संबंधित सभी whitespace स्ट्रिंग में शामिल रहता है।
स्ट्रिंग्स इम्यूटेबल होती हैं, यानी यदि आप स्ट्रिंग में कोई मान बदलने की कोशिश करेंगे, तो त्रुटि आएगी। परिवर्तन जोड़ने के लिए आपको एक नई स्ट्रिंग बनानी होगी।
आप स्ट्रिंग की लंबाई बिल्ट-इन
len()फंक्शन से जान सकते हैं: