

学习路径
开发大型语言模型
16 小时
实践并学习路径你的进步。
使用 Google 继续Qwen3-Max-Thinking 于 2025 年 11 月向公众开放。当您启用“思考模式”(thinking mode)时,模型会在作答前展示其推理过程。您可以看到它如何处理数学题、逻辑谜题和复杂代码。该模型拥有超过 1 万亿参数,最多可处理 262k 个 token。
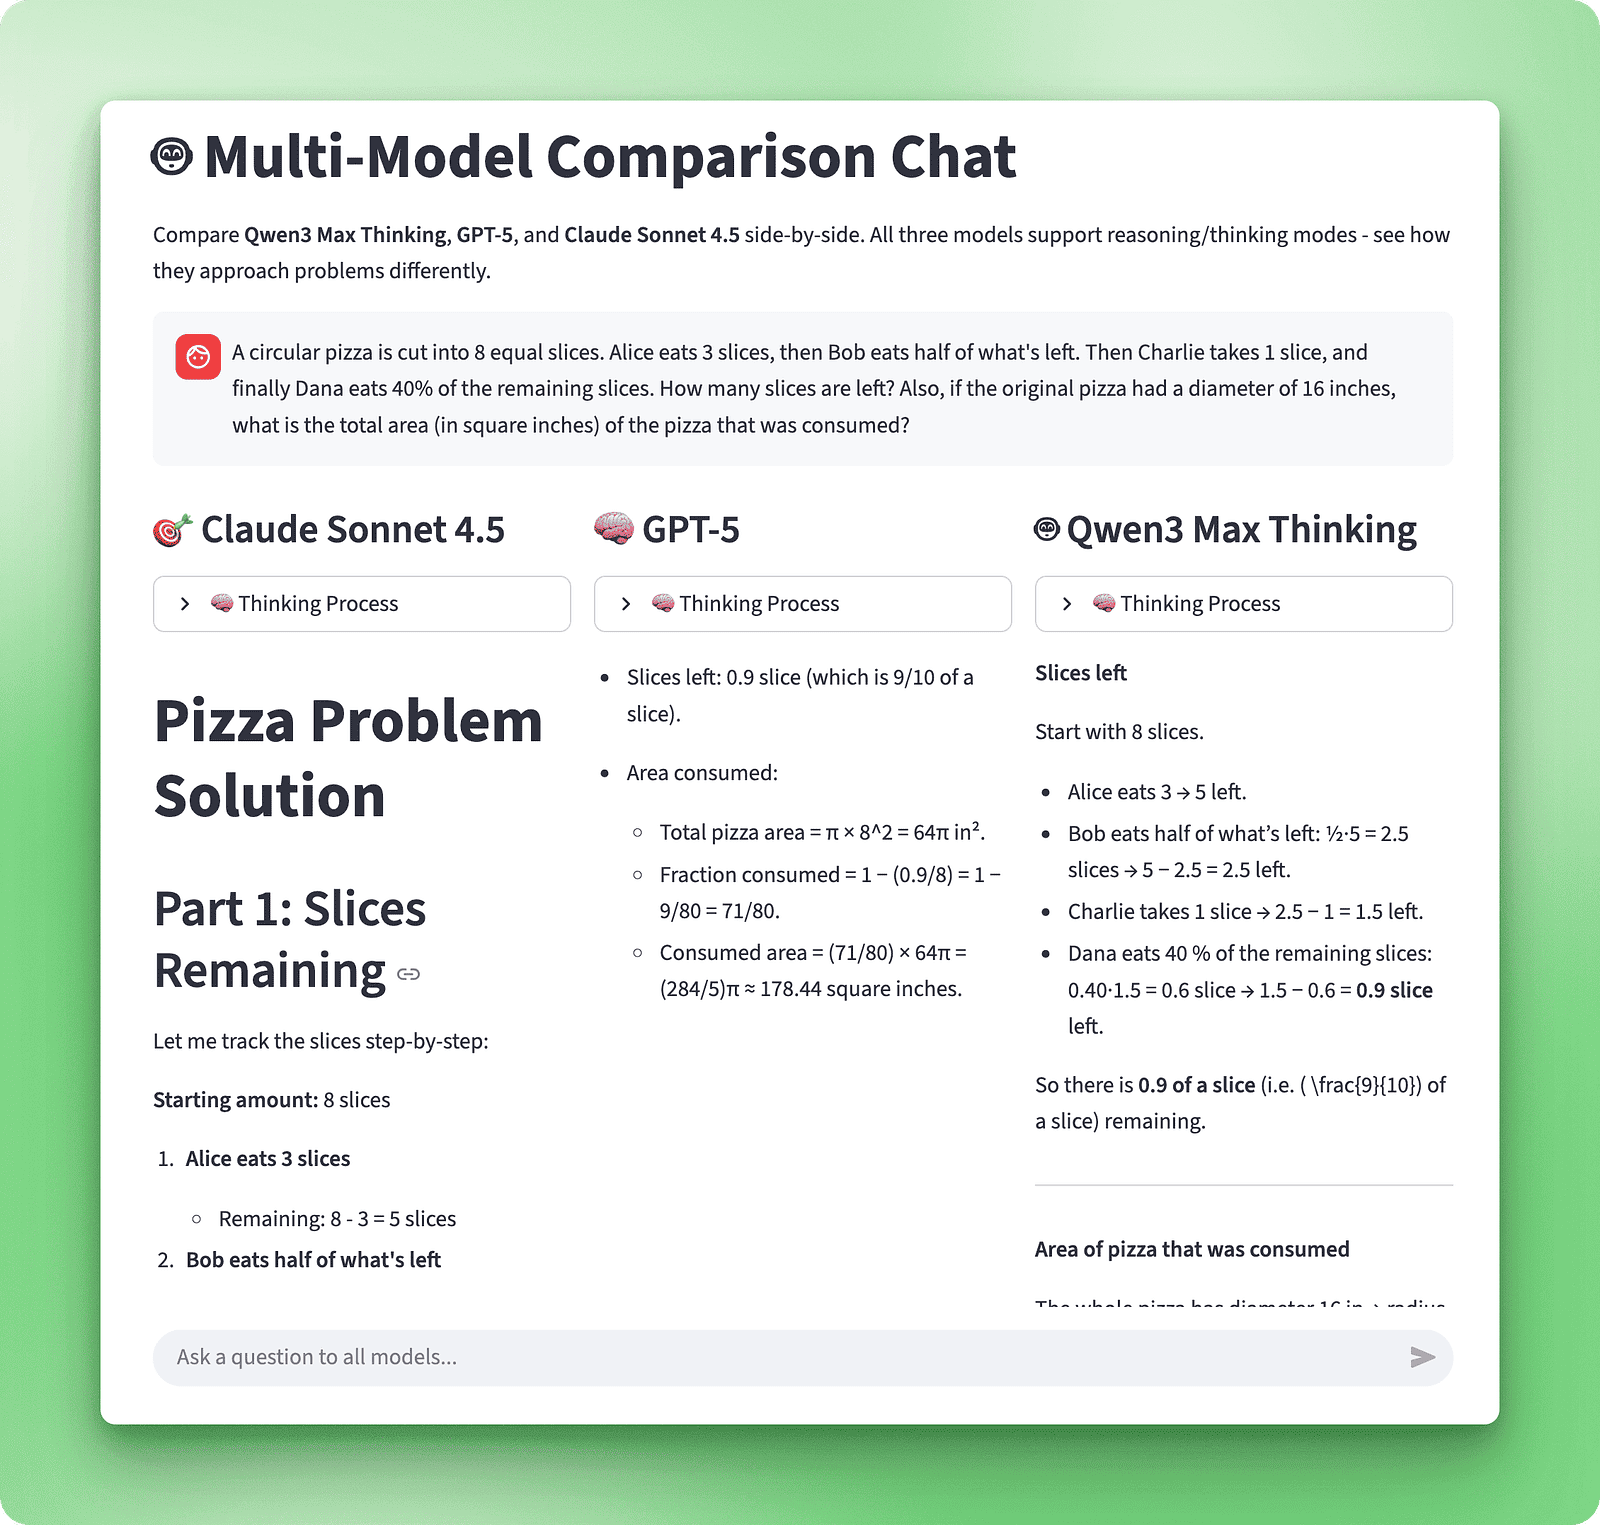
在本教程中,您将完成 API 访问配置,在不同问题上测试思考模式,并构建一个 Streamlit 应用,将相同提示同时发送给 Qwen3-Max-Thinking、GPT-5 和 Claude Sonnet 4.5。您将看到每个模型的解题思路,以及思考模式在何时有效。以下是应用的预览:
Qwen3 Max Thinking 是阿里云对 Qwen3-Max 模型的实现,于 2025 年 9 月 5 日发布。名称中的“thinking”指的是一种特殊模式:在给出答案之前,模型会公开其逐步推理过程。
该功能的价值体现在其在数学与推理基准上的表现。当与工具使用(如用于执行计算的代码解释器)以及扩展的测试时计算相结合时,它在 AIME25(面向高中高阶数学、需要多步推理的美国数学邀请赛)上取得了 100% 的成绩;在 HMMT(哈佛-麻省理工数学竞赛,考察复杂问题求解)上也达到了 100%。这些基准测试检验的是实际的推理能力,而非模式匹配或记忆。
测试时计算是模型取得卓越基准成绩的关键。模型不仅在训练阶段(学习阶段)使用计算资源,还在推理阶段(当您发起 API 调用、模型生成响应时)使用计算资源。配合工具使用,模型可以核查其推理,并与外部资源比对结果。
虽然 Qwen3 在部分基准(如 AIME25)上与 GPT-5 和 Claude Sonnet 4.5 持平,但在其他方面有所差异。在 SWE-bench Verified(软件工程任务)上,Claude 以 77.2% 领先,其次是 GPT-5 的 72.8%,Qwen3 为 69.6%。上下文窗口方面,GPT-5 以 400k token 最大,相比之下 Qwen3 为 262k,Claude 为 200k。
在定价上,Qwen3 具优势:输入/输出每百万 token 分别为 $1.20/$6.00,约为 GPT-5($1.25/$10.00)的一半、Claude($3.00/$15.00)的 2.5 倍便宜。思考模式通过展示明确的推理步骤,让 Qwen3 更显与众不同。
由于模型仍处于预览与训练阶段,覆盖所有任务的完整基准结果将在阿里巴巴发布最终版本后提供。
| 功能 | Qwen3-Max-Thinking | GPT-5 | Claude Sonnet 4.5 |
|---|---|---|---|
| 提供方 | 阿里云 | OpenAI | Anthropic |
| 参数规模(约) | ~1 万亿+ | 未公开 | 未公开 |
| 上下文窗口 | 262k tokens | 400k tokens | 200k tokens(标准)/ 最多 1M tokens(API) |
| 推理 / 思考模式 | 显式思考模式 | 可调推理强度 | 思考块 / 预算模式 |
| SWE-bench Verified(软件任务) | 69.6% | 72.8% | 77.2% |
| AIME25(数学推理) | 100% | 100% | 100% |
| 输入/输出定价 | 每百万 token $1.20 / $6.00 | $1.25 / $10.00 | $3.00 / $15.00 |
| 测试时计算 | 启用 | 是 | 是 |
| 状态 | 预览 | 生产可用 | 生产可用 |
| 最佳适用场景 | 学习 + 细致推理 | 推理与容量均衡 | 快速、简明推理 |
不过,基准并非全部。为更直观地了解模型表现,我们将在后文构建一个对比应用,将其与 GPT-5 和 Claude Sonnet 4.5 进行比较。
在使用 Qwen3 Max Thinking 前,您需要准备 Python 3.8 或更高版本、pip,以及用于在阿里云注册的信用卡。首次创建账户会获得免费用量上限,但仍需提供支付信息。
前往 阿里云并创建账号。注册时,您需要在两个区域间选择:国际(新加坡)或中国(北京)。中国大陆以外的大多数读者应选择国际区域。
该选择很重要,因为每个区域都有各自的 API 端点和密钥,不能互通。
注册后,在控制台中进入 Model Studio。您需要先激活该服务,才能生成 API 密钥。如果需要更详细的截图与说明,可查看 Qwen(阿里云)教程,了解完整的账号配置流程。
激活 Model Studio 后,前往控制台的 API Keys 部分。生成新密钥并立即复制。阿里云只会显示一次密钥。
将密钥存入 .env 文件,与代码分离;并将该文件加入 .gitignore 以避免误将 API 密钥提交到版本库。
Qwen3 Max Thinking 提供 OpenAI 兼容 API,因此可以使用标准的 OpenAI Python SDK。安装它以及用于环境变量管理的 python-dotenv:
pip install openai python-dotenv在项目目录创建 .env 文件:
DASHSCOPE_API_KEY=your_key_here将 your_key_here 替换为您的 API 密钥。现在编写一个快速测试脚本来验证一切正常:
import os
from openai import OpenAI
from dotenv import load_dotenv

load_dotenv()

client = OpenAI(
   api_key=os.getenv("DASHSCOPE_API_KEY"),
   base_url="https://dashscope-intl.aliyuncs.com/compatible-mode/v1"
)

completion = client.chat.completions.create(
   model="qwen3-max-preview",
   messages=[{"role": "user", "content": "Say hello in one sentence."}]
)

print(completion.choices[0].message.content)
运行该脚本。若看到无效 API 密钥的错误,请检查是否正确复制了密钥,并确认使用了符合您区域的 base URL。
如果脚本无报错运行,您应能看到类似如下的输出:
Hello! How can I assist you today?您刚刚完成了一次基础 API 调用。现在开启思考模式,查看模型如何逐步解决问题。
要开启思考模式,请在 extra_body 参数中加入 enable_thinking: True。以下示例使用了适合逐步推理的提示:
import os
from openai import OpenAI
from dotenv import load_dotenv

load_dotenv()

client = OpenAI(
   api_key=os.getenv("DASHSCOPE_API_KEY"),
   base_url="https://dashscope-intl.aliyuncs.com/compatible-mode/v1"
)

completion = client.chat.completions.create(
   model="qwen3-max-preview",
   messages=[
       {"role": "user", "content": "If I have 3 apples and buy 2 more packs of 4 apples each, then give away half, how many do I have left?"}
   ],
   extra_body={"enable_thinking": True}
)

print("Reasoning:", completion.choices[0].message.reasoning_content)
print("\nFinal answer:", completion.choices[0].message.content)响应包含两部分。reasoning_content 字段展示模型的内部思考过程,即它如何一步步推理;content 字段给出最终答案。当关闭思考模式时,reasoning_content 将返回 None。
输出示例如下(推理已截断):
Reasoning: The problem: "If I have 3 apples and buy 2 more packs of 4 apples each, then give away half, how many do I have left?" Starting with 3 apples. Then buy 2 packs of 4 apples each: that's 2 * 4 = 8 apples. So total after buying is 3 + 8 = 11 apples. Then give away half: half of 11 is 5.5 apples...

Final answer:
1. Start with: 3 apples.
2. Buy 2 packs of 4 apples each → 2 × 4 = 8 apples.
3. Total after buying: 3 + 8 = 11 apples.
4. Give away half: 11/2 = 5.5 apples.

Answer: You have 5½ apples left.由于推理会消耗额外 token,您可以通过 thinking_budget 参数控制成本。将其与 enable_thinking 一起添加到 extra_body 中:
completion = client.chat.completions.create(
   model="qwen3-max-preview",
   messages=[
       {"role": "user", "content": "Explain why 0.1 + 0.2 doesn't equal 0.3 in Python."}
   ],
   extra_body={
       "enable_thinking": True,
       "thinking_budget": 1000
   }
)
thinking_budget 用于设置模型用于推理的最大 token 数。对于简单问题,500–1000 个 token 即可;复杂的多步推理可能需要 2000–5000 个 token。如果模型达到预算上限,它会停止推理过程,并基于已完成的推理给出最终答案。
至此,您已经体验了 Qwen3 的思考模式。GPT-5 和 Claude 也提供推理能力,但语法与方法各有不同。为了比较这些模型,让我们构建一个并排测试三者的应用。
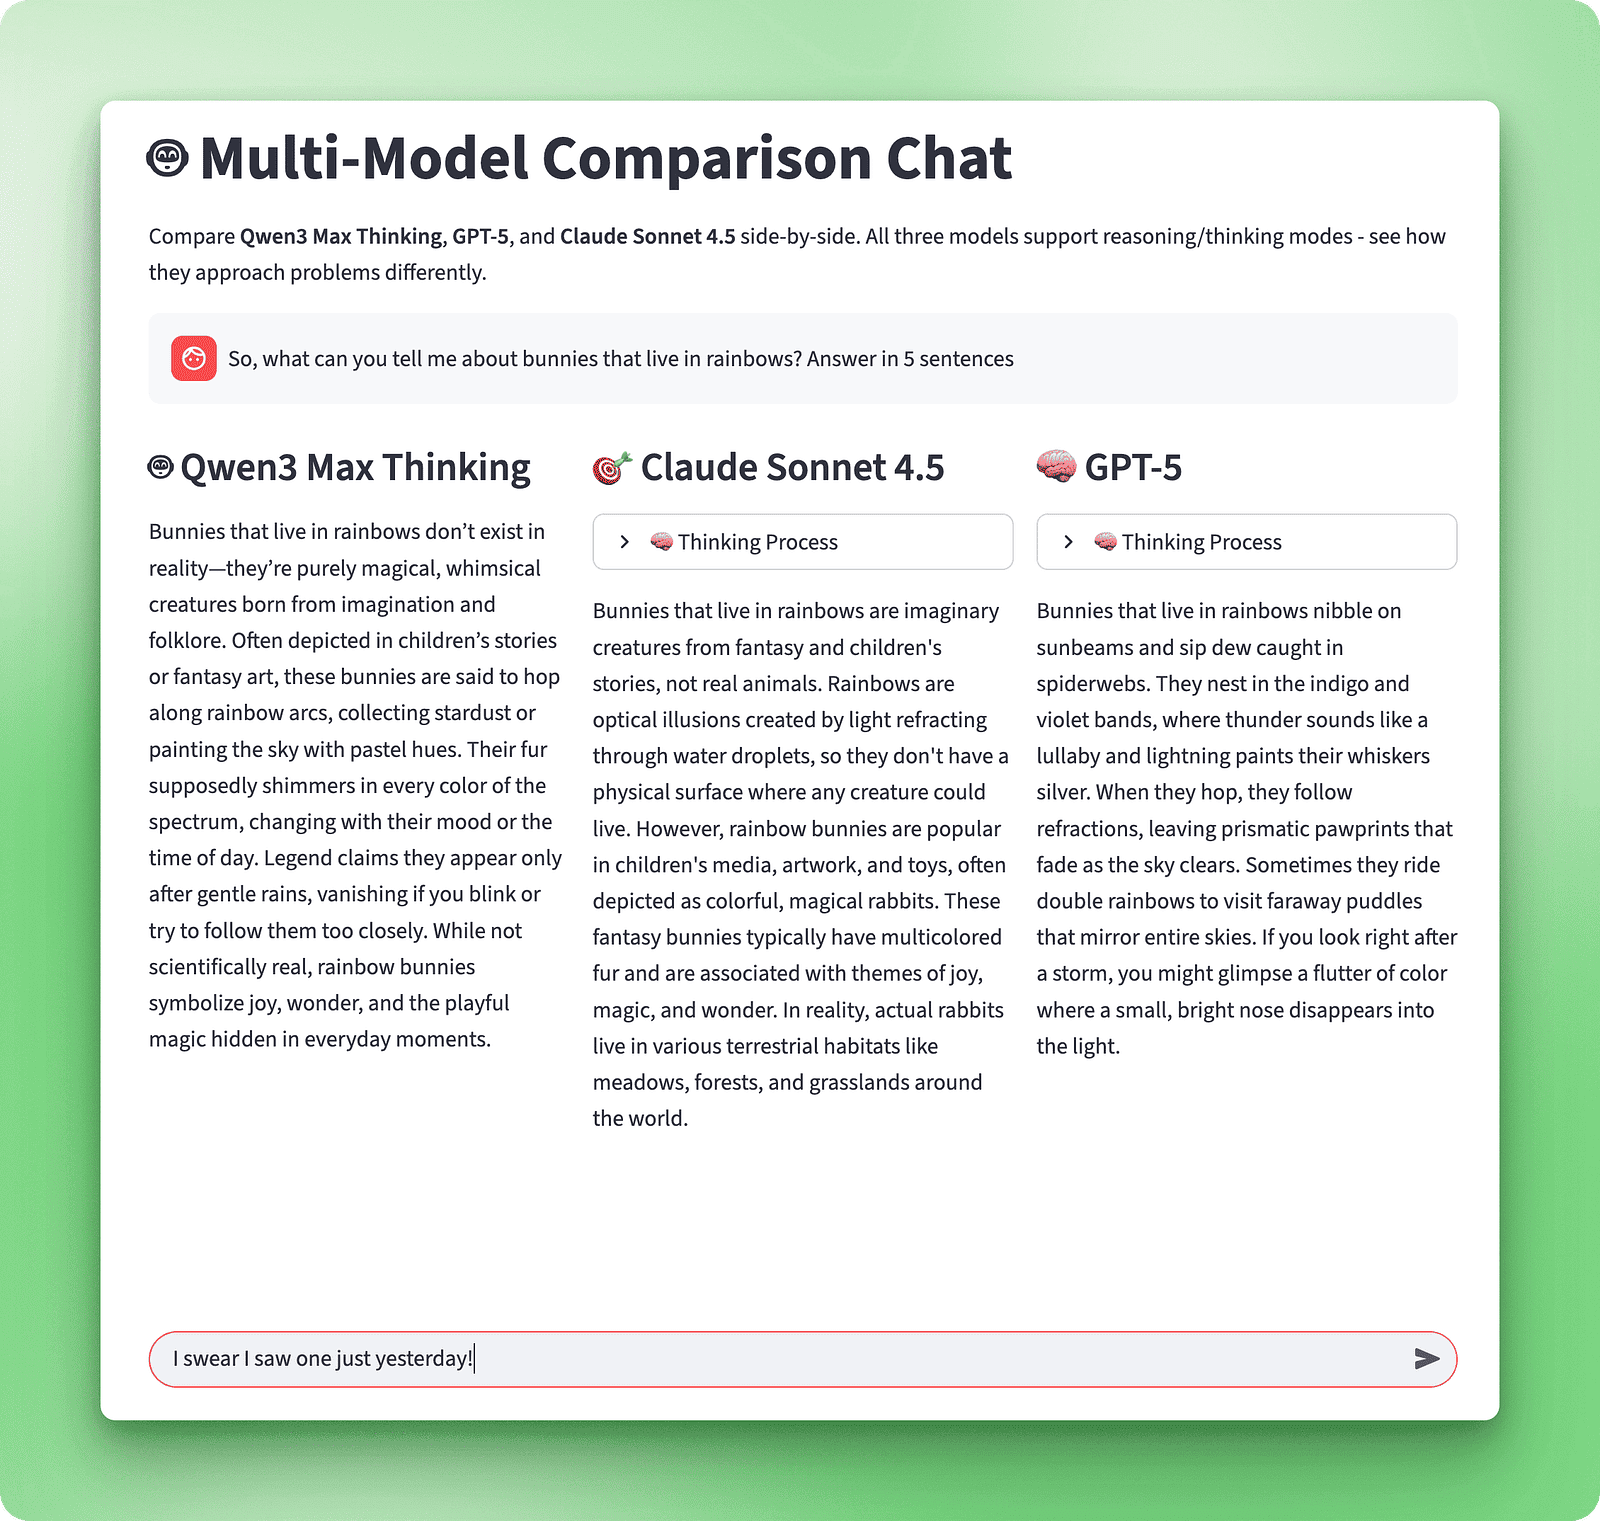
您将构建一个 Streamlit 应用,将相同提示同时发送给 Qwen3 Max Thinking、GPT-5 和 Claude Sonnet 4.5。应用会并排展示三者的响应,便于比较各自的推理方式。
完整项目代码见此 GitHub Gist。
请注意,接下来的章节会对该脚本进行详细拆解;如果您只关心应用结果,可直接跳至下一节。脚本拆解旨在教学,展示如何用 Streamlit UI 构建类似的基于 LLM 的应用。
安装用于 Web 界面的 Streamlit 和用于 Claude 的 Anthropic SDK。OpenAI SDK 您已在 API 配置部分安装。
pip install streamlit anthropic创建新文件 model_comparison_chat.py,写入导入与环境设置:
import os
import time
from typing import Dict, List
from concurrent.futures import ThreadPoolExecutor, as_completed
from dotenv import load_dotenv
import streamlit as st
from openai import OpenAI
from anthropic import Anthropic

load_dotenv()您已在第 3 节配置了 Qwen3。现在将 GPT-5 和 Claude 的 API 密钥添加到 .env 文件中:
DASHSCOPE_API_KEY=your_alibaba_cloud_key
OPENAI_API_KEY=your_openai_key
ANTHROPIC_API_KEY=your_anthropic_key
关于 GPT-5 的访问与定价详情,请参阅 GPT-5 指南。关于 Claude Sonnet 4.5,请查看 Claude Sonnet 4.5 概览。
初始化三个 API 客户端:
QWEN_CLIENT = OpenAI(
   api_key=os.getenv("DASHSCOPE_API_KEY"),
   base_url="https://dashscope-intl.aliyuncs.com/compatible-mode/v1"
)
GPT_CLIENT = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))
CLAUDE_CLIENT = Anthropic(api_key=os.getenv("ANTHROPIC_API_KEY"))与其为每个 API 写独立函数,不如使用一个统一函数来处理三种模型。以下是针对 Qwen3 的函数起始部分:
def call_model(model_name: str, messages: List[Dict], **kwargs) -> Dict:
   """Call any model with unified interface."""
   try:
       start_time = time.time()

       if model_name == "Qwen3 Max Thinking":
           enable_thinking = kwargs.get("enable_thinking", True)
           extra_body = {"enable_thinking": enable_thinking}

           completion = QWEN_CLIENT.chat.completions.create(
               model="qwen3-max-preview",
               messages=messages,
               extra_body=extra_body
           )
           reasoning_content = getattr(
               completion.choices[0].message,
               'reasoning_content',
               None
           )
           # Extract content and token info, then continue below
GPT-5 的工作方式不同,它使用 responses API,并可配置推理强度等级(以下为同一函数的延续):
       elif model_name == "GPT-5":
           reasoning_effort = kwargs.get("reasoning_effort", "medium")

           response = GPT_CLIENT.responses.create(
               model="gpt-5",
               input=messages,
               reasoning={
                   "effort": reasoning_effort,
                   "summary": "auto"
               }
           )
           # Extract response data, then continue below
GPT-5 提供四个推理强度等级:minimal、low、medium 和 high。强度越高,质量通常越好,但响应更慢、成本更高。
Claude Sonnet 4.5 的实现又有所不同(同一函数的延续):
       else:  # Claude Sonnet 4.5
           enable_thinking = kwargs.get("enable_thinking", True)
           params = {
               "model": "claude-sonnet-4-5",
               "max_tokens": 10000,
               "messages": messages
           }
           if enable_thinking:
               params["thinking"] = {
                   "type": "enabled",
                   "budget_tokens": 5000
               }

           message = CLAUDE_CLIENT.messages.create(**params)
# Parse thinking blocks from response, then continue below注意:Claude 的思考模式与 Qwen3 不同。Claude 不提供独立的 reasoning_content 字段,而是在响应内容中包含思考块,需要您自行解析。这是比较模型时的关键差异。
三个分支最终都会返回相同的数据结构(函数结尾):
    return {
               "content": content_text,
               "reasoning_content": thinking_text,
               "response_time": time.time() - start_time,
               "tokens_used": {
                   "input": input_tokens,
                   "output": output_tokens,
                   "total": total_tokens
               },
               "error": None
           }

   except Exception as e:
       return {
           "content": None,
           "reasoning_content": None,
           "response_time": 0,
           "tokens_used": {"input": 0, "output": 0, "total": 0},
           "error": f"{model_name} Error: {str(e)}"
       }
这种标准化的返回格式,可让您用同一套代码展示任意模型的响应。
在理解了各模型 API 的工作方式后,开始创建 Web 界面。先进行基础的 Streamlit 页面配置:
def main():
   st.set_page_config(
       page_title="Multi-Model Comparison Chat",
       page_icon="🤖",
       layout="wide",
       initial_sidebar_state="expanded"
   )

   st.session_state.setdefault("messages", [])
   st.session_state.setdefault("model_responses", [])
会话状态(session state)用于在多次重绘(用户交互后页面刷新)之间保存对话历史与模型响应。
添加标题与用于配置思考模式的侧边栏控件:
st.title("🤖 Multi-Model Comparison Chat")
   st.markdown("""
   Compare **Qwen3 Max Thinking**, **GPT-5**, and **Claude Sonnet 4.5** side-by-side.
   All three models support reasoning modes - see how they approach problems differently.
   """)

   with st.sidebar:
       st.header("⚙️ Settings")

       st.subheader("Thinking Mode")
       qwen_thinking = st.checkbox("Enable Qwen3 Thinking", value=True)
       gpt5_reasoning = st.selectbox(
           "GPT-5 Reasoning Effort",
           options=["minimal", "low", "medium", "high"],
           index=2
       )
       claude_thinking = st.checkbox("Enable Claude Thinking", value=True)
添加 API 状态指示:
st.subheader("API Status")
       st.markdown(f"""
       - Qwen3: {"✅" if os.getenv("DASHSCOPE_API_KEY") else "❌"}
       - GPT-5: {"✅" if os.getenv("OPENAI_API_KEY") else "❌"}
       - Claude: {"✅" if os.getenv("ANTHROPIC_API_KEY") else "❌"}
       """)
这将展示哪些 API 密钥已配置。若看到红色叉号,请检查您的 .env 文件。
def call_models_parallel(messages: List[Dict], selected_models: List[str], qwen_thinking: bool, gpt5_reasoning: str, claude_thinking: bool) -> Dict[str, Dict]:
   """Call multiple models in parallel."""
   model_kwargs = {
       "Qwen3 Max Thinking": {"enable_thinking": qwen_thinking},
       "GPT-5": {"reasoning_effort": gpt5_reasoning},
       "Claude Sonnet 4.5": {"enable_thinking": claude_thinking}
   }

   with ThreadPoolExecutor(max_workers=3) as executor:
       futures = {
           executor.submit(call_model, m, messages, **model_kwargs[m]): m
           for m in selected_models if m in model_kwargs
       }
       return {futures[f]: f.result() for f in as_completed(futures)}
相较顺序等待每个模型依次返回,并行执行会同时调用三个模型,缩短总体等待时间。
将其整合进聊天界面,并将响应并排展示:
if prompt := st.chat_input("Ask a question to all models..."):
       st.session_state.messages.append({"role": "user", "content": prompt})

       with st.spinner("🤔 Models are thinking..."):
           responses = call_models_parallel(
               st.session_state.messages,
               ["Qwen3 Max Thinking", "GPT-5", "Claude Sonnet 4.5"],
               qwen_thinking,
               gpt5_reasoning,
               claude_thinking
           )

       cols = st.columns(3)
       for idx, (model_name, response_data) in enumerate(responses.items()):
           with cols[idx]:
               st.markdown(f"### {model_name}")
               if response_data["reasoning_content"]:
                   with st.expander("🧠 Thinking Process", expanded=False):
                       st.markdown(response_data["reasoning_content"])
               st.markdown(response_data["content"])
这会创建三列,每列对应一个模型。思考过程默认折叠,便于用户首先关注最终答案。
用以下命令运行应用:
streamlit run model_comparison_chat.py先用简单的核对问题(如“2+2 等于多少?”)确认 API 连接与并行执行正常。
确认基本功能无误后,即可用更复杂的提示进行测试,以展现它们不同的推理方式。
在对比应用运行后,用更难的问题进行测试。尝试在应用中运行以下提示,看看不同模型的处理方式。
下面三个提示能清晰体现各模型的思维模式。
一个圆形披萨被切成 8 等份。Alice 吃了 3 片,Bob 吃掉剩余的一半。然后 Charlie 拿走 1 片,最后 Dana 吃掉剩下的 40%。还剩多少片?另外,若原披萨直径为 16 英寸,被吃掉的披萨总面积是多少平方英寸?
五位朋友——Amy、Ben、Clara、David 和 Emma——在电影院一排就座。
需要满足以下条件:
1. Amy 必须坐在 Ben 旁边
2. Clara 不能坐在 David 旁边
3. Emma 必须坐在一侧的端位
4. Ben 不能坐在任一端位。给定以上约束,请列出从左到右的所有可能座位排列。
编写一个 Python 函数,在给定字符串中寻找最长回文子串,需满足以下要求:
1. 时间复杂度须为 O(n²) 或更优
2. 必须正确处理 Unicode 字符
3. 若存在多个相同长度的回文,必须返回首次出现的那个
4. 包含带示例的详细文档字符串(docstring)
5. 添加类型注解
6. 处理边界情况(空字符串、单字符、无回文)。
并说明您的算法选择,以及为何满足复杂度要求。
三种模型都答对了全部问题。表现如下:
|
测试 |
模型 |
耗时(秒) |
Tokens |
结果 |
|
披萨问题 |
Qwen3-Max-Thinking |
157 |
4,419 |
✓ 正确(0.9 片,178.44 平方英寸) |
|
GPT-5 |
45 |
1,490 |
✓ 正确(0.9 片,178.44 平方英寸) |
|
|
Claude |
14 |
1,010 |
✓ 正确(0.9 片,178.44 平方英寸) |
|
|
剧院座位 |
Qwen3-Max-Thinking |
166 |
5,728 |
✓ 找到全部 8 种排列 |
|
GPT-5 |
83 |
4,607 |
✓ 找到全部 8 种排列 |
|
|
Claude |
32 |
3,081 |
✓ 找到全部 8 种排列 |
|
|
回文代码 |
Qwen3-Max-Thinking |
191 |
7,345 |
✓ 可运行的 O(n²) 解法 |
|
GPT-5 |
58 |
3,263 |
✓ 可运行的 O(n²) 解法 |
|
|
Claude |
48 |
3,279 |
✓ 可运行的 O(n²) 解法 |
Qwen3 的耗时是 Claude 的 10 倍,token 使用量为其 3–4 倍。
它会“面面俱到”。在披萨问题上,它会思考分数片是否合理、是否应该四舍五入为整数、多次校验计算,并在给出答案前评估不同解读方式。
整个过程中您能看到它反复自问“如果这样会怎样”“但也许那样更合适”。在座位问题上,它会逐一推演“若 Ben 坐在这里,Amy 可以坐在哪儿”。
回文题的解法则包含了对所选算法相较其他方案的深入分析、对 Unicode 边界情况的处理,以及详尽的复杂度拆解。就像看着一个人“出声思考”,并不断检查自己的工作。
更结构化、更有条理。它会先梳理问题,然后按步骤推进并校验结果。探索更少,执行更多。
在座位谜题中,它会先把 Emma 放在端位,再在规则约束下补齐其余位置。
回文代码给出了清晰的算法选择理由与良好的文档;它遵循既定计划,几乎不回溯。细节足够让人理解思路,但不会反复自我质疑。
它行动迅速。能快速识别解题路径并干净利落地执行。在座位问题中,它按情形(Emma 在第 1 位 vs 第 5 位)分类,逐一推演。回文代码同样干净、文档完整,但更快切入要点。它会展示思路,但很简练。
实践要点:当您需要看到方案背后的每个考量时,用 Qwen3。详尽的思考过程有助于学习或验证复杂决策。当速度更重要且您信任模型无需展示每一步也能得出答案时,用 Claude。而当您需要在两者之间取得平衡时,用 GPT-5。
注意:这些测试无法完全覆盖三种模型的全部能力。不同提示下,您的结果可能不同。
在本教程中,我演示了如何配置 Qwen3 Max Thinking,使用不同类型的问题测试其思考模式,并构建一个对比应用,将提示并排运行于 Qwen3、GPT-5 与 Claude Sonnet 4.5。
关键信息是:每个模型在不同场景下各有所长。Qwen3 擅长需要详尽推理、希望了解每一步过程的任务;Claude 以速度与干净实现取胜;GPT-5 则在两者间取得平衡。
请使用您的对比应用,在您自己的问题上测试这些模型。随着不断尝试,您将逐渐形成对不同任务应选哪种模型的直觉。
若想进一步了解 Qwen3 与多模型开发,请查看 OpenRouter 教程,以管理多种模型 API;或学习如何 借助 Ollama 在本地运行更小的 Qwen3 模型,用于离线开发。
DataCamp 热门课程
学习路径
课程
实践并学习路径你的进步。
使用 Google 继续