

लर्निंग पाथ
बड़े भाषा मॉडल विकसित करना
16 घंटा
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखेंQwen3-Max-Thinking नवंबर 2025 में सार्वजनिक रूप से उपलब्ध हुआ। जब आप thinking मोड सक्षम करते हैं, तो मॉडल उत्तर देने से पहले अपना तर्क दिखाता है। आप देख सकते हैं कि यह गणित की समस्याओं, तर्क पहेलियों, और जटिल कोड के माध्यम से कैसे काम करता है। मॉडल के 1 ट्रिलियन से अधिक पैरामीटर हैं और यह 262k टोकन तक संभाल सकता है।
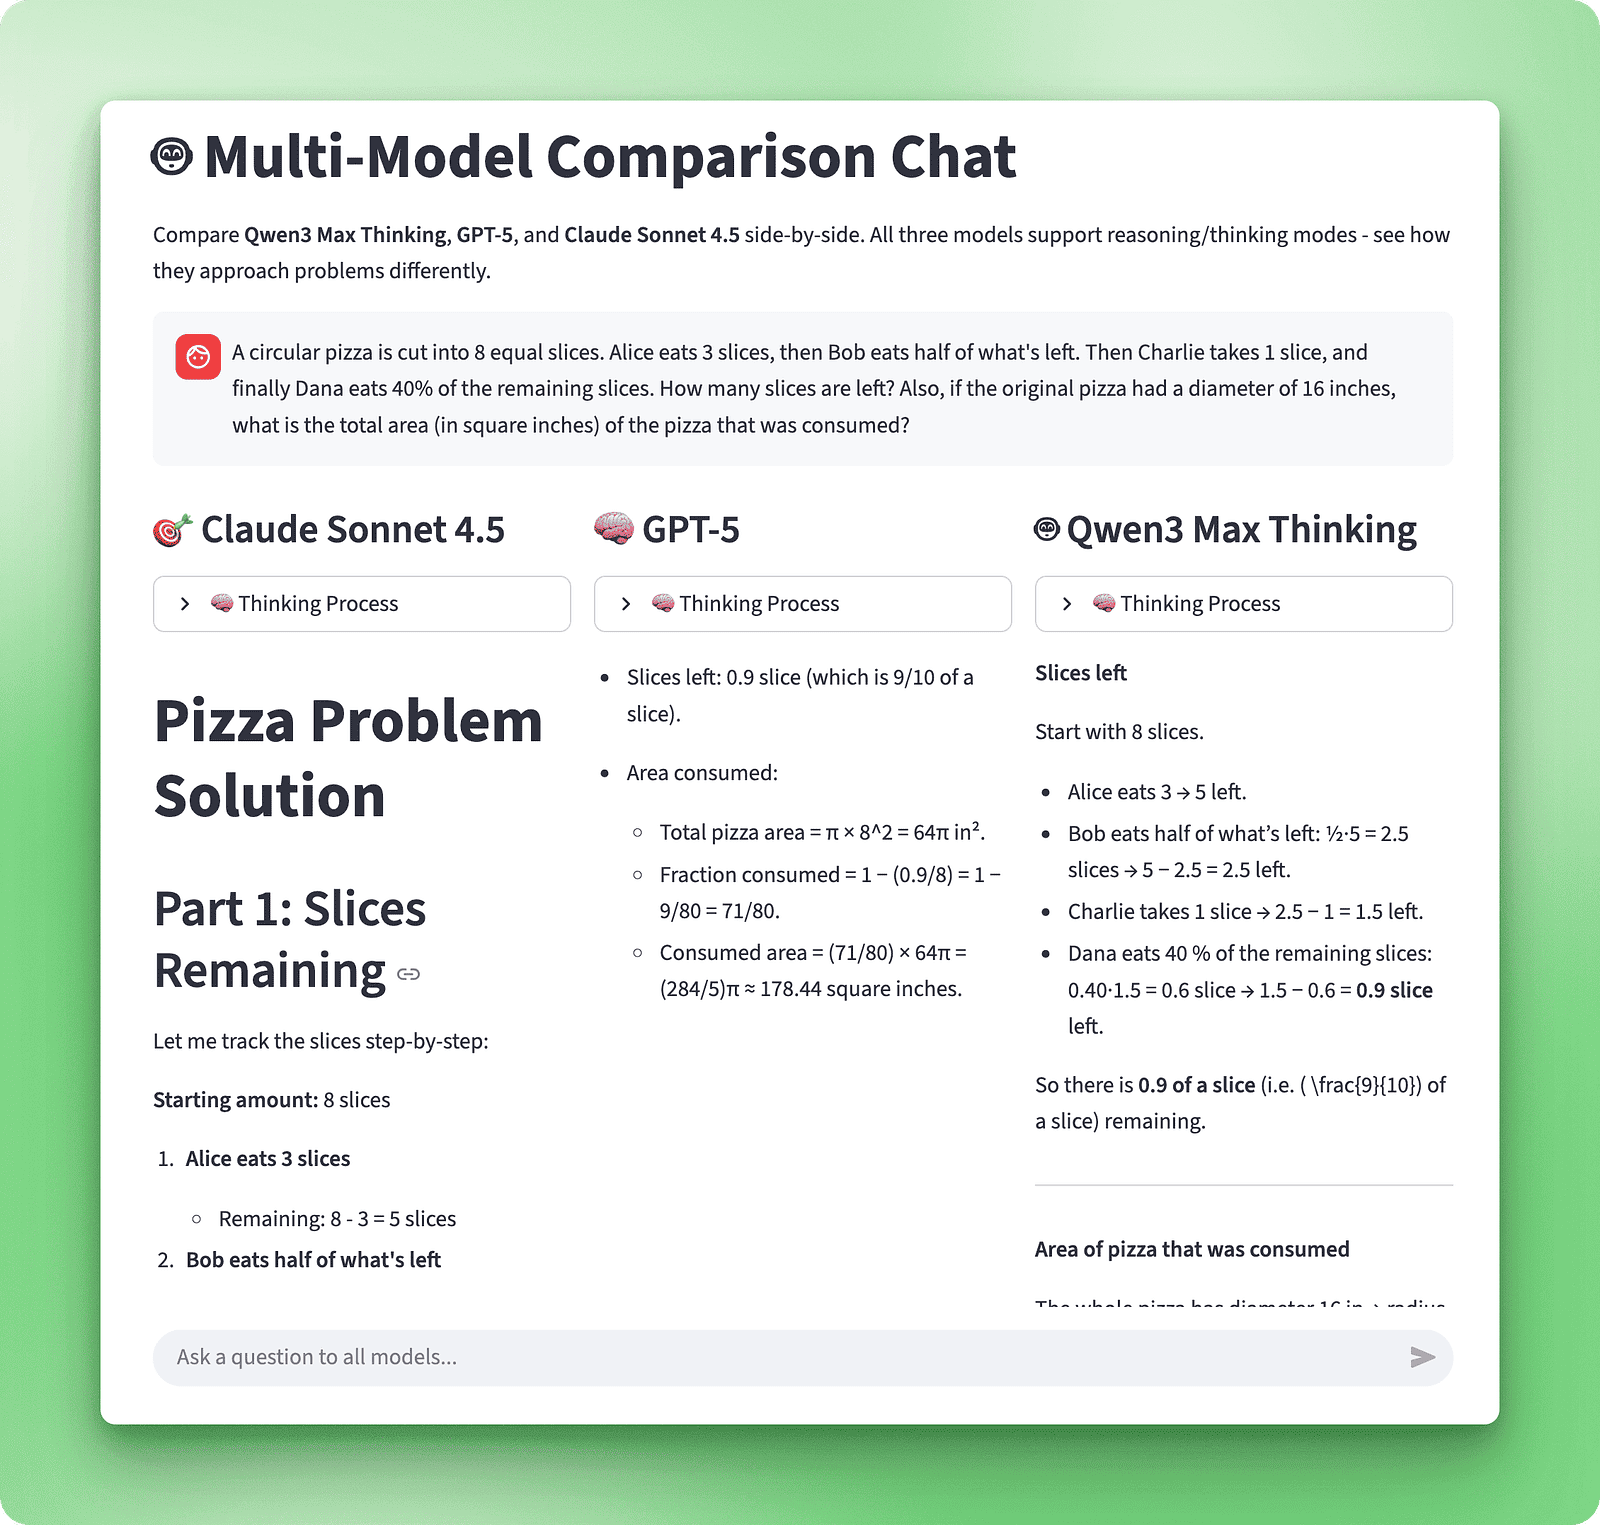
इस ट्यूटोरियल में, आप API एक्सेस सेट करेंगे, अलग‑अलग समस्याओं पर thinking मोड की जाँच करेंगे, और एक Streamlit ऐप बनाएंगे जो एक ही प्रॉम्प्ट को Qwen3-Max-Thinking, GPT-5, और Claude Sonnet 4.5 से चलाता है। आप देखेंगे कि प्रत्येक मॉडल समस्या को कैसे हल करता है और कब thinking मोड मददगार होता है। यहाँ ऐप का एक प्रीव्यू है:
Qwen3 Max Thinking, Alibaba Cloud का Qwen3-Max मॉडल का इम्प्लीमेंटेशन है, जिसका लॉन्च 5 सितंबर, 2025 को हुआ। इसके नाम में "thinking" एक विशेष मोड को संदर्भित करता है जिसमें मॉडल उत्तर देने से पहले अपने चरण-दर-चरण तर्क को उजागर करता है।
गणित और तर्क के बेंचमार्क पर मॉडल के प्रदर्शन से पता चलता है कि यह फीचर क्या प्रदान करता है। टूल उपयोग (जैसे गणनाएँ चलाने के लिए कोड इंटरप्रेटर) और स्केल्ड टेस्ट‑टाइम कंप्यूट के साथ मिलकर, इसने AIME25 में 100% स्कोर किया, जो उन्नत स्कूल स्तर के बहु‑चरणीय तर्क की जाँच करने वाली American Invitational Mathematics Examination है। इसने HMMT, यानी Harvard‑MIT Math Tournament में भी 100% हासिल किया, जो जटिल समस्या‑समाधान को मापता है। ये बेंचमार्क पैटर्न मिलान या रटना के बजाय वास्तविक तर्क क्षमता का परीक्षण करते हैं।
टेस्ट‑टाइम कंप्यूट ही मॉडल के असाधारण बेंचमार्क प्रदर्शन का कारण है। प्रशिक्षण (जब मॉडल सीखता है) के दौरान ही कंप्यूटेशनल संसाधन उपयोग करने के बजाय, यह इन्फरेंस (जब आप API कॉल करते हैं और मॉडल प्रतिक्रिया जनरेट करता है) के दौरान भी उनका उपयोग करता है। टूल उपयोग के साथ मिलकर, मॉडल अपने तर्क को सत्यापित कर सकता है और बाहरी संसाधनों के आधार पर अपने काम की जाँच कर सकता है।
जहाँ Qwen3 कुछ बेंचमार्क जैसे AIME25 पर GPT-5 और Claude Sonnet 4.5 की टक्कर देता है, वहीं अन्य क्षेत्रों में अंतर दिखता है। SWE-bench Verified द्वारा मापे गए सॉफ्टवेयर इंजीनियरिंग कार्यों पर, Claude 77.2% के साथ आगे है, उसके बाद GPT-5 72.8% और Qwen3 69.6% पर हैं। GPT-5 सबसे बड़ा कॉन्टेक्स्ट विंडो 400k टोकन का प्रदान करता है, जबकि Qwen3 का 262k और Claude का 200k है।
कीमत के मामले में बढ़त Qwen3 को है—इनपुट/आउटपुट के लिए प्रति मिलियन टोकन $1.20/$6.00—जो GPT-5 ($1.25/$10.00) की लगभग आधी और Claude ($3.00/$15.00) से 2.5 गुना सस्ती है। thinking मोड स्पष्ट तर्क चरण दिखाकर Qwen3 को अलग पहचान देता है।
क्योंकि मॉडल अभी प्रीव्यू और प्रशिक्षण में है, सभी कार्यों पर व्यापक बेंचमार्क परिणाम Alibaba द्वारा अंतिम संस्करण जारी करने के बाद उपलब्ध होंगे।
| फ़ीचर | Qwen3-Max-Thinking | GPT-5 | Claude Sonnet 4.5 |
|---|---|---|---|
| कहाँ सक्षम | Alibaba Cloud | OpenAI | Anthropic |
| पैरामीटर (लगभग) | ~1 ट्रिलियन + | सार्वजनिक रूप से प्रकट नहीं | सार्वजनिक रूप से प्रकट नहीं |
| कॉन्टेक्स्ट विंडो | 262 k टोकन | 400 k टोकन | 200 k टोकन (मानक) / API में 1 M टोकन तक |
| रीज़निंग / Thinking मोड | स्पष्ट thinking मोड | रीज़निंग effort स्तर | Thinking ब्लॉक्स / बजटेड मोड |
| SWE-bench Verified (सॉफ्टवेयर कार्य) | 69.6% | 72.8% | 77.2% |
| AIME25 (गणितीय तर्क) | 100% | 100% | 100% |
| इनपुट/आउटपुट कीमत | $1.20 / $6.00 प्रति मिलियन टोकन | $1.25 / $10.00 | $3.00 / $15.00 |
| टेस्ट‑टाइम कंप्यूट | सक्षम | Yes | Yes |
| स्थिति | प्रीव्यू | प्रोडक्शन | प्रोडक्शन |
| सर्वोत्तम उपयोग | सीखना + विस्तृत तर्क | संतुलित तर्क + क्षमता | तेज़, संक्षिप्त तर्क |
हालाँकि, बेंचमार्क पूरी कहानी नहीं बताते। यह महसूस करने के लिए कि मॉडल वास्तव में कैसा प्रदर्शन करता है, हम आगे के खंड में GPT-5 और Claude Sonnet 4.5 से इसकी तुलना करने के लिए एक कंपैरिजन ऐप बनाएँगे।
Qwen3 Max Thinking का उपयोग करने से पहले, आपको Python 3.8 या बाद का संस्करण, pip, और Alibaba Cloud पर पंजीकरण के लिए क्रेडिट कार्ड की आवश्यकता होगी। जब आप पहली बार खाता बनाते हैं, तो आपको एक मुफ्त उपयोग सीमा मिलती है, लेकिन फिर भी भुगतान विवरण देना आवश्यक है।
यहाँ जाएँ Alibaba Cloud और एक खाता बनाएँ। साइनअप के दौरान, आपको दो क्षेत्रों में से चुनना होगा: International (सिंगापुर) या China (बीजिंग)। मुख्यभूमि चीन के बाहर के अधिकांश पाठकों को International क्षेत्र चुनना चाहिए।
यह चयन महत्वपूर्ण है क्योंकि प्रत्येक क्षेत्र का अपना API endpoint और key होता है जो आपस में विनिमेय नहीं हैं।
पंजीकरण के बाद, कंसोल में Model Studio पर जाएँ। API keys जनरेट करने से पहले आपको सेवा को सक्रिय करना होगा। यदि आप अधिक विस्तृत स्क्रीनशॉट और स्पष्टीकरण चाहते हैं, तो Qwen (Alibaba Cloud) ट्यूटोरियल पूरे अकाउंट सेटअप प्रोसेस से आपको गुज़ारता है।
Model Studio सक्रिय होने के बाद, कंसोल में API Keys सेक्शन पर जाएँ। नई key जनरेट करें और तुरंत कॉपी कर लें। Alibaba Cloud key केवल एक बार दिखाता है।
अपनी key को .env फ़ाइल में रखें ताकि वह आपके कोड से अलग रहे, और इस फ़ाइल को .gitignore में जोड़ें ताकि गलती से आपकी API key वर्शन कंट्रोल में कमिट न हो जाए।
Qwen3 Max Thinking एक OpenAI‑संगत API का उपयोग करता है, इसलिए आप मानक OpenAI Python SDK का उपयोग कर सकते हैं। इसे python-dotenv के साथ इंस्टॉल करें ताकि environment variables प्रबंधित कर सकें:
pip install openai python-dotenvअपने प्रोजेक्ट डायरेक्टरी में एक .env फ़ाइल बनाएँ:
DASHSCOPE_API_KEY=your_key_hereyour_key_here को अपनी API key से बदलें। अब सब कुछ काम कर रहा है या नहीं यह जाँचने के लिए एक त्वरित टेस्ट स्क्रिप्ट लिखें:
import os
from openai import OpenAI
from dotenv import load_dotenv

load_dotenv()

client = OpenAI(
   api_key=os.getenv("DASHSCOPE_API_KEY"),
   base_url="https://dashscope-intl.aliyuncs.com/compatible-mode/v1"
)

completion = client.chat.completions.create(
   model="qwen3-max-preview",
   messages=[{"role": "user", "content": "Say hello in one sentence."}]
)

print(completion.choices[0].message.content)
यह स्क्रिप्ट चलाएँ। यदि आपको invalid API keys से संबंधित त्रुटि दिखे, तो जाँचें कि आपने key सही कॉपी की है और अपने क्षेत्र के लिए सही base URL का उपयोग कर रहे हैं।
यदि स्क्रिप्ट बिना त्रुटि के चलती है, तो आपको नीचे जैसा आउटपुट दिखना चाहिए:
Hello! How can I assist you today?आपने अभी एक बेसिक API कॉल किया। अब thinking मोड चालू करें ताकि देखें मॉडल समस्याओं को चरण‑दर‑चरण कैसे हल करता है।
thinking मोड चालू करने के लिए, extra_body पैरामीटर के अंदर enable_thinking: True जोड़ें। यहाँ एक उदाहरण है जो चरण‑दर‑चरण तर्क के साथ अच्छा काम करता है:
import os
from openai import OpenAI
from dotenv import load_dotenv

load_dotenv()

client = OpenAI(
   api_key=os.getenv("DASHSCOPE_API_KEY"),
   base_url="https://dashscope-intl.aliyuncs.com/compatible-mode/v1"
)

completion = client.chat.completions.create(
   model="qwen3-max-preview",
   messages=[
       {"role": "user", "content": "If I have 3 apples and buy 2 more packs of 4 apples each, then give away half, how many do I have left?"}
   ],
   extra_body={"enable_thinking": True}
)

print("Reasoning:", completion.choices[0].message.reasoning_content)
print("\nFinal answer:", completion.choices[0].message.content)
प्रतिक्रिया के दो भाग होते हैं। reasoning_content फ़ील्ड मॉडल की आंतरिक सोच दिखाता है, जहाँ वह समस्या को चरण‑दर‑चरण सुलझाता है। content फ़ील्ड अंतिम उत्तर देता है। जब thinking मोड अक्षम होता है, तो reasoning_content None लौटाता है।
आउटपुट ऐसा दिखता है (reasoning संक्षिप्त किया गया):
Reasoning: The problem: "If I have 3 apples and buy 2 more packs of 4 apples each, then give away half, how many do I have left?" Starting with 3 apples. Then buy 2 packs of 4 apples each: that's 2 * 4 = 8 apples. So total after buying is 3 + 8 = 11 apples. Then give away half: half of 11 is 5.5 apples...

Final answer:
1. Start with: 3 apples.
2. Buy 2 packs of 4 apples each → 2 × 4 = 8 apples.
3. Total after buying: 3 + 8 = 11 apples.
4. Give away half: 11/2 = 5.5 apples.

Answer: You have 5½ apples left.क्योंकि reasoning अतिरिक्त टोकन उपयोग करता है, आप thinking_budget पैरामीटर से लागत नियंत्रित कर सकते हैं। इसे enable_thinking के साथ extra_body में जोड़ें:
completion = client.chat.completions.create(
   model="qwen3-max-preview",
   messages=[
       {"role": "user", "content": "Explain why 0.1 + 0.2 doesn't equal 0.3 in Python."}
   ],
   extra_body={
       "enable_thinking": True,
       "thinking_budget": 1000
   }
)
thinking_budget वह अधिकतम टोकन निर्धारित करता है जो मॉडल reasoning के लिए उपयोग कर सकता है। सरल समस्याओं के लिए 500–1000 टोकन काम करते हैं। जटिल बहु‑चरणीय तर्क के लिए 2000–5000 टोकन चाहिए हो सकते हैं। यदि मॉडल बजट सीमा पर पहुँच जाता है, तो वह reasoning प्रक्रिया रोक देता है और अब तक किए गए तर्क के आधार पर अंतिम उत्तर प्रदान करता है।
अब आपने Qwen3 के thinking मोड के साथ काम कर लिया है। GPT-5 और Claude में भी reasoning सुविधाएँ हैं, पर उनकी सिंटैक्स और दृष्टिकोण अलग हैं। यह देखने के लिए कि ये मॉडल कैसे तुलना करते हैं, आइए एक ऐसा ऐप बनाते हैं जो तीनों को साथ‑साथ परखे।
आप एक Streamlit ऐप बनाएँगे जो एक ही प्रॉम्प्ट को एक साथ Qwen3 Max Thinking, GPT-5, और Claude Sonnet 4.5 को भेजता है। ऐप तीनों प्रतिक्रियाएँ साथ‑साथ दिखाता है ताकि आप देख सकें कि हर मॉडल समस्याओं के माध्यम से कैसे तर्क करता है।
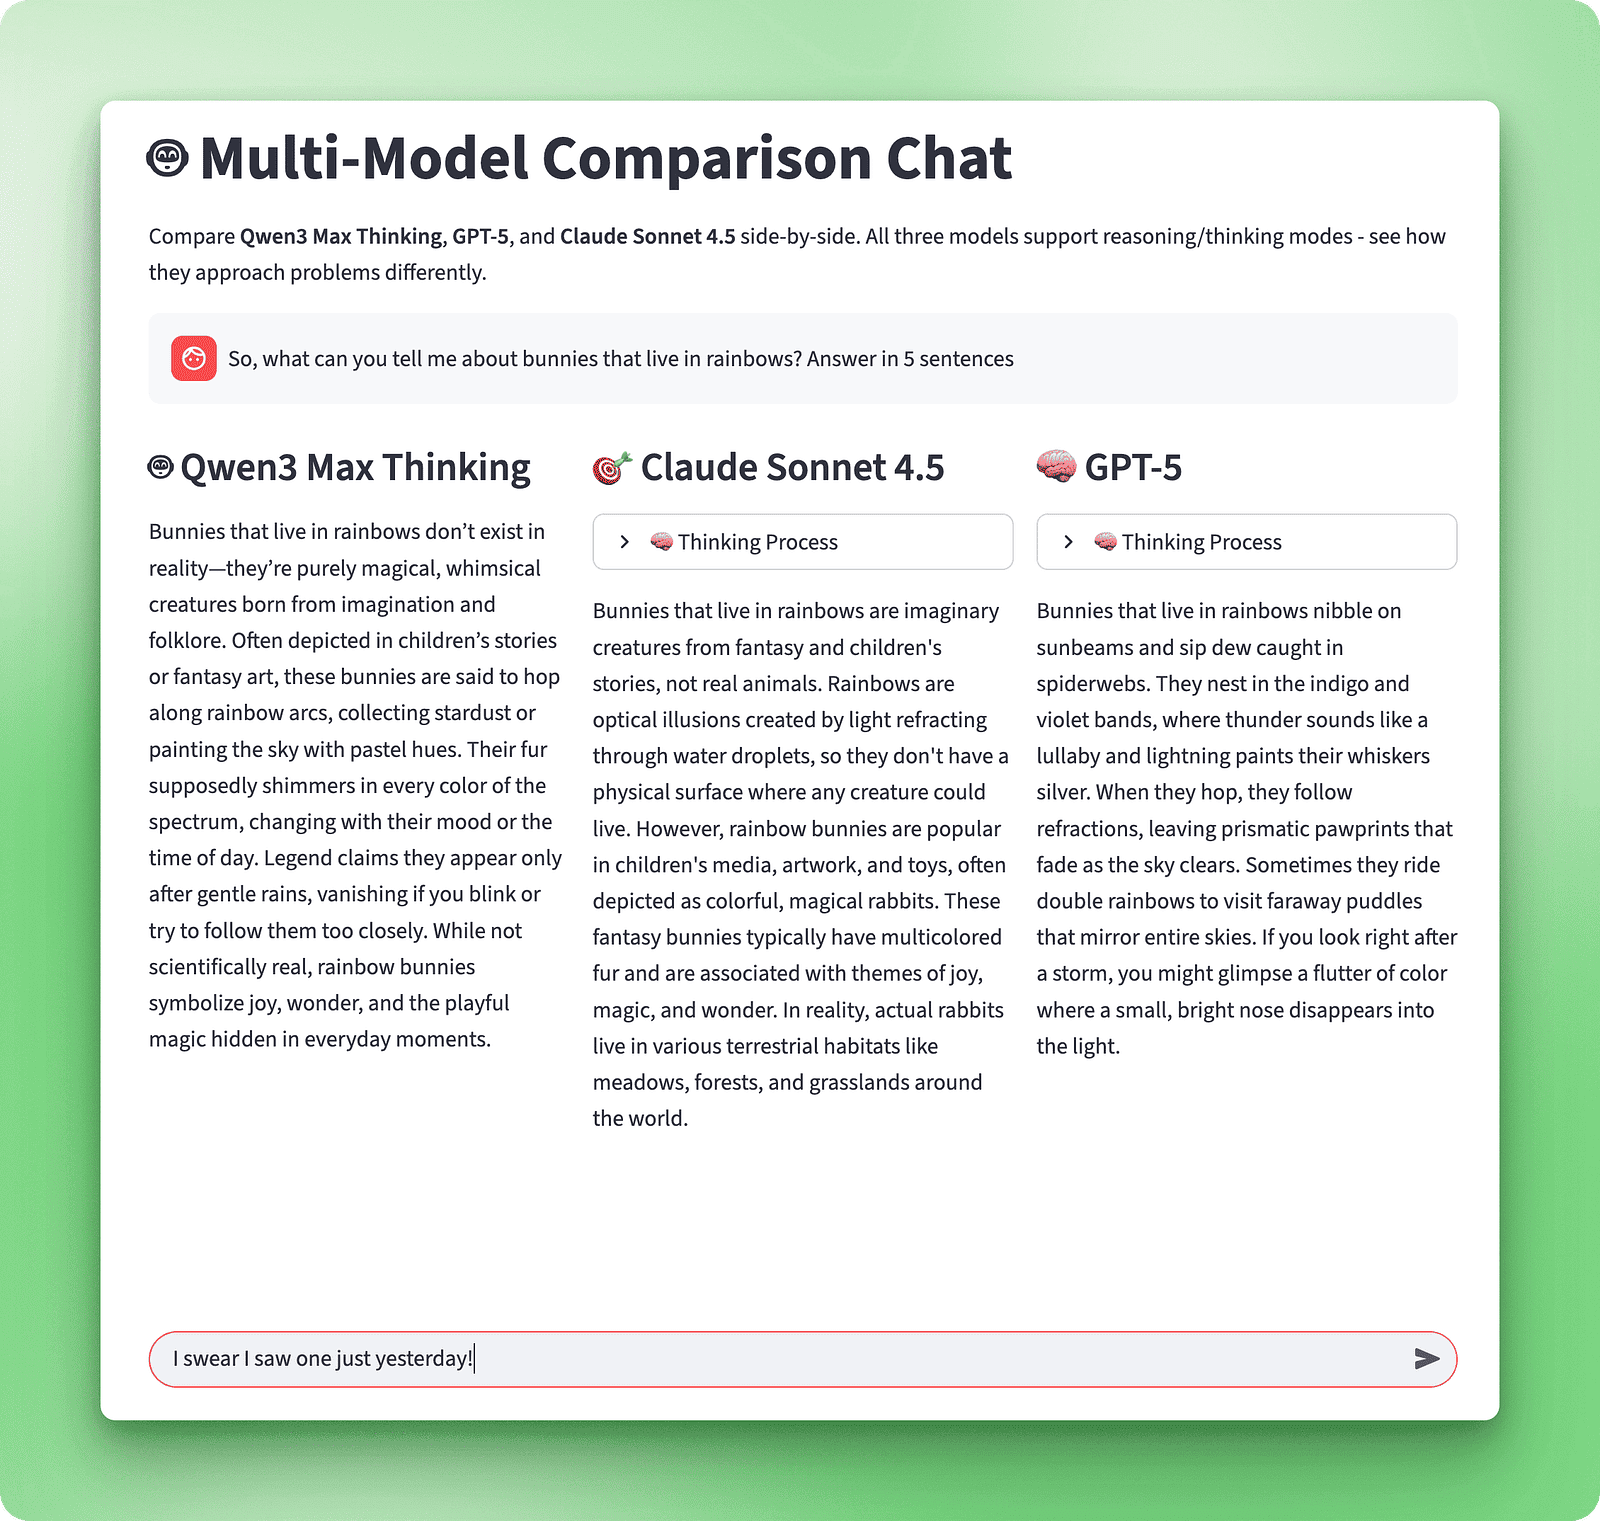
आप पूरा प्रोजेक्ट कोड इस GitHub Gist में देख सकते हैं।
ध्यान दें कि नीचे दिए गए खंड उस स्क्रिप्ट का विस्तृत ब्रेकडाउन प्रदान करते हैं, तो यदि आप केवल ऐप के परिणाम चाहते हैं, तो अगले खंड पर सीधे जाएँ। स्क्रिप्ट ब्रेकडाउन शैक्षिक उद्देश्यों के लिए है और दिखाता है कि Streamlit UI के साथ समान LLM‑आधारित अनुप्रयोगों की संरचना कैसे करें।
वेब इंटरफ़ेस के लिए Streamlit और Claude के लिए Anthropic का SDK इंस्टॉल करें। API सेटअप सेक्शन से आपके पास पहले से OpenAI SDK है।
pip install streamlit anthropicmodel_comparison_chat.py नामक नई फ़ाइल बनाएँ और इम्पोर्ट्स व पर्यावरण सेटअप जोड़ें:
import os
import time
from typing import Dict, List
from concurrent.futures import ThreadPoolExecutor, as_completed
from dotenv import load_dotenv
import streamlit as st
from openai import OpenAI
from anthropic import Anthropic

load_dotenv()आप सेक्शन 3 में Qwen3 सेट कर चुके हैं। अब अपने .env फ़ाइल में GPT-5 और Claude की API keys जोड़ें:
DASHSCOPE_API_KEY=your_alibaba_cloud_key
OPENAI_API_KEY=your_openai_key
ANTHROPIC_API_KEY=your_anthropic_key
GPT-5 एक्सेस और कीमत विवरण के लिए GPT-5 गाइड देखें। Claude Sonnet 4.5 के लिए Claude Sonnet 4.5 ओवरव्यू देखें।
तीनों API क्लाइंट्स इनिशियलाइज़ करें:
QWEN_CLIENT = OpenAI(
   api_key=os.getenv("DASHSCOPE_API_KEY"),
   base_url="https://dashscope-intl.aliyuncs.com/compatible-mode/v1"
)
GPT_CLIENT = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))
CLAUDE_CLIENT = Anthropic(api_key=os.getenv("ANTHROPIC_API_KEY"))प्रत्येक API के लिए अलग‑अलग फ़ंक्शन लिखने की बजाय, एक एकीकृत फ़ंक्शन उपयोग करें जो तीनों मॉडलों को संभालता हो। यहाँ Qwen3 के लिए फ़ंक्शन की शुरुआत है:
def call_model(model_name: str, messages: List[Dict], **kwargs) -> Dict:
   """Call any model with unified interface."""
   try:
       start_time = time.time()

       if model_name == "Qwen3 Max Thinking":
           enable_thinking = kwargs.get("enable_thinking", True)
           extra_body = {"enable_thinking": enable_thinking}

           completion = QWEN_CLIENT.chat.completions.create(
               model="qwen3-max-preview",
               messages=messages,
               extra_body=extra_body
           )
           reasoning_content = getattr(
               completion.choices[0].message,
               'reasoning_content',
               None
           )
           # Extract content and token info, then continue below
GPT-5 अलग तरह से काम करता है—यह responses API का उपयोग करता है और कॉन्फ़िगरेबल reasoning effort स्तर देता है (उसी फ़ंक्शन का जारी भाग):
       elif model_name == "GPT-5":
           reasoning_effort = kwargs.get("reasoning_effort", "medium")

           response = GPT_CLIENT.responses.create(
               model="gpt-5",
               input=messages,
               reasoning={
                   "effort": reasoning_effort,
                   "summary": "auto"
               }
           )
           # Extract response data, then continue below
GPT-5 में चार reasoning effort स्तर हैं: minimal, low, medium, और high। उच्च effort का अर्थ बेहतर गुणवत्ता है, पर प्रतिक्रिया धीमी और लागत अधिक होती है।
Claude Sonnet 4.5 का दृष्टिकोण अलग है (उसी फ़ंक्शन का जारी भाग):
       else:  # Claude Sonnet 4.5
           enable_thinking = kwargs.get("enable_thinking", True)
           params = {
               "model": "claude-sonnet-4-5",
               "max_tokens": 10000,
               "messages": messages
           }
           if enable_thinking:
               params["thinking"] = {
                   "type": "enabled",
                   "budget_tokens": 5000
               }

           message = CLAUDE_CLIENT.messages.create(**params)
# Parse thinking blocks from response, then continue belowनोट: Claude का thinking मोड Qwen3 से अलग काम करता है। अलग reasoning_content देने के बजाय, Claude प्रतिक्रिया सामग्री में thinking ब्लॉक्स शामिल करता है जिन्हें आपको अलग से पार्स करना होता है। यह मॉडलों की तुलना करते समय एक प्रमुख अंतर है।
तीनों मॉडल शाखाएँ अंत में एक ही संरचना लौटाती हैं (फ़ंक्शन का अंत):
    return {
               "content": content_text,
               "reasoning_content": thinking_text,
               "response_time": time.time() - start_time,
               "tokens_used": {
                   "input": input_tokens,
                   "output": output_tokens,
                   "total": total_tokens
               },
               "error": None
           }

   except Exception as e:
       return {
           "content": None,
           "reasoning_content": None,
           "response_time": 0,
           "tokens_used": {"input": 0, "output": 0, "total": 0},
           "error": f"{model_name} Error: {str(e)}"
       }
यह मानकीकृत रिटर्न फ़ॉर्मेट किसी भी मॉडल की प्रतिक्रियाओं को एक ही कोड से प्रदर्शित करना आसान बनाता है।
अब जब आप समझ गए हैं कि प्रत्येक मॉडल का API कैसे काम करता है, तो वेब इंटरफ़ेस बनाएँ। बेसिक Streamlit पेज कॉन्फ़िगरेशन से शुरू करें:
def main():
   st.set_page_config(
       page_title="Multi-Model Comparison Chat",
       page_icon="🤖",
       layout="wide",
       initial_sidebar_state="expanded"
   )

   st.session_state.setdefault("messages", [])
   st.session_state.setdefault("model_responses", [])
Session state उपयोगकर्ता इंटरैक्शन के बाद Streamlit के रीफ़्रेश पर भी बातचीत इतिहास और मॉडल प्रतिक्रियाओं को ट्रैक करता है।
शीर्षक और साइडबार कंट्रोल जोड़ें ताकि thinking मोड कॉन्फ़िगर हो सके:
st.title("🤖 Multi-Model Comparison Chat")
   st.markdown("""
   Compare **Qwen3 Max Thinking**, **GPT-5**, and **Claude Sonnet 4.5** side-by-side.
   All three models support reasoning modes - see how they approach problems differently.
   """)

   with st.sidebar:
       st.header("⚙️ Settings")

       st.subheader("Thinking Mode")
       qwen_thinking = st.checkbox("Enable Qwen3 Thinking", value=True)
       gpt5_reasoning = st.selectbox(
           "GPT-5 Reasoning Effort",
           options=["minimal", "low", "medium", "high"],
           index=2
       )
       claude_thinking = st.checkbox("Enable Claude Thinking", value=True)
API स्टेटस इंडिकेटर जोड़ें:
st.subheader("API Status")
       st.markdown(f"""
       - Qwen3: {"✅" if os.getenv("DASHSCOPE_API_KEY") else "❌"}
       - GPT-5: {"✅" if os.getenv("OPENAI_API_KEY") else "❌"}
       - Claude: {"✅" if os.getenv("ANTHROPIC_API_KEY") else "❌"}
       """)
यह दिखाता है कि कौन‑सी API keys कॉन्फ़िगर हैं। यदि लाल X दिखें, तो अपनी .env फ़ाइल जाँचें।
def call_models_parallel(messages: List[Dict], selected_models: List[str], qwen_thinking: bool, gpt5_reasoning: str, claude_thinking: bool) -> Dict[str, Dict]:
   """Call multiple models in parallel."""
   model_kwargs = {
       "Qwen3 Max Thinking": {"enable_thinking": qwen_thinking},
       "GPT-5": {"reasoning_effort": gpt5_reasoning},
       "Claude Sonnet 4.5": {"enable_thinking": claude_thinking}
   }

   with ThreadPoolExecutor(max_workers=3) as executor:
       futures = {
           executor.submit(call_model, m, messages, **model_kwargs[m]): m
           for m in selected_models if m in model_kwargs
       }
       return {futures[f]: f.result() for f in as_completed(futures)}
हर मॉडल की प्रतिक्रिया को क्रमवार इंतज़ार करने की बजाय, समानांतर निष्पादन तीनों को एक साथ कॉल करता है, जिससे कुल प्रतीक्षा समय कम होता है।
इसे अपने चैट इंटरफ़ेस में जोड़ें और प्रतिक्रियाएँ साथ‑साथ दिखाएँ:
if prompt := st.chat_input("Ask a question to all models..."):
       st.session_state.messages.append({"role": "user", "content": prompt})

       with st.spinner("🤔 Models are thinking..."):
           responses = call_models_parallel(
               st.session_state.messages,
               ["Qwen3 Max Thinking", "GPT-5", "Claude Sonnet 4.5"],
               qwen_thinking,
               gpt5_reasoning,
               claude_thinking
           )

       cols = st.columns(3)
       for idx, (model_name, response_data) in enumerate(responses.items()):
           with cols[idx]:
               st.markdown(f"### {model_name}")
               if response_data["reasoning_content"]:
                   with st.expander("🧠 Thinking Process", expanded=False):
                       st.markdown(response_data["reasoning_content"])
               st.markdown(response_data["content"])
यह तीन कॉलम बनाता है—प्रत्येक मॉडल के लिए एक। सोचने की प्रक्रिया डिफ़ॉल्ट रूप से समेटी रहती है ताकि उपयोगकर्ता अंतिम उत्तरों पर ध्यान दे सकें।
ऐप को इस कमांड से चलाएँ:
streamlit run model_comparison_chat.py“What is 2+2?” जैसे सरल sanity चेक प्रश्न से शुरू करें ताकि API कनेक्शन और समानांतर निष्पादन के काम करने की पुष्टि हो सके।
एक बार बेसिक फ़ंक्शनैलिटी की पुष्टि हो जाए, तो जटिल प्रॉम्प्ट्स के साथ मॉडल्स का परीक्षण करें ताकि उनके अलग‑अलग reasoning दृष्टिकोण सामने आएँ।
कंपैरिजन ऐप चलने के बाद, इसे कठिन समस्याओं से परखें। इन प्रॉम्प्ट्स को अपने ऐप में चलाकर देखें कि अलग‑अलग मॉडल उन्हें कैसे हल करते हैं।
यहाँ तीन प्रॉम्प्ट्स हैं जो दिखाते हैं कि प्रत्येक मॉडल कैसे सोचता है।
एक गोल पिज़्ज़ा को 8 बराबर स्लाइस में काटा जाता है। Alice 3 स्लाइस खाती है, फिर Bob बची हुई का आधा खा लेता है। फिर Charlie 1 स्लाइस लेता है, और अंत में Dana शेष स्लाइस का 40% खा लेती है। कितने स्लाइस बचे? साथ ही, यदि मूल पिज़्ज़ा का डायमीटर 16 इंच था, तो खाए गए पिज़्ज़ा का कुल क्षेत्रफल (वर्ग इंच में) कितना है?
पाँच दोस्त—Amy, Ben, Clara, David, और Emma—एक पंक्ति में
सिनेमा हॉल में बैठे हैं। निम्नलिखित शर्तें पूरी होनी चाहिए:
1. Amy को Ben के पास बैठना होगा
2. Clara, David के बगल में नहीं बैठ सकती
3. Emma को किसी एक छोर पर बैठना होगा
4. Ben किसी भी छोर पर नहीं बैठ सकता। इन बाधाओं को ध्यान में रखकर, बाएँ से दाएँ सभी संभावित बैठने की व्यवस्थाएँ सूचीबद्ध करें।
एक Python फ़ंक्शन लिखें जो दी गई स्ट्रिंग में सबसे लंबा palindromic substring ढूँढे, लेकिन इन विशिष्ट आवश्यकताओं के साथ:
1. समय जटिलता O(n²) या बेहतर होनी चाहिए
2. Unicode अक्षरों को सही तरीके से संभाले
3. यदि समान लंबाई के कई palindrome हों, तो पहला आने वाला लौटाएँ
4. विस्तृत docstring उदाहरणों सहित दें
5. टाइप हिंट्स जोड़ें
6. किनारी मामलों (खाली स्ट्रिंग, एकल अक्षर, कोई palindrome नहीं) को संभालें।
साथ ही अपने एल्गोरिद्म चयन की व्याख्या करें
और यह क्यों जटिलता आवश्यकता को पूरा करता है।
तीनों मॉडलों ने हर समस्या सही हल की। उनका प्रदर्शन इस प्रकार रहा:
|
टेस्ट |
मॉडल |
समय (सेकंड) |
टोकन |
परिणाम |
|
पिज़्ज़ा समस्या |
Qwen3-Max-Thinking |
157 |
4,419 |
✓ सही (0.9 स्लाइस, 178.44 वर्ग इंच) |
|
GPT-5 |
45 |
1,490 |
✓ सही (0.9 स्लाइस, 178.44 वर्ग इंच) |
|
|
Claude |
14 |
1,010 |
✓ सही (0.9 स्लाइस, 178.44 वर्ग इंच) |
|
|
थिएटर सीटिंग |
Qwen3-Max-Thinking |
166 |
5,728 |
✓ सभी 8 व्यवस्थाएँ मिलीं |
|
GPT-5 |
83 |
4,607 |
✓ सभी 8 व्यवस्थाएँ मिलीं |
|
|
Claude |
32 |
3,081 |
✓ सभी 8 व्यवस्थाएँ मिलीं |
|
|
Palindrome कोड |
Qwen3-Max-Thinking |
191 |
7,345 |
✓ कार्यशील O(n²) समाधान |
|
GPT-5 |
58 |
3,263 |
✓ कार्यशील O(n²) समाधान |
|
|
Claude |
48 |
3,279 |
✓ कार्यशील O(n²) समाधान |
Qwen3, Claude से 10 गुना अधिक समय लेता है और 3–4 गुना अधिक टोकन उपयोग करता है।
यह सब कुछ विचार में लेता है। पिज़्ज़ा समस्या पर, इसने सोचा कि क्या भिन्नात्मक स्लाइस मायने रखते हैं, क्या गणना को पूर्ण संख्याओं तक गोल करना चाहिए, कई बार गणनाओं की पुष्टि की, और उत्तर तय करने से पहले वैकल्पिक व्याख्याएँ भी जाँचीं।
पूरी प्रक्रिया में आप इसे “अगर ऐसा हो तो” और “पर शायद वैसा” सोचते देखेंगे। सीटिंग समस्या के लिए, इसने हर संभावना के लिए “यदि Ben यहाँ बैठे तो Amy कहाँ जा सकती है” के आधार पर काम किया।
Palindrome समाधान ने विकल्पों के ऊपर चुने गए एल्गोरिद्म का गहन विश्लेषण दिया, Unicode किनारी मामलों को कैसे संभालता है, और जटिलता का विस्तृत विश्लेषण। यह ऐसा है जैसे कोई ज़ोर से सोच रहा हो और बार‑बार अपना काम जाँच रहा हो।
यह संरचित और विधिवत है। इसने प्रत्येक समस्या को क्रम से रखा, चरणों में काम किया, और परिणामों को सत्यापित किया। कम अन्वेषण, अधिक निष्पादन।
सीटिंग पहेली में, इसने पहले Emma को किसी छोर पर बैठाया, फिर नियम जाँचते हुए स्थान भरे।
Palindrome कोड में एल्गोरिद्म चयन पर स्पष्ट तर्क और ठोस डॉक्युमेंटेशन था। यह बिना ज़्यादा पीछे मुड़े योजना का पालन करता है। आपको सोच का पर्याप्त विवरण मिलता है, लेकिन यह लगातार खुद पर संदेह नहीं करता।
यह तेज़ी से चलता है। यह समाधान पथ को जल्दी पहचानता है और साफ़‑सुथरे ढंग से निष्पादित करता है। सीटिंग समस्या के लिए, इसने मामलों के आधार पर (Emma पोज़ीशन 1 बनाम 5) व्यवस्थित किया और प्रत्येक पर काम किया। Palindrome कोड साफ़ और अच्छी तरह प्रलेखित था, लेकिन अधिक सीधे बिंदु पर पहुँचा। यह अपना काम दिखाता है पर ज़्यादा नहीं ठहरता—सोच दिखती है पर संक्षिप्त होती है।
व्यावहारिक निष्कर्ष: Qwen3 का उपयोग तब करें जब आपको समाधान में गई हर बात देखनी हो। विस्तृत thinking सीखने या जटिल निर्णयों के सत्यापन में मदद करती है। गति मायने रखे और हर चरण देखना ज़रूरी न हो तो Claude उपयोग करें। दोनों के बीच संतुलन चाहिए तो GPT-5 चुनें।
नोट: ये परीक्षण तीनों मॉडलों की क्षमताओं को पूरी तरह नहीं दर्शाते। अलग प्रॉम्प्ट्स के साथ आपके परिणाम भिन्न हो सकते हैं।
इस ट्यूटोरियल में, मैंने Qwen3 Max Thinking सेटअप करना दिखाया, उसके thinking मोड को अलग‑अलग प्रकार की समस्याओं पर परखा, और एक कंपैरिजन ऐप बनाया जो Qwen3, GPT-5, और Claude Sonnet 4.5 पर प्रॉम्प्ट्स को साथ‑साथ चलाता है।
मुख्य बात यह है कि हर मॉडल की अपनी‑अपनी ताकतें हैं। जब आपको विस्तृत reasoning और हर चरण समझना हो, Qwen3 उत्कृष्ट है। गति और साफ़ निष्पादन में Claude आगे है। GPT-5 दोनों दृष्टिकोणों का संतुलन बनाता है।
अपने कंपैरिजन ऐप का उपयोग करें और इन मॉडलों को अपनी समस्याओं पर परखें। जैसे‑जैसे आप अलग‑अलग कार्यों के साथ प्रयोग करेंगे, आपको यह समझ विकसित होगी कि आपकी आवश्यकताओं के लिए कौन सा मॉडल सबसे अच्छा काम करता है।
Qwen3 और मल्टी‑मॉडल डेवलपमेंट में और गहराई से जाने के लिए, कई मॉडल APIs को प्रबंधित करने हेतु OpenRouter ट्यूटोरियल देखें, या यह सीखें कि छोटे Qwen3 मॉडल्स को Ollama के साथ लोकली कैसे चलाएँ ताकि ऑफ़लाइन डेवलपमेंट कर सकें।
शीर्ष DataCamp पाठ्यक्रम
लर्निंग पाथ
कोर्स
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें