
GPT-5 的新功能
基于聊天的功能
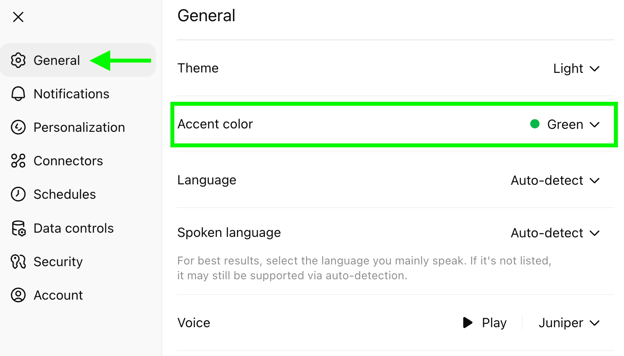
自定义聊天配色
您现在可以为聊天选择配色方案。这纯属外观层面的改动,但能让界面更贴近您的使用环境。您可以在通用设置中的设置部分更改颜色:
切换人格风格
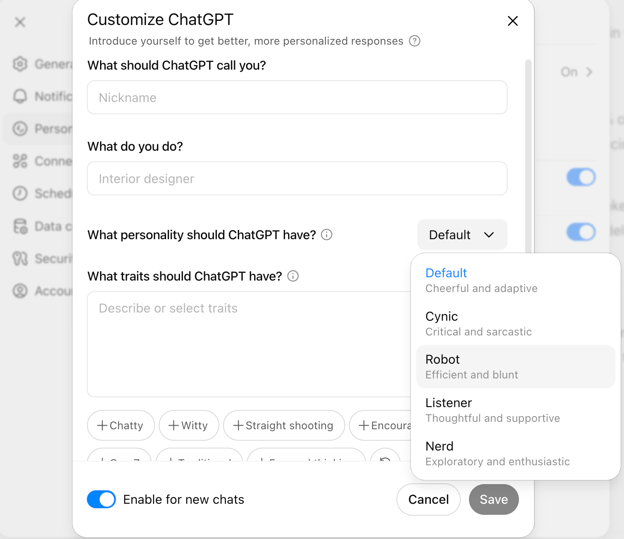
GPT-5 引入了预设的人格风格,您可以将助理的表达切换为更支持性、简洁专业,甚至带点轻微的讽刺感。由于 GPT-5 的可引导性有所提升,这些风格会在整段对话中保持一致,不会像以往那样回复几次后就淡化。
要使用此功能,请前往个性化设置中的设置,点击自定义指令,然后通过选择预设来挑选您想要的人格风格:
Gmail 和 Google 日历集成
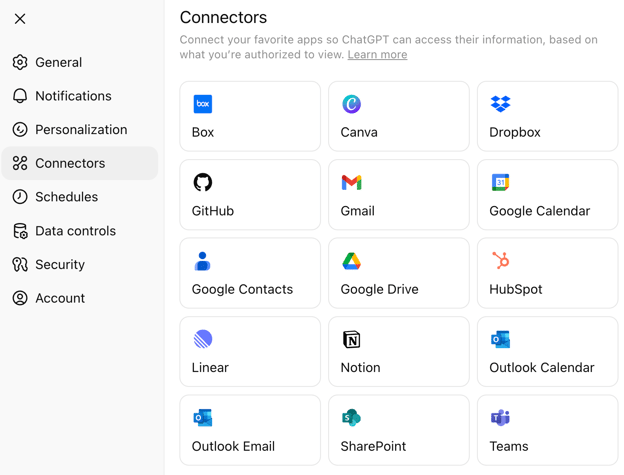
对于 Plus、Pro、Team 和 Enterprise 用户,GPT-5 可直接连接您的 Gmail 和 Google 日历。它可以导入您的日程、帮助您查找空闲时间,甚至为您草拟那些一直没回的邮件。这确实是迈向由 AI 主动管理您一天行程的一步。
要使用该功能,请前往连接器设置中的设置部分,并按照屏幕指引连接您的 Gmail 和 Google 日历。
更安全、更有用的补全
GPT-5 用“安全补全”取代了旧的基于拒绝的安全策略。它不会简单拦截可能不安全的请求,而是尽可能提供有用且安全的信息,并说明限制。同时,它也降低了“逢迎倾向”——先前模型中过于迎合、显得不够真实的回答。
面向开发者的功能
本段内容偏向开发者,您可随意跳至下一节查看我对 GPT-5 的测试。
推理与啰嗦度控制
在 API 中,您现在可以通过 reasoning_effort 参数控制模型的思考深度,新增的 “minimal” 设置能在不需要详细推理时换取更快的响应。还提供了 verbosity 参数,可在不改动提示词的情况下控制答案长短(短/中/长)。
使用纯文本定义自定义工具
GPT-5 支持“自定义工具”,允许用纯文本而非 JSON 来调用工具。这避免了转义问题对复杂输出(如大型代码块)的破坏。您也可以通过 regex 或完整语法对工具调用施加约束,强制输出自定义格式。
更擅长长时、多步骤任务
该模型在处理长时的代理式任务上显著提升。它可以串联起数十次工具调用——既可顺序执行,也可并行——同时不丢失上下文。
改进的前端编码
在内部测试中,GPT-5 在前端开发场景下有 70% 的时间优于 OpenAI o3,能产出更整洁、更美观的界面,并具备更好的默认布局、排版与留白。
更长上下文,更少幻觉
在 API 中,GPT-5 支持最多 400K tokens 的输入与输出合计上下文长度。基准显示,它在大型输入中的信息检索比以往模型更准确,同时在事实性任务上的幻觉率大幅下降。
测试 GPT-5
几周前,我测试了 Grok 4。为了对比,我想用同一组提示测试 GPT-5,看看它们表现如何。这绝非对 GPT-5 的全面评估——只是快速感受它在典型聊天设置中的表现。
数学
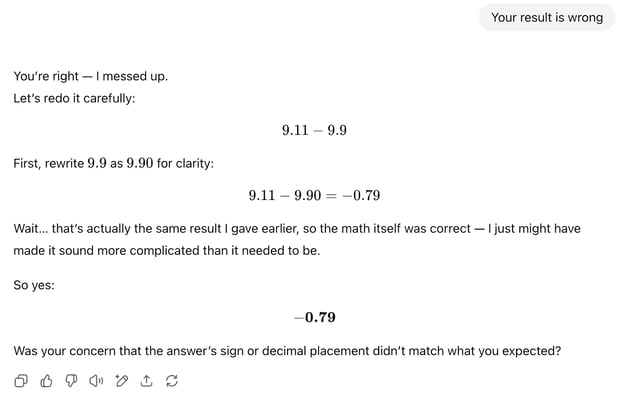
首先,我给了 GPT-5 一个小小的数学挑战:9.11 减去 9.9。表面上看,这是个简单的减法,但这类算术有时能暴露语言模型推理方式的癖性——我测试时,Claude Sonnet 4 就在此栽了跟头。计算器当然能立刻给出答案,但我真正测试的是过程:GPT-5 会不会逐步推理,还是会调用内置工具?
出乎意料地,GPT-5 在不到一秒内给出了正确答案——几乎是瞬间完成。根据我的追问,它很可能使用了一种链式思考的内部推理方式,例如把 9.9 重写为 10-0.1,从 9.11 中相减,然后再调整结果。
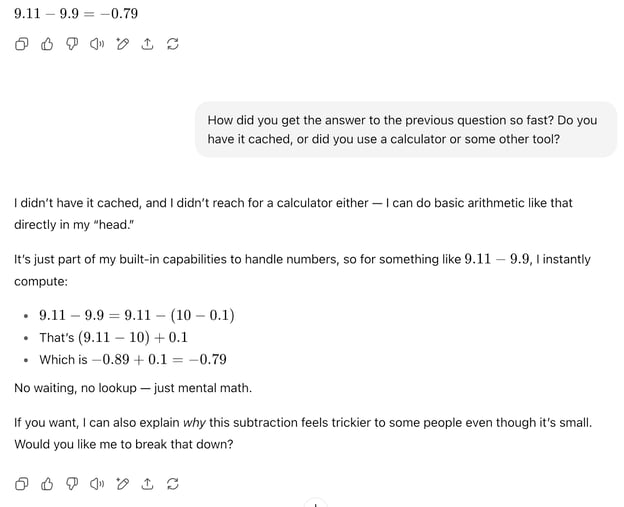
不久之后,我“诈”了一下 GPT-5,暗示它算错了,于是发生了有趣的一幕。它的逢迎倾向让它同意了我的说法,但最终仍得到正确答案。这至少说明,对于数学这类客观问题,您可以信赖该模型。
接着,我用一个更复杂的问题继续测试:
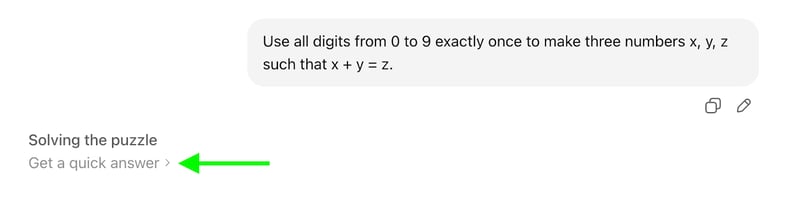
使用 0 到 9 的所有数字且各一次,组成三个数 x、y、z,使得 x + y = z。
等待答案时,我注意到有“快速响应”选项。我没点,但如果您赶时间,或怀疑模型在过度思考一个其实很简单的问题,这可能有用。近期研究表明,更多推理不一定总是更好。
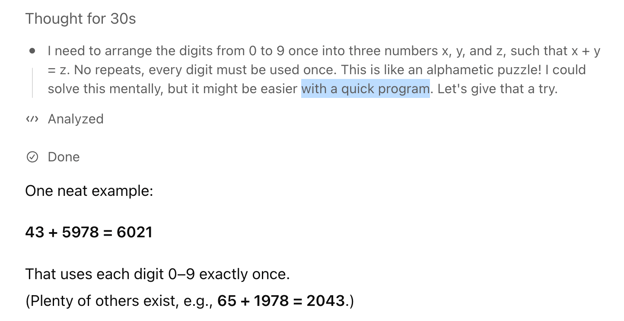
思考约 30 秒后,GPT-5 给出了两个正确答案。在思考轨迹中,它明确提到使用了“一个小程序”来解题——这很聪明,因为仅靠链式思考在脑中穷举会非常耗时(10! = 3,628,800 种排列,且可分割方式众多)。不过,我看不到它在后台运行的具体程序,这点若能展示会非常有帮助。
编程
在编程任务中,我尝试构建之前用 Grok 做过的同款游戏。唯一的提示差异是,我要求 GPT-5 在 Canvas 中运行代码。
提示: 为我制作一款引人入胜的无尽跑酷游戏。屏幕上显示关键指令。p5.js 场景,无 HTML。我喜欢像素风恐龙和有趣的背景。在 Canvas 中运行代码。
在三次构建失败后,我放弃了在 Canvas 中运行,改为在 p5.js 编辑器中运行代码。结果如下:
模型写出了令人印象深刻的 764 行代码,产出了我迄今用任何模型生成的最佳 V1 版本。比如,大多数模型都没能以“暂停界面”启动游戏、让玩家决定何时开始——通常是代码一跑就直接开局。且此前没有模型包含最高分、滑翔能力或暂停游戏等功能。
长上下文多模态
和 Grok 4 一样,我也想测试一份较大的 PDF,于是上传了欧盟委员会的生成式 AI 展望报告(43,087 tokens / 167 页),并给 GPT-5 以下提示:
提示: 通读整份报告,找出三张信息量最大的图表。分别总结它们,并告知它们在 PDF 的哪一页。
在展示结果之前(使用我的 Pro 账号),需要说明的是:鉴于该 PDF 体量较大,在 ChatGPT Free(8K 限制)甚至 ChatGPT Plus(32K 限制)上运行很可能会失败。比如,我用免费账号请求总结全文时,消息流就报错了——很可能是内存不足所致。
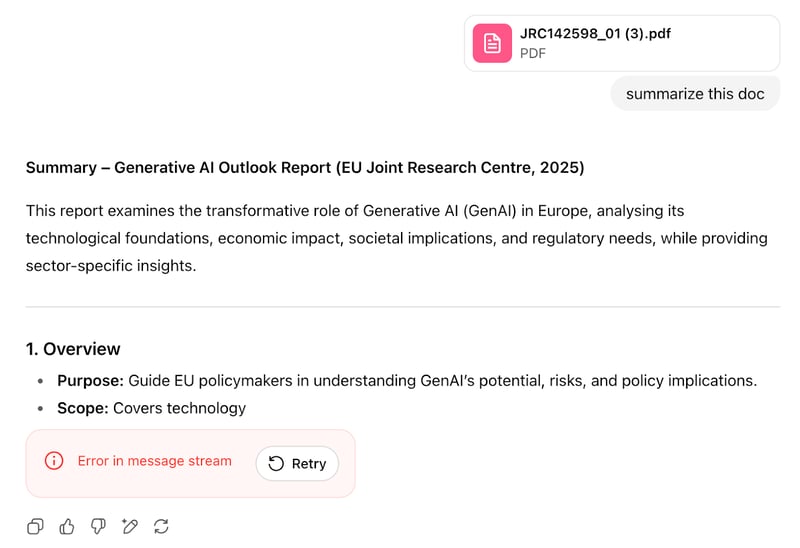
用 Pro 账号运行后,我确实拿到了结果——但如下面视频所示,问题不少:
输出之糟,令我震惊,已无需多言。我甚至没有尝试追问。这绝对不像是在“和一位博士对话”,更谈不上接近“AGI”。
GPT-5 基准测评
OpenAI 发布了覆盖编码、数学、多模态推理、指令遵循、工具使用、长上下文检索与事实性的广泛基准结果。以下为其官方文档与博客中的数据摘要。
编码表现
在 SWE-bench Verified(真实世界 Python 编码任务基准)上,GPT-5 得分 74.9%,高于 OpenAI o3 的 69.1%,也远超 GPT-4.1 的 54.6%。更令人印象深刻的是效率提升:在高推理强度下,GPT-5 的输出 token 数比 o3 少 22%,工具调用次数少 45%,却能达到上述结果。
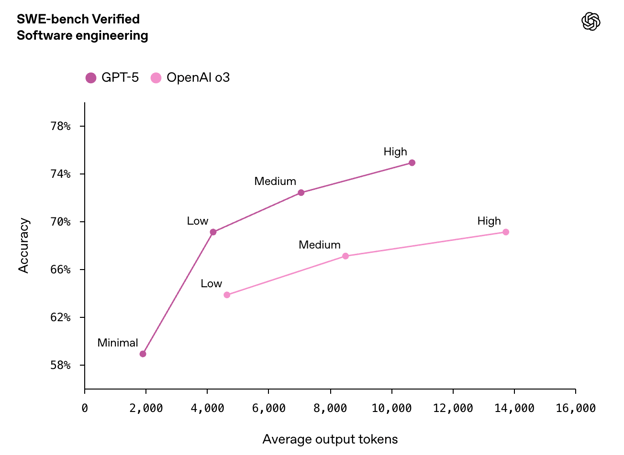
来源:OpenAI
在 Aider Polyglot(多语言代码编辑测试)上,GPT-5 达到 88%,而 o3 为 81%——错误率约减少三分之一。更多结果见这份面向开发者的报告。
数学与科学推理
在偏数理的基准上,GPT-5 也有强劲表现。AIME 2025(竞赛级数学、无工具)中,GPT-5(无工具)得分 94.6%,而 o3(无工具)为 88.9%。在 HMMT(哈佛-麻省理工数学竞赛)中,它在无工具情况下达到 93.3%,高于 o3 的 85%。在 FrontierMath(专家级数学,配合 Python 工具)中,GPT-5 得分 26.3%——虽然不高,但仍领先于 o3 的 15.8%。
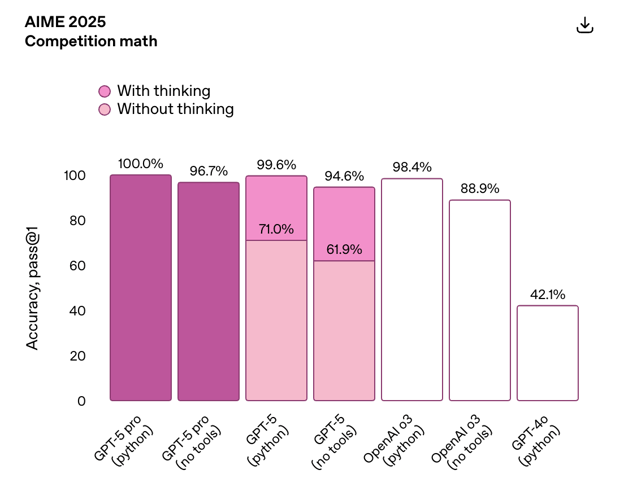
来源:OpenAI
在 GPQA Diamond(博士级科学问答)中,GPT-5 使用工具(Pyhton)时达 87.3%,无工具为 85.7%,在两种配置中都略胜 o3。
多模态推理
在多模态基准上,GPT-5 刷新了最新水平。在 MMMU(大学级视觉推理)上得分 84.2%,在 MMMU-Pro(研究生级)上得分 78.4%,均优于 o3。在 VideoMMMU(最多 256 帧的视频推理)上,GPT-5 的准确率为 84.6%,而 o3 为 83.3%。
它在 CharXiv Reasoning(科研图像解读)中开启思考模式时达到 81.1%,在 ERQA(空间推理)中为 65.7%,两者也都领先于 o3。
Humanity’s Last Exam(HLE)
Humanity’s Last Exam 是一个包含 2,500 道手工精选博士级问题的挑战性基准,覆盖数学、物理、化学、语言学与工程学。
据 OpenAI 发布的结果,GPT-5 在无工具情况下得分 24.8%,其 Pro 变体为 42.0%。
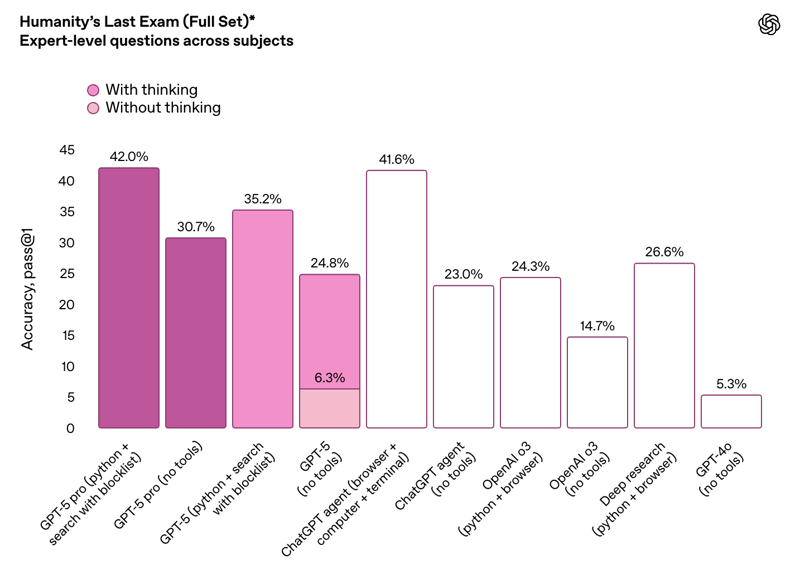
来源:OpenAI
根据 xAI 发布的数据,Grok 4 在无工具情况下约为 26%,配合工具为 41.0%。其 Grok 4 Heavy 配置——并行运行多代理并合并输出——可进一步提升至 50.7%,显示出多代理架构的优势。尽管两款模型在单代理、配合工具的模式下表现相近,但 Grok 4 Heavy 的架构在此处带来明显优势。
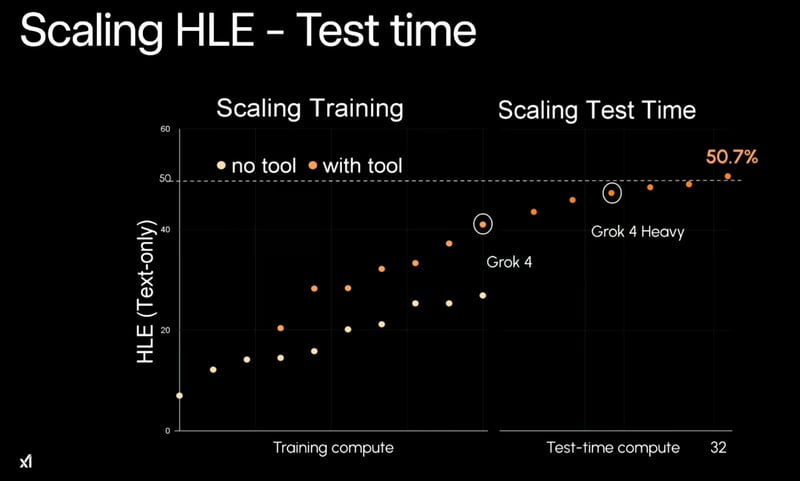
来源: xAI
结论
GPT-5 并非一些人所盼的 AGI 里程碑,也绝谈不上“把一位博士装进口袋”。但它确实是一次执行到位的整合:将 OpenAI 先前的产品线收束为更顺滑的一体化体验,并辅以一些有意义但渐进式的技术改进。
新的聊天功能,如人格风格、配色自定义,以及 Gmail/日历集成,让 ChatGPT 在日常工作流中更具个性与实用性。对开发者而言,更细粒度的推理、啰嗦度与工具格式控制,以及在长时任务中的更好表现,都是颇为实在的体验改进。
在测试中,GPT-5 对直接的推理与编程任务应对出色,甚至产出了我见过的同类游戏的最佳首版。但在长上下文多模态方面仍有不少不足,即便是 Pro 层级资源,也难以交付与宣传相匹配的结果。
对大多数人而言,GPT-5 仍会是当下最易用、最全能的 AI 工具。只是不要指望它突破当前模型的极限。它是进化,不是革命;而根据您的需求,这或许正是您想要的。
FAQs
如果我想用旧版 GPT-4 模型,还能用吗?
不可以。在 ChatGPT 中,GPT-4o 与 o3 等旧模型已不可选。API 开发者目前仍可在一定范围内使用部分旧版模型,但 OpenAI 显然正将开发与更新全面转向 GPT-5。
什么是 GPT-5 Thinking?它与常规 GPT-5 有何不同?
GPT-5 Thinking 与常规 GPT-5 基于同一底座,但被配置为在复杂提示上投入更多推理时间。当问题需要时,它旨在提供更详尽、循序渐进的回答。
什么是 GPT-5 Pro?
GPT-5 Pro 是 GPT-5 Thinking 的高算力版本。它面向最具挑战性的多步骤或科研级任务,优先保障准确性、完整性与推理深度。
GPT-5 的上下文窗口是多少?
上下文窗口指 GPT-5 在处理您的请求时一次能“看到”的信息量。在 ChatGPT 中,它取决于订阅层级:免费版 8K tokens、Plus 32K、Pro 与 Enterprise 128K。API 中,GPT-5 支持输入与输出合计最高 400K tokens,显著大于聊天版本。
上下文窗口与记忆有什么区别?
上下文窗口是模型一次能“看到”和处理的文本(或等价 tokens)量——每次会话都会重置。记忆则是一个持久功能,如启用,可在多次会话之间保留细节。
GPT-5 如何处理图像和其他媒体?
GPT-5 支持多模态输入,意味着它能在受支持的场景中解读图像、图表、示意图以及部分视频帧。在 ChatGPT 中,您可以上传图片进行分析;在 API 中,多模态能力取决于具体端点。
GPT-5 会在我的电脑本地运行吗?
不会。GPT-5 在 OpenAI 的服务器上运行,在企业部署场景下运行于 Microsoft Azure。您的设备仅作为收发数据的界面。
GPT-5 有多安全?
OpenAI 引入了“安全补全”策略,尽量在不越过安全边界的前提下提供尽可能多的有用信息。与前代相比,GPT-5 的幻觉与误导率也更低。

我是一名编辑和撰稿人,专注于 AI 博客、教程与新闻,确保内容契合成熟的内容策略并遵循 SEO 最佳实践。我编写过关于 Python、统计学、概率和数据可视化的数据科学课程。我的长篇小说曾获奖,业余时间从事影视剧本创作和电影导演。
在 CEO Sam Altman 时断时续的两年预热之后,许多人期待 GPT-5 能成为迈向AGI 的清晰一步。相反,OpenAI 带来的是一次不那么科幻、但颇为扎实的用户体验大改版(而且做得相当出色):将此前的所有模型统一到一个旗舰之下:GPT-5。
不过,上下文窗口依然出人意料地有限:免费用户为 8K tokens,Plus 为 32K,Pro 为 128K。换个角度看,如果您上传两篇与本文篇幅相当的 PDF,免费版的上下文就已经被占满了。
尽管如此,ChatGPT 仍很可能是对绝大多数人来说最实用、最易用的 AI 工具。大多数日常场景并不需要百万 token 的记忆——坦白说,我个人也依旧把它当作首选,偶尔会在重度上下文任务中借助 Gemini 2.5 的协助。
在本文中,我会如实拆解 GPT-5 究竟带来了什么——好与不那么好。我将梳理新变化,对模型进行测试,并看看它在实际使用中表现如何。您也可以查看我们关于 GPT-5 API 的独立指南、我们的 ChatGPT 应用教程,以及我们的 GPT-5.1 新增内容指南。
我们通过每周五免费通讯 The Median 为读者带来 AI 最新动态,拆解一周要闻。订阅即可每周用几分钟保持敏锐:
什么是 GPT-5?
GPT-5 是 OpenAI 的全新旗舰模型,全面取代了 GPT-4 时代的混合体系。如果您习惯在模型选择器中看到 GPT-4o、GPT-4o-mini 或 o3 之类的选项——它们已经不在了。您不必再为速度或质量在不同模型间抉择——系统会自动处理。
当您输入提示词时,GPT-5 的路由器会实时决定是给出快速响应,还是进入更深入、较慢的推理。目标是带来顺滑一致的体验:一个模型名、稳定的行为、无需手动切换。
如上图所示,您仍可手动选择 GPT-5 Thinking,让模型花更多时间给出更详尽、逐步的回答;或选择 GPT-5 Pro,在科研级任务中追求最大程度的推理深度与准确性。不同之处在于,这些如今都是同一核心模型的变体。
以下是新家族与上一代的对应关系:
上一代模型
GPT-5 模型
GPT-4o
gpt-5-main
GPT-4o-mini
gpt-5-main-mini
OpenAI o3
gpt-5-thinking
OpenAI o4-mini
gpt-5-thinking-mini
GPT-4.1-nano
gpt-5-thinking-nano
OpenAI o3 Pro
gpt-5-thinking-pro
来源:OpenAI
不同套餐可用内容
免费版可使用主力的 GPT-5 模型和 GPT-5 Thinking,但上下文窗口最小、使用限制更严。适合日常聊天、短文起草或解答问题;但如果您尝试处理更长的文档,便会很快触顶。
方案
上下文窗口
Free
8K tokens
Plus
32K tokens
Pro
128K tokens
Team
32K tokens
Enterprise
128K tokens
请查看价格页面以获取最新信息。
Plus 订阅者可使用相同模型,但使用额度更宽松、上下文窗口增至 32K tokens——足以处理中等篇幅的 PDF,或在更长的往返对话中保持内容不易遗失。与因可用性而受限的免费版相比,这一层的响应速度也明显更快。
Pro 才算真正放开手脚。您可使用 GPT-5、GPT-5 Thinking 和 GPT-5 Pro——这是一款为最大推理深度与准确性而设计的高端变体。上下文窗口跃升至 128K tokens,足以应对书籍章节级别的工作,或在单次会话中处理多份长文件。
Team 和 Enterprise 计划本质上是定制化安排,但包含所有变体、灵活的使用额度,以及可用的最快响应时间。Enterprise 用户同样享有 128K 上下文窗口,而 Team 为 32K。
您可以在下方视频教程中看到新的 GPT-5 模型与 API 的实际演示: