在 SQL 的世界里,将多条查询的结果合并是一项基本需求,而 SQL 提供了强大的 UNION 和 UNION ALL 等函数来实现这一点。
正如您将看到的,理解 SQL 中 UNION 与 UNION ALL 之间的细微差别,对于高效的数据查询与管理至关重要。本教程将借助配套数据集,解释它们的关键相似点、差异以及使用场景,帮助您优化 SQL 查询。
简要结论:SQL UNION vs. UNION ALL
关键区别在于,UNION 会去除重复记录,而 UNION ALL 会保留所有重复。这不仅会影响结果集中行的数量,也会影响性能。
| 功能 | UNION | UNION ALL |
|---|
| 重复项 | 去除重复记录 | 保留所有记录(包括重复) |
| 性能 | 较慢(需排序/哈希以查找重复) | 较快(直接将数据追加到结果) |
| 操作性质 | 集合论(数学并集) | 结果追加/堆叠 |
我们来看两个示例表,employees_2023 与 employees_2024,分别表示两个年度的员工记录。
SELECT *
FROM employees_2023技术支持
|
employee_id
|
name
|
department
|
|
1
|
Alice
|
HR
|
|
2
|
Bob
|
IT
|
|
3
|
Charlie
|
Finance
|
SELECT *
FROM employees_2024技术支持
|
employee_id
|
name
|
department
|
|
2
|
Bob
|
IT
|
|
3
|
Charlie
|
Finance
|
|
4
|
David
|
Marketing
|
现在,让我们使用 UNION 将两张表连接起来。
SELECT employee_id, name, department FROM employees_2023
UNION
SELECT employee_id, name, department FROM employees_2024;技术支持
|
employee_id
|
name
|
department
|
|
1
|
Alice
|
HR
|
|
2
|
Bob
|
IT
|
|
3
|
Charlie
|
Finance
|
|
4
|
David
|
Marketing
|
在该结果中,重复记录已被去除。现在,我们将其与使用 UNION ALL 得到的结果进行对比。
SELECT employee_id, name, department FROM employees_2023
UNION ALL
SELECT employee_id, name, department FROM employees_2024;技术支持
|
employee_id
|
name
|
department
|
|
1
|
Alive
|
HR
|
|
2
|
Bob
|
IT
|
|
3
|
Charlie
|
Finance
|
|
2
|
Bob
|
IT
|
|
3
|
Charlie
|
Finance
|
|
4
|
David
|
Marketing
|
在该结果中,包含了所有记录,未对重复项进行去重。
SQL 中的 UNION 是什么?
UNION 会将两条或多条 SELECT 查询的结果合并为一个结果集,并去除重复行。每条 UNION 中的 SELECT 语句必须具有相同的列数、相近的数据类型,且列的顺序一致。为便于理解,我们先创建下面两个示例表。
CREATE TABLE sales_team (
    employee_id INT,
    employee_name VARCHAR(50)
);
INSERT INTO sales_team (employee_id, employee_name) VALUES
(1, 'Alice'),
(2, 'Bob'),
(3, 'Charlie');
CREATE TABLE support_team (
employee_id INT,
employee_name VARCHAR(50)
 );
INSERT INTO support_team (employee_id, employee_name) VALUES
(3, 'Charlie'),
(4, 'David'),
(5, 'Eve');技术支持
上述代码将分别创建本教程中要使用的两张表:sales_team 与 support_team。您可以使用下面的代码查看这些表。
SELECT *
FROM sales_team技术支持
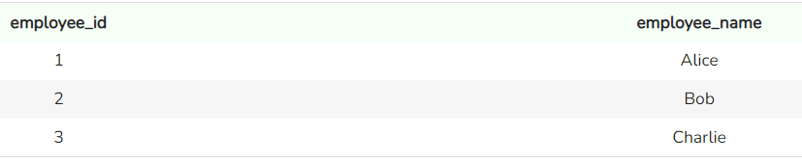
sales_team 表中的记录。图片由作者提供
SELECT *
FROM support_team技术支持
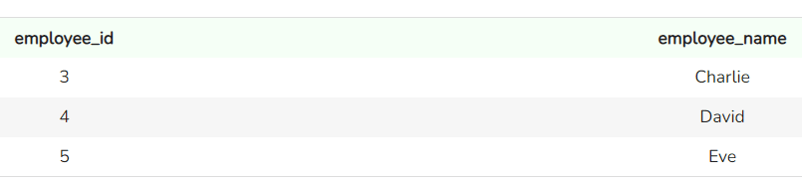
support_team 表中的记录。图片由作者提供
这两张小表各包含三条记录,列名一目了然。现在我们已经创建了两张表,来应用一下 UNION 函数。
SELECT employee_id, employee_name
    FROM sales_team
   UNION
SELECT employee_id, employee_name
    FROM support_team;技术支持
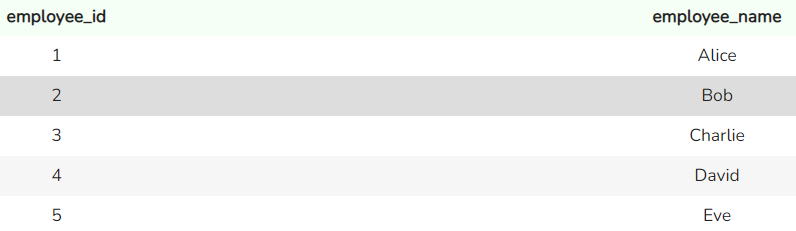
UNION 函数的输出。图片由作者提供
可以看到,值为 3 的 employee_id 的重复条目被去除了。
UNION 在 SQL 中的使用场景有哪些?
以下是 UNION 的一些常见用法。
-
合并不同表的结果:当您希望合并多张表并确保没有重复记录时,UNION 是首选。
-
处理不同数据源:在合并来自不同数据源的表时,UNION 很有用。
-
跨查询去重:当您需要确保合并结果集的唯一性时,使用 UNION。
SQL 中的 UNION ALL 是什么?
UNION ALL 会合并两条或多条 SELECT 查询的结果,并保留所有重复行。由于不进行去重,该函数通常比 UNION 更快。
SELECT employee_id, employee_name
    FROM sales_team
UNION ALL
SELECT employee_id, employee_name
    FROM support_team;技术支持
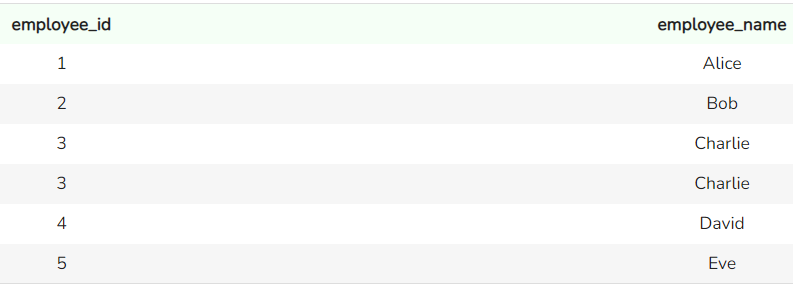
UNION ALL 函数的输出。图片由作者提供
可以看到,在这种情况下,重复条目会被保留并重复显示。
UNION ALL 在 SQL 中的使用场景有哪些?
以下是 UNION ALL 的一些常见用法。
- 合并包含重复的结果:当您需要合并多条查询的结果并保留所有重复行时,使用
UNION ALL。
- 性能考量:
UNION ALL 比 UNION 更高效,因为无需额外的去重步骤。
- 汇总不同时期数据:当按不同时期或来源聚合数据且需要保留重复时,优先使用
UNION ALL。
- 报表与分析:用于要求包含每条记录(包括重复)的报表场景,
UNION ALL 更合适。
UNION 与 UNION ALL:相同点与差异
我们用一张汇总表来概述其相同点与差异。
|
功能
|
UNION
|
UNION ALL
|
|
重复行
|
去除
|
保留
|
|
性能
|
较慢
|
较快
|
|
使用场景
|
需要唯一记录时
|
需要所有记录时
|
|
结果规模
|
较小
|
较大
|
各 SQL 方言中 UNION 与 UNION ALL 的语法差异
尽管基本语法在不同 SQL 方言中保持一致,但也会因平台而略有差异。在大多数平台(如 SQL Server、Oracle、MySQL、PostgreSQL 或 BigQuery)上,代码大致如下所示。
SELECT employee_id, employee_name
    FROM sales_team
UNION ALL
SELECT employee_id, employee_name
    FROM support_team;技术支持
这些 SQL 方言中的基本用法相同,但也存在一些细微差别:
- 对 NULL 与排序规则的处理:不同方言对
NULL 值与字符串排序规则的处理可能不同。
- 性能优化:各方言在优化与执行效率上可能存在差异。
- 错误与警告处理:使用这些函数时,不同方言的错误与警告处理方式可能不同。
- 平台特定函数与特性:某些方言可能提供额外的函数或特性,可与
UNION 和 UNION ALL 结合用于更复杂的场景。
在运行于分布式环境的 PySpark 中,命令有明显不同。假设 df1 与 df2 是我们在上文创建的两张表对应的数据框,代码如下:
df1.union(df2)技术支持
使用 SQL UNION 的 3 条规则与常见错误
尽管 UNION 与 UNION ALL 功能强大,但对语法非常严格。如果您的查询报错,很可能是违反了以下三条黄金法则之一。
1. 列数量不一致
用户最常见的错误是两边列数不匹配。要合并两个数据集,表的“形状”必须一致。无法将 3 列的表堆叠到 2 列的表之上。
错误示例:
SELECT employee_id, name, department
FROM employees_2023
UNION
SELECT employee_id, name
FROM employees_2024;技术支持
修复方法:确保两条 SELECT 语句请求的列数完全一致。如果第二张表缺少数据(如 department),可选择 NULL 作为占位,使列数对齐:
SELECT employee_id, name, department FROM employees_2023
UNION
SELECT employee_id, name, NULL as department FROM employees_2024;技术支持
2. 数据类型兼容性
SQL 按位置合并结果,而非按列名。第一条查询的第一个列的数据类型,必须与第二条查询的第一个列相匹配(或兼容)。
错误示例:如果不小心交换了列的顺序,SQL 会尝试将数字(ID)堆叠到字符串(Name)之上,从而导致数据类型转换错误。
SELECT employee_id, name FROM employees_2023
UNION
SELECT name, employee_id FROM employees_2024;技术支持
修复方法:务必确保每个 SELECT 语句中的列顺序完全一致,再进行 UNION。
3. ORDER BY 的限制
常见困惑在于 ORDER BY 的位置。无法在 UNION 的子查询内部进行排序;只能对最终合并的结果排序。
错误示例:在最终查询前使用 ORDER BY 会触发语法错误。
SELECT employee_id, name FROM employees_2023
ORDER BY employee_id
UNION
SELECT employee_id, name FROM employees_2024;技术支持
修复方法:将 ORDER BY 放在查询的最后。这会对整个合并后的结果集进行排序。
SELECT employee_id, name FROM employees_2023
UNION
SELECT employee_id, name FROM employees_2024
ORDER BY employee_id; 技术支持
结语
要高效地使用 SQL 管理数据,理解 UNION 与 UNION ALL 的适用性至关重要。前者仅选择去重后的记录,后者保留所有记录,从而影响性能与结果集规模。请根据您的具体需求选择合适的函数。
如需进一步学习,建议参考以下资源:
- SQL 入门:学习如何使用 SQL 创建并查询关系型数据库。
- SQL 基础:掌握与数据交互和查询所需的基础 SQL 技能。
- SQL 助理认证:通过从数据库中提取合适数据并回答常见数据问题,证明您的 SQL 能力。
- SQL 进阶:在这门实践课程中,学习分析数据所需的关键 SQL 技能,并立即用自己的 SQL 代码开展分析。


在 SQL 的世界里,将多条查询的结果合并是一项基本需求,而 SQL 提供了强大的
UNION和UNION ALL等函数来实现这一点。正如您将看到的,理解 SQL 中
UNION与UNION ALL之间的细微差别,对于高效的数据查询与管理至关重要。本教程将借助配套数据集,解释它们的关键相似点、差异以及使用场景,帮助您优化 SQL 查询。简要结论:SQL UNION vs. UNION ALL
关键区别在于,
UNION会去除重复记录,而UNION ALL会保留所有重复。这不仅会影响结果集中行的数量,也会影响性能。我们来看两个示例表,
employees_2023与employees_2024,分别表示两个年度的员工记录。employee_id
name
department
1
Alice
HR
2
Bob
IT
3
Charlie
Finance
employee_id
name
department
2
Bob
IT
3
Charlie
Finance
4
David
Marketing
现在,让我们使用
UNION将两张表连接起来。employee_id
name
department
1
Alice
HR
2
Bob
IT
3
Charlie
Finance
4
David
Marketing
在该结果中,重复记录已被去除。现在,我们将其与使用
UNION ALL得到的结果进行对比。employee_id
name
department
1
Alive
HR
2
Bob
IT
3
Charlie
Finance
2
Bob
IT
3
Charlie
Finance
4
David
Marketing
在该结果中,包含了所有记录,未对重复项进行去重。
SQL 中的 UNION 是什么?
UNION会将两条或多条SELECT查询的结果合并为一个结果集,并去除重复行。每条UNION中的SELECT语句必须具有相同的列数、相近的数据类型,且列的顺序一致。为便于理解,我们先创建下面两个示例表。上述代码将分别创建本教程中要使用的两张表:
sales_team与support_team。您可以使用下面的代码查看这些表。sales_team 表中的记录。图片由作者提供
support_team 表中的记录。图片由作者提供
这两张小表各包含三条记录,列名一目了然。现在我们已经创建了两张表,来应用一下
UNION函数。UNION 函数的输出。图片由作者提供
可以看到,值为
3的employee_id的重复条目被去除了。UNION 在 SQL 中的使用场景有哪些?
以下是
UNION的一些常见用法。合并不同表的结果:当您希望合并多张表并确保没有重复记录时,
UNION是首选。处理不同数据源:在合并来自不同数据源的表时,
UNION很有用。跨查询去重:当您需要确保合并结果集的唯一性时,使用
UNION。SQL 中的 UNION ALL 是什么?
UNION ALL会合并两条或多条SELECT查询的结果,并保留所有重复行。由于不进行去重,该函数通常比UNION更快。UNION ALL 函数的输出。图片由作者提供
可以看到,在这种情况下,重复条目会被保留并重复显示。
UNION ALL 在 SQL 中的使用场景有哪些?
以下是
UNION ALL的一些常见用法。UNION ALL。UNION ALL比UNION更高效,因为无需额外的去重步骤。UNION ALL。UNION ALL更合适。UNION 与 UNION ALL:相同点与差异
我们用一张汇总表来概述其相同点与差异。
功能
UNION
UNION ALL
重复行
去除
保留
性能
较慢
较快
使用场景
需要唯一记录时
需要所有记录时
结果规模
较小
较大
各 SQL 方言中 UNION 与 UNION ALL 的语法差异
尽管基本语法在不同 SQL 方言中保持一致,但也会因平台而略有差异。在大多数平台(如 SQL Server、Oracle、MySQL、PostgreSQL 或 BigQuery)上,代码大致如下所示。
这些 SQL 方言中的基本用法相同,但也存在一些细微差别:
NULL值与字符串排序规则的处理可能不同。UNION和UNION ALL结合用于更复杂的场景。在运行于分布式环境的 PySpark 中,命令有明显不同。假设
df1与df2是我们在上文创建的两张表对应的数据框,代码如下:使用 SQL UNION 的 3 条规则与常见错误
尽管
UNION与UNION ALL功能强大,但对语法非常严格。如果您的查询报错,很可能是违反了以下三条黄金法则之一。1. 列数量不一致
用户最常见的错误是两边列数不匹配。要合并两个数据集,表的“形状”必须一致。无法将 3 列的表堆叠到 2 列的表之上。
错误示例:
修复方法:确保两条
SELECT语句请求的列数完全一致。如果第二张表缺少数据(如department),可选择NULL作为占位,使列数对齐:2. 数据类型兼容性
SQL 按位置合并结果,而非按列名。第一条查询的第一个列的数据类型,必须与第二条查询的第一个列相匹配(或兼容)。
错误示例:如果不小心交换了列的顺序,SQL 会尝试将数字(ID)堆叠到字符串(Name)之上,从而导致数据类型转换错误。
修复方法:务必确保每个
SELECT语句中的列顺序完全一致,再进行UNION。3. ORDER BY 的限制
常见困惑在于
ORDER BY的位置。无法在UNION的子查询内部进行排序;只能对最终合并的结果排序。错误示例:在最终查询前使用
ORDER BY会触发语法错误。修复方法:将
ORDER BY放在查询的最后。这会对整个合并后的结果集进行排序。结语
要高效地使用 SQL 管理数据,理解
UNION与UNION ALL的适用性至关重要。前者仅选择去重后的记录,后者保留所有记录,从而影响性能与结果集规模。请根据您的具体需求选择合适的函数。如需进一步学习,建议参考以下资源: