加权平均在数据分析中无处不在,从计算您的 GPA 到确定投资组合回报。与对所有数据点一视同仁的简单平均不同,加权平均承认某些数值应当拥有更大的影响力。当您处理重要性或出现频率各不相同的数据时,它就格外有用。
什么是加权平均?
加权平均根据预先设定的权重,为各个数据点分配不同的重要程度。简单平均对所有数值一视同仁,而加权平均会在计算最终结果前,将每个数值与其对应权重相乘。
关键洞见在于:权重直接决定每个数据点对最终平均值的影响程度。权重更高的数据点会将结果拉向其自身的数值,而权重较低的数据点影响较小。这使您对计算有更强的掌控力,并常常得到更有意义的结果。
加权平均与简单平均的不同之处在于:它考虑了每个数据点的相对重要性,而不是假设所有点同等重要。
理解加权平均公式
既然我们已经明确了加权平均的概念及其重要性,接下来就深入了解其背后的数学基础。
数学定义与核心原理
加权平均公式将每个数据点与其对应的权重结合:
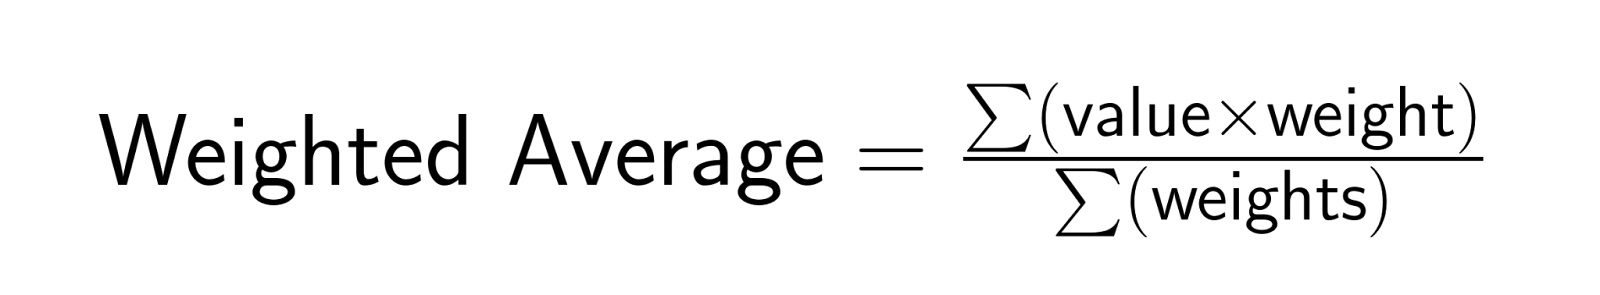
其中 Σ 表示对所有项求和。先将每个数值与其权重相乘,再将这些乘积相加,最后除以所有权重之和。
在大多数实际情境(概率、频数与占比)中,权重为非负数,并常被规范化为总和为 1(或为总数量)。在一些特定方法中可能出现负权重,但它们可能产生反直觉结果,应谨慎使用。务必确保权重之和大于零,以避免被零除。
该公式确保高权重的数值对最终结果具有成比例的更大影响。例如,如果一个数据点的权重为 10,另一个为 1,则前者对最终平均值的贡献是后者的十倍。
规范化与特殊情形
规范化指将权重缩放为总和为 1,使每个权重可直接解释为百分比贡献。当 $(sum_i w_i = 1)$ 时,加权平均可简化为 $(sum_i w_i x_i)$。在概率情境下,这些权重就是概率,而加权平均即为期望值。
这种规范化方法在概率场景中尤为有用,因为权重代表必须相加为 1 的概率。在这些情况下,加权平均就是分布的期望值。
为何以及何时使用加权平均
在掌握数学基础之后,您或许会想,何时应优先采用加权平均而不是简单平均?答案在于识别您的数据何时天然具有不同的重要程度。
当数据点在重要性或出现频率上天然不同,加权平均就至关重要。当数据点代表不同的样本量、时间段或可靠性水平时,加权平均往往优于简单平均。例如,在计算不同班级规模的平均测试分数时,较大的班级应比小班级对总体平均有更大影响。
加权平均在金融计算(投资组合回报)、学术评分(不同作业权重)、调查分析(人口统计校正)以及存货管理(跨不同采购数量的成本平均)中尤为有价值。
加权平均的常见挑战
尽管加权平均十分强大,但也存在一些潜在陷阱,需要您谨慎应对。
权重选择
最关键的挑战在于选择合适的权重,这需要领域专业知识,并要仔细考虑每个数据点所代表的含义。不当的权重选择可能严重扭曲结果,导致误导性结论。
例如,如果您在计算客户满意度得分时,不慎给不太可靠的数据源分配了更高权重,那么最终平均值将无法准确反映真实的客户情绪。务必确保您的权重体现出每个数据点的实际重要性或可靠性。
计算陷阱
除权重选择外,常见的计算错误还包括使用零权重(会移除数据点)、负权重(可能产生反直觉结果),以及在需要时忘记对权重进行规范化。当所有权重为零时会发生被零除错误。
在处理应相加为 100% 的百分比型权重时,务必仔细检查权重分配并确保正确规范化。
如何在 Excel 与 Python 中计算加权平均
在了解了理论与潜在挑战后,让我们转向实践,看看如何用您可能已熟悉的常用工具实现加权平均。
如何在 Excel 中计算加权平均
Excel 可借助 SUMPRODUCT() 与 SUM() 函数轻松完成加权平均计算。公式结构为:
=SUMPRODUCT(values, weights)/SUM(weights) 技术支持
例如,若数值在 A2:A6,权重在 B2:B6: =SUMPRODUCT(A2:A6, B2:B6) / SUM(B2:B6)
提示:保持权重单位一致。若权重为百分比,要么以小数形式存储(如 0.6),要么以整数形式存储(如 60),但务必在分子与分母中使用相同单位。
如何在 Python 中计算加权平均
对于使用 Python 的读者,可以借助 numpy 库实现优雅的解法,也可手动计算:
import numpy as np 技术支持
加权平均公式在真实、特定领域中的应用
既然您已掌握如何计算加权平均,接下来看看它如何在不同领域中解决真实问题。这些示例将帮助您识别在何种情境下加权平均能改进自己的分析。
教育评分体系
学术评分体系通常使用加权平均来平衡不同类型的评估。例如,一门课程可能将考试占 60%,作业占 25%,课堂参与占 15%。
如果一名学生考试得分 88,作业 95,参与 92,则其最终成绩为:(88×0.6) + (95×0.25) + (92×0.15) = 90.35。此方法确保更重要的评估对最终成绩影响更大。
财务中的存货计价
在商业应用中,公司常用加权平均成本(WAC)法在一个期间内以不同价格采购商品时对存货进行计价。不同于简单算术平均,WAC 将采购数量纳入考量,从而平滑价格波动,并为财务报告提供一致的成本基础。
例如,若公司以 10 美元购买 100 件、以 12 美元购买 300 件,则加权平均成本为 11.50 美元,而非简单平均给出的 11.00 美元。
金融分析
在金融领域,加权平均的应用远不止存货。投资组合管理依赖加权平均来计算预期收益与风险,每项资产的权重基于其在组合总价值中的占比。这确保了较大持仓比小额持仓有更大影响力。
类似地,加权平均资本成本(WACC)应用相同原理:它通过按资本结构中债务与权益的占比分别加权其成本,代表一家公司的平均融资成本。WACC 是估值模型与投资决策中的关键输入,常被用作公司实现回报的门槛收益率。
统计调查
在研究领域,调查分析使用加权平均来校正人口统计失衡,确保结果具有代表性。如果您的调查对某些年龄组抽样不足,您可以为回答加权,使之匹配真实人口分布。
这种调整有助于消除抽样偏差,产出对所研究更广泛人群更准确的洞见。
存货会计
回到实际业务应用,移动平均法在存货会计中使用加权平均来确定销售成本。每次新采购都会根据剩余存货与新增数量更新单位平均成本。
这种方法可平滑价格波动,并为财务报告提供稳定的成本估计,使得长期追踪盈利趋势更为容易。
按面积加权的建筑输入与其他专业场景
除了上述常见应用之外,工程领域常在建筑能耗计算中使用按面积加权的平均,不同区域根据其面积对整体建筑性能作出贡献。
类似概念也出现在地理信息系统(GIS)的空间分析以及制造业的跨生产区域质量控制中。
与其他平均方法的比较分析
了解了上述应用,您可能会思考如何在加权平均与其他平均方法之间进行选择。理解这些差异将帮助您为具体情境选用合适的方法。
算术平均 vs. 加权平均
算术平均假设所有数据点同等重要且具有代表性。加权平均则明确考虑数据点在重要性、可靠性或频率方面的差异。
当您的数据天然具有不同的重要程度,或需要校正抽样不平衡时,请选择加权平均。当所有数据点确实应得到同等对待时,使用简单的算术平均。
几何平均
几何平均最适用于增长率或比率等乘法型数据,帮助您找到一段时间内的平均变化率。不过,几何平均并不天然支持加权。
虽然可借助对数构造加权几何平均,但该方法在数学上更复杂,且相较于加权算术平均,对大多数应用来说不够直观。
加权平均的优缺点
在进入更高级主题前,值得退一步思考使用加权平均所涉及的整体权衡。
优点
当数据点在重要性或可靠性上天然存在差异时,加权平均可提供更高的准确性。它允许基于领域知识灵活调整计算,并能更好地反映并非所有观测都相同的真实世界情境。
这种方法在需要进行人口统计校正、投资组合分析,或样本量与测量置信度在数据点间存在差异的情境中表现突出。
缺点
主要局限在于权重选择的主观性,若处理不当会引入偏差。加权平均对高权重离群值更为敏感,且若权重分配错误,易导致失误。
此外,与简单平均相比,它需要更多的计算工作与领域专业知识;当等权更为合适时,使用加权平均会显得不必要地复杂。
更高级与理论性的拓展
对于希望超越基础应用的读者而言,加权平均可扩展至更复杂的数学领域,开启更多分析可能性。
连续加权平均
加权平均可通过积分运算扩展到连续函数。此时不再是离散的权重与数值,而是对连续的权重函数与数值函数进行积分:
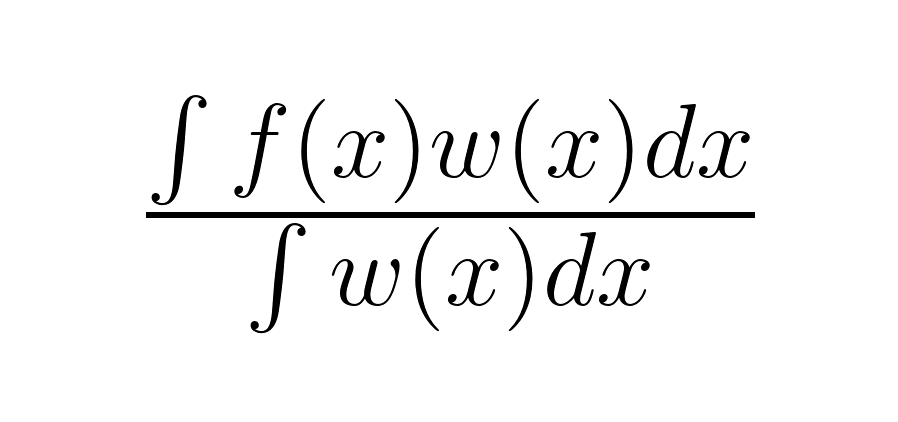
该方法出现在物理学中用于计算质心,以及在概率论中用于连续型分布。
概率中的期望值
在上述数学基础上,概率论中的期望值表示所有可能结果的加权平均,其中权重为各结果发生的概率。
期望值用于在不确定环境中预测长期结果,从赌场博弈到投资回报,都是进行风险评估与决策制定的基本工具。
结论
当观测值在重要性、频率或可靠性上存在差异时,加权平均为数据分析提供了更细致且准确的方法。贯穿本指南,我们看到它如何在不同领域提升决策质量。从学术评分到投资组合管理,通过恰当地考虑不同数据点的相对重要性,加权平均能发挥更大价值。
当您开始在自己的分析中采用加权平均时,请牢记其力量源于反映真实世界的复杂性——并非所有数据都应获得同等对待。无论是在计算成绩、分析投资组合,还是处理调查数据,加权平均都能通过为最重要的信息赋予恰当影响,帮助您做出更明智的决策。
不妨探索我们的 高级 Excel 函数课程以深化您的表格技能,或查看我们的 描述性统计速查表,快速回顾此类统计概念。


加权平均在数据分析中无处不在,从计算您的 GPA 到确定投资组合回报。与对所有数据点一视同仁的简单平均不同,加权平均承认某些数值应当拥有更大的影响力。当您处理重要性或出现频率各不相同的数据时,它就格外有用。
什么是加权平均?
加权平均根据预先设定的权重,为各个数据点分配不同的重要程度。简单平均对所有数值一视同仁,而加权平均会在计算最终结果前,将每个数值与其对应权重相乘。
关键洞见在于:权重直接决定每个数据点对最终平均值的影响程度。权重更高的数据点会将结果拉向其自身的数值,而权重较低的数据点影响较小。这使您对计算有更强的掌控力,并常常得到更有意义的结果。
加权平均与简单平均的不同之处在于:它考虑了每个数据点的相对重要性,而不是假设所有点同等重要。
理解加权平均公式
既然我们已经明确了加权平均的概念及其重要性,接下来就深入了解其背后的数学基础。
数学定义与核心原理
加权平均公式将每个数据点与其对应的权重结合:
其中 Σ 表示对所有项求和。先将每个数值与其权重相乘,再将这些乘积相加,最后除以所有权重之和。
在大多数实际情境(概率、频数与占比)中,权重为非负数,并常被规范化为总和为 1(或为总数量)。在一些特定方法中可能出现负权重,但它们可能产生反直觉结果,应谨慎使用。务必确保权重之和大于零,以避免被零除。
该公式确保高权重的数值对最终结果具有成比例的更大影响。例如,如果一个数据点的权重为 10,另一个为 1,则前者对最终平均值的贡献是后者的十倍。
规范化与特殊情形
规范化指将权重缩放为总和为 1,使每个权重可直接解释为百分比贡献。当 $(sum_i w_i = 1)$ 时,加权平均可简化为 $(sum_i w_i x_i)$。在概率情境下,这些权重就是概率,而加权平均即为期望值。
这种规范化方法在概率场景中尤为有用,因为权重代表必须相加为 1 的概率。在这些情况下,加权平均就是分布的期望值。
为何以及何时使用加权平均
在掌握数学基础之后,您或许会想,何时应优先采用加权平均而不是简单平均?答案在于识别您的数据何时天然具有不同的重要程度。
当数据点在重要性或出现频率上天然不同,加权平均就至关重要。当数据点代表不同的样本量、时间段或可靠性水平时,加权平均往往优于简单平均。例如,在计算不同班级规模的平均测试分数时,较大的班级应比小班级对总体平均有更大影响。
加权平均在金融计算(投资组合回报)、学术评分(不同作业权重)、调查分析(人口统计校正)以及存货管理(跨不同采购数量的成本平均)中尤为有价值。
加权平均的常见挑战
尽管加权平均十分强大,但也存在一些潜在陷阱,需要您谨慎应对。
权重选择
最关键的挑战在于选择合适的权重,这需要领域专业知识,并要仔细考虑每个数据点所代表的含义。不当的权重选择可能严重扭曲结果,导致误导性结论。
例如,如果您在计算客户满意度得分时,不慎给不太可靠的数据源分配了更高权重,那么最终平均值将无法准确反映真实的客户情绪。务必确保您的权重体现出每个数据点的实际重要性或可靠性。
计算陷阱
除权重选择外,常见的计算错误还包括使用零权重(会移除数据点)、负权重(可能产生反直觉结果),以及在需要时忘记对权重进行规范化。当所有权重为零时会发生被零除错误。
在处理应相加为 100% 的百分比型权重时,务必仔细检查权重分配并确保正确规范化。
如何在 Excel 与 Python 中计算加权平均
在了解了理论与潜在挑战后,让我们转向实践,看看如何用您可能已熟悉的常用工具实现加权平均。
如何在 Excel 中计算加权平均
Excel 可借助
SUMPRODUCT()与SUM()函数轻松完成加权平均计算。公式结构为:例如,若数值在 A2:A6,权重在 B2:B6: =SUMPRODUCT(A2:A6, B2:B6) / SUM(B2:B6)
提示:保持权重单位一致。若权重为百分比,要么以小数形式存储(如 0.6),要么以整数形式存储(如 60),但务必在分子与分母中使用相同单位。
如何在 Python 中计算加权平均
对于使用 Python 的读者,可以借助 numpy 库实现优雅的解法,也可手动计算:
加权平均公式在真实、特定领域中的应用
既然您已掌握如何计算加权平均,接下来看看它如何在不同领域中解决真实问题。这些示例将帮助您识别在何种情境下加权平均能改进自己的分析。
教育评分体系
学术评分体系通常使用加权平均来平衡不同类型的评估。例如,一门课程可能将考试占 60%,作业占 25%,课堂参与占 15%。
如果一名学生考试得分 88,作业 95,参与 92,则其最终成绩为:(88×0.6) + (95×0.25) + (92×0.15) = 90.35。此方法确保更重要的评估对最终成绩影响更大。
财务中的存货计价
在商业应用中,公司常用加权平均成本(WAC)法在一个期间内以不同价格采购商品时对存货进行计价。不同于简单算术平均,WAC 将采购数量纳入考量,从而平滑价格波动,并为财务报告提供一致的成本基础。
例如,若公司以 10 美元购买 100 件、以 12 美元购买 300 件,则加权平均成本为 11.50 美元,而非简单平均给出的 11.00 美元。
金融分析
在金融领域,加权平均的应用远不止存货。投资组合管理依赖加权平均来计算预期收益与风险,每项资产的权重基于其在组合总价值中的占比。这确保了较大持仓比小额持仓有更大影响力。
类似地,加权平均资本成本(WACC)应用相同原理:它通过按资本结构中债务与权益的占比分别加权其成本,代表一家公司的平均融资成本。WACC 是估值模型与投资决策中的关键输入,常被用作公司实现回报的门槛收益率。
统计调查
在研究领域,调查分析使用加权平均来校正人口统计失衡,确保结果具有代表性。如果您的调查对某些年龄组抽样不足,您可以为回答加权,使之匹配真实人口分布。
这种调整有助于消除抽样偏差,产出对所研究更广泛人群更准确的洞见。
存货会计
回到实际业务应用,移动平均法在存货会计中使用加权平均来确定销售成本。每次新采购都会根据剩余存货与新增数量更新单位平均成本。
这种方法可平滑价格波动,并为财务报告提供稳定的成本估计,使得长期追踪盈利趋势更为容易。
按面积加权的建筑输入与其他专业场景
除了上述常见应用之外,工程领域常在建筑能耗计算中使用按面积加权的平均,不同区域根据其面积对整体建筑性能作出贡献。
类似概念也出现在地理信息系统(GIS)的空间分析以及制造业的跨生产区域质量控制中。
与其他平均方法的比较分析
了解了上述应用,您可能会思考如何在加权平均与其他平均方法之间进行选择。理解这些差异将帮助您为具体情境选用合适的方法。
算术平均 vs. 加权平均
算术平均假设所有数据点同等重要且具有代表性。加权平均则明确考虑数据点在重要性、可靠性或频率方面的差异。
当您的数据天然具有不同的重要程度,或需要校正抽样不平衡时,请选择加权平均。当所有数据点确实应得到同等对待时,使用简单的算术平均。
几何平均
几何平均最适用于增长率或比率等乘法型数据,帮助您找到一段时间内的平均变化率。不过,几何平均并不天然支持加权。
虽然可借助对数构造加权几何平均,但该方法在数学上更复杂,且相较于加权算术平均,对大多数应用来说不够直观。
加权平均的优缺点
在进入更高级主题前,值得退一步思考使用加权平均所涉及的整体权衡。
优点
当数据点在重要性或可靠性上天然存在差异时,加权平均可提供更高的准确性。它允许基于领域知识灵活调整计算,并能更好地反映并非所有观测都相同的真实世界情境。
这种方法在需要进行人口统计校正、投资组合分析,或样本量与测量置信度在数据点间存在差异的情境中表现突出。
缺点
主要局限在于权重选择的主观性,若处理不当会引入偏差。加权平均对高权重离群值更为敏感,且若权重分配错误,易导致失误。
此外,与简单平均相比,它需要更多的计算工作与领域专业知识;当等权更为合适时,使用加权平均会显得不必要地复杂。
更高级与理论性的拓展
对于希望超越基础应用的读者而言,加权平均可扩展至更复杂的数学领域,开启更多分析可能性。
连续加权平均
加权平均可通过积分运算扩展到连续函数。此时不再是离散的权重与数值,而是对连续的权重函数与数值函数进行积分:
该方法出现在物理学中用于计算质心,以及在概率论中用于连续型分布。
概率中的期望值
在上述数学基础上,概率论中的期望值表示所有可能结果的加权平均,其中权重为各结果发生的概率。
期望值用于在不确定环境中预测长期结果,从赌场博弈到投资回报,都是进行风险评估与决策制定的基本工具。
结论
当观测值在重要性、频率或可靠性上存在差异时,加权平均为数据分析提供了更细致且准确的方法。贯穿本指南,我们看到它如何在不同领域提升决策质量。从学术评分到投资组合管理,通过恰当地考虑不同数据点的相对重要性,加权平均能发挥更大价值。
当您开始在自己的分析中采用加权平均时,请牢记其力量源于反映真实世界的复杂性——并非所有数据都应获得同等对待。无论是在计算成绩、分析投资组合,还是处理调查数据,加权平均都能通过为最重要的信息赋予恰当影响,帮助您做出更明智的决策。
不妨探索我们的 高级 Excel 函数课程以深化您的表格技能,或查看我们的 描述性统计速查表,快速回顾此类统计概念。